
Kurs
LangChain ile LLM Uygulamaları Geliştirme
3 sa
51.1K
Apple’ın son katkısı DCLM-7B (DataComp for Language Models) temel modeli, LLM alanında dikkat çekici bir ekleme olarak öne çıkıyor. Gelin, temel özelliklerine bakalım.
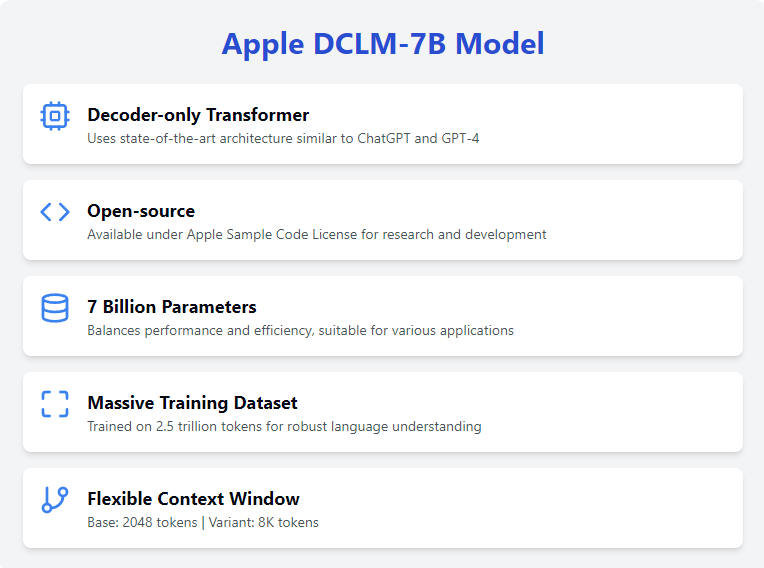
DCLM-7B modeli, her seferinde bir belirteç öngören ve her Transformer mimarisi, tasarımına dayanan yalnızca kod çözücü bir yapı kullanır; her bir üretilen belirteç bir sonrakini üretmek için modele geri beslenir.
Bu mimari, tutarlı ve bağlama uygun metin üretimi için optimize edilmiştir; bu da onu çeşitli doğal dil işleme görevleri için ideal kılar. Bu, ChatGPT ve GPT-4o gibi en son teknoloji modellerde kullanılan aynı mimaridir ve insan benzeri metinleri anlama ve üretmedeki etkinliğini gösterir.
DCLM-7B modeli, Apple Sample Code Lisansı kapsamında araştırma ve geliştirme için kullanılabilir. Bu açık kaynak yaklaşımı, yapay zekâ topluluğu içinde yaygın kullanımı ve iş birliğini teşvik eder.
Modeli erişilebilir kılarak Apple, dünyanın dört bir yanındaki araştırmacı ve geliştiricilerin temel model üzerinde deney yapmasını ve onu geliştirmesini destekliyor.
7 milyar parametreyle DCLM-7B modeli, performans ile hesaplama verimliliği arasında bir denge kurar.
Bu boyut, modeli yüksek RAM/VRAM’e sahip çoğu makinede ve bulut platformlarında çalıştırmayı mümkün kılar; bu da onu çeşitli uygulamalar için çok yönlü ve erişilebilir hale getirir. Parametrelerin çokluğu, modelin karmaşık dil kalıplarını yakalamasını sağlar ve çok çeşitli görevleri yerine getirme kabiliyetini artırır.
Model, 2,5 trilyon belirteçten oluşan kapsamlı bir veri kümesi üzerinde eğitilmiştir; bu da geniş bir yelpazedeki dil görevleri için sağlam bir temel sunar. Bu sayede DCLM-7B modeli metni yüksek doğruluk ve alaka düzeyiyle anlar ve üretir. Ayrıca bu durum, modelin göreve özgü ince ayar için iyi bir seçenek olmasını sağlar; çünkü İngilizce diline dair güçlü bir temel anlayışa sahiptir.
DCLM-7B temel modelinin 2048 belirteçlik bir bağlam penceresi vardır; bu da nispeten uzun metin dizilerini işlemesine olanak tanır. Her ne kadar bu, günümüz standartlarına göre nispeten küçük olsa da Apple, 8K belirteç bağlam penceresine sahip bir varyantı da yayınladı.
Bu genişletilmiş bağlam penceresi, daha uzun girdileri işleme konusunda daha fazla esneklik sağlar ve modeli, Retrieval Augmented Generation (RAG) gibi uzun metinlerin veya belgelerin işlenmesini gerektiren uygulamalar için uygun hale getirir.
Apple, DCLM-7B modelini Hugging Face’in transformers kütüphanesiyle uyumlu hale getirdi; bu da erişimi ve kullanımı kolaylaştırıyor.
Modelin web sayfasını Hugging Face’te bulabilir ve daha fazla ayrıntı için GitHub deposuna göz atabilirsiniz. Modeli kullanmak ve erişmek için transformers kütüphanesini yüklememiz gerekecek:
pip install transformersEk olarak, open_lm çatısını da yüklememiz gerekecek:
pip install git+https://github.com/mlfoundations/open_lm.gitTam hassasiyetli DCLM-7B modeli oldukça büyüktür; yaklaşık 27,5 GB’tır ve çalıştırmak için ciddi miktarda RAM veya VRAM gerektirir. Üst düzey bir bilgisayara veya bir tür bulut ortamına ihtiyacınız olacak. Ben 50 GB RAM ve L4 GPU’ya sahip Google Colab’in premium abonelikli defterini kullanacağım.
Gerekli tüm kütüphaneler kurulduğuna göre, modeli kullanmaya başlamaya hazırız!
Örnek için, modelin Hugging Face sayfasında verilen basit bir örneği çalıştıracağım. İlk olarak gerekli tüm kütüphaneleri içe aktarıyoruz:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
Ardından hem belirteçleyiciyi (tokenizer) hem de modeli indirip başlatmamız gerekiyor (bu örnekte modeli tam hassasiyetli kayan noktalı değerlerle CPU üzerinde çalıştırdığımıza dikkat edin):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
Ve son olarak örnek istemi çalıştırıyoruz:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
Aldığım çıktı şu şekildeydi:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]DCLM-7B modeline ince ayar yapmak, onu belirli görevlere uyarlamaya yardımcı olur ve uygulamalarınızda performansını artırır. Ne yazık ki DCLM-7B modeli Hugging Face’in peft kütüphanesi tarafından desteklenmiyor; bu nedenle ince ayar için transformers kütüphanesini kullanmamız gerekiyor.
LoRA gibi araçlar olmadan, bu kadar büyük bir modele ince ayar yapmak muazzam kaynak gerektirir; zira temelde sıfırdan eğitimle neredeyse aynıdır. Bu nedenle burada, sonuçlarını görmek için çalıştırmadan, yalnızca ince ayar sürecinin ana hatlarını sunacağım.
Açıkça erişilebilen bir veri kümesini indirmek ve kullanmak için Hugging Face’in datasets kütüphanesini kullanacağız. Şu komutla kuruyoruz:
pip install datasetsKurulumun ardından, bu örnek için wikitext veri kümesini kullanarak load_dataset fonksiyonunu içe aktarıp çalıştırıyoruz:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
Şimdi veri kümesini belirteçleyelim:
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
Artık ince ayara başlamaya hazırız!
İnce ayar için TrainingArguments ve Trainer nesnelerini içe aktarıp başlatmamız ve ardından train() fonksiyonunu çalıştırmamız gerekir.
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Controls how much to change the model weights during training
	    per_device_train_batch_size=2,  # Number of samples per batch per device during training
	    per_device_eval_batch_size=2,  # Number of samples per batch per device during evaluation
	    num_train_epochs=3,  # Number of times the entire training dataset will be passed through the model
	    weight_decay=0.01,  # Regularization technique to prevent overfitting
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()Genel olarak Apple’ın DCLM-7B’si, açık kaynak dil modeli ekosistemine önemli bir katkıdır ve araştırmacı ile geliştiricilere çeşitli NLP görevleri için güçlü bir araç sunar.
Yalnızca kod çözücü bir Transformer modeli olarak metin üretimi için optimize edilmiştir ve tutarlı, bağlama uygun çıktılar sağlar. Modelin Apple Academic Software License Agreement kapsamında erişilebilir olması, yapay zekâ topluluğunda iş birliği ve inovasyonu daha da teşvik eder.
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



