
Last chance! 50% off DataCamp Premium
Sale ends in
Apple का नवीनतम योगदान, DCLM-7B (DataComp for Language Models) बेस मॉडल, LLM क्षेत्र में एक उल्लेखनीय जोड़ के रूप में उभरता है। आइए इसकी मुख्य विशेषताओं का अन्वेषण करें।
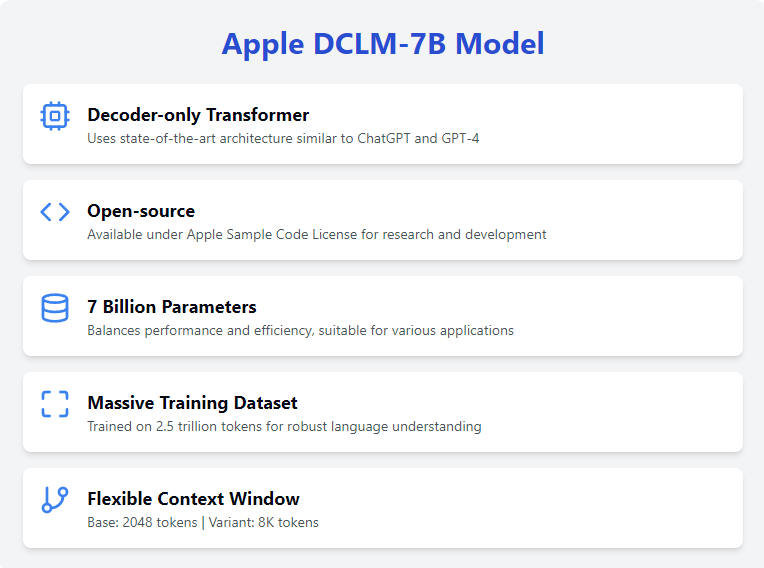
DCLM-7B मॉडल एक केवल-डिकोडर Transformer आर्किटेक्चर का उपयोग करता है, जिसमें मॉडल एक समय में एक टोकन का पूर्वानुमान लगाता है, और प्रत्येक उत्पन्न टोकन को अगले टोकन को जनरेट करने के लिए मॉडल में वापस फीड किया जाता है।
यह आर्किटेक्चर सुसंगत और सन्दर्भानुकूल टेक्स्ट जनरेट करने के लिए अनुकूलित है, जो इसे विविध प्राकृतिक भाषा संसाधन कार्यों के लिए आदर्श बनाता है। यही आर्किटेक्चर अत्याधुनिक मॉडलों जैसे ChatGPT और GPT-4o में उपयोग किया जाता है, जो मानवीय-से टेक्स्ट को समझने और जनरेट करने में इसकी प्रभावशीलता दर्शाता है।
DCLM-7B मॉडल शोध और विकास के लिए Apple Sample Code License के तहत उपलब्ध है। यह ओपन-सोर्स दृष्टिकोण AI समुदाय में व्यापक उपयोग और सहयोग को प्रोत्साहित करता है।
इस मॉडल को सुलभ बनाकर, Apple AI के लोकतंत्रीकरण को सहारा देता है, जिससे दुनिया भर के शोधकर्ता और डेवलपर बेस मॉडल के साथ प्रयोग कर सकें और उस पर आगे कार्य कर सकें।
7 बिलियन पैरामीटर्स के साथ, DCLM-7B मॉडल प्रदर्शन और गणनात्मक दक्षता के बीच संतुलन स्थापित करता है।
यह आकार अधिकांश हाई RAM/VRAM सेटअप और क्लाउड प्लेटफ़ॉर्म पर मॉडल चलाना संभव बनाता है, जिससे यह विभिन्न अनुप्रयोगों के लिए बहुपयोगी और सुलभ हो जाता है। बड़ी संख्या में पैरामीटर्स मॉडल को जटिल भाषा पैटर्न पकड़ने में सक्षम बनाते हैं, जिससे विभिन्न प्रकार के कार्यों को करने की इसकी क्षमता बढ़ती है।
मॉडल को 2.5 ट्रिलियन टोकन के विस्तृत डेटासेट पर प्रशिक्षित किया गया है, जो विविध भाषा कार्यों से निपटने के लिए एक मजबूत आधार प्रदान करता है। यह DCLM-7B मॉडल को उच्च सटीकता और प्रासंगिकता के साथ टेक्स्ट को समझने और जनरेट करने की अनुमति देता है। इसके अलावा, यह मॉडल को कार्य-विशिष्ट फाइन-ट्यूनिंग के लिए एक अच्छा विकल्प बनाता है, क्योंकि इसमें अंग्रेजी भाषा की ठोस आधारभूत समझ है।
बेस DCLM-7B मॉडल में 2048 टोकन की संदर्भ विंडो है, जो इसे अपेक्षाकृत लंबी टेक्स्ट सीक्वेंस संसाधित करने देती है। हालाँकि यह आज के मानकों के हिसाब से अपेक्षाकृत छोटा है, Apple ने एक वैरिएंट जारी किया है जिसमें 8K टोकन की संदर्भ विंडो है।
यह विस्तारित संदर्भ विंडो लंबे इनपुट्स को संभालने में और भी अधिक लचीलापन देती है, जिससे मॉडल उन अनुप्रयोगों के लिए उपयुक्त हो जाता है जिन्हें विस्तारित टेक्स्ट या दस्तावेज़ों को संसाधित करने की आवश्यकता होती है, जैसे Retrieval Augmented Generation (RAG)।
Apple ने DCLM-7B मॉडल को Hugging Face की transformers लाइब्रेरी के साथ संगत बनाया है, जिससे इसे एक्सेस और उपयोग करना आसान हो गया है।
आप मॉडल का वेबपेज Hugging Face पर पा सकते हैं, और अधिक विवरण के लिए GitHub रिपॉजिटरी देखें। मॉडल का उपयोग और एक्सेस करने के लिए, हमें transformers लाइब्रेरी इंस्टॉल करनी होगी:
pip install transformersइसके अतिरिक्त, हमें open_lm फ्रेमवर्क इंस्टॉल करना होगा:
pip install git+https://github.com/mlfoundations/open_lm.gitपूर्ण परिशुद्धता वाले DCLM-7B मॉडल का आकार काफ़ी बड़ा है, लगभग 27.5GB, जिसे चलाने के लिए काफी RAM या VRAM चाहिए। आपको एक हाई-एंड कंप्यूटर या किसी प्रकार का क्लाउड वातावरण चाहिए होगा। मैं Google Colab की प्रीमियम सदस्यता वाली नोटबुक का उपयोग करूँगा, जिसमें 50GB RAM और L4 GPU है।
सभी आवश्यक लाइब्रेरी इंस्टॉल होने के साथ, हम मॉडल का उपयोग शुरू करने के लिए तैयार हैं!
उदाहरण के लिए, मैं मॉडल के Huggingface वेबपेज पर दिए गए एक बेसिक उदाहरण को चलाऊँगा। पहले, हम सभी आवश्यक लाइब्रेरी इम्पोर्ट करते हैं:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
इसके बाद, हमें टोकनाइज़र और मॉडल दोनों को डाउनलोड और इनिशियलाइज़ करना है (ध्यान दें कि इस उदाहरण में हम CPU पर फुल-प्रिसीजन फ्लोट्स के साथ मॉडल चला रहे हैं):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
और अंत में, हम उदाहरण प्रॉम्प्ट चलाते हैं:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
मुझे निम्नलिखित आउटपुट मिला:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]DCLM-7B मॉडल की फाइन-ट्यूनिंग उसे विशिष्ट कार्यों के अनुरूप ढालने में मदद कर सकती है, जिससे आपके अनुप्रयोगों में इसका प्रदर्शन बेहतर होता है। दुर्भाग्य से, DCLM-7B मॉडल Huggingface की peft लाइब्रेरी द्वारा समर्थित नहीं है, और इसलिए हमें फाइन-ट्यूनिंग के लिए transformers लाइब्रेरी का उपयोग करना होगा।
जैसे LoRA जैसे टूल्स के बिना, इतने बड़े मॉडल की फाइन-ट्यूनिंग के लिए अपार संसाधनों की आवश्यकता होती है, क्योंकि यह मूलतः इसे शुरू से ट्रेन करने जैसा ही है। इसलिए यहाँ मैं बिना वास्तविक रूप से चलाए केवल फाइन-ट्यूनिंग प्रक्रिया की रूपरेखा प्रस्तुत करूँगा।
खुले तौर पर उपलब्ध डेटासेट डाउनलोड और उपयोग करने के लिए, हम Hugging Face की datasets लाइब्रेरी का उपयोग करेंगे। इसे हम निम्न कमांड से इंस्टॉल करते हैं:
pip install datasetsइंस्टॉल होने के बाद, हम load_dataset फ़ंक्शन इम्पोर्ट और उपयोग करते हैं; इस उदाहरण के लिए मैं wikitext डेटासेट का उपयोग करूँगा:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
अब, हमें डेटासेट को टोकनाइज़ करना है:
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
अब, हम फाइन-ट्यूनिंग शुरू करने के लिए तैयार हैं!
फाइन-ट्यूनिंग के लिए, हमें TrainingArguments और Trainer ऑब्जेक्ट्स इम्पोर्ट और इनिशियलाइज़ करने होंगे, और फिर train() फ़ंक्शन चलाना होगा।
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Controls how much to change the model weights during training
	    per_device_train_batch_size=2,  # Number of samples per batch per device during training
	    per_device_eval_batch_size=2,  # Number of samples per batch per device during evaluation
	    num_train_epochs=3,  # Number of times the entire training dataset will be passed through the model
	    weight_decay=0.01,  # Regularization technique to prevent overfitting
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()कुल मिलाकर, Apple का DCLM-7B ओपन-सोर्स भाषा मॉडल परिदृश्य में एक महत्वपूर्ण जोड़ है, जो शोधकर्ताओं और डेवलपर्स को विभिन्न NLP कार्यों के लिए एक शक्तिशाली टूल प्रदान करता है।
एक केवल-डिकोडर Transformer मॉडल के रूप में, यह टेक्स्ट जेनरेशन के लिए अनुकूलित है, और सुसंगत तथा सन्दर्भानुकूल आउटपुट प्रदान करता है। मॉडल की उपलब्धता Apple Academic Software License Agreement के अंतर्गत AI समुदाय में सहयोग और नवाचार को और बढ़ावा देती है।
इन कोर्सेज़ के साथ AI सीखें!
कोर्स
कोर्स
कोर्स
