Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
52K
Đóng góp mới nhất của Apple, mô hình nền tảng DCLM-7B (DataComp for Language Models), nổi bật như một bổ sung đáng chú ý cho lĩnh vực LLM. Hãy cùng khám phá các tính năng chính của nó.
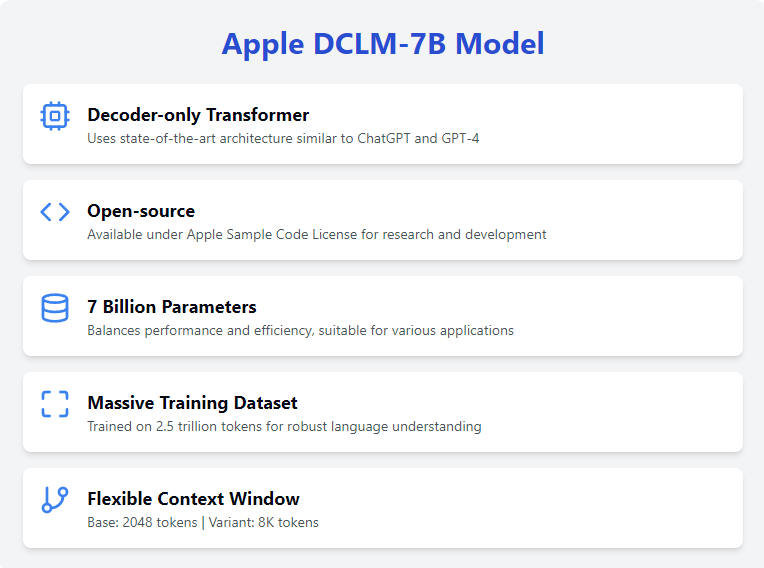
Mô hình DCLM-7B sử dụng kiến trúc Transformer chỉ có decoder, tức là mô hình dự đoán từng token một, và mỗi token được tạo ra sẽ được đưa lại vào mô hình để tạo ra token tiếp theo.
Kiến trúc này được tối ưu hóa để tạo văn bản mạch lạc, phù hợp ngữ cảnh, rất lý tưởng cho nhiều tác vụ xử lý ngôn ngữ tự nhiên. Đây cũng là kiến trúc được dùng trong các mô hình hiện đại như ChatGPT và GPT-4o, cho thấy hiệu quả của nó trong việc hiểu và tạo văn bản gần với con người.
Mô hình DCLM-7B khả dụng cho mục đích nghiên cứu và phát triển theo Giấy phép Mã nguồn Mẫu của Apple (Apple Sample Code License). Cách tiếp cận mã nguồn mở này khuyến khích việc sử dụng rộng rãi và hợp tác trong cộng đồng AI.
Bằng cách mở quyền truy cập mô hình, Apple góp phần dân chủ hóa AI, cho phép các nhà nghiên cứu và nhà phát triển trên toàn thế giới thử nghiệm và xây dựng trên mô hình nền tảng.
Với 7 tỷ tham số, DCLM-7B cân bằng giữa hiệu năng và hiệu quả tính toán.
Kích thước này cho phép chạy mô hình trên hầu hết các máy có RAM/VRAM cao và các nền tảng đám mây, khiến nó linh hoạt và dễ tiếp cận cho nhiều ứng dụng. Số lượng tham số lớn giúp mô hình nắm bắt các mẫu ngôn ngữ phức tạp, nâng cao khả năng thực hiện nhiều tác vụ khác nhau.
Mô hình được huấn luyện trên bộ dữ liệu lớn gồm 2,5 nghìn tỷ token, tạo nền tảng vững chắc để xử lý nhiều tác vụ ngôn ngữ. Điều này giúp DCLM-7B hiểu và tạo văn bản với độ chính xác và mức độ phù hợp cao. Ngoài ra, nó cũng là lựa chọn tốt cho tinh chỉnh theo tác vụ cụ thể, vì nó có hiểu biết nền tảng vững chắc về tiếng Anh.
Mô hình DCLM-7B bản nền có cửa sổ ngữ cảnh 2048 token, cho phép xử lý các chuỗi văn bản tương đối dài. Mặc dù con số này tương đối nhỏ theo tiêu chuẩn hiện nay, Apple cũng đã phát hành một biến thể với cửa sổ ngữ cảnh 8K token.
Cửa sổ ngữ cảnh mở rộng này mang lại sự linh hoạt hơn khi xử lý đầu vào dài, giúp mô hình phù hợp với các ứng dụng cần xử lý văn bản hoặc tài liệu nhiều trang, như RAG (Retrieval Augmented Generation).
Apple đã làm cho DCLM-7B tương thích với thư viện transformers của Hugging Face, giúp việc truy cập và sử dụng trở nên dễ dàng.
Bạn có thể tìm trang mô hình trên Hugging Face và xem kho GitHub để biết thêm chi tiết. Để sử dụng và truy cập mô hình, chúng ta cần cài đặt thư viện transformers:
pip install transformersNgoài ra, chúng ta cần cài đặt framework open_lm:
pip install git+https://github.com/mlfoundations/open_lm.gitPhiên bản DCLM-7B độ chính xác đầy đủ khá lớn, khoảng 27,5GB, đòi hỏi lượng RAM hoặc VRAM đáng kể để chạy. Bạn sẽ cần một máy tính cấu hình cao hoặc môi trường đám mây. Tôi sẽ sử dụng sổ tay đăng ký cao cấp của Google Colab với 50GB RAM và GPU L4.
Khi đã cài đặt đầy đủ các thư viện cần thiết, chúng ta sẵn sàng bắt đầu sử dụng mô hình!
Trong ví dụ này, tôi sẽ chạy một ví dụ cơ bản được cung cấp trên trang Hugging Face của mô hình. Trước tiên, chúng ta nhập các thư viện cần thiết:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
Tiếp theo, chúng ta cần tải xuống và khởi tạo cả tokenizer và mô hình (lưu ý rằng trong ví dụ này chúng ta chạy mô hình với số thực độ chính xác đầy đủ trên CPU):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
Cuối cùng, chúng ta chạy prompt ví dụ:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
Tôi nhận được kết quả sau:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]Tinh chỉnh (fine-tune) mô hình DCLM-7B có thể giúp tùy biến cho các tác vụ cụ thể, từ đó tăng hiệu năng trong ứng dụng của bạn. Đáng tiếc là DCLM-7B chưa được hỗ trợ bởi thư viện peft của Hugging Face, vì vậy chúng ta cần dùng thư viện transformers để tinh chỉnh.
Không có các công cụ như LoRA, việc tinh chỉnh một mô hình lớn như vậy đòi hỏi tài nguyên khổng lồ, gần như tương đương huấn luyện từ đầu. Vì vậy, tôi chỉ phác thảo quy trình tinh chỉnh tại đây mà không thực sự chạy để xem kết quả.
Để tải và sử dụng một bộ dữ liệu mở, chúng ta sẽ dùng thư viện datasets của Hugging Face. Cài đặt bằng lệnh sau:
pip install datasetsSau khi cài đặt, chúng ta nhập và dùng hàm load_dataset; trong ví dụ này tôi sẽ dùng bộ dữ liệu wikitext:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
Tiếp theo, chúng ta cần tokenize bộ dữ liệu:
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
Bây giờ, chúng ta đã sẵn sàng bắt đầu fine-tuning!
Để fine-tune, chúng ta cần nhập và khởi tạo các đối tượng TrainingArguments và Trainer, sau đó chạy hàm train().
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Controls how much to change the model weights during training
	    per_device_train_batch_size=2,  # Number of samples per batch per device during training
	    per_device_eval_batch_size=2,  # Number of samples per batch per device during evaluation
	    num_train_epochs=3,  # Number of times the entire training dataset will be passed through the model
	    weight_decay=0.01,  # Regularization technique to prevent overfitting
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()Tổng thể, DCLM-7B của Apple là một bổ sung đáng kể cho hệ sinh thái mô hình ngôn ngữ mã nguồn mở, mang đến cho các nhà nghiên cứu và nhà phát triển một công cụ mạnh mẽ cho nhiều tác vụ NLP.
Là một mô hình Transformer chỉ có decoder, nó được tối ưu cho tạo văn bản, cho đầu ra mạch lạc và phù hợp ngữ cảnh. Việc mô hình khả dụng theo Thỏa thuận Giấy phép Phần mềm Học thuật của Apple càng khuyến khích sự hợp tác và đổi mới trong cộng đồng AI.
Học AI với các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
