
Cursus
Concepten voor AWS-beveiliging en kostenbeheer
3 uur
11.3K
Cloud-native oplossingen worden in steeds meer sectoren populair vanwege hun veiligheid, flexibiliteit en schaalbaarheid. Een van die oplossingen is AWS Glue, dat datapreparatie vereenvoudigt—een kernonderdeel bij het nemen van geïnformeerde beslissingen en het optimaliseren van bedrijfsprocessen.
In deze tutorial gebruiken we AWS Glue om een veelvoorkomende ETL-taak (Extract, Transform, Load) te demonstreren: het converteren van CSV-bestanden die zijn opgeslagen in een S3-bucket naar Parquet-indeling. Met Parquet verbeter je zowel de efficiëntie van gegevensverwerking als de queryprestaties.
We introduceren AWS Glue, de kernfuncties en de voordelen van het automatiseren van datapreparatie. Daarna doorlopen we het instellen van je AWS-account, het aanmaken van IAM-rollen en het configureren van toegang tot je S3-bucket. Tot slot helpen we je bij het maken van een Glue-crawler om je datasets te scannen en Parquet-bestanden te genereren.
Voordat we met de praktische stappen beginnen, kijken we eerst wat AWS Glue is en waarom het nuttig is voor dataverwerkingstaken.
AWS Glue is een volledig beheerde ETL-service die het voorbereiden en laden van je data voor analytics eenvoudig maakt. Het biedt een serverloze omgeving om ETL-jobs te maken, uit te voeren en te monitoren. AWS Glue ontdekt en profileert je data automatisch via de AWS Glue Data Catalog, raadt ETL-code aan en genereert die, en biedt een flexibele planner voor het afhandelen van afhankelijkheden, jobmonitoring en retries.
Als je de voordelen van AWS Glue begrijpt, zie je beter de waarde in de dataverwerkingsworkflow. Er zijn meerdere sterke redenen om AWS Glue te gebruiken; hieronder staan er een aantal:
Waarom kiezen voor AWS Glue? Afbeelding door de auteur
Nu begint het leuke deel: leren hoe je Glue gebruikt voor een heel algemene dataverwerkingstaak: CSV-bestanden converteren naar Parquet.
Voor wie nieuw is met AWS: de eerste stap is een account aanmaken en vervolgens inloggen op de beheerconsole.
AWS Identity and Access Management (IAM) stelt gebruikers in staat om veilig toegang tot AWS-services en -resources te beheren.
We moeten een IAM-rol maken zodat Glue toegang heeft tot de relevante services. In ons geval is de belangrijkste service waar we toegang toe nodig hebben S3, waar onze CSV-bestanden staan.
De AWS Storage Tutorial is een mooie manier voor nieuwe AWS-gebruikers om meer te leren over systemen zoals S3.
De belangrijkste stappen om die IAM-rol te maken, zijn hieronder beschreven, startend vanuit de Management Console:
AWSGlueServiceRoleAmazonS3FullAccess (Let op: in een productieomgeving maak je beter een restrictiever beleid).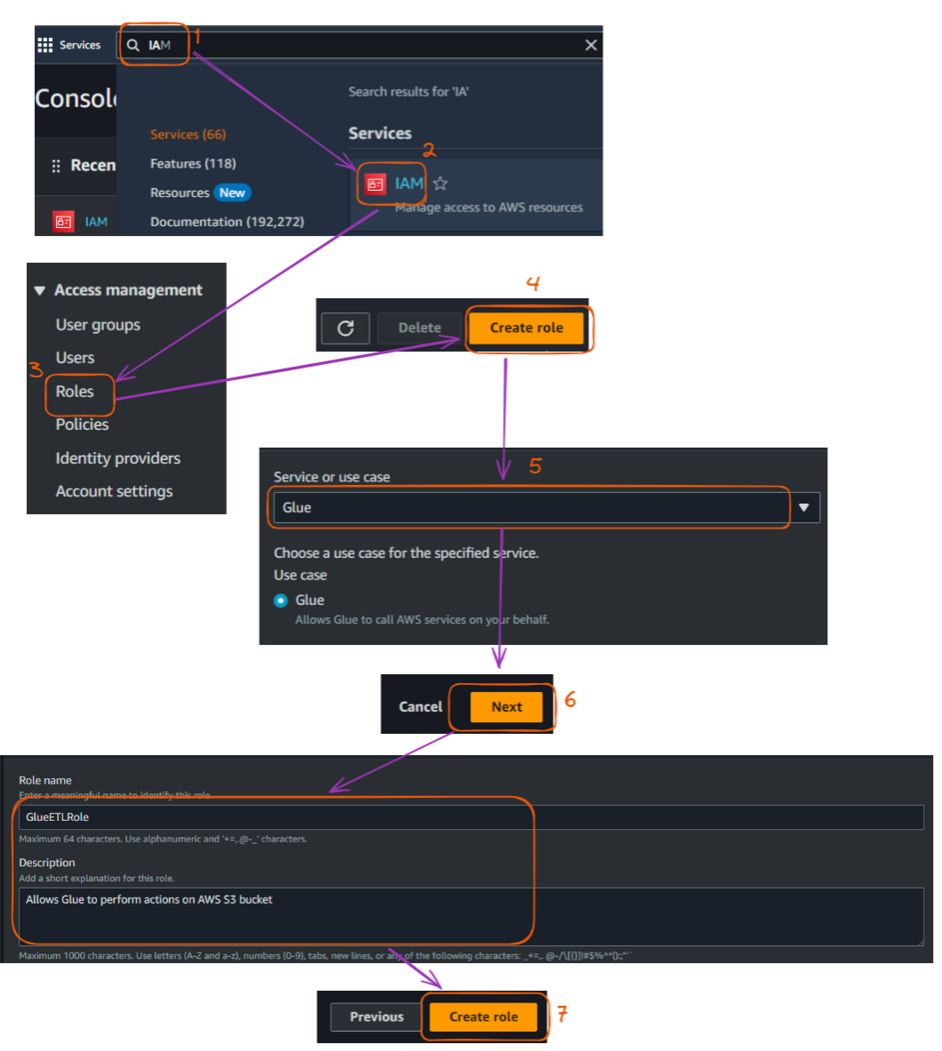
Stappen om een IAM-rol te maken in de AWS-console. Afbeelding door de auteur
De Complete gids voor AWS IAM doorloopt de stappen om IAM te gebruiken om AWS-omgevingen te beveiligen, toegang te beheren met users, groups en roles, en beste praktijken voor sterke beveiliging te schetsen.
We slaan zowel de input-CSV-bestanden als de output-Parquet-bestanden op Amazon S3 op.
De inputdata voor dit voorbeeld is gemaakt ter illustratie en is te vinden in de GitHub-repository van de auteur:
athletes.csv: Bevat informatie over atleten, inclusief hun ID, naam, land, sport en leeftijd.events.csv: Lijst met verschillende evenementen, inclusief event-ID, sport, eventnaam, datum en locatie.medals.csv: Registreert medaille-informatie, waarbij events en atleten worden gekoppeld aan de medailles die ze wonnen.Nu kunnen we onze S3-bucket als volgt inrichten:
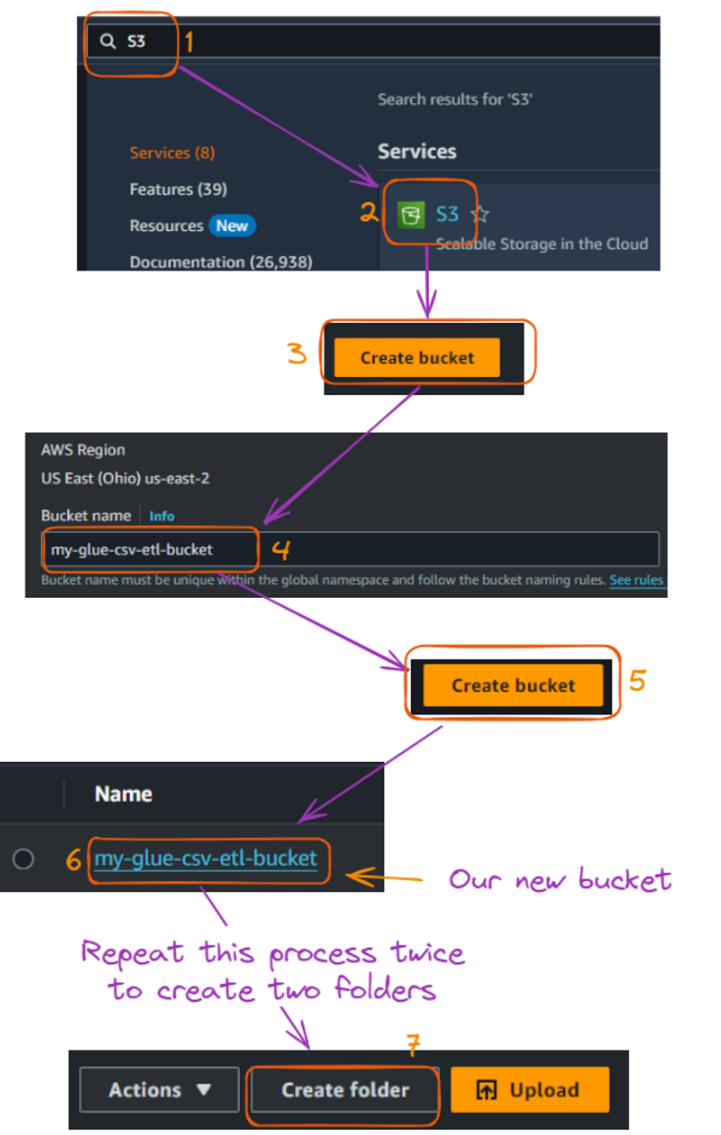
Flow voor het maken van S3-bucket en mappen. Afbeelding door de auteur
Na het maken van de twee mappen zou de inhoud van je bucket er als volgt uit moeten zien:
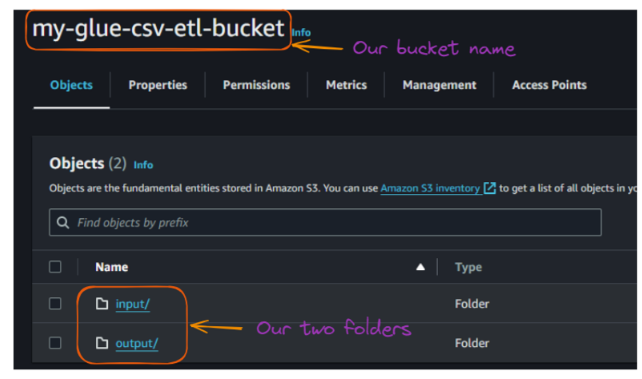
Weergave van de mappen in de S3-bucket. Afbeelding door de auteur
Nu kunnen we deze CSV-inputbestanden uploaden naar de map "input".
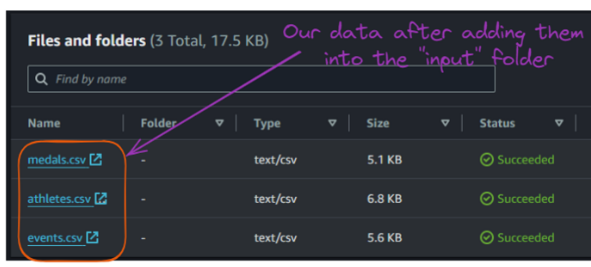
Inhoud van de map "input" in de S3-bucket. Afbeelding door de auteur
Een Glue-crawler wordt gebruikt om onze data automatisch te ontdekken en te catalogiseren. In dit onderdeel leggen we uit hoe je een crawler maakt die alle CSV-inputbestanden scant.
De belangrijkste stappen staan hieronder uitgelegd:
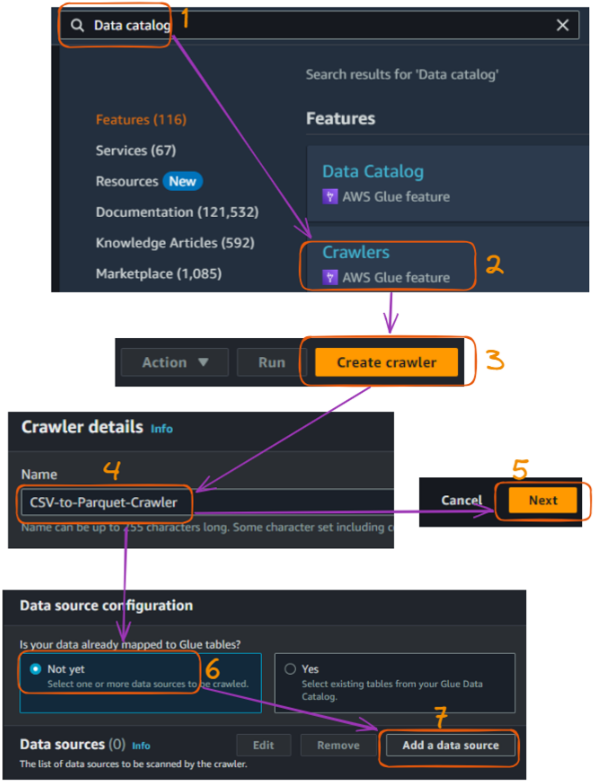
Flow voor het maken van een AWS Glue-crawler in de console - deel 1. Afbeelding door de auteur
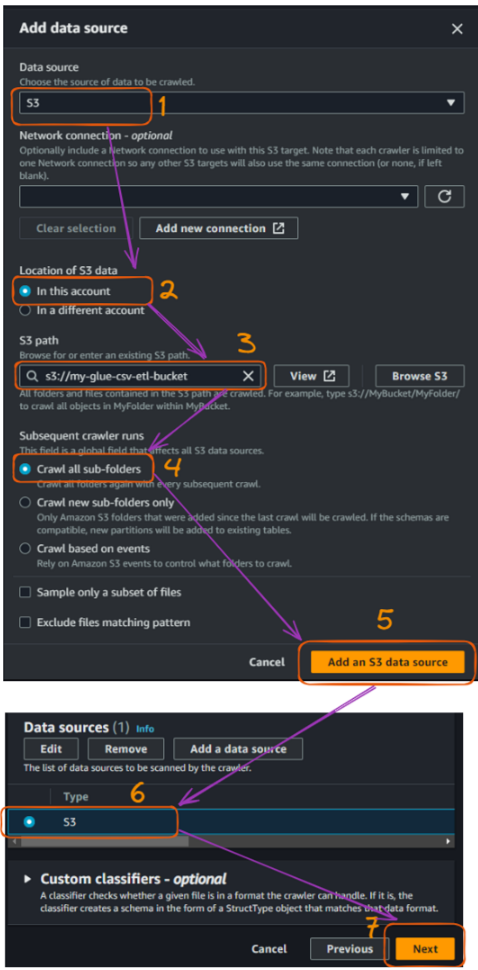
Flow voor het maken van een AWS Glue-crawler in de console - deel 2. Afbeelding door de auteur
Zodra we de S3-bucket hebben verbonden, moeten we de eerder gemaakte IAM-rol koppelen om Glue toegang te geven tot S3-buckets. De naam van onze rol is "GlueETLRole".
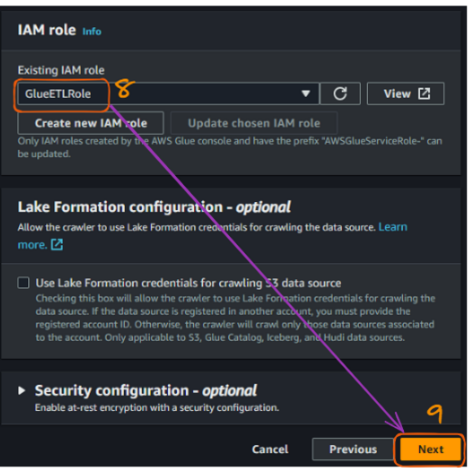
Flow voor het maken van een AWS Glue-crawler in de console - deel 3. Afbeelding door de auteur
De volgende stap is het aanmaken van een database. De database "paris_olympics_db" die we zullen maken, dient als centrale repository in de AWS Glue Data Catalog om metadata over onze CSV-bestanden op te slaan en te organiseren.
De catalogus maakt efficiënte data discovery mogelijk en vereenvoudigt ons ETL-proces voor het combineren en converteren van de data over atleten, events en medailles naar Parquet-indeling.
Op dit moment hebben we nog geen database; de stappen voor het aanmaken staan hieronder geïllustreerd:
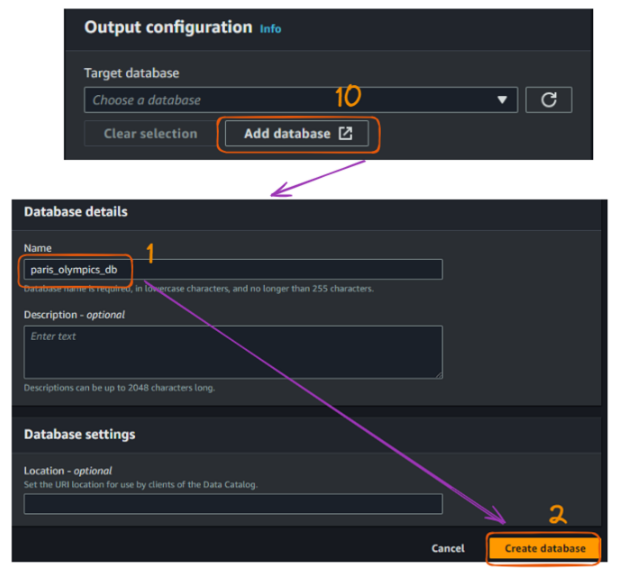
Flow voor het maken van een AWS Glue-crawler in de console - deel 4. Afbeelding door de auteur
Ga in het oorspronkelijke tabblad waar we een database verbinden naar de sectie "Target database", ververs deze en kies de zojuist aangemaakte database. Klik vervolgens op "Next".
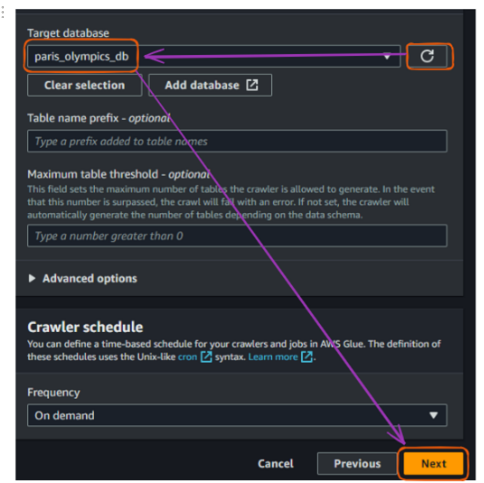
Flow voor het maken van een AWS Glue-crawler in de console - deel 5. Afbeelding door de auteur
Controleer tot slot alles en klik op "Create crawler".
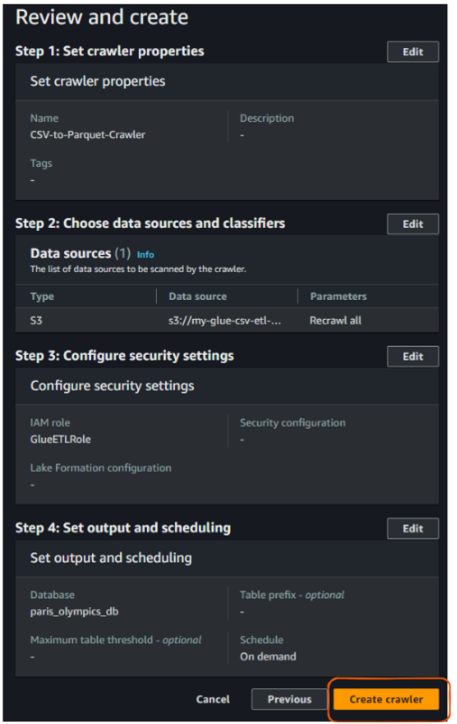
AWS Glue-crawler "Review and create"-weergave. Afbeelding door de auteur
Na het aanmaken van een crawler zouden we het volgende resultaat moeten zien dat de creatie bevestigt:
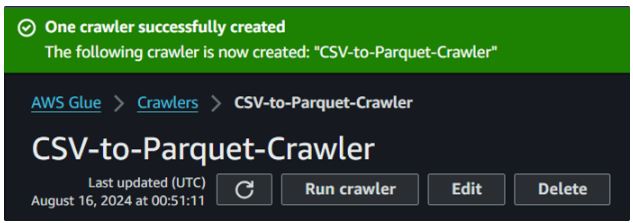
Glue-crawler succesvol aangemaakt. Afbeelding door de auteur
Nu we onze crawler hebben aangemaakt, is het tijd om hem uit te voeren en te zien hoe hij onze data catalogiseert.
Glue-knop "Run crawler". Afbeelding door de auteur
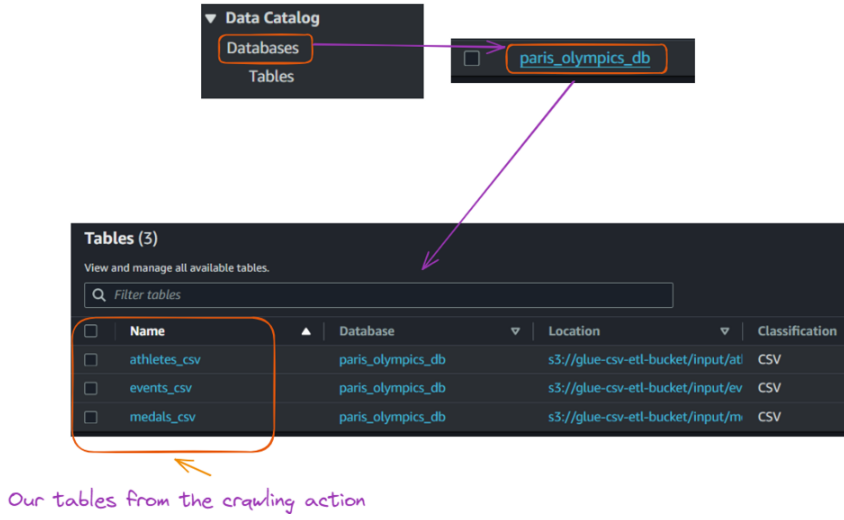
Weergave van tabellen die in de database zijn aangemaakt door de Glue-crawler. Afbeelding door de auteur
Met onze datacatalogus gereed, kunnen we nu een Glue-job maken om onze CSV-bestanden te combineren en te converteren naar Parquet-indeling. Dit onderdeel leidt je door het maken van de Glue-job en geeft de benodigde Python-code.
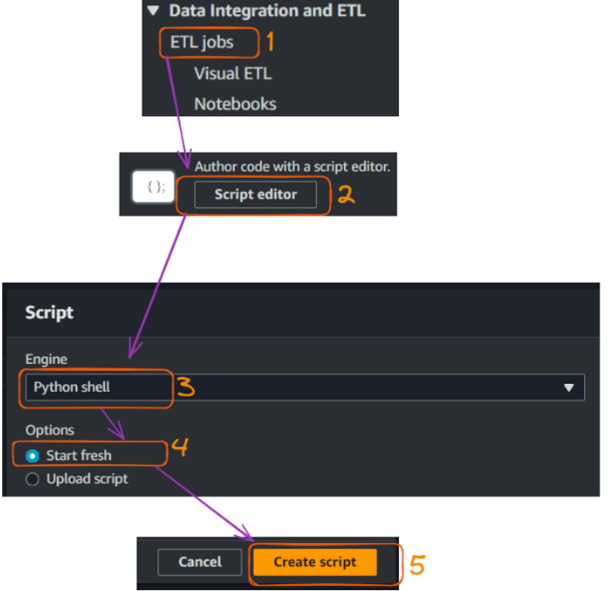
Een Glue-job maken en uitvoeren - deel 1. Afbeelding door de auteur
Door het script te maken, opent het volgende scripttabblad waar we de job een naam kunnen geven; in ons geval is dat "CS".
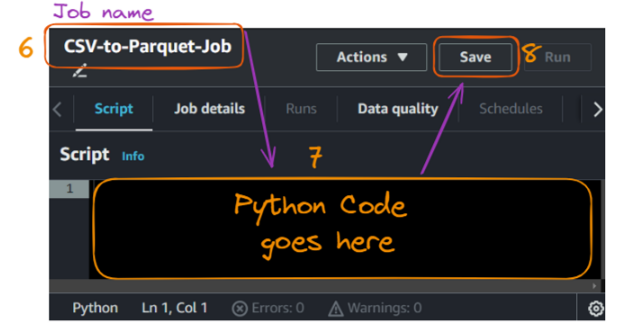
Een Glue-job maken en uitvoeren - deel 2. Afbeelding door de auteur
De bijbehorende Python-code staat hieronder:
import sys
from awsglue.transforms import *
from awsglue.utils import getResolvedOptions
from pyspark.context import SparkContext
from awsglue.context import GlueContext
from awsglue.job import Job
from pyspark.sql.functions import col, to_date

# Initialize the Spark and Glue contexts
sc = SparkContext()
glueContext = GlueContext(sc)
spark = glueContext.spark_session
job = Job(glueContext)

# Set Spark configurations for optimization
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")

# Get job parameters
args = getResolvedOptions(sys.argv, ['JOB_NAME'])

# Set the input and output paths
input_path = "s3://glue-csv-etl-bucket/input/"
output_path = "s3://glue-csv-etl-bucket/output/"

# Function to read CSV and write Parquet
def csv_to_parquet(input_file, output_file):
    try:
        # Read CSV
        df = spark.read.option("header", "true") \
                       .option("inferSchema", "true") \
                       .option("mode", "PERMISSIVE") \
                       .option("columnNameOfCorruptRecord", "_corrupt_record") \
                       .csv(input_file)

        # Print schema for debugging
        print(f"Schema for {input_file}:")
        df.printSchema()

        # Convert date column if it exists (assuming it's in the format M/d/yyyy)
        if "date" in df.columns:
            df = df.withColumn("date", to_date(col("date"), "M/d/yyyy"))

        # Write Parquet
        df.write.mode("overwrite").parquet(output_file)

        print(f"Successfully converted {input_file} to Parquet at {output_file}")
        print(f"Number of rows processed: {df.count()}")
    except Exception as e:
        print(f"Error processing {input_file}: {str(e)}")

# List of files to process
files = ["athletes", "events", "medals"]

# Process each file
for file in files:
    input_file = f"{input_path}{file}.csv"
    output_file = f"{output_path}{file}_parquet"
    csv_to_parquet(input_file, output_file)

job.commit()
print("Job completed.")
Laten we kort bekijken wat er in de code gebeurt:
csv_to_parquet() om een CSV-bestand te lezen, het schema te printen, een datumkolom te converteren als die bestaat, en de data als Parquet te schrijven. Verwerkt uitzonderingen tijdens het proces.athletes, events, medals) door de functie csv_to_parquet() op elk bestand aan te roepen.Voordat we de job uitvoeren, moeten we de volgende extra configuraties invullen in de sectie "Job details":
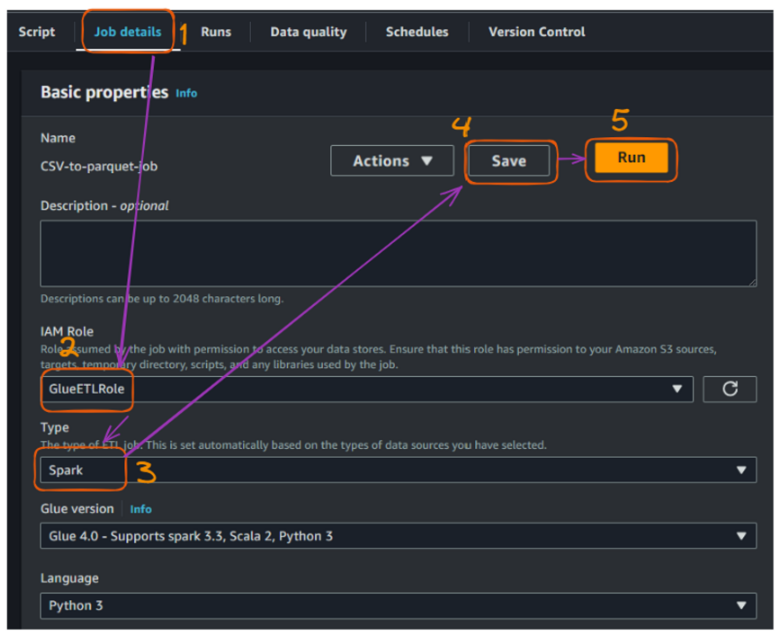
Een Glue-job maken en uitvoeren - deel 3. Afbeelding door de auteur
Na het succesvol uitvoeren van de job kunnen we meer details zien over de status van de uitvoering:
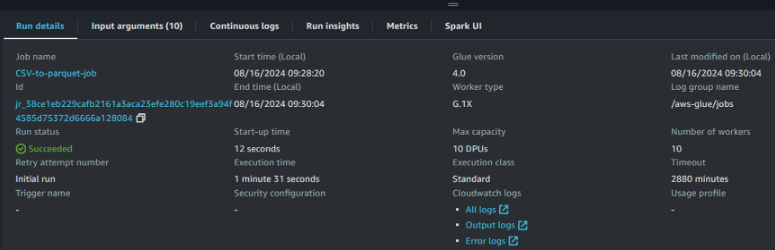
Weergave van jobrundetails in AWS Glue. Afbeelding door de auteur
Toegang tot en monitoring van de rundetails is belangrijk om efficiënte en betrouwbare datapijplijnen te onderhouden. Deze statistieken geven waardevolle inzichten en helpen bij het volgende:
De succesvolle uitvoering van deze job heeft elk CSV-bestand geconverteerd naar het bijbehorende Parquet-bestand en deze opgeslagen in de map "output", zoals hieronder weergegeven:
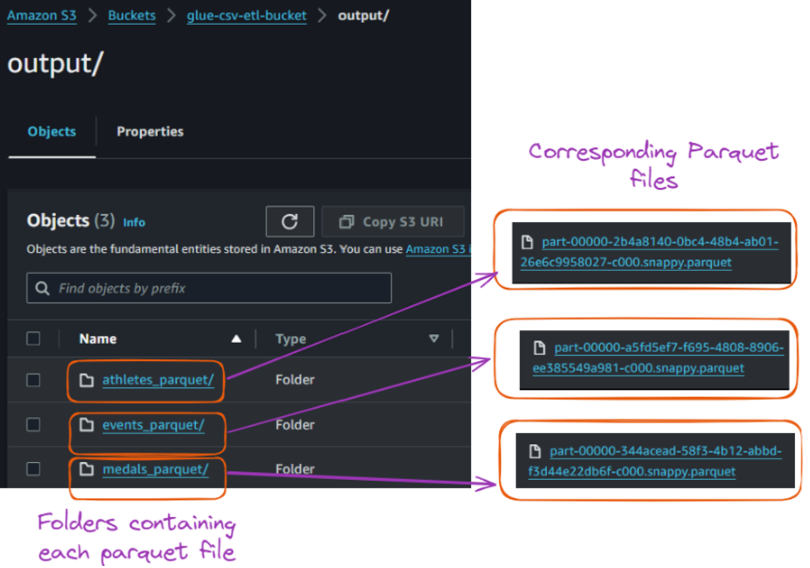
Inhoud van de map "output" in de S3-bucket. Afbeelding door de auteur
Deze tutorial besprak AWS Glue en de functies ervan. Je leerde een AWS-omgeving in te richten en de AWS Glue-interface te verkennen. Ook liet hij zien hoe je een Glue-crawler bouwt en uitvoert om data te catalogiseren, een Glue-job maakt om die te transformeren, en succesvol CSV-bestanden naar Parquet-indeling converteert.
Je kunt voortbouwen op wat je hebt geleerd door triggers in te stellen om workflows te automatiseren, foutafhandeling en logging te implementeren en Parquet-bestanden te optimaliseren voor nog betere prestaties. Je kunt je data ook query'en met AWS Athena of Amazon Redshift Spectrum.
Houd bovendien je AWS-gebruik en -kosten in de gaten en ruim resources op wanneer ze niet meer nodig zijn om onnodige kosten te voorkomen.
De cursussen Introduction to AWS en AWS Cloud Technology and Services zijn uitstekende volgende stappen om verder te leren!
De eerste biedt een solide basis in AWS en cloud computing, ideaal voor beginners of wie kernconcepten wil opfrissen. De tweede richt zich op praktijkgericht leren en helpt je je praktische kennis van AWS-services te verdiepen.
Leer meer over AWS en data engineering met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

