

AWS Glue: चरण-दर-चरण मार्गदर्शिका
अब आता है रोचक भाग: चलिए Glue का उपयोग एक बहुत सामान्य डेटा प्रोसेसिंग कार्य के लिए करना सीखते हैं: CSV फाइलों को Parquet में बदलना।
1. AWS खाता सेटअप
जो लोग AWS में नए हैं, उनके लिए पहला कदम एक खाता बनाना और फिर मैनेजमेंट कंसोल में साइन-इन करना होगा।
- AWS पर जाएँ और साइन अप करें।
- एक खाता बन जाने पर, AWS Management Console में लॉग इन करें।
2. IAM रोल बनाना
AWS Identity and Access Management (IAM) उपयोगकर्ताओं को AWS सेवाओं और संसाधनों तक सुरक्षित रूप से पहुंच प्रबंधित करने की अनुमति देता है।
हमें Glue को प्रासंगिक सेवाओं तक पहुंच देने के लिए एक IAM रोल बनाना होगा। हमारे मामले में, मुख्य सेवा S3 है, जो हमारी CSV फाइलों की होस्टिंग करती है।
नए AWS उपयोगकर्ताओं के लिए AWS Storage Tutorial S3 जैसे सिस्टम के बारे में अधिक जानने का एक शानदार तरीका है।
उस IAM रोल को बनाने के मुख्य चरण नीचे दिए गए हैं, जो मैनेजमेंट कंसोल से शुरू होते हैं:
- IAM सेवा पर जाएँ।
- बाएँ साइडबार में "Roles" पर क्लिक करें, फिर "Create role" पर क्लिक करें।
- "Choose a use case" के अंतर्गत, "Glue" चुनें और "Next: Permissions" पर क्लिक करें।
- निम्नलिखित पॉलिसी खोजें और चुनें:
AWSGlueServiceRoleAmazonS3FullAccess(नोट: प्रोडक्शन वातावरण में, आपको अधिक प्रतिबंधात्मक पॉलिसी बनानी चाहिए)।- अपने रोल का नाम दें (उदा., "GlueETLRole"), और चाहें तो विवरण दें, पर यह अनिवार्य नहीं है। अंत में, "Create role" पर क्लिक करें।
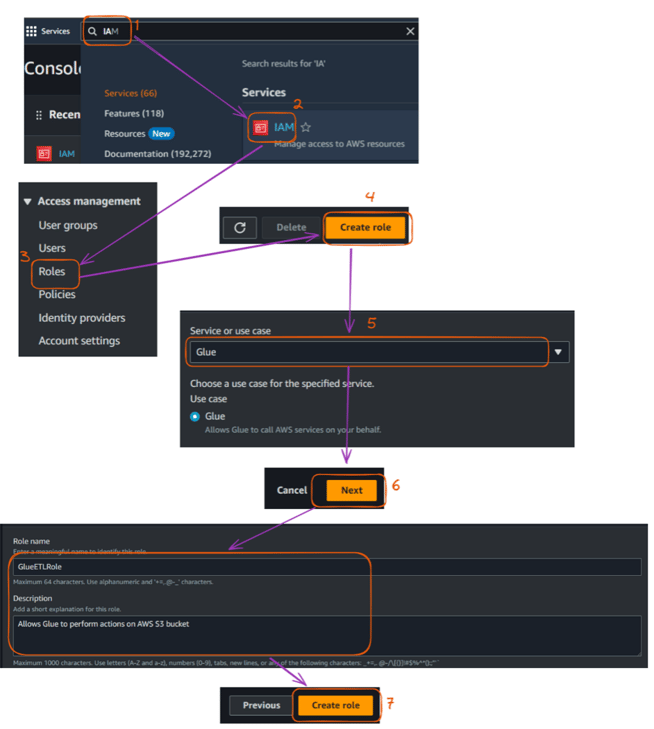
AWS कंसोल में IAM रोल बनाने के चरण। चित्र: लेखक द्वारा
The Complete Guide to AWS IAM AWS वातावरण को सुरक्षित करने, उपयोगकर्ता, समूह, और रोल के साथ एक्सेस प्रबंधन करने, और मजबूत सुरक्षा के सर्वोत्तम अभ्यासों की रूपरेखा बताने के चरणों से गुज़रता है।
3. S3 बकेट सेटअप
हम इनपुट CSV फाइलें और आउटपुट Parquet फाइलें दोनों Amazon S3 पर संग्रहीत करेंगे।
इस उदाहरण के लिए इनपुट डेटा चित्रण हेतु बनाया गया है और लेखक के GitHub रिपॉजिटरी में पाया जा सकता है:
athletes.csv: एथलीटों की जानकारी रखता है, जिनमें उनका ID, नाम, देश, खेल, और आयु शामिल है।events.csv: विभिन्न इवेंट्स की सूची देता है, जिनमें इवेंट ID, खेल, इवेंट नाम, तारीख और स्थल शामिल हैं।medals.csv: मेडल जानकारी रिकॉर्ड करता है, जो इवेंट्स और एथलीटों को उनके जीते गए मेडल्स से जोड़ता है।
अब, हम अपना S3 बकेट निम्नानुसार सेट कर सकते हैं:
- AWS Management Console में S3 सेवा पर जाएँ।
- "Create bucket" पर क्लिक करें और एक यूनिक नाम दें (उदा., "my-glue-csv-etl-bucket")।
- सरलता के लिए बकेट की डिफ़ॉल्ट सेटिंग्स ही रहने दें और बकेट बना दें।
- अपने बकेट के अंदर दो फोल्डर बनाएं: "input" और "output"।
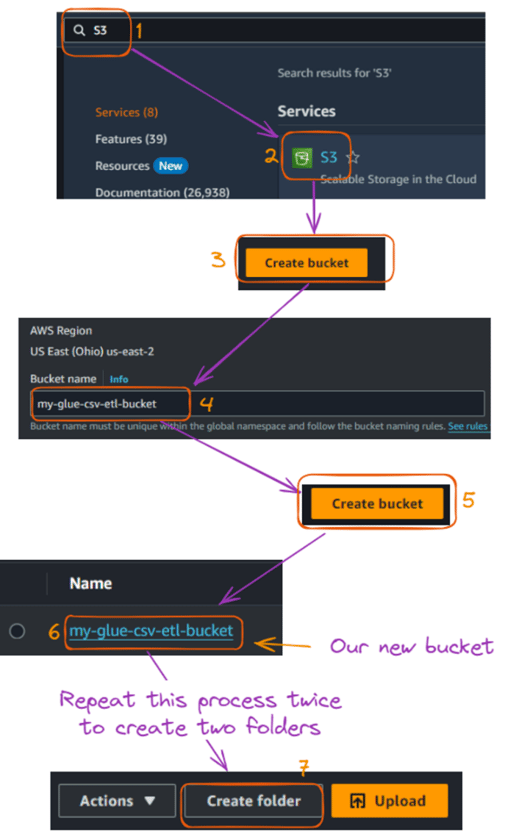
S3 बकेट और फोल्डर निर्माण प्रवाह। चित्र: लेखक द्वारा
दोनों फोल्डर बनाने के बाद, आपके बकेट की सामग्री कुछ इस प्रकार दिखनी चाहिए:
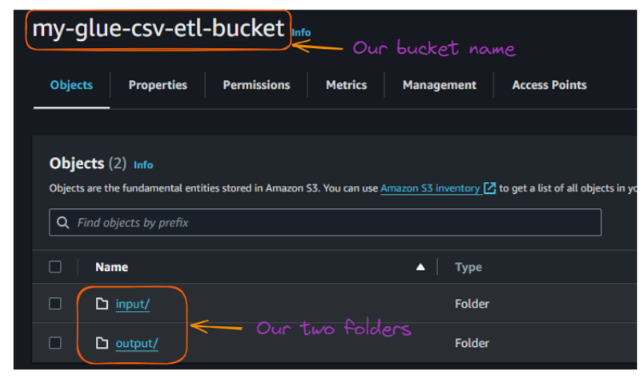
S3 बकेट के अंदर मौजूद फोल्डरों का दृश्य। चित्र: लेखक द्वारा
अब, हम इन इनपुट CSV फाइलों को "input" फोल्डर में अपलोड कर सकते हैं।
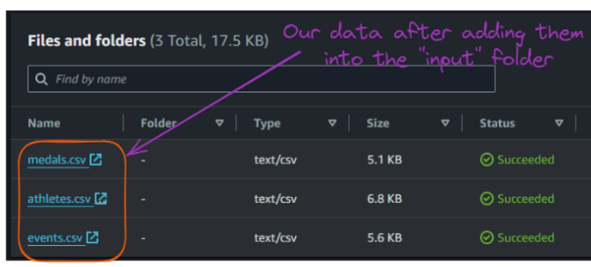
S3 बकेट के “input” फोल्डर की सामग्री। चित्र: लेखक द्वारा
4. Glue क्रॉलर बनाना
Glue क्रॉलर का उपयोग हमारे डेटा को स्वत: खोजने और कैटलॉग करने के लिए किया जाता है। इस खंड में उस क्रॉलर को बनाने की प्रक्रिया समझाई गई है, जो सभी इनपुट CSV फाइलों को स्कैन करेगा।
मुख्य चरण नीचे समझाए गए हैं:
- AWS Management Console में AWS Glue सेवा पर जाएँ।
- बाएँ साइडबार में "Data catalog" के अंतर्गत "Crawlers" पर क्लिक करें।
- "Create crawler" पर क्लिक करें।
- अपने क्रॉलर का नाम दें (उदा., "CSV-to-Parquet-Crawler") और विवरण फ़ील्ड खाली छोड़ दें, फिर "Next" पर क्लिक करें।
- हमें डेटा स्रोत के रूप में “S3” निर्दिष्ट करना है, जो "Add data source " को क्रॉलर सोर्स टाइप के रूप में चुनकर और "Next" पर क्लिक करके किया जाता है।
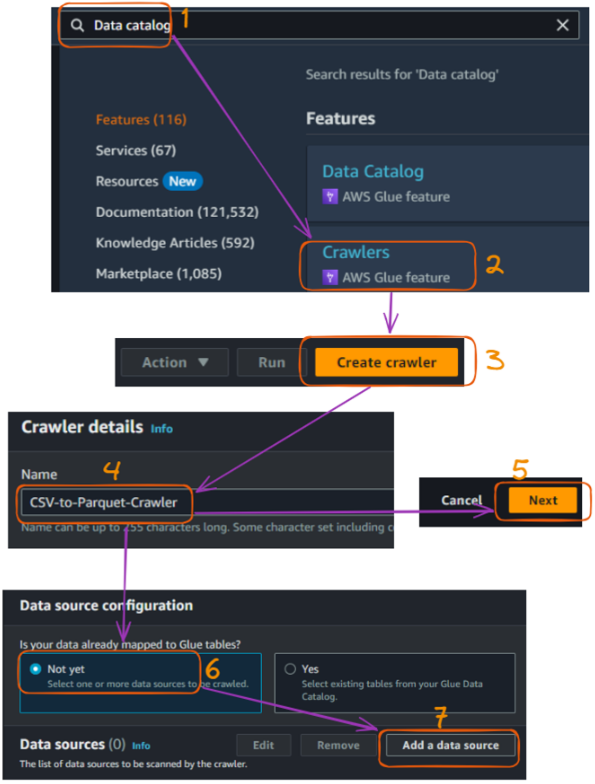
AWS Glue कंसोल में क्रॉलर निर्माण प्रवाह - भाग 1। चित्र: लेखक द्वारा
- डेटा स्टोर के रूप में "S3" चुनें और अपने S3 बकेट पाथ को निर्दिष्ट करें, जिसे आप “Browse S3” चुनकर कर सकते हैं। फिर "Next" पर क्लिक करें।
- “Crawl all sub-folders” चुनें
- “Add an S3 data source” चुनें, फिर "Next" पर क्लिक करें।
- आगे बढ़ने से पहले, “S3” डेटा टाइप की जाँच करें, फिर “Next।”
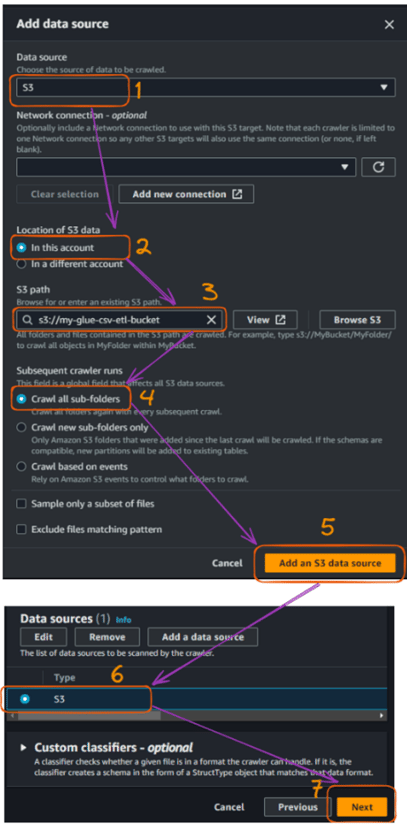
AWS Glue कंसोल में क्रॉलर निर्माण प्रवाह - भाग 2। चित्र: लेखक द्वारा
एक बार जब हमने S3 बकेट को कनेक्ट कर लिया, तो हमें पहले से बनाए गए IAM रोल को कनेक्ट करना होगा ताकि Glue S3 बकेट्स तक पहुंच सके। हमारे रोल का नाम “GlueETLRole” है।
- “Existing IAM role” फ़ील्ड से रोल का नाम चुनें।
- “Next” पर क्लिक करें।
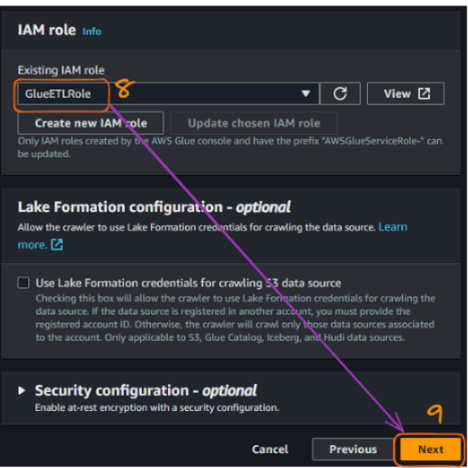
AWS Glue कंसोल में क्रॉलर निर्माण प्रवाह - भाग 3। चित्र: लेखक द्वारा
अगला चरण एक डेटाबेस बनाना है। हम जो “paris_olympics_db” डेटाबेस बनाएंगे, वह AWS Glue Data Catalog में एक केंद्रीय रिपॉजिटरी के रूप में काम करेगा, जहाँ हमारे CSV फाइलों के बारे में मेटाडेटा संग्रहीत और व्यवस्थित होगा।
यह कैटलॉग कुशल डेटा खोज सक्षम करेगा और हमारे ETL प्रोसेस को सरल बनाएगा, ताकि एथलीट्स, इवेंट्स और मेडल्स डेटा को मिलाकर Parquet फॉर्मेट में बदला जा सके।
इस समय, हमारे पास अभी तक कोई डेटाबेस नहीं है, और निर्माण के चरण नीचे दर्शाए गए हैं:
- “Add database” चुनें, जो हमारा डेटाबेस बनाने के लिए एक नई विंडो खोलेगा। इसे “paris_olympics_db” नाम दें और बाकी सब कुछ डिफ़ॉल्ट ही रहने दें, फिर “Create database” पर क्लिक करें।
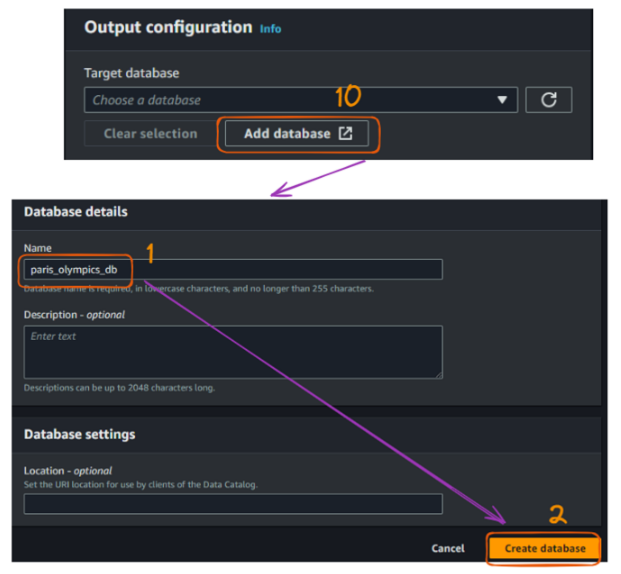
AWS Glue कंसोल में क्रॉलर निर्माण प्रवाह - भाग 4। चित्र: लेखक द्वारा
मूल टैब से जहाँ हम डेटाबेस कनेक्ट करते हैं, “Target database” सेक्शन को रिफ्रेश करें और नए बनाए गए डेटाबेस को चुनें। फिर “Next” पर क्लिक करें।
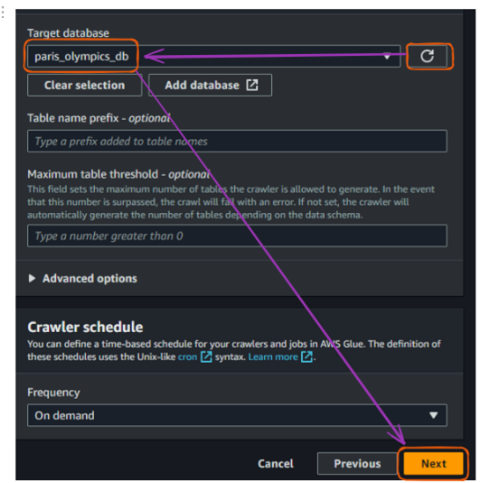
AWS Glue कंसोल में क्रॉलर निर्माण प्रवाह - भाग 5। चित्र: लेखक द्वारा
अंत में, सबकुछ समीक्षा करें और “Create crawler” पर क्लिक करें।
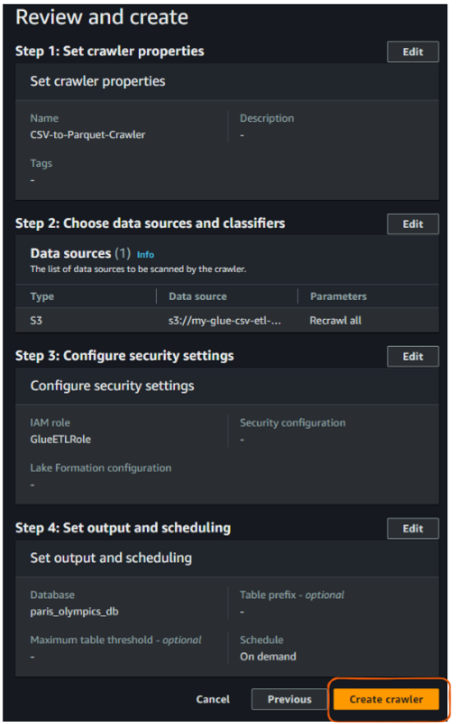
AWS Glue क्रॉलर “Review and create” दृश्य। चित्र: लेखक द्वारा
क्रॉलर बनाने की पिछली क्रिया के बाद, हमें इसके निर्माण की पुष्टि करते हुए निम्न परिणाम दिखाई देना चाहिए:
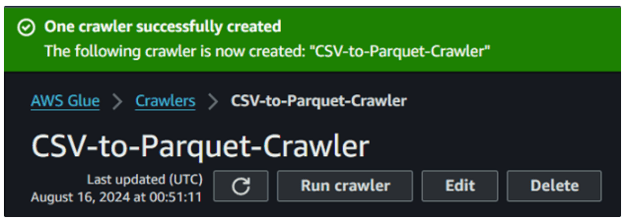
Glue क्रॉलर सफलतापूर्वक बनाया गया। चित्र: लेखक द्वारा
5. Glue क्रॉलर चलाना
अब जब हमने अपना क्रॉलर बना लिया है, तो इसे चलाने और यह देखने का समय है कि यह हमारे डेटा को कैसे कैटलॉग करता है।
Glue “Run crawler” बटन। चित्र: लेखक द्वारा
- सूची में से अपना क्रॉलर चुनें।
- "Run crawler" पर क्लिक करें।
- क्रॉलर के पूरा होने की प्रतीक्षा करें। इसमें कुछ मिनट लग सकते हैं।
- पूरा होने पर, बाएँ साइडबार में "Data catalog" के अंतर्गत "Databases" पर जाएँ।
- बनाए गए डेटाबेस पर क्लिक करें।
- आपको एक टेबल दिखनी चाहिए जो आपकी CSV डेटा संरचना का प्रतिनिधित्व करती है।
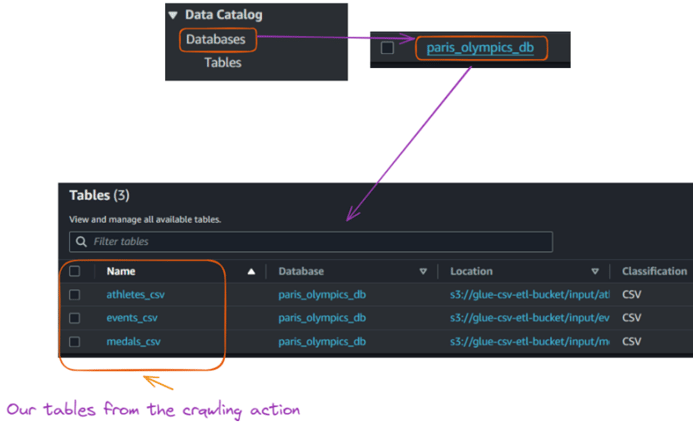
Glue क्रॉलर चलाने से डेटाबेस में बनी तालिकाओं का दृश्य। चित्र: लेखक द्वारा
6. Glue जॉब बनाना और चलाना
डेटा कैटलॉग बनने के बाद, अब हम एक Glue जॉब बना सकते हैं जो हमारी CSV फाइलों को मिलाकर उन्हें Parquet फॉर्मेट में बदल देगा। यह खंड Glue जॉब बनाने के चरणों से गुज़रता है और आवश्यक Python कोड प्रदान करता है।
- बाएँ साइडबार में AWS Glue कंसोल में "ETL" के अंतर्गत "Jobs" पर जाएँ।
- Script editor चुनें ताकि Python कोड लिखने के लिए एडिटर खुले, और “Create script” पर क्लिक करें।
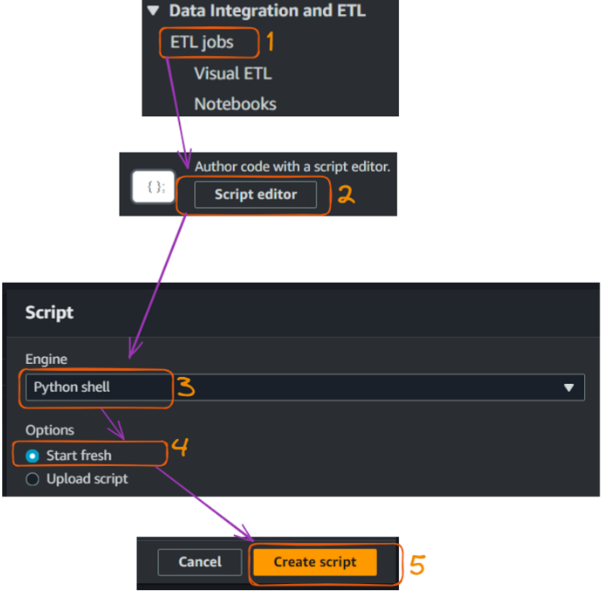
Glue जॉब बनाना और चलाना - भाग 1। चित्र: लेखक द्वारा
स्क्रिप्ट बनाने की क्रिया निम्न स्क्रिप्ट टैब खोलती है जहाँ हम जॉब को नाम दे सकते हैं, जो हमारे मामले में “CS” है।
- कोड सेक्शन के भीतर, निम्न कोड पेस्ट करें, फिर “Save” पर क्लिक करें।
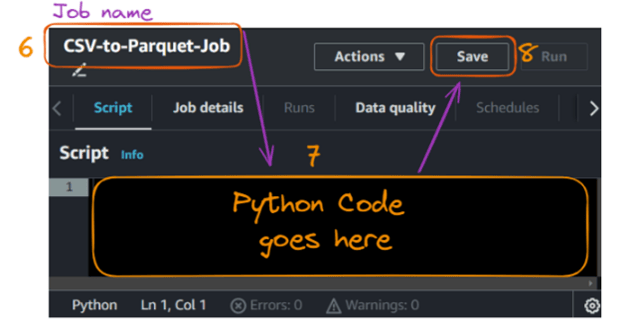
Glue जॉब बनाना और चलाना - भाग 2। चित्र: लेखक द्वारा
संबंधित Python कोड नीचे दिया गया है:
import sys
from awsglue.transforms import *
from awsglue.utils import getResolvedOptions
from pyspark.context import SparkContext
from awsglue.context import GlueContext
from awsglue.job import Job
from pyspark.sql.functions import col, to_date
# Initialize the Spark and Glue contexts
sc = SparkContext()
glueContext = GlueContext(sc)
spark = glueContext.spark_session
job = Job(glueContext)
# Set Spark configurations for optimization
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
# Get job parameters
args = getResolvedOptions(sys.argv, ['JOB_NAME'])
# Set the input and output paths
input_path = "s3://glue-csv-etl-bucket/input/"
output_path = "s3://glue-csv-etl-bucket/output/"
# Function to read CSV and write Parquet
def csv_to_parquet(input_file, output_file):
try:
# Read CSV
df = spark.read.option("header", "true") \
.option("inferSchema", "true") \
.option("mode", "PERMISSIVE") \
.option("columnNameOfCorruptRecord", "_corrupt_record") \
.csv(input_file)
# Print schema for debugging
print(f"Schema for {input_file}:")
df.printSchema()
# Convert date column if it exists (assuming it's in the format M/d/yyyy)
if "date" in df.columns:
df = df.withColumn("date", to_date(col("date"), "M/d/yyyy"))
# Write Parquet
df.write.mode("overwrite").parquet(output_file)
print(f"Successfully converted {input_file} to Parquet at {output_file}")
print(f"Number of rows processed: {df.count()}")
except Exception as e:
print(f"Error processing {input_file}: {str(e)}")
# List of files to process
files = ["athletes", "events", "medals"]
# Process each file
for file in files:
input_file = f"{input_path}{file}.csv"
output_file = f"{output_path}{file}_parquet"
csv_to_parquet(input_file, output_file)
job.commit()
print("Job completed.")आइए संक्षेप में समझें कि कोड में क्या हो रहा है:
- इम्पोर्ट्स: AWS Glue, PySpark, और Python की मानक लाइब्रेरी से आवश्यक लाइब्रेरीज़ इम्पोर्ट करता है।
- इनिशियलाइज़ेशन: Spark और Glue कॉन्टेक्स्ट को इनिशियलाइज़ करता है और अनुकूलन के लिए Spark कॉन्फ़िगरेशन सेट करता है।
- जॉब पैरामीटर्स: कमांड लाइन आर्ग्यूमेंट्स से जॉब नाम सहित पैरामीटर्स प्राप्त करता है।
- पाथ्स: S3 बकेट में CSV और Parquet फाइलों के लिए इनपुट और आउटपुट पाथ्स परिभाषित करता है।
- फंक्शन परिभाषा:
csv_to_parquet()फंक्शन परिभाषित करता है जो CSV फाइल पढ़ता है, उसकी स्कीमा प्रिंट करता है, यदि मौजूद हो तो डेट कॉलम को कन्वर्ट करता है, और डेटा को Parquet फाइल के रूप में लिखता है। प्रोसेसिंग के दौरान अपवादों को संभालता है। - फाइल प्रोसेसिंग: फाइलों की सूची (
athletes,events,medals) को प्रत्येक परcsv_to_parquet()कॉल करके प्रोसेस करता है। - जॉब कमिट: जॉब को कमिट करता है और पूर्ण होने का संदेश प्रिंट करता है।
जॉब चलाने से पहले, हमें “Job details” सेक्शन में निम्न अतिरिक्त कॉन्फ़िगरेशन भरने होंगे:
- पिछले चरण में बनाया गया IAM रोल प्रदान करें ताकि जॉब चल सके।
- जॉब “Type” को “Spark” पर सेट करें, बाकी फ़ील्ड्स डिफ़ॉल्ट रहने दें, और “Save” करें।
- फिर, जॉब चलाएँ!
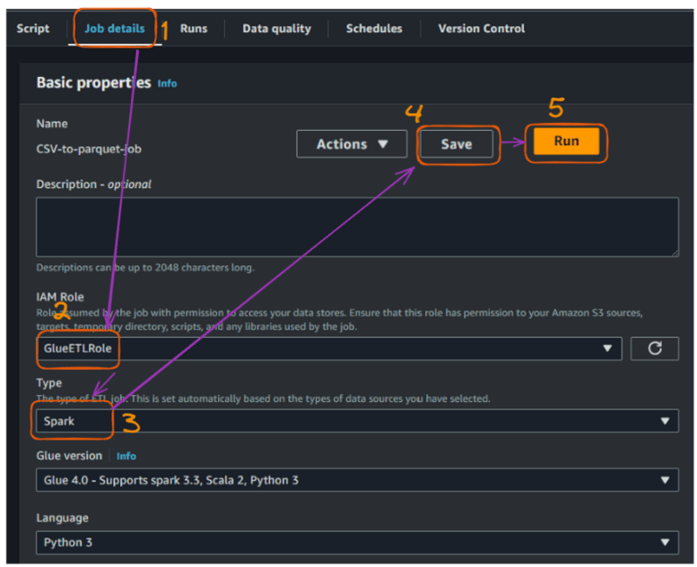
Glue जॉब बनाना और चलाना - भाग 3। चित्र: लेखक द्वारा
जॉब सफलतापूर्वक चलाने के बाद, हम निष्पादन की स्थिति के बारे में अधिक विवरण देख सकते हैं:
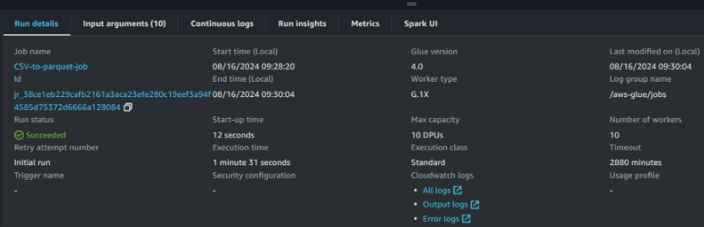
AWS Glue जॉब रन विवरण दृश्य। चित्र: लेखक द्वारा
रन विवरण तक पहुँच और मॉनिटरिंग करना कुशल और विश्वसनीय डेटा पाइपलाइन्स बनाए रखने के लिए महत्वपूर्ण है। ये मैट्रिक्स मूल्यवान इनसाइट्स प्रदान करते हैं और निम्न में मदद करते हैं:
- प्रदर्शन अनुकूलन: निष्पादन समय को ट्रैक करें ताकि जॉब की दक्षता और संसाधन आवंटन बेहतर हो सके।
- लागत प्रबंधन: संसाधन उपयोग (DPU, वर्कर्स) की निगरानी करें ताकि बजट के अनुरूप रहे और खर्च अनुकूलित हो।
- क्षमता योजना: निष्पादन मैट्रिक्स का उपयोग संसाधन आवश्यकताओं का पूर्वानुमान लगाने और स्केलेबिलिटी की योजना बनाने के लिए करें।
इस जॉब के सफल निष्पादन ने प्रत्येक CSV फाइल को उसके संबंधित Parquet फाइल में बदल दिया और उन्हें “output” फोल्डर में निम्नानुसार संग्रहीत किया:
- बाएँ तरफ हमारे पास मूल CSV फाइल के समान नाम वाले फोल्डर हैं।
- दाएँ तरफ प्रत्येक CSV फाइल के लिए Parquet फाइलें मौजूद हैं।
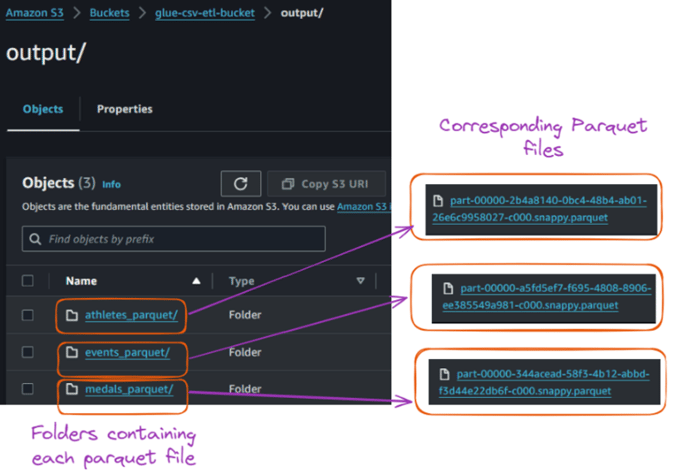
S3 बकेट के अंदर “output” फोल्डर की सामग्री। चित्र: लेखक द्वारा
निष्कर्ष और अगले कदम
इस ट्यूटोरियल में AWS Glue और इसकी विशेषताओं को शामिल किया गया। इसने आपको AWS वातावरण सेटअप करने और AWS Glue इंटरफ़ेस का अन्वेषण करने में मार्गदर्शन दिया। इसने यह भी दिखाया कि डेटा कैटलॉग करने के लिए Glue क्रॉलर कैसे बनाएं, उसे ट्रांसफॉर्म करने के लिए Glue जॉब कैसे बनाएं, और CSV फाइलों को सफलतापूर्वक Parquet फॉर्मेट में कैसे बदलें।
आप सीखे हुए को आगे बढ़ा सकते हैं—वर्कफ़्लो को स्वचालित करने के लिए ट्रिगर सेट करके, एरर हैंडलिंग और लॉगिंग लागू करके, और बेहतर प्रदर्शन के लिए Parquet फाइलों का अनुकूलन करके। आप AWS Athena या Amazon Redshift Spectrum के साथ अपने डेटा की क्वेरी करना भी एक्सप्लोर कर सकते हैं।
इसके अतिरिक्त, अपने AWS उपयोग और लागत की निगरानी करें और जब संसाधनों की आवश्यकता न हो तो उन्हें साफ़ करें ताकि अनावश्यक शुल्कों से बचा जा सके।
कोर्स Introduction to AWS और AWS Cloud Technology and Services आगे सीखने के लिए उत्कृष्ट अगले कदम हो सकते हैं!
पहला कोर्स AWS और क्लाउड कंप्यूटिंग की ठोस नींव प्रदान करता है, जो शुरुआती या प्रमुख अवधारणाओं की पुनरावृत्ति करने वालों के लिए उपयुक्त है। दूसरा कोर्स हाथ-से-सीखने पर केंद्रित है, जो AWS सेवाओं के आपके व्यावहारिक ज्ञान को और गहरा करने में मदद करता है।
FAQs
Parquet फाइल प्रदर्शन को अनुकूलित करने के लिए कुछ सर्वोत्तम अभ्यास क्या हैं?
Parquet फाइल प्रदर्शन को अनुकूलित करने के लिए, फाइल आकार समायोजित करें (आदर्शतः 128 MB से 1 GB), डेटा का विभाजन करें ताकि क्वेरी कुशल हो, और सही कंप्रेशन कोडेक (जैसे Snappy या Gzip) सेट करें। ये रणनीतियाँ I/O घटाती हैं और AWS Athena जैसे टूल्स में बड़े डेटासेट्स पर क्वेरी गति में सुधार करती हैं।
मैं AWS Glue जॉब्स में एरर हैंडलिंग और लॉगिंग कैसे लागू कर सकता/सकती हूँ?
AWS Glue, Amazon CloudWatch के साथ एकीकृत होता है, जो आपको जॉब स्थिति, त्रुटियाँ, और कस्टम लॉग ट्रैक करने की अनुमति देता है। आप अपने Glue जॉब्स को CloudWatch में लॉग लिखने के लिए कॉन्फ़िगर कर सकते हैं, जिससे प्रदर्शन मॉनिटर करना, समस्याओं का समाधान करना, और ETL प्रक्रियाओं का सुचारू निष्पादन सुनिश्चित करना आसान हो जाता है।
CSV-से-Parquet रूपांतरण से परे AWS Glue के कुछ सामान्य उपयोग मामले क्या हैं?
AWS Glue बहुमुखी है और डेटा डेडुप्लीकेशन, डेटा एनरिचमेंट, और स्कीमा ट्रांसफॉर्मेशन जैसे कार्य संभाल सकता है। इसे आमतौर पर कई स्रोतों (उदा., RDS, S3, Redshift) से डेटा को एकीकृत फ़ॉर्मेट में लाने, मशीन लर्निंग मॉडल्स के लिए डेटा तैयार करने, और डेटा लेक ट्रांसफॉर्मेशन करने के लिए उपयोग किया जाता है।
AWS Glue की तुलना Apache Airflow या Databricks जैसे अन्य ETL टूल्स से कैसे होती है?
AWS Glue एक पूर्ण-प्रबंधित, सर्वरलेस ETL सेवा है, जबकि Apache Airflow एक ओपन-सोर्स वर्कफ़्लो ऑर्केस्ट्रेशन टूल है जिसे अधिक कॉन्फ़िगरेशन और इन्फ्रास्ट्रक्चर प्रबंधन की आवश्यकता होती है। दूसरी ओर, Databricks बड़े पैमाने पर डेटा एनालिटिक्स और मशीन लर्निंग के लिए बनाया गया है। AWS Glue उपयोग में आसानी और अन्य AWS सेवाओं के साथ एकीकरण के लिए बढ़िया है, लेकिन अत्यधिक जटिल वर्कफ़्लोज़ के लिए Airflow या Databricks जैसे टूल अधिक लचीलापन प्रदान कर सकते हैं।
मैं ट्रिगर्स के साथ AWS Glue जॉब्स को कैसे स्वचालित कर सकता/सकती हूँ?
AWS Glue में ट्रिगर्स आपको ETL वर्कफ़्लो को स्वचालित करने देते हैं—जॉब्स को विशिष्ट समय पर या कुछ घटनाओं के बाद, जैसे S3 बकेट में नया डेटा आने पर, चलाने के लिए शेड्यूल किया जा सकता है। आप AWS Glue कंसोल के माध्यम से समय या ईवेंट-आधारित ट्रिगर्स सेट कर सकते हैं, जिससे बिना मैनुअल हस्तक्षेप के निर्बाध डेटा प्रोसेसिंग संभव होती है।

बहु-प्रतिभाशाली डेटा साइंटिस्ट जो अपना ज्ञान साझा करने और समुदाय को वापस देने में आनंद लेते हैं, ज़ूमाना YouTube पर कंटेंट क्रिएटर हैं और Medium पर शीर्ष तकनीकी लेखक हैं। उन्हें बोलने, कोडिंग करने और पढ़ाने में खुशी मिलती है। ज़ूमाना के पास दो मास्टर डिग्री हैं—पहली पेरिस, फ्रांस से कंप्यूटर साइंस में, मशीन लर्निंग पर केंद्रित, और दूसरी अमेरिका के टेक्सास टेक यूनिवर्सिटी से डेटा साइंस में। उनका करियर फ्रांस में Groupe OPEN में सॉफ्टवेयर डेवलपर के रूप में शुरू हुआ, जिसके बाद वे IBM में मशीन लर्निंग कंसल्टेंट बने, जहाँ उन्होंने बीमा कंपनियों के लिए एंड-टू-एंड एआई समाधान विकसित किए। ज़ूमाना ने Axionable, पेरिस और मॉन्ट्रियल स्थित पहली Sustainable AI स्टार्टअप, से जुड़कर डेटा साइंटिस्ट के रूप में काम किया और फ्रांस, मॉन्ट्रियल, सिंगापुर और स्विट्ज़रलैंड के क्लाइंट्स के लिए मुख्यतः NLP उपयोग मामलों पर आधारित एआई प्रोडक्ट्स लागू किए। इसके अतिरिक्त, अपने समय का 5% उन्होंने अनुसंधान और विकास को समर्पित किया। वर्तमान में, वे IFC - The World Bank Group में सीनियर डेटा साइंटिस्ट के रूप में कार्यरत हैं।
सुरक्षा, लचीलापन, और स्केलेबिलिटी के कारण क्लाउड-नेटिव समाधान विभिन्न उद्योगों में तेजी से लोकप्रिय हो रहे हैं। ऐसा ही एक समाधान AWS Glue है, जो डेटा प्रोसेसिंग को सरल बनाता है—जो सूचित निर्णय लेने और व्यावसायिक संचालन को अनुकूलित करने का मूल घटक है।
इस ट्यूटोरियल में, हम AWS Glue का उपयोग एक सामान्य ETL (Extract, Transform, Load) कार्य को प्रदर्शित करने के लिए करेंगे: S3 बकेट में संग्रहीत CSV फाइलों को Parquet फॉर्मेट में बदलना। Parquet का उपयोग डेटा प्रोसेसिंग दक्षता और क्वेरी प्रदर्शन—दोनों—को बेहतर बनाता है।
हम AWS Glue, इसकी मुख्य विशेषताओं, और डेटा तैयारी को स्वचालित करने के लाभों का परिचय देंगे। इसके बाद, हम आपके AWS खाते की सेटअप, IAM रोल बनाने, और आपके S3 बकेट तक पहुंच कॉन्फ़िगर करने की प्रक्रिया समझेंगे। अंत में, हम आपको Glue क्रॉलर बनाने में मार्गदर्शन करेंगे, जो आपके डेटासेट को स्कैन करेगा और Parquet फाइलें जनरेट करेगा।
AWS Glue क्या है?
व्यावहारिक चरणों पर आगे बढ़ने से पहले, आइए पहले समझें कि AWS Glue क्या है और यह डेटा प्रोसेसिंग कार्यों के लिए क्यों उपयोगी है।
AWS Glue एक पूर्ण-प्रबंधित ETL सेवा है जो एनालिटिक्स के लिए आपका डेटा तैयार करना और लोड करना आसान बनाती है। यह ETL जॉब्स बनाने, चलाने और मॉनिटर करने के लिए सर्वरलेस वातावरण प्रदान करती है। AWS Glue, AWS Glue Data Catalog के माध्यम से आपके डेटा की स्वत: खोज और प्रोफाइलिंग करती है, ETL कोड की सिफारिश और जनरेशन करती है, और निर्भरता समाधान, जॉब मॉनिटरिंग, और रीट्राइज़ संभालने के लिए एक लचीला शेड्यूलर प्रदान करती है।
AWS Glue का उपयोग क्यों करें?
AWS Glue के लाभों को समझना आपको डेटा प्रोसेसिंग वर्कफ़्लो में इसकी उपयोगिता का मूल्यांकन करने में मदद करेगा। AWS Glue का उपयोग करने के कई ठोस कारण हैं, जिनमें से कुछ नीचे दर्शाए गए हैं:
AWS Glue क्यों चुनें? चित्र: लेखक द्वारा