

कोर्स
LangChain के साथ Retrieval Augmented Generation (RAG)
3 घंटा
21.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंRetrieval-Augmented Generation (RAG) इस समय AI में सबसे रोमांचक तकनीकों में से एक है। यह विशाल डेटासेट्स से वास्तविक जानकारी प्राप्त करने की सटीकता को बड़े भाषा मॉडलों की तर्कशक्ति के साथ जोड़ता है। नतीजा? प्रतिक्रियाएँ जो न सिर्फ़ सटीक होती हैं बल्कि गहराई से प्रासंगिक भी। यही कारण है कि RAG चैटबॉट्स और सर्च इंजनों से लेकर व्यक्तिगत सामग्री तक, हर चीज़ को शक्ति दे रहा है।
लेकिन ध्यान दें: प्रोटोटाइप बनाना सिर्फ़ आधी लड़ाई है। असली चुनौती डिप्लॉयमेंट में है—यानी आपके विचार को एक भरोसेमंद, स्केलेबल प्रोडक्ट में बदलना।
इस लेख में, मैं आपको दिखाऊँगा कि RAG सिस्टम कैसे बनाना और डिप्लॉय करना है LangChain और FastAPI का उपयोग करके। आप सीखेंगे कि काम करने वाले प्रोटोटाइप से वास्तविक उपयोगकर्ताओं के लिए तैयार फुल-स्केल एप्लिकेशन तक कैसे पहुँचा जाए।
चलिए शुरू करते हैं!
जैसा कि हम एक अलग गाइड में एक्सप्लोर करते हैं, Retrieval-Augmented Generation, या RAG, प्राकृतिक भाषा प्रसंस्करण में एक काफ़ी उन्नत विधि है जो भाषा मॉडलों की क्षमताओं को वाकई नए स्तर पर ले जाती है।
सिर्फ़ मॉडल के पहले से सीखे हुए ज्ञान पर निर्भर रहने के बजाय, RAG प्रतिक्रिया जनरेट करने से पहले बाहरी स्रोतों से नया, प्रासंगिक डेटा खींचकर उसे शामिल करता है।
यह ऐसे काम करता है: जब कोई यूज़र सवाल पूछता है, तो सिस्टम सिर्फ़ मॉडल के प्री-लर्न्ड डेटा पर निर्भर नहीं करता। यह पहले बड़े डॉक्युमेंट सेट्स या डेटा स्रोतों में खोज करता है, सबसे प्रासंगिक हिस्से चुनता है, और उन्हें भाषा मॉडल में फ़ीड करता है। अपने आंतरिक ज्ञान और नए प्राप्त डेटा—दोनों के साथ—मॉडल अधिक सटीक और ताज़ा प्रतिक्रिया बना सकता है।
RAG रिट्रीवल और जनरेशन को मिलाता है, इसलिए प्रतिक्रियाएँ सिर्फ़ स्मार्ट नहीं होतीं—वे वास्तविक, तथ्यात्मक जानकारी पर आधारित भी होती हैं। यह प्रश्नोत्तर, चैटबॉट्स, या ऐसी सामग्री बनाने के लिए बेहतरीन है जहाँ तथ्य सही होना और संदर्भ समझना बेहद मायने रखता है।
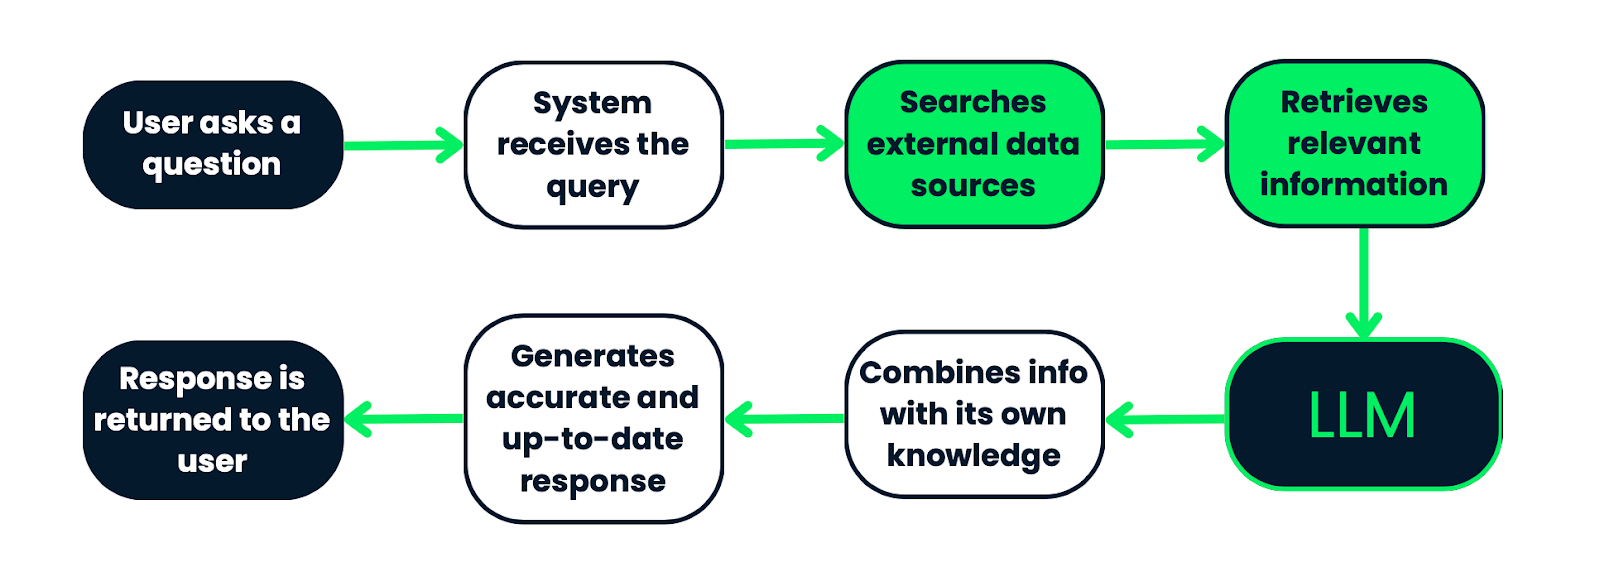
RAG सिस्टम का वर्कफ़्लो। यह यूज़र क्वेरी से शुरू होता है, जिसे सिस्टम प्रासंगिक जानकारी के लिए बाहरी डेटा स्रोतों में खोजता है। प्राप्त जानकारी फिर एक LLM को दी जाती है, जो इसे अपने मौजूदा ज्ञान के साथ मिलाकर सटीक और नवीनतम उत्तर जनरेट करता है। अंत में, यह प्रतिक्रिया यूज़र को वापस की जाती है। यह प्रक्रिया सुनिश्चित करती है कि प्रतिक्रियाएँ तथ्यात्मक और संदर्भानुकूल डेटा पर आधारित हों।
जब आप RAG सिस्टम बना रहे होते हैं, तो इसे चालू करने के लिए कुछ आवश्यक हिस्से होते हैं: डॉक्युमेंट लोडर्स, टेक्स्ट स्प्लिटिंग, इंडेक्सिंग, रिट्रीवल मॉडल्स, और जनरेटिव मॉडल्स। आइए इसे सरलता से समझें:
पहला कदम है आपके डेटा को तैयार करना। यही काम डॉक्युमेंट लोडर्स, टेक्स्ट स्प्लिटिंग और इंडेक्सिंग करते हैं:
ये RAG सिस्टम का दिल हैं। ये इंडेक्स किए गए डेटा में से ज़रूरी हिस्से ढूँढने के ज़िम्मेदार होते हैं।
यही वह जगह है जहाँ “मैजिक” होता है। प्रासंगिक डेटा मिल जाने के बाद जनरेटिव मॉडल अंतिम प्रतिक्रिया तैयार करते हैं।
|
घटक |
वर्णन |
|
Document Loaders |
टेक्स्ट फ़ाइलें, PDF या डेटाबेस जैसे स्रोतों से डेटा लाते हैं और जानकारी को सिस्टम के लिए उपयोगी फ़ॉर्मेट में बदलते हैं। |
|
Text Splitting |
लोड किए गए डेटा को छोटे-छोटे हिस्सों में बाँटता है, जिससे भाषा मॉडलों की सीमाओं के भीतर सर्च और प्रोसेस करना आसान हो जाता है। |
|
Indexing |
स्प्लिट किए गए डेटा को वेक्टर रिप्रेजेंटेशन्स में व्यवस्थित करता है, जिससे क्वेरी के लिए प्रासंगिक जानकारी तेज़ और कुशल खोज के जरिए मिल सके। |
|
Vector Stores |
वेक्टर रिप्रेजेंटेशन्स को स्टोर करने वाले विशेष डेटाबेस, जो क्वेरी के आधार पर सबसे प्रासंगिक जानकारी निकालने के लिए वेक्टर सिमिलैरिटी सर्च का उपयोग करते हैं। |
|
Retrievers |
सर्च घटक जो क्वेरी को वेक्टर में बदलते हैं, वेक्टर स्टोर में खोजते हैं, और अगले चरण के लिए सबसे प्रासंगिक डेटा चंक्स निकालते हैं। |
|
Language Models |
प्राप्त डेटा और आंतरिक ज्ञान—दोनों—का उपयोग करके सुसंगत और संदर्भानुकूल प्रतिक्रियाएँ जनरेट करते हैं। |
|
Contextual Response Generation |
यूज़र के प्रश्न को प्राप्त डेटा के साथ मिलाकर ऐसा विस्तृत उत्तर बनाता है जो प्रश्न का समाधान करे और प्रासंगिक जानकारी को शामिल करे। |
RAG सिस्टम बनाने से पहले, हमें सुनिश्चित करना होगा कि हमारा डेवलपमेंट एनवायरनमेंट ठीक से सेट है। आपको ये चीज़ें चाहिए होंगी:
python --versionpython3 -m venv ragenv
source ragenv/bin/activate # For Linux/Mac
ragenv\Scripts\activate # For Windowsडिपेंडेंसीज़ इंस्टॉल करें: अब pip का उपयोग करके आवश्यक पैकेज इंस्टॉल करें।
pip install fastapi uvicorn langchain langchain-community openai langchain-openai faiss-cpu|
FastAPI |
Uvicorn |
LangChain |
OpenAI API |
|
API बनाने के लिए एक आधुनिक वेब फ़्रेमवर्क। |
आपके FastAPI एप्लिकेशन को सर्व करने के लिए एक ASGI सर्वर। |
वह मुख्य लाइब्रेरी जो RAG सिस्टम को शक्ति देती है। |
प्रतिक्रिया जनरेट करने के लिए GPT मॉडल्स का उपयोग करने हेतु। |
प्रो टिप: अपने प्रोजेक्ट के लिए आवश्यक पैकेज बताने हेतु requirements.txt फ़ाइल ज़रूर बनाएँ। यदि आप उपयोग करते हैं: pip freeze > requirements.txt
यह कमांड सभी इंस्टॉल्ड पैकेज और उनके वर्ज़न के साथ requirements.txt फ़ाइल जनरेट कर देगी, जिसका उपयोग आप डिप्लॉयमेंट या दूसरों के साथ एनवायरनमेंट साझा करने में कर सकते हैं।
अपनी OpenAI API Key जोड़ें: OpenAI भाषा मॉडल को अपने RAG सिस्टम में इंटीग्रेट करने के लिए, आपको अपनी OpenAI API key देनी होगी:
OPENAI_API_KEY=your-openai-api-keypip install python-dotenvfrom dotenv import load_dotenv
import os
load_dotenv()
openai_api_key = os.getenv("OPENAI_API_KEY")अब आपकी OpenAI API key एनवायरनमेंट से सुरक्षित रूप से लोड हो रही है, और आप इसे अपने RAG सिस्टम में उपयोग करने के लिए तैयार हैं!
PostgreSQL और PGVector (वैकल्पिक): यदि आप वेक्टर स्टोरेज के लिए PGVector का उपयोग करने की योजना बना रहे हैं, तो अपने मशीन पर PostgreSQL इंस्टॉल और सेट अप करना सुनिश्चित करें। आप FAISS (जिसका हम इस लेख में उपयोग करेंगे) या LangChain द्वारा समर्थित अन्य वेक्टर डेटाबेस का भी उपयोग कर सकते हैं।
Docker (वैकल्पिक): Docker आपकी एप्लिकेशन को कंटेनराइज़ करने में मदद कर सकता है ताकि विभिन्न एनवायरनमेंट्स में डिप्लॉयमेंट एकसमान रहे। यदि आप Docker का उपयोग करने की योजना बना रहे हैं, तो सुनिश्चित करें कि यह आपकी मशीन पर इंस्टॉल हो।
RAG सिस्टम बनाने का पहला कदम उन डेटा को तैयार करना है जिनका उपयोग सिस्टम प्रासंगिक जानकारी प्राप्त करने के लिए करेगा। इसमें डॉक्युमेंट्स को सिस्टम में लोड करना, उन्हें प्रोसेस करना, और फिर यह सुनिश्चित करना शामिल है कि वे ऐसे फ़ॉर्मेट में हों जिन्हें आसानी से इंडेक्स और रिट्रीव किया जा सके।
LangChain विभिन्न डेटा स्रोतों—जैसे टेक्स्ट फ़ाइलें, PDF, या वेब पेज—के लिए कई डॉक्युमेंट लोडर्स प्रदान करता है। आप इन लोडर्स का उपयोग करके अपने डॉक्युमेंट्स को सिस्टम में ला सकते हैं।
मुझे ध्रुवीय भालुओं के प्रति आकर्षण है, इसलिए मैंने निम्नलिखित टेक्स्ट फ़ाइल (my_document.txt) अपलोड करने का निर्णय लिया है जिसमें यह जानकारी है:“Polar Bears: The Arctic Giants
Polar bears (Ursus maritimus) पृथ्वी के सबसे बड़े स्थलीय मांसाहारी हैं, और वे आर्कटिक की चरम ठंड में जीवन के लिए पूरी तरह अनुकूलित हो गए हैं। अपने घने सफेद फर के लिए जाने जाते हैं, जो उन्हें बर्फीले परिदृश्य में घुलने-मिलने में मदद करता है, ध्रुवीय भालू शक्तिशाली शिकारी हैं, जो सील—अपने प्रमुख भोजन स्रोत—का शिकार करने के लिए समुद्री बर्फ पर निर्भर रहते हैं।
ध्रुवीय भालुओं के बारे में जो बात आकर्षक है, वह है उनके परिवेश के अनुरूप उनकी अविश्वसनीय अनुकूलन क्षमता। उस घने फर के नीचे वसा की एक परत होती है जो 4.5 इंच तक मोटी हो सकती है, जो कठोर सर्दी के महीनों में इन्सुलेशन और ऊर्जा भंडार प्रदान करती है। उनके बड़े पंजे उन्हें बर्फ और खुले पानी—दोनों पर चलने में मदद करते हैं, जिससे वे मज़बूत तैराक बनते हैं—जो भोजन या नए क्षेत्र की तलाश में लंबी दूरी तय कर सकते हैं।
दुर्भाग्य से, जलवायु परिवर्तन के कारण ध्रुवीय भालू गंभीर खतरों का सामना कर रहे हैं। जैसे-जैसे आर्कटिक गरम होता है, समुद्री बर्फ साल में पहले पिघलती है और बाद में बनती है, जिससे ध्रुवीय भालुओं के पास सील का शिकार करने का समय कम हो जाता है। पर्याप्त भोजन न होने पर कई भालुओं के लिए जीवित रहना कठिन हो जाता है, और कुछ क्षेत्रों में उनकी आबादी घट रही है।
ध्रुवीय भालू आर्कटिक पारिस्थितिकी तंत्र के स्वास्थ्य को बनाए रखने में महत्वपूर्ण भूमिका निभाते हैं, और उनकी दुर्दशा दुनिया के वन्यजीवों पर जलवायु परिवर्तन के व्यापक प्रभावों की एक शक्तिशाली याद दिलाती है। उनके आवास की रक्षा करने और यह सुनिश्चित करने के लिए कि ये शानदार जीव जंगली में फलते-फूलते रहें, संरक्षण प्रयास चल रहे हैं।”
from langchain_community.document_loaders import TextLoader
loader = TextLoader('data/my_document.txt')
documents = loader.load()
यहाँ एक साधारण टेक्स्ट फ़ाइल सिस्टम में लोड की गई है—सिर्फ़ शैक्षणिक उदाहरण के रूप में—लेकिन आप चाहें तो किसी भी प्रकार के डॉक्युमेंट जोड़ सकते हैं! उदाहरण के लिए, आप अपने संगठन की आंतरिक डॉक्युमेंटेशन भी जोड़ सकते हैं। अब documents वेरिएबल में फ़ाइल की सामग्री मौजूद है, प्रोसेसिंग के लिए तैयार।
बड़े डॉक्युमेंट्स को अक्सर छोटे-छोटे चंक्स में बाँटा जाता है ताकि उन्हें इंडेक्स और रिट्रीव करना आसान हो। यह प्रक्रिया बहुत महत्वपूर्ण है क्योंकि छोटे चंक्स भाषा मॉडल के लिए अधिक प्रबंधनीय होते हैं और अधिक सटीक रिट्रीवल की अनुमति देते हैं। आप हमारे गाइड AI और RAG के लिए chunking रणनीतियाँ में अधिक जान सकते हैं।
from langchain.text_splitter import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
document_chunks = splitter.split_documents(documents)
यहाँ, टेक्स्ट को 500 कैरेक्टर के चंक्स में बाँटा गया है, जिनके बीच 50 कैरेक्टर का ओवरलैप है। यह ओवरलैप रिट्रीवल के दौरान चंक्स में संदर्भ बनाए रखने में मदद करता है।
डेटा तैयार हो जाने के बाद, अगला कदम उसे कुशल रिट्रीवल के लिए इंडेक्स करना है। इंडेक्सिंग में टेक्स्ट चंक्स को वेक्टर एम्बेडिंग्स में बदलना और उन्हें वेक्टर स्टोर में रखना शामिल है।
LangChain विभिन्न मॉडल्स—जैसे OpenAI या HuggingFace मॉडल्स—का उपयोग करके वेक्टर एम्बेडिंग्स बनाने का समर्थन करता है। ये एम्बेडिंग्स टेक्स्ट चंक्स के सिमेंटिक अर्थ को दर्शाती हैं, जिससे सिमिलैरिटी सर्च के लिए वे उपयुक्त बनती हैं।
सरल शब्दों में, एम्बेडिंग्स टेक्स्ट—जैसे किसी डॉक्युमेंट के पैराग्राफ—को ऐसे नंबर्स (वेक्टर) में बदलने का तरीका हैं जिन्हें AI मॉडल समझ सके। ये नंबर्स टेक्स्ट के अर्थ का प्रतिनिधित्व करते हैं, जिससे AI सिस्टम के लिए उसे प्रोसेस करना आसान हो जाता है।
from langchain_openai.embeddings import OpenAIEmbeddings
embeddings = OpenAIEmbeddings()
हम OpenAI की एम्बेडिंग्स का उपयोग वह रूपांतरण संभालने के लिए कर रहे हैं। पहले हम OpenAI के एम्बेडिंग टूल को लाते हैं, और फिर उसे इनिशियलाइज़ करते हैं ताकि वह उपयोग के लिए तैयार हो।
एम्बेडिंग्स जनरेट करने के बाद, अगला कदम उन्हें किसी वेक्टर स्टोर में रखना है, जैसे PGVector, FAISS, या LangChain द्वारा समर्थित कोई और। इससे क्वेरी आने पर प्रासंगिक डॉक्युमेंट्स को तेज़ी और सटीकता से रिट्रीव करना संभव होता है।
from langchain_community.vectorstores import FAISS
vector_store = FAISS.from_documents(document_chunks, embeddings)
इस मामले में, हम FAISS का उपयोग कर रहे हैं, जो बड़े वेक्टर सेट्स में सर्च करने के लिए बनाया गया बेहतरीन टूल है। FAISS हमें सबसे मिलते-जुलते वेक्टर्स बहुत तेज़ी से खोजने में मदद करता है।
तो यहाँ क्या हो रहा है: हम LangChain से FAISS को इम्पोर्ट करते हैं और उससे एक वेक्टर स्टोर बनाते हैं। यह एक तरह का विशेष डेटाबेस है जो वेक्टर्स को कुशलता से स्टोर और सर्च करने के लिए बनाया गया है।
इस सेटअप की खूबी यह है कि बाद में जब हम सर्च करेंगे, तो FAISS उन सभी वेक्टर्स में देखेगा, क्वेरी से सबसे मिलते-जुलते वेक्टर ढूँढेगा, और उनसे जुड़े डॉक्युमेंट चंक्स वापस करेगा।
डेटा इंडेक्स हो जाने के बाद, अब आप रिट्रीवल कंपोनेंट इम्प्लीमेंट कर सकते हैं, जो यूज़र की क्वेरी के आधार पर प्रासंगिक जानकारी लाने का ज़िम्मेदार होता है।
अब हम एक रिट्रीवर सेट कर रहे हैं। यही वह कंपोनेंट है जो इंडेक्स किए गए डॉक्युमेंट्स में से यूज़र की क्वेरी के लिए सबसे प्रासंगिक हिस्से ढूँढता है।
यहाँ अच्छी बात यह है कि आप रैंडम सर्च नहीं कर रहे—आप एम्बेडिंग्स की ताकत से स्मार्ट सर्च कर रहे हैं, ताकि जो नतीजे मिलें वे यूज़र के सवाल के सिमेंटिक रूप से क़रीब हों। आइए कोड की इस लाइन को समझें:
retriever = vector_store.as_retriever(
	 search_type="similarity",
	 search_kwargs={"k": 5}
	)
सबसे पहले, हम वेक्टर स्टोर को रिट्रीवर में बदल रहे हैं। आपने जो FAISS वेक्टर स्टोर डॉक्युमेंट एम्बेडिंग्स से भरा था, अब हम उसे कह रहे हैं, "जब यूज़र सवाल पूछे तो इसी का उपयोग करके सर्च करो।"
अब, search_type वह जगह है जहाँ जादू होता है। रिट्रीवर अलग-अलग तरीकों से सर्च कर सकता है, और आपके पास यहाँ कुछ विकल्प हैं। सिमिलैरिटी सर्च रिट्रीवल का बुनियादी तरीका है। यह देखता है कि कौन-से डॉक्युमेंट्स क्वेरी के अर्थ के सबसे क़रीब हैं।
तो जब आप कहते हैं "search_type='similarity'," तो आप रिट्रीवर को बता रहे हैं, "एम्बेडिंग्स के आधार पर क्वेरी से सबसे मिलते-जुलते डॉक्युमेंट्स ढूँढो।"
search_kwargs={"k": 5} के साथ आप चीज़ों को फ़ाइन-ट्यून करते हैं। k का मान रिट्रीवर को बताता है कि वेक्टर स्टोर से कितने डॉक्युमेंट्स निकालने हैं। यहाँ k=5 का मतलब है, “मुझे टॉप 5 सबसे प्रासंगिक डॉक्युमेंट्स दो।”
यह बहुत ताक़तवर है क्योंकि यह शोर को कम करता है। बहुत सारे “शायद-कुछ-काम-के” नतीजों के बजाय, आप सिर्फ़ सबसे ज़रूरी जानकारी के टुकड़े ले रहे हैं।
कोड के इस हिस्से में हम LangChain का उपयोग करके आपके RAG सिस्टम के कोर इंजन को सेट अप कर रहे हैं। आपके पास पहले से एक रिट्रीवर है, जो क्वेरी के आधार पर प्रासंगिक डॉक्युमेंट्स वापस ला सकता है।
अब, हम LLM जोड़ रहे हैं और उसे प्राप्त डॉक्युमेंट्स के आधार पर प्रतिक्रिया जनरेट करने के लिए उपयोग कर रहे हैं।
from langchain_openai import OpenAI  # Updated import
from langchain.chains import RetrievalQA
यहाँ, हम दो मुख्य तत्व इम्पोर्ट कर रहे हैं:
llm = OpenAI(openai_api_key=openai_api_key)यह लाइन आपके OpenAI API key के साथ LLM को इनिशियलाइज़ करती है। इसे ऐसे समझें जैसे सिस्टम का “दिमाग़” लोड कर रहे हैं—यही मॉडल टेक्स्ट लेगा, समझेगा, और प्रतिक्रियाएँ जनरेट करेगा।
qa_chain = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=retriever
)
यहाँ से चीज़ें वाकई दिलचस्प होने लगती हैं। हम QA Chain सेट कर रहे हैं, जो सब कुछ आपस में जोड़ती है। RetrievalQA.from_chain_type() एक प्रश्न-उत्तर चेन बनाता है—मतलब, “रिट्रीवर और LLM को जोड़कर ऐसा सिस्टम बनाओ जो प्राप्त डॉक्युमेंट्स के आधार पर सवालों के जवाब दे।”
इसके बाद, हम चेन को बताते हैं कि अभी-अभी इनिशियलाइज़ किया गया OpenAI LLM उत्तर जनरेट करने के लिए उपयोग करना है। फिर हम पहले बनाए गए रिट्रीवर को कनेक्ट करते हैं, जो यूज़र की क्वेरी के आधार पर प्रासंगिक डॉक्युमेंट्स ढूँढने के लिए ज़िम्मेदार है।
फिर हम chain_type="stuff" सेट कर रहे हैं: "stuff" क्या है? यह LangChain में एक चेन टाइप है। "stuff" का मतलब है कि प्राप्त प्रासंगिक डॉक्युमेंट्स सभी LLM में लोड किए जाते हैं और मॉडल उन्हीं सबके आधार पर प्रतिक्रिया जनरेट करता है।
यह ऐसा है जैसे LLM की मेज़ पर ढेर सारे नोट्स रखकर कहना, "लो, इन सबका उपयोग करके सवाल का जवाब दो।"
अन्य चेन टाइप भी हैं (जैसे "map_reduce" या "refine"), लेकिन "stuff" सबसे सरल और सीधा है।
query = "Are polar bears in danger?"
response = qa_chain.invoke({"query": query})
यहीं हम सिस्टम से वाकई में सवाल पूछते हैं और प्रतिक्रिया लेते हैं। invoke() मेथड पूरी पाइपलाइन को ट्रिगर करता है।
यह आपकी क्वेरी लेता है, रिट्रीवर को भेजता है ताकि प्रासंगिक डॉक्युमेंट्स मिलें, और फिर वे डॉक्युमेंट्स LLM को भेजे जाते हैं, जो अंतिम प्रतिक्रिया जनरेट करता है।
print(response)आख़िर में यह LLM द्वारा जनरेट की गई प्रतिक्रिया प्रिंट कर देता है। प्राप्त डॉक्युमेंट्स के आधार पर, सिस्टम क्वेरी का पूरा, सूचित उत्तर जनरेट करता है, जिसे प्रिंट किया जाता है।
अंतिम स्क्रिप्ट इस प्रकार दिखती है:
from dotenv import load_dotenv
import os
from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai.embeddings import OpenAIEmbeddings
from langchain_community.vectorstores import FAISS
from langchain.chains import RetrievalQA
from langchain_openai import OpenAI

# Load environment variables
load_dotenv()
openai_api_key = os.getenv("OPENAI_API_KEY")

# Load the document
loader = TextLoader('data/my_document.txt')
documents = loader.load()

# Split the document into chunks
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
document_chunks = splitter.split_documents(documents)

# Initialize embeddings with OpenAI API key
embeddings = OpenAIEmbeddings(openai_api_key=openai_api_key)

# FAISS expects document objects and the embedding model
vector_store = FAISS.from_documents(document_chunks, embeddings)

# Use the vector store's retriever
retriever = vector_store.as_retriever()

# Initialize the LLM (using OpenAI)
llm = OpenAI(openai_api_key=openai_api_key)

# Set up the retrieval-based QA chain
qa_chain = RetrievalQA.from_chain_type(
   llm=llm,
   chain_type="stuff",
   retriever=retriever
)

# Example query
query = "Are polar bears in danger?"
response = qa_chain.invoke({"query": query})

# Print the response
print(response)अब समय है अपने RAG सिस्टम के साथ इंटरैक्ट करने के लिए API बनाने का। लेकिन डिप्लॉयमेंट में यह कदम ज़रूरी क्यों है?
मान लीजिए आप यह ट्यूटोरियल फॉलो कर रहे थे और आपने अपने डॉक्युमेंट्स और ज़रूरतों के अनुसार शानदार RAG सिस्टम सेट कर लिया—वह प्रासंगिक जानकारी ला रहा है, क्वेरीज़ प्रोसेस कर रहा है, और समझदार प्रतिक्रियाएँ बना रहा है। लेकिन वास्तव में यूज़र्स या अन्य सिस्टम इससे कैसे इंटरैक्ट करेंगे?
FastAPI आपका मिडलमैन है। यह यूज़र या ऐप्स के लिए आपके RAG सिस्टम से सवाल पूछने और उत्तर पाने का एक सरल, स्ट्रक्चर्ड तरीका बनाता है।
FastAPI असिंक्रोनस और हाई-परफ़ॉर्मेंस है। इसका मतलब, यह एक साथ कई अनुरोधों को संभाल सकता है बिना धीमा पड़े—जो AI सिस्टम्स के साथ काम करते समय बहुत जरूरी है, जहाँ बड़े डेटा चंक्स रिट्रीव करने या जटिल क्वेरी चलाने की ज़रूरत पड़ सकती है।
इस सेक्शन में, हम पिछली स्क्रिप्ट में बदलाव करेंगे और कुछ अतिरिक्त स्क्रिप्ट बनाएँगे ताकि आपका RAG सिस्टम सुलभ, स्केलेबल और वास्तविक ट्रैफ़िक संभालने के लिए तैयार हो।आइए उन रूट्स को बनाकर शुरू करें जो RAG सिस्टम पर आने वाले अनुरोध संभालेंगे।
अपने वर्किंग डायरेक्टरी में एक main.py फ़ाइल बनाएँ। यह आपके FastAPI ऐप का एंट्री पॉइंट है। यह आपका FastAPI “ब्रेन” होगा—यह फ़ाइल सभी API रूट्स, डिपेंडेंसीज़, और RAG सिस्टम को एक साथ लाएगी।
from fastapi import FastAPI
from endpoints import router
app = FastAPI()
app.include_router(router)
यह सेटअप काफ़ी सरल है, लेकिन साफ़-सुथरा। हम यहाँ FastAPI इंस्टेंस सेट कर रहे हैं और फिर दूसरे फ़ाइल (जिसे हम आगे बनाएँगे) से सारे रूट्स (या API पाथ्स) इम्पोर्ट कर रहे हैं।
यहीं सब कुछ एक साथ आता है। हम एक फ़ंक्शन लिखने जा रहे हैं जो तब आपका RAG सिस्टम चलाएगा जब यूज़र कोई क्वेरी सबमिट करता है।
async def get_rag_response(query: str):यह फ़ंक्शन async मार्क किया गया है, यानी यह असिंक्रोनस है। इसका मतलब है कि यह इंतज़ार करते समय भी अन्य चीज़ें संभाल सकता है।
यह सुविधा खास तौर पर तब उपयोगी होती है जब आप रिट्रीवल-आधारित सिस्टम्स से डील कर रहे हों, जहाँ डॉक्युमेंट्स लाना या LLM को क्वेरी करना समय ले सकता है। इस तरह FastAPI इस रिक्वेस्ट के बैकग्राउंड में काम करने के दौरान अन्य रिक्वेस्ट प्रोसेस कर सकता है।
retriever = setup_rag_system()यहाँ हम setup_rag_system() फ़ंक्शन को कॉल कर रहे हैं, जो—as पहले चर्चा की—पूरा रिट्रीवर पाइपलाइन इनिशियलाइज़ करता है। यानी:
यह रिट्रीवर यूज़र की क्वेरी के आधार पर प्रासंगिक टेक्स्ट चंक्स फेच करने के लिए ज़िम्मेदार होगा।
अब, जब यूज़र सवाल पूछता है, तो रिट्रीवर वेक्टर स्टोर के सभी डॉक्युमेंट्स में देखता है और क्वेरी के आधार पर सबसे प्रासंगिक वाले हिस्से निकालता है।
retrieved_docs = retriever.get_relevant_documents(query)यह invoke(query) मेथड वे प्रासंगिक डॉक्युमेंट्स ला रहा है। पर्दे के पीछे, यह क्वेरी को एम्बेडिंग वेक्टर्स से मिलाता है और सिमिलैरिटी के आधार पर टॉप मैच निकालता है।
अब जबकि हमारे पास प्रासंगिक डॉक्युमेंट्स हैं, हमें उन्हें LLM के लिए फ़ॉर्मैट करना है।
context = "\n".join([doc.page_content for doc in retrieved_docs])यहाँ हम सभी प्राप्त डॉक्युमेंट्स को एक सिंगल स्ट्रिंग में जोड़ रहे हैं। यह इसलिए ज़रूरी है क्योंकि LLM अलग-अलग टुकड़ों के बजाय एक साफ़-सुथरा टेक्स्ट ब्लॉक एक्सपेक्ट करता है।
हम Python के join() फ़ंक्शन का इस्तेमाल करके इन डॉक्युमेंट चंक्स को एक सुसंगत ब्लॉक में जोड़ते हैं। हर डॉक्युमेंट की सामग्री doc.page_content फ़ील्ड में होती है, और हम उन्हें नए लाइनों (\n) से जोड़ रहे हैं।
अब हम LLM के लिए प्रॉम्प्ट बना रहे हैं।
prompt = [f"Use the following information to answer the question:\n\n{context}\n\nQuestion: {query}"]प्रॉम्प्ट को इस तरह स्ट्रक्चर किया गया है कि LLM को प्राप्त जानकारी का उपयोग करके यूज़र के प्रश्न का उत्तर देने के लिए कहा जाए।
अब प्रतिक्रिया जनरेट करने का समय है।
generated_response = llm.generate(prompt) # Pass as a list of stringsयहाँ OpenAI मॉडल का काम है कि वह प्रॉम्प्ट लेकर प्रश्न और प्रासंगिक डॉक्युमेंट्स—दोनों—के आधार पर संदर्भ-संवेदनशील प्रतिक्रिया जनरेट करे।
अंत में, हम जनरेट की गई प्रतिक्रिया वापस उस किसी को भी रिटर्न करते हैं जिसने फ़ंक्शन को कॉल किया (चाहे वह यूज़र हो, फ्रंटएंड ऐप हो, या कोई और सिस्टम)।
return generated_responseयह प्रतिक्रिया पूरी तरह से तैयार, संदर्भ-आधारित है और वास्तविक दुनिया के अनुप्रयोगों में उपयोग के लिए तैयार है।
संक्षेप में, यह फ़ंक्शन पूरा रिट्रीवल और जनरेशन लूप करता है। फ़्लो का त्वरित रीकैप:
1. यह प्रासंगिक डॉक्युमेंट्स ढूँढने के लिए रिट्रीवर सेट करता है।
2. क्वेरी के आधार पर वे डॉक्युमेंट्स निकाले जाते हैं।
3. उन डॉक्युमेंट्स से संदर्भ LLM के लिए तैयार किया जाता है।
4. LLM उस संदर्भ का उपयोग करके अंतिम प्रतिक्रिया जनरेट करता है।
5. प्रतिक्रिया यूज़र को रिटर्न की जाती है।
from dotenv import load_dotenv
import os

from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai.embeddings import OpenAIEmbeddings
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAI

# Load environment variables
load_dotenv()
openai_api_key = os.getenv("OPENAI_API_KEY")

# Initialize the LLM (using OpenAI)
llm = OpenAI(openai_api_key=openai_api_key)

# Function to set up the RAG system
def setup_rag_system():
   # Load the document
   loader = TextLoader('data/my_document.txt')
   documents = loader.load()

   # Split the document into chunks
   splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
   document_chunks = splitter.split_documents(documents)

   # Initialize embeddings with OpenAI API key
   embeddings = OpenAIEmbeddings(openai_api_key=openai_api_key)

   # Create FAISS vector store from document chunks and embeddings
   vector_store = FAISS.from_documents(document_chunks, embeddings)

   # Return the retriever for document retrieval with specified search_type
   retriever = vector_store.as_retriever(
       search_type="similarity",  # or "mmr" or "similarity_score_threshold"
       search_kwargs={"k": 5}  # Adjust the number of results if needed
   )
   return retriever

# Function to get the response from the RAG system
async def get_rag_response(query: str):
   retriever = setup_rag_system()

   # Retrieve the relevant documents using 'get_relevant_documents' method
   retrieved_docs = retriever.get_relevant_documents(query)

   # Prepare the input for the LLM: Combine the query and the retrieved documents into a single string
   context = "\n".join([doc.page_content for doc in retrieved_docs])

   # LLM expects a list of strings (prompts), so we create one by combining the query with the retrieved context
   prompt = [f"Use the following information to answer the question:\n\n{context}\n\nQuestion: {query}"]

   # Generate the final response using the language model (LLM)
   generated_response = llm.generate(prompt)

   return generated_response
endpoints.py में API रूट्स परिभाषित करनाअब अपना endpoints.py फ़ाइल बनाते हैं। यहाँ हम वे वास्तविक पाथ्स परिभाषित करेंगे जिन्हें यूज़र्स आपके RAG सिस्टम के साथ इंटरैक्ट करने के लिए कॉल करेंगे।
from fastapi import APIRouter, HTTPException
from rag import get_rag_response
router = APIRouter()
@router.get("/query/")
async def query_rag_system(query: str):
    try:
        # Pass the query string to your RAG system and return the response
        response = await get_rag_response(query)
        return {"query": query, "response": response}
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
हम अपने API रूट्स को मैनेज करने के लिए APIRouter बनाते हैं। /query/ एंडपॉइंट को एक GET रिक्वेस्ट के साथ क्वेरी स्ट्रिंग स्वीकार करने के लिए परिभाषित किया गया है। यह आपके rag.py फ़ाइल के get_rag_response फ़ंक्शन को कॉल करता है, जो पूरा RAG पाइपलाइन (डॉक्युमेंट रिट्रीवल + भाषा जनरेशन) संभालता है। अगर कुछ गलत होता है, तो हम विस्तृत संदेश के साथ HTTP 500 एरर उठाते हैं।
सारी सेटिंग के बाद, अब आप Uvicorn का उपयोग करके अपना FastAPI ऐप चला सकते हैं। यही वह वेब सर्वर है जो यूज़र्स को आपकी API तक पहुँचने देगा।
टर्मिनल में जाएँ और यह चलाएँ:
uvicorn app.main:app --reloadapp.main:app Uvicorn को बताता है कि main.py फ़ाइल में app इंस्टेंस ढूँढो और --reload कोड में बदलाव होने पर सर्वर को ऑटो-रिलोड करने में सक्षम करता है।
सर्वर चलने के बाद, अपने ब्राउज़र में http://127.0.0.1:8000/docs खोलें। FastAPI आपकी API के लिए अपने आप Swagger UI डॉक्युमेंटेशन जेनरेट करता है, जिससे आप सीधे ब्राउज़र से टेस्ट कर सकते हैं!
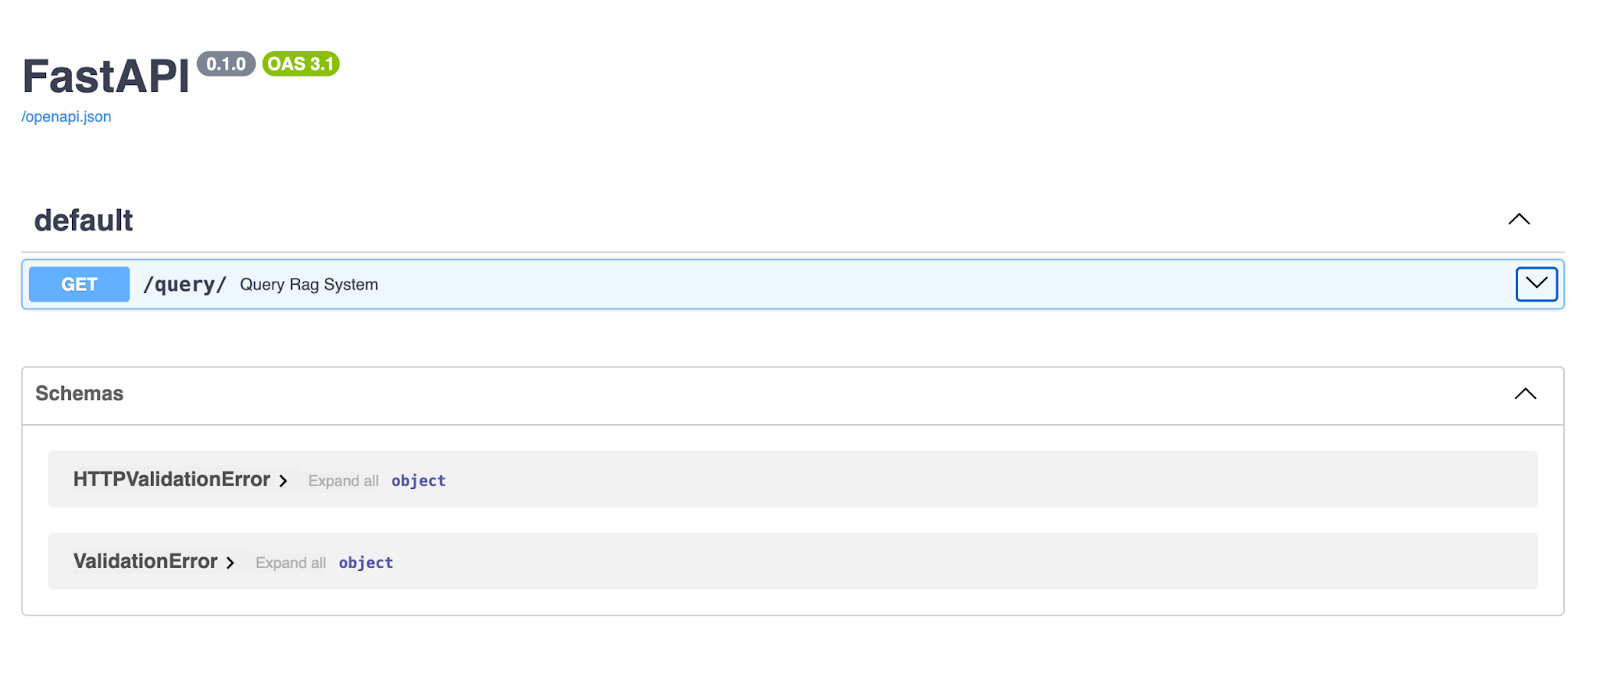
FastAPI का Swagger UI आपकी API एंडपॉइंट्स को एक्सप्लोर और टेस्ट करने के लिए एक साफ़ और इंटरैक्टिव इंटरफ़ेस देता है। यहाँ /query/ एंडपॉइंट यूज़र्स को क्वेरी स्ट्रिंग इनपुट करने और RAG पाइपलाइन द्वारा जेनरेटेड प्रतिक्रिया प्राप्त करने देता है।
अपने FastAPI सर्वर के चलने के साथ, ब्राउज़र, Postman, या Curl का उपयोग करके अपने /query/ एंडपॉइंट पर GET रिक्वेस्ट करें।
ब्राउज़र में, Swagger के ज़रिए:
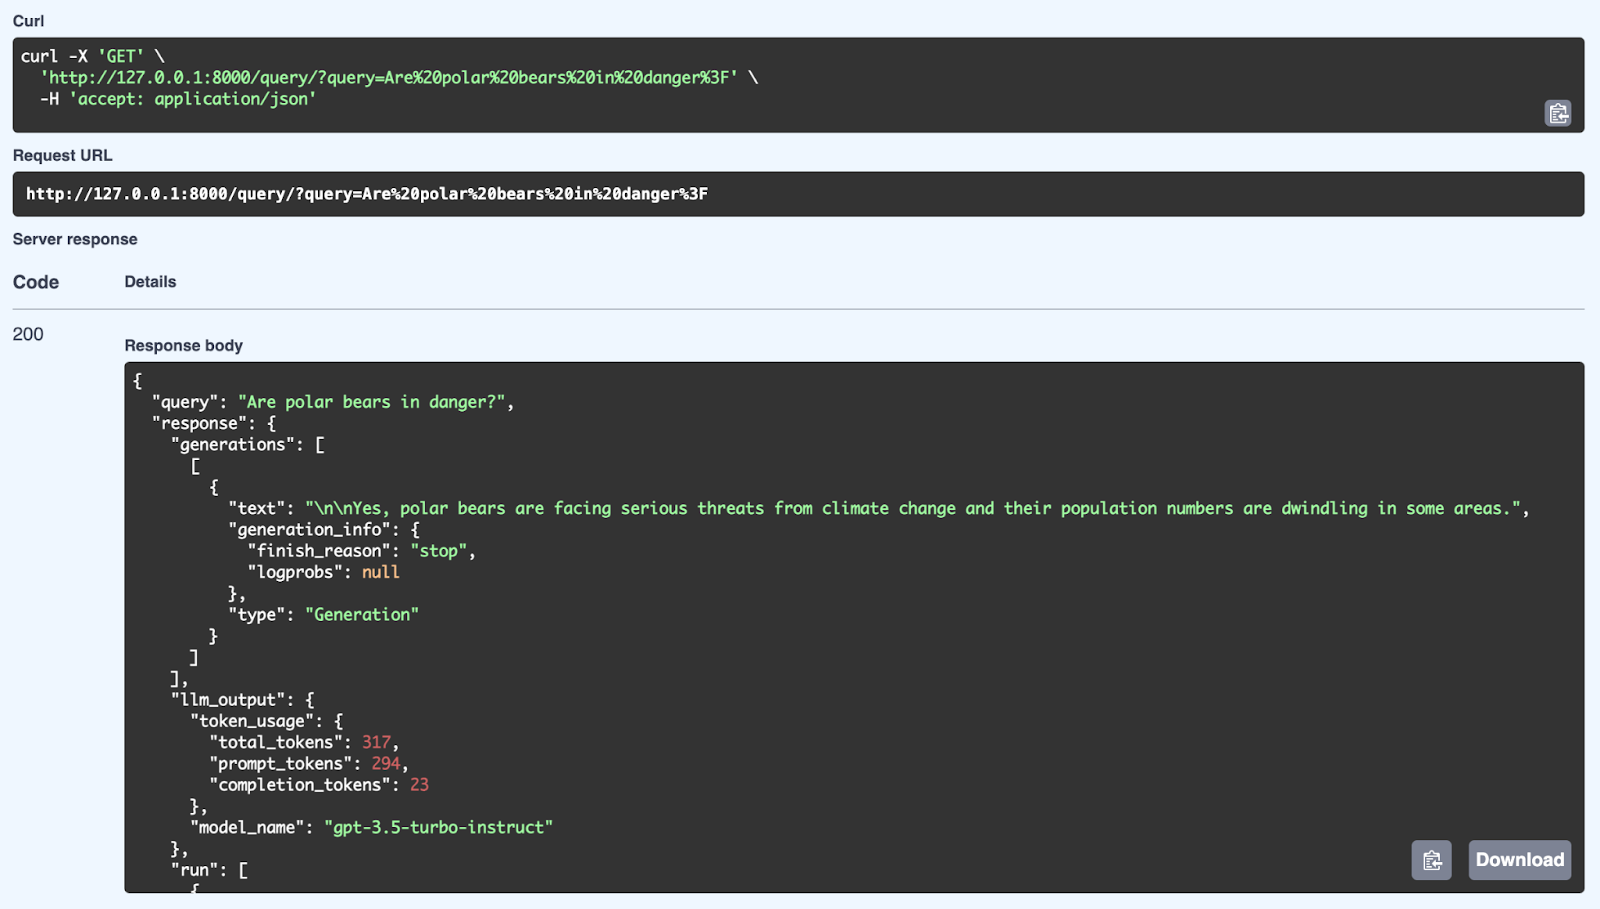
यहाँ हम RAG सिस्टम से “Are polar bears in danger?” क्वेरी पर सफल प्रतिक्रिया देख सकते हैं। सिस्टम अपने नॉलेज बेस से प्रासंगिक जानकारी रिट्रीव करता है और GPT-3.5 Turbo-Instruct मॉडल का उपयोग करके सुसंगत उत्तर जनरेट करता है। विस्तृत प्रतिक्रिया में सिर्फ़ उत्तर (हाँ, ध्रुवीय भालू जलवायु परिवर्तन के कारण गंभीर खतरों का सामना कर रहे हैं और उनकी आबादी घट रही है) ही नहीं, बल्कि टोकन उपयोग (प्रोसेस किए गए टोकन की संख्या) और जनरेशन में उपयोग किए गए मॉडल जैसे मेटाडेटा भी शामिल हैं। FastAPI के ज़रिए API रिट्रीवल और जनरेशन—दोनों—का उपयोग कर सुव्यवस्थित, संदर्भ-अनुकूल उत्तर देने में सक्षम है।
अब बात करते हैं FastAPI में Asynchronous Processing के फ़ायदों की—और यह वास्तविक दुनिया की API रिक्वेस्ट्स को संभालने में इतना बड़ा अंतर क्यों बनाता है।
आपका RAG सिस्टम चालू है। API सवाल ले रही है, अपने नॉलेज बेस से प्रासंगिक जानकारी ला रही है, और भाषा मॉडल से प्रतिक्रियाएँ जेनरेट कर रही है।
अब, यदि यह पूरी प्रक्रिया सिंक्रोनस होती, तो सिस्टम एक-एक टास्क के पूरा होने का इंतज़ार करता रहता। उदाहरण के लिए, डॉक्युमेंट्स रिट्रीव होने के दौरान वह नई रिक्वेस्ट्स प्रोसेस नहीं कर पाता।
|
नॉन-ब्लॉकिंग I/O |
बेहतर परफ़ॉर्मेंस |
बेहतर यूज़र अनुभव |
|
Async फ़ंक्शन सर्वर को एक साथ कई रिक्वेस्ट्स संभालने देते हैं—एक के खत्म होने का इंतज़ार करने के बजाय। |
वेक्टर स्टोर से डॉक्युमेंट्स रिट्रीव करने या टेक्स्ट जनरेट करने जैसे टास्क्स के लिए, async प्रोसेसिंग यह सुनिश्चित करती है कि API हाई लोड्स को कुशलतापूर्वक संभाल सके। |
क्लाइंट्स को तेज़ प्रतिक्रियाएँ मिलती हैं, और भारी उपयोग के दौरान भी आपकी API उत्तरदायी बनी रहती है। |
अब डिप्लॉयमेंट रणनीतियों की बात करते हैं—यह वह बहुत महत्वपूर्ण चरण है जो आपके RAG सिस्टम को प्रोटोटाइप से एक पूर्णत: क्रियाशील प्रोडक्ट में बदलता है। लक्ष्य है कि आपका सिस्टम पैकेज्ड, डिप्लॉय और स्केल के लिए तैयार हो ताकि वह वास्तविक यूज़र्स को संभाल सके।
सबसे पहले Docker की बात करते हैं। Docker एक जादुई बॉक्स जैसा है जो आपके RAG सिस्टम की हर ज़रूरत—कोड, डिपेंडेंसीज़, कॉन्फ़िगरेशन—को पैक कर एक सलीकेदार कंटेनर में लपेट देता है।
यह सुनिश्चित करता है कि जहाँ भी आप अपना ऐप डिप्लॉय करें, वह बिल्कुल वैसा ही व्यवहार करे। आप अलग-अलग एनवायरनमेंट्स में ऐप चला सकते हैं, लेकिन चूँकि वह कंटेनर में है, आपको “मेरी मशीन पर तो चलता है” वाली समस्या की चिंता नहीं करनी पड़ती।
आप एक Dockerfile बनाते हैं, जो निर्देशों का एक सेट होता है जो Docker को बताता है कि आपके ऐप का एनवायरनमेंट कैसे सेट करना है, किन पैकेजों को इंस्टॉल करना है, और कैसे शुरू करना है। इसके बाद, आप इससे Docker इमेज बनाते हैं और अपने एप्लिकेशन को कंटेनर के भीतर चलाते हैं। यह कुशल, दोहराने योग्य, और बेहद पोर्टेबल है।
एक बार आपका सिस्टम पैक होकर तैयार हो जाए, तो आप संभवतः उसे क्लाउड में डिप्लॉय करना चाहेंगे। यहीं चीज़ें दिलचस्प हो जाती हैं क्योंकि क्लाउड में RAG सिस्टम डिप्लॉय करने का मतलब है कि उसे दुनिया में कहीं से भी एक्सेस किया जा सकता है। साथ ही, यह स्केलेबिलिटी, विश्वसनीयता, और अन्य क्लाउड सेवाओं तक पहुँच देता है जो आपके सिस्टम को और सक्षम बना सकती हैं।
आइए कुछ पॉपुलर क्लाउड प्लेटफ़ॉर्म्स—जिनमें Azure और Google Cloud भी शामिल हैं—पर नज़र डालते हैं:
AWS Elastic Beanstalk जैसे टूल्स देता है, जो डिप्लॉयमेंट को बहुत आसान बना देता है। आप मूल रूप से अपना Docker कंटेनर दे देते हैं और AWS स्केलिंग, लोड बैलेंसिंग, और मॉनिटरिंग का ध्यान रखता है। यदि आपको और कंट्रोल चाहिए, तो आप Amazon ECS का उपयोग कर सकते हैं, जो आपके Docker कंटेनर्स को सर्वर्स के क्लस्टर पर चलाने और ज़रूरत के अनुसार उन्हें ऊपर-नीचे स्केल करने देता है।
Heroku एक और विकल्प है जो डिप्लॉयमेंट को सरल बनाता है। आप बस अपना कोड पुश करते हैं, और Heroku आपके लिए इन्फ्रास्ट्रक्चर संभालता है। यदि आप क्लाउड संसाधनों के बारीक़ प्रबंधन में बहुत गहराई तक नहीं जाना चाहते, तो यह शानदार विकल्प है।
Azure Azure App Service देता है, जिससे आप अपना RAG सिस्टम आसानी से डिप्लॉय और मैनेज कर सकते हैं—ऑटो-स्केलिंग, लोड बैलेंसिंग, और कंटिन्युअस डिप्लॉयमेंट के लिए बिल्ट-इन सपोर्ट के साथ।
और अधिक लचीलापन के लिए, आप Azure Kubernetes Service (AKS) का उपयोग करके अपने Docker कंटेनर्स को स्केल पर मैनेज कर सकते हैं, ताकि आपका सिस्टम हाई ट्रैफ़िक संभाल सके और ज़रूरत के अनुसार संसाधन डायनेमिक रूप से समायोजित कर सके।
GCP Google Cloud Run देता है—एक फ़ुली-मैनेज्ड प्लेटफ़ॉर्म—जो आपको कंटेनर्स डिप्लॉय करने और ट्रैफ़िक के आधार पर उन्हें ऑटो-स्केल करने देता है।
यदि आप अपने इन्फ्रास्ट्रक्चर पर अधिक कंट्रोल चाहते हैं, तो आप Google Kubernetes Engine (GKE) का उपयोग कर सकते हैं, जो कई नोड्स पर आपके Docker कंटेनर्स को मैनेज और स्केल करने की शक्ति देता है—साथ ही Google की AI और मशीन लर्निंग APIs जैसी क्लाउड सेवाओं के साथ गहरे इंटीग्रेशन का फ़ायदा भी।
हर प्लेटफ़ॉर्म की अपनी ताकतें हैं—चाहे आप सरलता और ऑटोमेशन चाहें या डिप्लॉयमेंट पर अधिक सूक्ष्म नियंत्रण।
हमने इस लेख में बहुत कुछ कवर किया—LangChain और FastAPI का उपयोग करके RAG सिस्टम बनाने की प्रक्रिया को समझा। RAG सिस्टम प्राकृतिक भाषा प्रसंस्करण में बड़ा कदम हैं क्योंकि वे बाहरी जानकारी शामिल करते हैं, जिससे AI अधिक सटीक, प्रासंगिक और संदर्भ-संवेदनशील प्रतिक्रियाएँ दे पाता है।
LangChain के साथ, हमारे पास एक सुदृढ़ फ़्रेमवर्क है जो डॉक्युमेंट लोड करने, टेक्स्ट स्प्लिट करने, एम्बेडिंग्स बनाने से लेकर यूज़र क्वेरी के आधार पर जानकारी रिट्रीव करने तक सब सँभालता है।
इसके बाद, FastAPI हमें एक तेज़, async-रेडी वेब फ़्रेमवर्क देता है, जो RAG सिस्टम को एक स्केलेबल API के रूप में डिप्लॉय करने में मदद करता है।
ये टूल्स मिलकर ऐसे AI एप्लिकेशन बनाना आसान बनाते हैं जो जटिल क्वेरीज़ संभाल सकें, सटीक उत्तर दें, और अंततः बेहतर यूज़र अनुभव प्रदान करें।
अब आपकी बारी है कि जो आपने सीखा है उसे अपने प्रोजेक्ट्स में लागू करें।
संभावनाओं के बारे में सोचें: अपनी कंपनी के आंतरिक नॉलेज बेस से क्वेरी करना, डॉक्युमेंट रिव्यू प्रक्रियाओं को ऑटोमेट करना, या क्लाइंट सपोर्ट के लिए इंटेलिजेंट चैटबॉट्स बनाना।
ना भूलें—इस सेटअप को बढ़ाने के कई तरीके हैं! आप अधिक जटिल डेटा स्ट्रक्चर्स भेजने के लिए POST रिक्वेस्ट्स के साथ प्रयोग कर सकते हैं, या रियल-टाइम इंटरैक्शन के लिए WebSocket कनेक्शंस एक्सप्लोर कर सकते हैं।
मैं आपको और गहराई से जाने, प्रयोग करने और देखने के लिए प्रोत्साहित करता हूँ कि यह आपको कहाँ तक ले जा सकता है। यह तो बस शुरुआत है जो आप LangChain, FastAPI, और आधुनिक AI टूल्स के साथ हासिल कर सकते हैं! यहाँ कुछ संसाधन हैं जो मैं सुझाता हूँ:
Top DataCamp Courses
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें