Ana içeriğe atla

Kardinaliteyi Anlamak: Veri Yüklü İş Akışları için Zorluklar ve Çözümler

Kardinalitenin ne anlama geldiğini ve veri işleme, analiz ve makine öğrenimini nasıl etkilediğini keşfedin. Veri ön işlemden gelişmiş optimizasyon araçlarına kadar, yüksek kardinaliteyi yönetmeye yönelik pratik strateji ve teknikleri öğrenin.
Güncel 3 Eki 2026  · 8 dk. oku

Yapay Zeka ile Keşfedin

ChatGPTClaudePerplexity

Kardinalite kavramıyla ilk kez Fizik lisansım sırasında bir Kuantum Mekaniği dersinde karşılaştım. O derste kardinalite, bir kümenin sonlu ya da sonsuz olmasına bakılmaksızın büyüklüğünü ifade ediyor ve sayılabilirlik ile sonsuzluklar gibi soyut kavramlarla ilişkilendiriliyordu. Yazılım mühendisliğine geçiş yaptığımda ise veri mühendisi ya da bilim insanı için kardinalitenin çok daha pratik bir anlama geldiğini fark ettim: bir veri kümesindeki değerlerin ayırt edilebilirliği.

Gerçek dünya verilerini analiz ettiğim ilk projelerimden birinde, yüksek kardinalitenin ne kadar zorlayıcı olabileceğini bizzat öğrendim. Veritabanı sorgularımı yavaşlattı ve net olması gereken içgörüleri karmaşık bir keşmekeşe çevirdi. O zamandan beri uygulamalı deneyim kazandım ve benzer durumdaki başkalarına yardımcı olabileceğini umarak bu rehberi derledim. Yüksek kardinalitenin ne olduğunu, ne tür zorluklar getirdiğini ve bunları pratik ve etkili yollarla nasıl kontrol altına alabileceğinizi öğrenmek istiyorsanız doğru yerdesiniz!

Kardinalite Nedir, Yüksek Kardinalite Nedir?

Kardinalite ve yüksek kardinalite kavramları biraz soyut gelebilir, gelin parçalara ayıralım.

Tanım ve örnekler

Kardinalite, bir veri kümesi sütunundaki benzersiz değerlerin sayısını ifade eder. Yüksek kardinaliteli bir sütunda çok sayıda benzersiz değer bulunur; düşük kardinaliteli sütunlarda ise daha az benzersiz girdi vardır.

Yüksek kardinalite, özellikle aşağıdakiler gibi benzersiz tanımlayıcılar içeren veri kümelerinde yaygındır:

  • Zaman damgaları (timestamps): Veriler milisaniye ya da nanosaniye düzeyinde kaydedildiğinde, neredeyse her değer benzersizdir.
  • Müşteri kimlikleri (Customer IDs): Her müşteri, etkinliklerini izlemek için kendine özgü bir tanımlayıcıya sahiptir.
  • İşlem kimlikleri (Transaction IDs): Finansal veri kümelerinde her işlem için benzersiz kodlar bulunur.

Bu benzersiz değerler, verileri izlemek, birleştirmek veya kişiselleştirmek için önemlidir. Ancak sayılarının çokluğu, az sonra göreceğimiz üzere depolama, performans ve görselleştirme açısından önemli zorluklar yaratabilir.

Yaygın gerçek hayat örnekleri

Yüksek kardinalite her alanda ve sektörde karşımıza çıkabilir. Aşağıda, yüksek kardinalitenin pratikte ne anlama geldiğini anlamanıza yardımcı olacak bazı örnekler sıraladım.

E-ticaret ve müşteri verileri

E-ticaret platformları her gün büyük miktarda yüksek kardinaliteli veri üretir:

  • Müşteri kimlikleri: Her kullanıcıya davranışlarını, satın alımlarını ve tercihlerini izlemek için benzersiz bir tanımlayıcı atanır.
  • Oturum kimlikleri: Her gezinme oturumu benzersiz şekilde kaydedilir; bu da oturum izleme veri kümelerinde çok sayıda farklı değere yol açar.
  • Ürün SKU’ları: Stok kodları (SKU) her ürün varyasyonu için benzersizdir; envanter ve satış verilerinde yüksek kardinaliteli sütunlar oluşturur.

Bu veri kümeleri kullanıcı davranışını anlamak, envanteri izlemek ve satış stratejilerini optimize etmek için gereklidir; fakat benzersiz girişlerin çokluğu analizi çoğu zaman karmaşık hale getirir.

Sağlık hizmetleri ve hasta kayıtları

Sağlık alanında hassas izleme ve kimlik doğrulama ihtiyacı doğal olarak yüksek kardinaliteli veriler üretir. Örneğin şunlarla karşılaşırız:

  • Hasta kimlikleri: Her hastaya doğru ve güvenli kayıt tutma için benzersiz bir tanımlayıcı verilir.
  • Randevu zaman damgaları: Doktor ziyaretlerinden laboratuvar testlerine kadar her hasta etkileşimi için benzersiz zaman damgaları oluşturulabilir.
  • Sigorta talep numaraları: Sigorta sağlayıcıları tarafından işlenen her talebe, kayıt ve denetim amaçlarıyla benzersiz bir kod atanır.

Bu veriler, hasta geçmişlerini tutmak ve gizlilik düzenlemelerine uyumu sağlamak için gereklidir.

IoT sensörleri ve akış verileri

IoT cihazlarının yaygınlaşması, yüksek kardinaliteli veri kümelerinde bir patlama yarattı:

  • Sensör kimlikleri: Her IoT cihazının etkinliğini ve konumunu izlemek için benzersiz bir tanımlayıcısı vardır.
  • Zaman damgası verileri: Sürekli veri akışları, olayları milisaniye ya da nanosaniye aralıklarla kaydeder; bu da neredeyse bütünüyle benzersiz değerler üretir.
  • Olay kimlikleri: Sıcaklık okumalarından hareket algılamaya kadar sistemde kaydedilen her olaya benzersiz bir tanımlayıcı atanır.

IoT’de yüksek kardinalite, çok sayıda cihazdan gelen ayrıntılı, gerçek zamanlı verilerin işlenmesi ihtiyacından kaynaklanır. Analitik ve izleme için hayati önemdedir; ancak verimli şekilde depolamak ve sorgulamak zordur – detaylara birazdan geleceğiz!

Yüksek Kardinalitenin Yarattığı Zorluklar

Yüksek kardinalite; veri işleme, mühendislik, analiz ve makine öğrenimi genelinde çeşitli zorluklar doğurur. Yüksek kardinaliteli veri kümeleri çok sayıda faydalı bilgi sunsa da sıklıkla bir darboğaza dönüşerek performansı, yorumlanabilirliği ve ölçeklenebilirliği olumsuz etkileyebilir.

Veri depolama ve performans sorunları

Yüksek kardinalitenin en büyük zorluklarından biri, veri depolama ve sistem performansı üzerindeki etkisidir.

  • Depolama yükü: Benzersiz tanımlayıcılar veya zaman damgaları gibi yüksek kardinaliteli sütunlar, veri kümelerini büyütür. Örneğin, bir e-ticaret platformunda milyonlarca kullanıcı etkileşiminin kaydedilmesi, oturum kimliklerinin veya işlem zaman damgalarının benzersizliği nedeniyle büyük bir depolama yükü yaratır.
  • Sorgu performansında düşüş: Yüksek kardinaliteli sütunlar sorgulandığında, veritabanları indeksleme ve tarama karmaşıklığının artmasıyla zorlanır. Bu sütunlarda filtreleme veya birleştirme içeren sorgular, veritabanının çok sayıda farklı değeri elemesi gerektiğinden daha uzun sürer.
  • İndeksleme zorlukları: Veritabanı sorgularını hızlandırmak için kritik olan indeksler, yüksek kardinaliteli sütunlarda şişer ve verimsizleşir. Bu da daha yavaş aramalara ve düşen performansa yol açabilir.

Benzersiz sensör kimlikleri ve hassas zaman damgaları içeren bir IoT sensör veritabanını düşünün. Belirli bir sensöre ve zaman aralığına göre filtreleyen sorgular, veritabanının milyonlarca benzersiz girdiyi işlemesini gerektirebilir; bu da son derece yavaş yanıt sürelerine ve kaynak yoğun işlemlere neden olur.

Veri görselleştirme zorlukları

Zorluk, çok sayıda farklı değeri hem anlaşılır hem de anlamlı bir şekilde sunmaktır. Dikkatli düşünülmezse, yüksek kardinaliteli veriler içgörüleri ortaya çıkarmak yerine gizleyebilir.

Buna iyi bir örnek aşağıdaki pasta grafiktir. Kullanılan grafik türü için benzersiz giriş (eyalet) sayısı çok fazla olduğundan, gösterge ve değerler okunamaz hale gelmiştir. Bazen grafik türünü değiştirmek yardımcı olur, ama her zaman değil. 
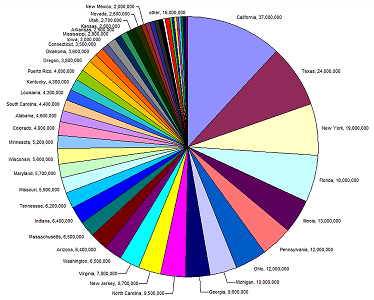
Her ABD eyaleti için bir dilim ve değer içeren, okunamaz pasta grafik.

Kaynak: European Environment Agency

Bir e-ticaret platformunun müşteri etkinliğini oturum kimliğine göre gösteren bir çubuk grafik hayal edin. Binlerce ya da milyonlarca benzersiz kimlikle grafik, okunamaz çubuklardan oluşan bir karmaşaya dönüşür ve bu veriyi çizmek için grafik türünü değiştirmek muhtemelen fark yaratmaz. 

Peki neden verileri basitçe birleştirip grafiklerimizden desen ve ilişkiler çıkarmıyoruz? Yapabiliriz, ama dikkatli yapılmalı. Yüksek kardinaliteli verileri birleştirmek, içgörü çıkarmak için gereken ayrıntı düzeyini kaybetmemize yol açabilir. Örneğin IoT verilerini konuma göre gruplamak, tekil sensör düzeyindeki ince ama kritik değişimleri gizleyebilir. Bu sorunu çözmeye yönelik teknikler inceliklidir. Bire bir ve bire çok ilişkilerle pratik yapmak için Power BI’da Orta Düzey Veri Modelleme kursumuzu öneririm. 

Makine öğrenimiyle ilişkisi

Yüksek kardinalite, özellikle öznitelik mühendisliği, model karmaşıklığı ve yorumlanabilirlik söz konusu olduğunda makine öğreniminde ciddi zorluklar doğurabilir. Makine öğrenimi modelleri yapılandırılmış ve anlamlı girdilerle başarı gösterir; ancak yüksek kardinaliteli öznitelikler bu dengeyi sıklıkla bozar ve şu karmaşıklıklara neden olur:

  • Artan seyrekli̇k: Yüksek-cardinaliteli öznitelikler sıklıkla seyrek veri kümeleri üretir. Örneğin, posta kodu gibi yüksek kardinaliteli kategorik bir öznitelikte tek-seçenekli kodlama (one-hot encoding) uygulamak, boyutların son derece arttığı bir matris oluşturur ve bunların çoğu boştur. Bu seyreklik, özellikle k-en yakın komşu ya da kümeleme algoritmaları gibi mesafeye dayalı modellerin veride anlamlı ilişkiler bulmasını zorlaştırır.
  • Aşırı uyum (overfitting) riski: Yüksek kardinaliteli öznitelikler, veriyi çok ince kategorilere bölen karar ağaçları veya rastgele ormanlar gibi modellerde aşırı uyuma yol açabilir. Her kategori yalnızca birkaç örnekle temsil edildiğinde model, gerçek desenler yerine gürültüyü öğrenir ve görülmemiş verilere genellenebilirliği zayıflar.

Örneğin e-ticarette, müşteri kaybını öngören bir makine öğrenimi modeli, "kullanıcı kimliği" veya "ürün kimliği" gibi yüksek kardinaliteli bir öznitelik içerebilir. Uygun şekilde yönetilmezse, model eğitim verilerindeki belirli müşterilere veya ürünlere aşırı uyum sağlayabilir. Bu da, genel eğilimler yerine eğitim veri setine özgü desenleri öğrendiği için yeni kullanıcılar için kaybı tahmin etmede modelin etkinliğini azaltır.

Yüksek Kardinaliteyi Yönetme Stratejileri

Yüksek kardinaliteyi etkili şekilde yönetmek, alana özgü stratejiler ile genel veri optimizasyon tekniklerinin bir karışımını gerektirir. Bu yaklaşımlar yalnızca sistem performansını iyileştirmekle kalmaz, verileri daha yorumlanabilir ve eyleme dönüştürülebilir hale de getirir.

Teknoloji ve araçlardan yararlanma

Neyse ki, yüksek kardinaliteli veri kümelerinin yarattığı zorluklar yeterince yaygın olduğundan, bunlarla başa çıkmak için özel olarak geliştirilmiş çeşitli teknik ve araçlar mevcut.

Veritabanı optimizasyonu

Veritabanlarında yüksek kardinaliteyi yönetmek, basitçe yinelenenleri kaldırmanın ötesinde, verilerin nasıl depolandığını ve sorgulandığını optimize etmekle başlar. En yaygın teknikler şunlardır:

  • Gruplama (bucketing/binning): Yüksek kardinaliteli verileri daha geniş kategoriler altında toplayarak benzersiz değer sayısını azaltmak. Örneğin, posta kodlarını tek tek saklamak yerine bölgelere göre gruplamak.
  • Bölümlendirme (partitioning): Sıklıkla sorgulanan alanlara göre tabloları bölümlere ayırmak. Örneğin, müşteri verilerini ülkeye göre bölümlendirmek, coğrafi olarak dağıtık sistemlerde sorgu performansını artırabilir.
  • İndeksleme: Bitmap veya bileşik indeksler gibi yüksek kardinaliteli alanlar için özel olarak tasarlanmış indeksleri kullanmak, depolama verimliliğini gözetirken sorgu hızını artırabilir.

Uzmanlaşmış yazılımlar

Aşırı yüksek kardinaliteyle uğraşıyorsanız, size yardımcı olabilecek özel araç ve platformlar bulunur:

  • Sütun bazlı veritabanları: Apache Parquet veya Amazon Redshift gibi veritabanları, analitik sorgular için tasarlanmıştır ve yüksek kardinaliteli sütunları verimli şekilde depolayıp işleyebilir.
  • NoSQL veritabanları: Bazı durumlarda MongoDB veya Elasticsearch gibi NoSQL veritabanları, özellikle şemasız tasarımlarla birlikte kullanıldığında yüksek kardinaliteli veri kümelerinin değişkenliğini ve boyutunu daha iyi yönetebilir.
  • Zaman serisi veritabanları: Zaman damgaları ve olayların hakim olduğu veri kümeleri için IoT sensör verileri veya borsa işlemleri gibi kullanım alanlarında, InfluxDB veya TimescaleDB gibi zaman serisi veritabanları son derece faydalıdır. Bu sistemler, yüksek kardinaliteli boyutları verimli şekilde depolamak üzere özel olarak optimize edilmiştir ve depolama maliyetlerini en aza indirirken yüksek performansı korumak için gelişmiş sıkıştırma teknikleri kullanır. Çok büyük miktarda IoT verisi içeren birkaç projede çalıştım ve eğilimleri ile öngörüleri çıkarmada zaman serisi veritabanlarının büyük fark yarattığını gördüm. Daha fazlasını öğrenmek isterseniz, zaman serisi veritabanlarına ilişkin bu rehberi yazdım! 
  • Veri profilleme araçları: Talend, OpenRefine veya özel Python betikleri gibi araçlar, yüksek kardinaliteli alanları hızla belirleyebilir ve en uygun ön işleme veya depolama stratejisini saptamaya yardımcı olabilir.

Veri ön işleme teknikleri

Veri bilimi ve makine öğreniminde ön işleme, ham verilerin analiz veya modelleme için uygun bir biçime temizlenmesi, dönüştürülmesi ve düzenlenmesi adımlarını ifade eder.

Oldukça kapsamlı bir konudur; veri mühendisliği veya veri bilimi bilginiz azsa bu bölümdeki bilgiler takip etmesi biraz zor olabilir. Yine de ilerlemenize yardımcı olacak ilgili bağlantılar ve örnekler ekledim!

Veri ön işleme, yüksek kardinaliteyi yönetmek için kritik bir adımdır; karmaşıklığı azaltır, performansı artırır ve veri kalitesinin analiz veya makine öğrenimi görevleri için yeterli olmasını sağlar. Ham verileri daha yönetilebilir formlara dönüştürerek seyreklik, depolama verimsizlikleri ve hesaplama darboğazları gibi zorlukların üstesinden gelebiliriz.

Boyut indirgeme

Boyut indirgeme teknikleri, yüksek kardinalitenin çok sayıda özniteliğe veya seyrek matrislere yol açtığı durumlarda özellikle değerlidir. Bu yöntemler, kritik bilgiyi koruyarak veriyi daha az boyuta sıkıştırır.

Temel Bileşenler Analizi (PCA)

Bir e-ticaret müşteri davranışları veri kümeniz olduğunu hayal edin; bir müşterinin bir ürünü kaç kez görüntülediği, farklı ürün kategorileriyle etkileşimi, web sitesinde geçirdiği süre vb. gibi pek çok öznitelik var. Çok sayıda ürünü takip ediyorsanız bu özniteliklerin her biri yüksek kardinaliteli olabilir. PCA, bu öznitelikleri, verideki en önemli desenleri (ör. genel müşteri etkileşimi veya belirli ürün türlerine ilgi) yakalayan daha az sayıda bileşende birleştirmek için kullanılabilir. Bunu verinin Marie Kondo’su gibi düşünün: Neşe uyandıran öznitelikleri tutar, diğerlerini nazikçe eler!

t-SNE ve UMAP

t-SNE ve UMAP, yüksek boyutlu verileri yapısını koruyarak iki ya da üç boyuta eşleyip görselleştirmede özellikle faydalı tekniklerdir. Örneğin sağlık kayıtları veri kümelerinde, UMAP benzer tıbbi durumlara veya tedavi rejimlerine sahip hastaları bir araya getirerek gruplamaya yardımcı olabilir. Bu da birlikte görülen yaygın hastalıklar veya tedavi sonuçları gibi eğilimlerin fark edilmesini sağlar.

Öznitelik seçimi

Bir e-ticaret platformu için satış performansını tahminleyen bir makine öğrenimi modeli kurduğunuzu ve veri kümenizde bir müşterinin bir reklama kaç kez tıkladığı, kaç ürün görüntülediği ve son alışverişinden bu yana geçen gün sayısı gibi öznitelikler olduğunu düşünün. Bu özniteliklerin birçoğunun birbiriyle ilişkili olduğunu ve bunun yüksek kardinalite ile fazlalık yarattığını göreceksiniz. 

Karşılıklı bilgi (mutual information) veya yinelemeli öznitelik eleme gibi öznitelik seçimi tekniklerini kullanarak, en yüksek öngörü gücüne sahip olanları (ör. "son satın alma üzerinden geçen süre" reklam tıklamalarından daha önemli olabilir) belirleyip ilgisiz olanları hariç tutabilirsiniz; bu da nihayetinde model performansınızı iyileştirir.

Bu konuda daha fazla bilgi edinmek isterseniz, Makine Öğrenimi için Ön İşleme kursunu deneyin. Verilerinizi modellerinize vermeden önce Python ile temizleyip hazırlayacaksınız.

Kodlama (encoding) yöntemleri

Kodlama, özellikle yüksek kardinaliteli özniteliklerle uğraşırken kategorik verileri ele almak için kritik bir ön işleme adımıdır. Kullanılacak kodlama yöntemi, kullanım senaryosuna ve veri kümesindeki kardinalite düzeyine bağlıdır.

  • Tek-seçenekli kodlama (One-Hot): Tek-seçenekli kodlama, veri kümesindeki her benzersiz kategori için ikili bir sütun oluşturur. Düşük kardinaliteli veriler için basit ve etkilidir; ancak yüksek kardinaliteli özniteliklere uygulandığında son derece seyrek matrislere yol açabilir. Örneğin 1.000 benzersiz posta kodunu kodlamak, 1.000 ikili sütun üretir ve bu da bellek ile hesaplama kaynaklarını zorlayabilir. Bana güvenin, bunu zor yoldan öğrendim…
  • Hedef kodlama (ortalama kodlama): Bu yöntemde, kategorik değerler her kategori için hedef değişkenin ortalamasıyla değiştirilir. Örneğin müşteri kaybını tahminliyorsanız, hedef kodlama her posta kodunu o bölgedeki müşterilerin ortalama kayıp oranıyla değiştirebilir. Bu yaklaşım boyutu azaltır; ancak önyargı katabilir ve veri sızıntısından kaçınmak için dikkatli doğrulama gerektirir.
  • Frekans kodlama: Frekans kodlama, bir kategoriye o kategorinin görülme sıklığını değer olarak atar ve benzersiz değer sayısını azaltır. Örneğin bir e-ticaret veri setinde, ürün kimlikleri satın alınma sıklıklarıyla değiştirilebilir. Bu teknik kaynak açısından verimlidir ve sıklıkla özniteliğin önemine koreledir.
  • Hashing kodlama: Hashing kodlama, kategorileri bir hash fonksiyonu kullanarak tamsayılara eşler ve bazı kategorileri bir araya getirir. Bellek açısından verimlidir ve akış verileri veya aşırı yüksek kardinalite için iyi çalışır; ancak hash çakışması riski taşır. Çevrimiçi alışveriş sitenizden araba yağı ararken size bebek maması önerildiğini hiç düşündünüz mü? İşte bu, hashing çakışmalarının bir eseridir.
  • Gömme katmanları (embeddings): Sinir ağları gibi makine öğrenimi modellerinde, gömme katmanları yüksek kardinaliteli kategorik öznitelikleri yoğun, düşük boyutlu temsillere dönüştürebilir. Bu yaklaşım, e-ticaret platformlarında milyonlarca ürün veya kullanıcı kimliğini kodlamak gibi öneri sistemlerinde yaygın şekilde kullanılır.

Sonuç

Yüksek kardinaliteli veri kümeleri zaman zaman bunaltıcı gelebilir ve bu veri kümelerinden değerli içgörüler çıkarmak kesinlikle zorlayıcı olabilir. Bir dahaki sefere yüksek kardinaliteli bir veri kümesiyle karşılaştığınızda, suçun veride olmadığını hatırlayın – yalnızca açığa çıkarılmayı bekleyen potansiyelle doludur. İster boyut indirgeme ister akıllı kodlama teknikleri ister zaman serisi veritabanları gibi araçlar olsun, veri kümelerinizi etkili şekilde yönetebilir ve onları son derece güçlü varlıklara dönüştürebilirsiniz.

Ve artık yüksek kardinaliteli verilerle teoride nasıl çalışacağınızı bildiğinize göre, bunu pratiğe dökme zamanı:

  • Boyut indirgeme ve kodlama tekniklerini bizzat deneyin – küçük başlayın ve kademeli ilerleyin. Python ile Boyut İndirgeme kursumuz harika bir seçimdir.
  • Burada bahsedilen bazı araçları deneyin (evet, zaman serisi veritabanları kulağa geldiği kadar havalı!).

Ve en önemlisi, zorluğu kucaklayın. Yüksek kardinalite karmaşık olabilir; ama aynı zamanda veri mühendisliği ve analiz hakkında çok şey öğrenmek için bir fırsattır!


Marie Fayard's photo
Author
Marie Fayard

İlk prototipten ürün-pazar uyumuna ve ötesine kadar erken aşama girişimleri büyütme konusunda uzmanlaşmış, ürün odaklı bir teknik liderim. İnsanların teknolojiyi nasıl kullandığına dair bitmeyen bir merakım var ve kurucularla ile disiplinler arası ekiplerle yakın çalışarak cesur fikirleri hayata geçirmeyi seviyorum. Ürün inşa etmediğim zamanlarda ya dünyanın yeni köşelerinde ilham peşinde koşuyor ya da yoga stüdyosunda stres atıyorum.

FAQs

Kendi veri kümelerimde yüksek kardinaliteyi nasıl tespit edebilirim?

Yüksek kardinalite, satır sayısına kıyasla çok sayıda benzersiz değere sahip sütunları kontrol ederek tespit edilebilir. Örneğin bir müşteri veri setinde, her girdinin benzersiz olduğu "müşteri kimliği" gibi bir sütun muhtemelen yüksek kardinalitelidir. Python’da pandas gibi araçlar, df['column_name'].nunique() gibi komutlarla bir sütundaki benzersiz değer sayısını kolayca kontrol etmenize yardımcı olabilir.

Veri analizinde yüksek kardinalite göz ardı edilirse gerçek dünyada ne gibi sonuçlar doğar?

Yüksek kardinaliteyi görmezden gelmek, performans sorunları (daha yavaş sorgu süreleri), verileri anlamlandırmada zorluklar (aşırı karmaşık görselleştirmeler) ve makine öğrenimi modellerinde güçlükler (aşırı uyum veya verimsiz eğitim) dahil olmak üzere çeşitli problemlere yol açabilir. Yüksek kardinalite ele alınmazsa, veri analizi karmaşıklaşabilir, yanlış sonuçlar üretebilir veya yönetilemez hale gelebilir.

Yüksek kardinalite veri analizinde hiç faydalı olabilir mi, yoksa kaçınılması mı gerekir?

Yüksek kardinalite genellikle bir zorluk olarak görülse de bazı bağlamlarda değerli bilgiler sağlayabilir. Örneğin öneri sistemlerinde, yüksek kardinaliteli öznitelikler (kullanıcı kimliği veya ürün kimliği gibi) sistemin kişiselleştirilmiş öneriler sunmasına yardımcı olur. Ancak aşırı uyumu ve performans düşüşünü önlemek için bu özniteliklerin modellerde nasıl kullanıldığının dikkatle yönetilmesi önemlidir.

Yüksek kardinalite daha çok yapılandırılmış verilerde mi yoksa yapılandırılmamış verilerde mi sorun olur?

Yüksek kardinalite hem yapılandırılmış hem de yapılandırılmamış verilerde sorun olabilir; ancak genellikle kardinalitenin belirli sütunlarla (tanımlayıcılar veya zaman damgaları gibi) ilişkili olduğu yapılandırılmış veri kümelerinde daha zorludur. Metin veya görsel gibi yapılandırılmamış verilerde ise kardinalite sorunları, çok fazla benzersiz kelime veya piksel gibi daha ince yollarla ortaya çıkar ve işlemi karmaşıklaştırır.

Konular
Veri Bilimi
Veri Mühendisliği

DataCamp ile Öğrenin

Kurs

Power BI'de Orta Düzey Veri Modelleme

3 sa
60.6K
Power BI'da ana veri modelleme.
Ayrıntıları GörüntüleRight Arrow
Kursa Başla
Devamını GörRight Arrow
İlgili

blog

Hızlı Sevkiyat İçin Pratik Vibe Kodlama Teknoloji Yığını

Ön uç, arka uç, veritabanları, kimlik doğrulama, depolama, e-posta, test, dağıtım ve izleme için en iyi araçları keşfedin.
Abid Ali Awan's photo

Abid Ali Awan

14 dk.

blog

2026’da En Popüler 40 Yazılım Mühendisi Mülakat Sorusu

Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Dario Radečić's photo

Dario Radečić

15 dk.

Eğitim

.gitignore Nasıl Kullanılır: Örneklerle Pratik Bir Giriş

Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Kurtis Pykes 's photo

Kurtis Pykes

8 dk.

Eğitim

Python'da Listeyi String'e Nasıl Dönüştürürsünüz

Bu hızlı eğitimde, Python'da bir listeyi string'e nasıl dönüştüreceğinizi öğrenin.
Adel Nehme's photo

Adel Nehme

Devamını GörDevamını Gör

