मैंने पहली बार कार्डिनैलिटी की अवधारणा से अपने भौतिकी के दौरान क्वांटम मैकेनिक्स की कक्षा में सामना किया। वहाँ, कार्डिनैलिटी का अर्थ किसी समुच्चय का आकार था—ससीम या असीम—और यह गणनीयता तथा अनंतताओं जैसे अमूर्त विचारों से जुड़ा था। सॉफ्टवेयर इंजीनियरिंग में आने के बाद मुझे एहसास हुआ कि डेटा इंजीनियर या वैज्ञानिक के लिए कार्डिनैलिटी का अर्थ कहीं अधिक व्यावहारिक होता है: किसी डेटासेट में मानों की विशिष्टता।
वास्तविक-जीवन के डेटा का विश्लेषण करने वाले अपने शुरुआती प्रोजेक्ट्स में से एक में, मुझे पता चला कि उच्च कार्डिनैलिटी कितनी चुनौतीपूर्ण हो सकती है। इसने मेरे डेटाबेस क्वेरीज़ को बेहद धीमा कर दिया और जो स्पष्ट इनसाइट्स मिलनी चाहिए थीं, वे उलझन भरे नतीजों में बदल गईं। तब से मुझे कुछ हाथों-हाथ अभ्यास मिला है, और मैंने यह गाइड तैयार किया है ताकि यही स्थिति किसी और के साथ हो तो उसे मदद मिल सके। यदि आप जानना चाहते हैं कि उच्च कार्डिनैलिटी क्या है, यह किन चुनौतियों को जन्म देती है, और उन्हें व्यावहारिक तथा प्रभावी तरीकों से कैसे काबू में किया जाए—तो आप सही जगह पर हैं!
कार्डिनैलिटी क्या है, और उच्च कार्डिनैलिटी क्या होती है?
कार्डिनैलिटी और उच्च कार्डिनैलिटी की अवधारणाएँ थोड़ी अमूर्त लग सकती हैं, तो आइए उन्हें सरल करें।
परिभाषा और उदाहरण
कार्डिनैलिटी किसी डेटासेट के कॉलम में अद्वितीय मानों की संख्या को दर्शाती है। उच्च कार्डिनैलिटी वाला कॉलम बहुत बड़ी संख्या में अद्वितीय मान रखता है, जबकि निम्न कार्डिनैलिटी वाले कॉलम में कम अद्वितीय प्रविष्टियाँ होती हैं।
उच्च कार्डिनैलिटी उन डेटासेट्स में विशेष रूप से आम है जिनमें अद्वितीय आइडेंटिफ़ायर होते हैं, जैसे:
- टाइमस्टैम्प्स: जब डेटा मिलीसेकंड या नैनोसेकंड स्तर पर लॉग किया जाता है, तो लगभग हर मान अद्वितीय होता है।
- कस्टमर IDs: प्रत्येक ग्राहक की गतिविधि को ट्रैक करने के लिए एक विशिष्ट पहचानकर्ता होता है।
- ट्रांज़ैक्शन IDs: वित्तीय डेटासेट्स में अक्सर हर लेन-देन के लिए एक अनोखा कोड शामिल होता है।
ये अद्वितीय मान ट्रैकिंग, समेकन या पर्सनलाइज़ेशन के लिए महत्वपूर्ण होते हैं। हालाँकि, इनकी विशाल संख्या स्टोरेज, परफॉर्मेंस और विज़ुअलाइज़ेशन में बड़ी चुनौतियाँ पैदा कर सकती है, जिन पर हम आगे नज़र डालेंगे।
सामान्य वास्तविक-जीवन परिदृश्य
उच्च कार्डिनैलिटी हर डोमेन और उद्योग में दिखाई दे सकती है। नीचे कुछ उदाहरण दिए गए हैं ताकि आप इसे अधिक व्यावहारिक रूप में समझ सकें।
ई-कॉमर्स और ग्राहक डेटा
ई-कॉमर्स प्लेटफ़ॉर्म रोज़ाना भारी मात्रा में उच्च-कार्डिनैलिटी डेटा उत्पन्न करते हैं:
- कस्टमर IDs: प्रत्येक उपयोगकर्ता को व्यवहार, खरीदारी और पसंद ट्रैक करने के लिए एक अद्वितीय पहचानकर्ता दिया जाता है।
- सेशन IDs: हर ब्राउज़िंग सेशन अलग से लॉग होता है, जिससे सेशन-ट्रैकिंग डेटासेट्स में बहुत सारे भिन्न मान बनते हैं।
- प्रोडक्ट SKUs: स्टॉक कीपिंग यूनिट्स हर प्रोडक्ट वेरिएशन के लिए अलग होती हैं, जिससे इन्वेंटरी और बिक्री डेटा में उच्च-कार्डिनैलिटी कॉलम बनते हैं।
ये डेटासेट्स उपयोगकर्ता व्यवहार समझने, इन्वेंटरी ट्रैक करने और बिक्री रणनीतियाँ अनुकूलित करने के लिए आवश्यक हैं, लेकिन अद्वितीय प्रविष्टियों की भारी संख्या विश्लेषण को जटिल बना देती है।
हेल्थकेयर और रोगी रिकॉर्ड
हेल्थकेयर में सटीक ट्रैकिंग और पहचान की ज़रूरत स्वाभाविक रूप से उच्च-कार्डिनैलिटी डेटा उत्पन्न करती है। उदाहरण के लिए, हम पाते हैं:
- पेशेंट IDs: प्रत्येक रोगी के पास सटीक और सुरक्षित रिकॉर्ड-कीपिंग सुनिश्चित करने के लिए एक अद्वितीय पहचानकर्ता होता है।
- अपॉइंटमेंट टाइमस्टैम्प्स: डॉक्टर विज़िट से लेकर लैब टेस्ट तक, हर रोगी इंटरैक्शन के लिए अद्वितीय टाइमस्टैम्प बनाए जा सकते हैं।
- इंश्योरेंस क्लेम नंबर: बीमा प्रदाताओं द्वारा संसाधित हर क्लेम को रिकॉर्ड-कीपिंग और ऑडिट हेतु एक अलग कोड दिया जाता है।
यह डेटा रोगियों के इतिहास बनाए रखने और गोपनीयता नियमों के अनुपालन को सुनिश्चित करने के लिए आवश्यक है।
IoT सेंसर और स्ट्रीमिंग डेटा
IoT डिवाइसेज़ के प्रसार ने उच्च-कार्डिनैलिटी डेटासेट्स में उछाल ला दिया है:
- सेंसर IDs: हर IoT डिवाइस के पास उसकी गतिविधि और लोकेशन ट्रैक करने के लिए एक अद्वितीय पहचानकर्ता होता है।
- टाइमस्टैम्प डेटा: सतत डेटा स्ट्रीम अक्सर मिलीसेकंड या नैनोसेकंड अंतराल पर घटनाओं को लॉग करती हैं, जिसके परिणामस्वरूप लगभग पूरी तरह अद्वितीय मान बनते हैं।
- इवेंट IDs: किसी सिस्टम में दर्ज हर घटना—तापमान रीडिंग से लेकर मोशन डिटेक्शन तक—को एक अद्वितीय पहचानकर्ता दिया जाता है।
IoT में, बड़ी संख्या में डिवाइसों से सूक्ष्म-स्तरीय, वास्तविक-समय डेटा संसाधित करने की आवश्यकता के कारण उच्च कार्डिनैलिटी पैदा होती है। यह एनालिटिक्स और मॉनिटरिंग के लिए अनिवार्य है लेकिन इन्हें कुशलता से स्टोर और क्वेरी करना चुनौतीपूर्ण होता है—इस पर आगे चर्चा करेंगे!
उच्च कार्डिनैलिटी की चुनौतियाँ
उच्च कार्डिनैलिटी डेटा प्रोसेसिंग, इंजीनियरिंग, विश्लेषण और मशीन लर्निंग में कई चुनौतियाँ पेश करती है। ऐसे डेटासेट्स जानकारी से भरपूर होते हैं, पर अक्सर बाधा बन जाते हैं और परफॉर्मेंस, व्याख्येयता तथा स्केलेबिलिटी को नुकसान पहुँचाते हैं।
डेटा स्टोरेज और परफॉर्मेंस से जुड़ी समस्याएँ
उच्च कार्डिनैलिटी की सबसे बड़ी चुनौतियों में से एक इसका डेटा स्टोरेज और सिस्टम परफॉर्मेंस पर असर है।
- स्टोरेज ओवरहेड: उच्च-कार्डिनैलिटी कॉलम, जैसे अद्वितीय आइडेंटिफ़ायर या टाइमस्टैम्प्स, डेटासेट्स को बड़ा बना देते हैं। उदाहरण के लिए, किसी ई-कॉमर्स प्लेटफ़ॉर्म पर लाखों यूज़र इंटरेक्शन लॉग करने से सेशन IDs या ट्रांज़ैक्शन टाइमस्टैम्प्स की विशिष्टता के कारण भारी स्टोरेज ओवरहेड पैदा होता है।
- क्वेरी परफॉर्मेंस में कमी: उच्च-कार्डिनैलिटी कॉलम पर क्वेरी करते समय डेटाबेस को इंडेक्सिंग और स्कैनिंग की बढ़ी हुई जटिलता से जूझना पड़ता है। ऐसे कॉलमों पर फ़िल्टर या जॉइन करने वाली क्वेरीज़ में अधिक समय लगता है, क्योंकि डेटाबेस को बहुत बड़ी संख्या में भिन्न मानों में से छाँटना पड़ता है।
- इंडेक्सिंग चुनौतियाँ: इंडेक्स, जो डेटाबेस क्वेरीज़ को तेज़ करने के लिए ज़रूरी होते हैं, उच्च-कार्डिनैलिटी कॉलम के साथ फूले हुए और कम कुशल हो जाते हैं। इससे लुकअप धीमे पड़ते हैं और परफॉर्मेंस गिरती है।
उदाहरण के तौर पर, अद्वितीय सेंसर IDs और सटीक टाइमस्टैम्प्स वाला IoT सेंसर डेटा स्टोर करने वाला डेटाबेस लें। किसी विशिष्ट सेंसर और समय-सीमा पर फ़िल्टर करने वाली क्वेरी के लिए डेटाबेस को लाखों अद्वितीय प्रविष्टियाँ प्रोसेस करनी पड़ सकती हैं, जिससे बेहद धीमी प्रतिक्रिया और संसाधन-गहन ऑपरेशंस होते हैं।
डेटा विज़ुअलाइज़ेशन में कठिनाइयाँ
यहाँ चुनौती बहुत बड़ी संख्या में भिन्न मानों को ऐसे प्रस्तुत करने की है जो समझने योग्य और सार्थक हो। बिना सोचे-समझे, उच्च-कार्डिनैलिटी डेटा इनसाइट्स को उजागर करने के बजाय छिपा भी सकता है।
इसका एक अच्छा उदाहरण नीचे दिया गया पाई चार्ट है। लीजेंड और मान अपठनीय हैं क्योंकि उपयोग किए गए चार्ट प्रकार के लिए अद्वितीय प्रविष्टियाँ (स्टेट्स) बहुत अधिक हैं। कभी-कभी ग्राफ़ का प्रकार बदलने से मदद मिलती है, पर हमेशा नहीं।
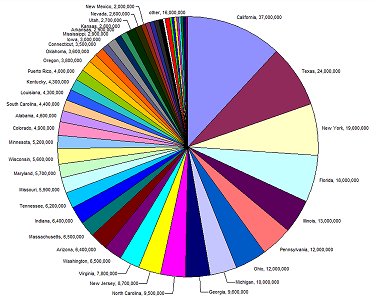
स्रोत: European Environment Agency
मान लीजिए एक बार चार्ट किसी ई-कॉमर्स प्लेटफ़ॉर्म की ग्राहक गतिविधि को सेशन ID के अनुसार दर्शा रहा है। हज़ारों या लाखों अद्वितीय IDs के साथ, चार्ट अपठनीय बार्स का गुच्छा बन जाएगा, और इस डेटा को प्लॉट करने के लिए चार्ट का प्रकार बदलना भी शायद फर्क न डाले।
तो फिर हम डेटा को एकत्रित करके अपने चार्ट्स से पैटर्न और रिश्ते क्यों न निकाल लें? कर सकते हैं, पर सावधानी से। उच्च-कार्डिनैलिटी डेटा का एग्रीगेशन कभी-कभी वह सूक्ष्मता खो देता है जिसकी हमें इनसाइट्स निकालने के लिए ज़रूरत होती है। उदाहरण के लिए, IoT डेटा को लोकेशन के आधार पर समूहित करने से व्यक्तिगत सेंसर-स्तर पर मौजूद हल्के लेकिन महत्वपूर्ण परिवर्तन दब सकते हैं। इन्हें ठीक करने की तकनीकें सूक्ष्म होती हैं। एक-से-एक और एक-से-अनेक रिश्तों का व्यावहारिक अनुभव लेने के लिए मैं हमारा Intermediate Data Modeling in Power BI कोर्स सुझाता/सुझाती हूँ।
मशीन लर्निंग से संबंध
उच्च कार्डिनैलिटी मशीन लर्निंग में विशेषकर फीचर इंजीनियरिंग, मॉडल जटिलता और व्याख्येयता के संदर्भ में बड़ी चुनौतियाँ पैदा कर सकती है। मशीन लर्निंग मॉडल संरचित और सार्थक इनपुट्स पर फलते-फूलते हैं, लेकिन उच्च-कार्डिनैलिटी फीचर्स इस संतुलन को बिगाड़ देते हैं, जिससे जटिलताएँ पैदा होती हैं:
- स्पैरसिटी में वृद्धि: उच्च-कार्डिनैलिटी फीचर्स अक्सर स्पैर्स डेटासेट्स बनाते हैं। उदाहरण के लिए, ZIP कोड जैसे उच्च-कार्डिनैलिटी श्रेणीबद्ध फीचर का वन-हॉट एन्कोडिंग बहुत बड़ी आयाम-गणना वाली मैट्रिक्स बनाता है, जिनमें से अधिकांश एंट्री खाली होती हैं। यह स्पैरसिटी मॉडल्स—खासतौर पर दूरी-आधारित जैसे k-nearest neighbors या क्लस्टरिंग एल्गोरिद्म—के लिए डेटा में सार्थक रिश्ते ढूँढना मुश्किल बना देती है।
- ओवरफ़िटिंग का जोखिम: उच्च-कार्डिनैलिटी फीचर्स उन मॉडलों में ओवरफ़िटिंग करा सकते हैं जो डेटा को सूक्ष्म श्रेणियों में बाँटते हैं, जैसे डिसीजन ट्रीज़ या रैंडम फॉरेस्ट्स। जब प्रत्येक श्रेणी बहुत कम नमूनों से प्रतिनिधित्वित होती है, तो मॉडल वास्तविक पैटर्न की बजाय शोर सीख सकता है, जिससे नए डेटा पर सामान्यीकरण कमजोर हो जाता है।
उदाहरण के लिए, ई-कॉमर्स में ग्राहक चर्न की भविष्यवाणी करने वाला मॉडल "user ID" या "product ID" जैसे उच्च-कार्डिनैलिटी फीचर शामिल कर सकता है। यदि इन्हें ठीक से प्रबंधित न किया जाए, तो मॉडल प्रशिक्षण डेटा में मौजूद विशिष्ट ग्राहकों या प्रोडक्ट्स पर ओवरफ़िट हो सकता है। इससे नए उपयोगकर्ताओं के लिए चर्न का पूर्वानुमान लगाते समय इसकी क्षमता घट जाएगी, क्योंकि यह सामान्य रुझानों के बजाय प्रशिक्षण डेटासेट के लिए अद्वितीय पैटर्न सीख लेता है।
उच्च कार्डिनैलिटी को संभालने की रणनीतियाँ
उच्च कार्डिनैलिटी का प्रभावी प्रबंधन डोमेन-विशिष्ट रणनीतियों और सामान्य डेटा अनुकूलन तकनीकों के मेल की माँग करता है। ये तरीके न केवल सिस्टम परफॉर्मेंस बेहतर करते हैं बल्कि डेटा को अधिक व्याख्येय और क्रियान्वित करने योग्य बनाते हैं।
प्रौद्योगिकी और टूल्स का लाभ उठाना
खुशकिस्मती से, उच्च-कार्डिनैलिटी डेटासेट्स से पैदा होने वाली चुनौतियाँ इतनी व्यापक हैं कि उनसे निपटने के लिए अलग-अलग तकनीकें और टूल्स विशेष रूप से बनाए और परिष्कृत किए गए हैं।
डेटाबेस ऑप्टिमाइज़ेशन
डेटाबेस में उच्च कार्डिनैलिटी का प्रबंधन अक्सर इस बात के अनुकूलन से शुरू होता है कि डेटा कैसे स्टोर और क्वेरी किया जाता है—सिर्फ डुप्लिकेट हटाने से आगे बढ़कर। सबसे आम तकनीकें हैं:
- बकेटिंग (या बिनिंग): उच्च-कार्डिनैलिटी डेटा को व्यापक श्रेणियों में समूहित करना ताकि अद्वितीय मानों की संख्या घटे। उदाहरण के लिए, हर ZIP कोड को अलग से स्टोर करने के बजाय उन्हें क्षेत्र के आधार पर समूहित करना।
- पार्टिशनिंग: अक्सर क्वेरी किए जाने वाले फ़ील्ड्स के आधार पर टेबल्स को पार्टिशनों में संरचित करना। जैसे, ग्राहक डेटा को देश के अनुसार पार्टिशन करना, भौगोलिक रूप से वितरित सिस्टम्स में क्वेरी परफॉर्मेंस सुधार सकता है।
- इंडेक्सिंग: उच्च-कार्डिनैलिटी फ़ील्ड्स के लिए विशेष रूप से डिज़ाइन किए गए इंडेक्स, जैसे बिटमैप या कॉम्पोज़िट इंडेक्स, क्वेरी स्पीड को बेहतर करते हुए स्टोरेज क्षमता का संतुलन बनाए रख सकते हैं।
विशेषीकृत सॉफ़्टवेयर
यदि आप अत्यधिक उच्च कार्डिनैलिटी से जूझ रहे हैं, तो कुछ विशेष टूल्स और प्लेटफ़ॉर्म आपकी मदद कर सकते हैं:
- कॉलमनर डेटाबेस: जैसे Apache Parquet या Amazon Redshift, जो विश्लेषणात्मक क्वेरीज़ के लिए बने हैं और उच्च-कार्डिनैलिटी कॉलम को कुशलता से स्टोर और प्रोसेस कर सकते हैं।
- NoSQL डेटाबेस: कुछ मामलों में, MongoDB या Elasticsearch जैसे NoSQL डेटाबेस, विशेषकर स्कीमा-लेस डिज़ाइनों के साथ, उच्च-कार्डिनैलिटी डेटासेट्स की विविधता और आकार को बेहतर तरीके से संभाल सकते हैं।
- टाइम सीरीज़ डेटाबेस: टाइमस्टैम्प्स और इवेंट्स-प्रधान डेटासेट्स के लिए, जैसे IoT सेंसर डेटा या शेयर बाज़ार के लेन-देन, InfluxDB या TimescaleDB जैसे टाइम सीरीज़ डेटाबेस बेहद मददगार होते हैं। वे उच्च-कार्डिनैलिटी डाइमेंशन्स को कुशलता से स्टोर करने के लिए विशेष रूप से ऑप्टिमाइज़्ड होते हैं और उन्नत कंप्रेशन तकनीकों का उपयोग करते हैं ताकि स्टोरेज लागत कम रहे और परफॉर्मेंस उच्च बना रहे। मैंने IoT डेटा की भारी मात्रा वाले कुछ प्रोजेक्ट्स पर काम किया है, और ट्रेंड्स व प्रीडिक्शंस निकालने में टाइम सीरीज़ डेटाबेस ने बड़ा फर्क डाला। यदि आप और जानना चाहते हैं तो मैंने टाइम सीरीज़ डेटाबेस पर यह गाइड लिखा है!
- डेटा प्रोफाइलिंग टूल्स: Talend, OpenRefine जैसे टूल्स या कस्टम Python स्क्रिप्ट्स उच्च-कार्डिनैलिटी फ़ील्ड्स को तेज़ी से पहचान सकते हैं और सर्वोत्तम प्री-प्रोसेसिंग या स्टोरेज रणनीति तय करने में सहायता करते हैं।
डेटा प्रीप्रोसेसिंग तकनीकें
डेटा साइंस और मशीन लर्निंग में प्रीप्रोसेसिंग उन चरणों को संदर्भित करती है जिनमें कच्चे डेटा को साफ़, रूपांतरित और व्यवस्थित करके विश्लेषण या मॉडलिंग के लिए उपयुक्त प्रारूप में ढाला जाता है।
यह काफ़ी व्यापक विषय है, और यदि आपका डेटा इंजीनियरिंग या डेटा साइंस का ज्ञान कम है, तो यह अनुभाग थोड़ा कठिन लग सकता है। फिर भी, मैंने साथ चलने में मदद के लिए प्रासंगिक लिंक्स और उदाहरण शामिल किए हैं!
उच्च कार्डिनैलिटी को संभालने के लिए डेटा प्रीप्रोसेसिंग एक आवश्यक कदम है, क्योंकि यह जटिलता घटाती है, परफॉर्मेंस बढ़ाती है और यह सुनिश्चित करती है कि डेटा की गुणवत्ता विश्लेषण या मशीन लर्निंग कार्यों के लिए पर्याप्त हो। कच्चे डेटा को अधिक प्रबंधनीय रूपों में बदलकर, हम स्पैरसिटी, स्टोरेज की अकार्यकुशलता और कम्प्यूटेशनल बोतलनेक्स जैसी चुनौतियों का समाधान कर सकते हैं।
डायमेंशनलिटी रिडक्शन
जब उच्च कार्डिनैलिटी के कारण ढेर सारे फीचर्स या स्पैर्स मैट्रिसेज़ बन जाती हैं, तब डायमेंशनलिटी रिडक्शन तकनीकें विशेष रूप से मूल्यवान होती हैं। ये तरीके कम आयामों में डेटा को संपीड़ित करते हुए भी महत्वपूर्ण जानकारी बनाए रखते हैं।
प्रिंसिपल कंपोनेंट एनालिसिस (PCA)
मान लीजिए आपके पास ई-कॉमर्स ग्राहकों के व्यवहार का डेटासेट है, जिसमें बहुत से फीचर्स हैं—किसी ग्राहक ने किसी प्रोडक्ट को कितनी बार देखा, अलग-अलग प्रोडक्ट कैटेगरीज़ के साथ उनकी इंटरैक्शन, वेबसाइट पर बिताया समय, वगैरह। यदि आप बड़ी संख्या में प्रोडक्ट्स ट्रैक कर रहे हैं तो इनमें से कई फीचर्स उच्च-कार्डिनैलिटी हो सकते हैं। PCA इन फीचर्स को कम कंपोनेंट्स में संयोजित कर सकता है जो डेटा के सबसे महत्वपूर्ण पैटर्न—जैसे कुल मिलाकर ग्राहक एंगेजमेंट या विशिष्ट प्रोडक्ट प्रकारों में रुचि—को पकड़ते हैं। इसे डेटा की मेरी कोंडो समझिए: यह उन्हीं फीचर्स को रखता है जो “खुशी जगाएँ” और बाकी को सलीके से अलग कर देता है!
t-SNE और UMAP
t-SNE और UMAP ऐसी तकनीकें हैं जो उच्च-आयामी डेटा को दो या तीन आयामों में मैप करके विज़ुअलाइज़ करने में बेहद सहायक हैं, साथ ही उसकी संरचना भी बनाए रखती हैं। उदाहरण के लिए, हेल्थकेयर रिकॉर्ड्स के डेटासेट्स में UMAP समान चिकित्सीय स्थितियों या उपचार-रीज़ीम वाले रोगियों को एक साथ समूहित करने में मदद कर सकता है। इससे साथ-साथ घटित होने वाली बीमारियाँ या उपचार के परिणाम जैसे रुझान पहचानने में सहायता मिलती है।
फ़ीचर चयन
यदि आप किसी ई-कॉमर्स प्लेटफ़ॉर्म के लिए बिक्री प्रदर्शन का पूर्वानुमान लगाने वाला मशीन लर्निंग मॉडल बना रहे हैं, और आपके डेटासेट में फीचर्स हैं—जैसे किसी ग्राहक ने विज्ञापन पर कितनी बार क्लिक किया, कितने प्रोडक्ट्स देखे, उनकी पिछली खरीद से कितने दिन बीते—तो पाएँगे कि इनमें से कई फीचर्स आपस में सहसंबद्ध हैं, जिससे उच्च कार्डिनैलिटी और अतिशयता पैदा होती है।
म्यूचुअल इंफॉर्मेशन या रिकर्सिव फ़ीचर एलिमिनेशन जैसी तकनीकों का उपयोग करके आप यह पहचान सकते हैं कि किन फीचर्स की भविष्यवाणी-क्षमता सबसे अधिक है (उदाहरण के लिए, "पिछली खरीद से बीता समय" शायद "विज्ञापन पर क्लिक" से अधिक महत्त्वपूर्ण हो) और अप्रासंगिक फीचर्स को हटा सकते हैं, जिससे अंततः मॉडल का परफॉर्मेंस सुधरता है।
यदि आप इस विषय पर और सीखना चाहते हैं, तो यह Preprocessing for Machine Learning कोर्स आज़माएँ। आप Python का उपयोग करके अपने डेटा को मॉडलों में देने से पहले साफ़ और तैयार करेंगे।
एन्कोडिंग विधियाँ
एन्कोडिंग श्रेणीबद्ध डेटा को संभालने के लिए एक महत्वपूर्ण प्रीप्रोसेसिंग चरण है, विशेषकर उच्च-कार्डिनैलिटी फीचर्स के साथ। एन्कोडिंग विधि का चुनाव उपयोग-परिदृश्य और डेटासेट में मौजूद कार्डिनैलिटी के स्तर पर निर्भर करता है।
- वन-हॉट एन्कोडिंग: वन-हॉट एन्कोडिंग डेटासेट में प्रत्येक अद्वितीय श्रेणी के लिए एक बाइनरी कॉलम बनाता है। कम-कार्डिनैलिटी डेटा के लिए यह सरल और कारगर है, लेकिन उच्च-कार्डिनैलिटी फीचर्स पर यह अत्यधिक स्पैर्स मैट्रिसेज़ बना देता है। उदाहरण के लिए, 1,000 अद्वितीय ZIP कोड्स को एन्कोड करना 1,000 बाइनरी कॉलम बना देगा, जो मेमोरी और कम्प्यूट संसाधनों पर बोझ डाल सकता है। यक़ीन मानिए, यह मैंने कठिनाई से सीखा है…
- टारगेट एन्कोडिंग (मीन एन्कोडिंग): इस विधि में, श्रेणीबद्ध मानों को प्रत्येक श्रेणी के लिए लक्ष्य चर के औसत से बदला जाता है। उदाहरण के लिए, यदि आप ग्राहक चर्न की भविष्यवाणी कर रहे हैं, तो टारगेट एन्कोडिंग प्रत्येक ZIP कोड को उस क्षेत्र के औसत चर्न रेट से बदल सकती है। यह तरीका आयाम घटाता है, लेकिन पूर्वग्रह ला सकता है और डेटा लीकेज से बचने के लिए सावधानीपूर्वक वैलिडेशन की आवश्यकता होती है।
- फ़्रीक्वेंसी एन्कोडिंग: फ़्रीक्वेंसी एन्कोडिंग किसी श्रेणी की आवृत्ति को उसका मान बनाती है, जिससे अद्वितीय मानों की संख्या घटती है। उदाहरण के लिए, किसी ई-कॉमर्स डेटासेट में प्रोडक्ट IDs को उनकी खरीद आवृत्ति से बदला जा सकता है। यह तकनीक संसाधन-कुशल है और अक्सर फीचर के महत्व से सहसंबद्ध होती है।
- हैशिंग एन्कोडिंग: हैशिंग एन्कोडिंग किसी हैश फंक्शन का उपयोग करके श्रेणियों को पूर्णांकों पर मैप करती है, जिससे कुछ श्रेणियाँ एक साथ समूहित हो जाती हैं। यह तरीका मेमोरी-कुशल है और स्ट्रीमिंग डेटा या अत्यधिक उच्च कार्डिनैलिटी के लिए अच्छा काम करता है, लेकिन हैश कोलिज़न का जोखिम लाता है। कभी सोचा है कि ऑनलाइन शॉपिंग साइट ने कार ऑयल ढूँढने पर आपको बेबी फ़ॉर्मूला क्यों सुझा दिया? बस, वही हैं हैश कोलिज़न।
- एम्बेडिंग लेयर्स: न्यूरल नेटवर्क जैसे मशीन लर्निंग मॉडलों के लिए, एम्बेडिंग लेयर्स उच्च-कार्डिनैलिटी श्रेणीबद्ध फीचर्स को सघन, निम्न-आयामी निरूपणों में बदल सकती हैं। यह तरीका रिकमेंडेशन सिस्टम्स में व्यापक रूप से उपयोग होता है, जैसे ई-कॉमर्स प्लेटफ़ॉर्म्स में लाखों प्रोडक्ट IDs या यूज़र IDs को एन्कोड करना।
निष्कर्ष
उच्च-कार्डिनैलिटी वाले डेटासेट्स कभी-कभी भारी लग सकते हैं, और उनसे मूल्यवान इनसाइट्स निकालना वाकई चुनौतीपूर्ण हो सकता है। अगली बार जब आप ऐसे डेटासेट से रूबरू हों, तो याद रखें कि गलती डेटा की नहीं—वह तो संभावनाओं से भरा है जिन्हें खोला जाना बाकी है। चाहे डायमेंशनलिटी रिडक्शन हो, स्मार्ट एन्कोडिंग तकनीकें हों, या टाइम सीरीज़ डेटाबेस जैसे टूल्स—आप अपने डेटासेट्स को प्रभावी ढंग से प्रबंधित कर उन्हें बेहद शक्तिशाली एसेट में बदल सकते हैं।
और अब जबकि आपने सिद्धांत में उच्च-कार्डिनैलिटी डेटा के साथ काम करना समझ लिया है, तो इसे व्यवहार में लाने का समय है:
- डायमेंशनलिटी रिडक्शन और एन्कोडिंग तकनीकों के साथ हाथ गंदे करें—छोटे से शुरू करें और धीरे-धीरे आगे बढ़ें। हमारा Dimensionality Reduction in Python बढ़िया विकल्प है।
- यहाँ बताए गए कुछ टूल्स आज़माएँ (हाँ, टाइम सीरीज़ डेटाबेस उतने ही शानदार हैं जितना वे सुनाई देते हैं!).
और सबसे महत्वपूर्ण, चुनौती को अपनाएँ। उच्च कार्डिनैलिटी मुश्किल हो सकती है, लेकिन यह डेटा इंजीनियरिंग और विश्लेषण के बारे में बहुत कुछ सीखने का अवसर भी है!


मैंने पहली बार कार्डिनैलिटी की अवधारणा से अपने भौतिकी के दौरान क्वांटम मैकेनिक्स की कक्षा में सामना किया। वहाँ, कार्डिनैलिटी का अर्थ किसी समुच्चय का आकार था—ससीम या असीम—और यह गणनीयता तथा अनंतताओं जैसे अमूर्त विचारों से जुड़ा था। सॉफ्टवेयर इंजीनियरिंग में आने के बाद मुझे एहसास हुआ कि डेटा इंजीनियर या वैज्ञानिक के लिए कार्डिनैलिटी का अर्थ कहीं अधिक व्यावहारिक होता है: किसी डेटासेट में मानों की विशिष्टता।
वास्तविक-जीवन के डेटा का विश्लेषण करने वाले अपने शुरुआती प्रोजेक्ट्स में से एक में, मुझे पता चला कि उच्च कार्डिनैलिटी कितनी चुनौतीपूर्ण हो सकती है। इसने मेरे डेटाबेस क्वेरीज़ को बेहद धीमा कर दिया और जो स्पष्ट इनसाइट्स मिलनी चाहिए थीं, वे उलझन भरे नतीजों में बदल गईं। तब से मुझे कुछ हाथों-हाथ अभ्यास मिला है, और मैंने यह गाइड तैयार किया है ताकि यही स्थिति किसी और के साथ हो तो उसे मदद मिल सके। यदि आप जानना चाहते हैं कि उच्च कार्डिनैलिटी क्या है, यह किन चुनौतियों को जन्म देती है, और उन्हें व्यावहारिक तथा प्रभावी तरीकों से कैसे काबू में किया जाए—तो आप सही जगह पर हैं!
कार्डिनैलिटी क्या है, और उच्च कार्डिनैलिटी क्या होती है?
कार्डिनैलिटी और उच्च कार्डिनैलिटी की अवधारणाएँ थोड़ी अमूर्त लग सकती हैं, तो आइए उन्हें सरल करें।
परिभाषा और उदाहरण
कार्डिनैलिटी किसी डेटासेट के कॉलम में अद्वितीय मानों की संख्या को दर्शाती है। उच्च कार्डिनैलिटी वाला कॉलम बहुत बड़ी संख्या में अद्वितीय मान रखता है, जबकि निम्न कार्डिनैलिटी वाले कॉलम में कम अद्वितीय प्रविष्टियाँ होती हैं।
उच्च कार्डिनैलिटी उन डेटासेट्स में विशेष रूप से आम है जिनमें अद्वितीय आइडेंटिफ़ायर होते हैं, जैसे:
ये अद्वितीय मान ट्रैकिंग, समेकन या पर्सनलाइज़ेशन के लिए महत्वपूर्ण होते हैं। हालाँकि, इनकी विशाल संख्या स्टोरेज, परफॉर्मेंस और विज़ुअलाइज़ेशन में बड़ी चुनौतियाँ पैदा कर सकती है, जिन पर हम आगे नज़र डालेंगे।
सामान्य वास्तविक-जीवन परिदृश्य
उच्च कार्डिनैलिटी हर डोमेन और उद्योग में दिखाई दे सकती है। नीचे कुछ उदाहरण दिए गए हैं ताकि आप इसे अधिक व्यावहारिक रूप में समझ सकें।
ई-कॉमर्स और ग्राहक डेटा
ई-कॉमर्स प्लेटफ़ॉर्म रोज़ाना भारी मात्रा में उच्च-कार्डिनैलिटी डेटा उत्पन्न करते हैं:
ये डेटासेट्स उपयोगकर्ता व्यवहार समझने, इन्वेंटरी ट्रैक करने और बिक्री रणनीतियाँ अनुकूलित करने के लिए आवश्यक हैं, लेकिन अद्वितीय प्रविष्टियों की भारी संख्या विश्लेषण को जटिल बना देती है।
हेल्थकेयर और रोगी रिकॉर्ड
हेल्थकेयर में सटीक ट्रैकिंग और पहचान की ज़रूरत स्वाभाविक रूप से उच्च-कार्डिनैलिटी डेटा उत्पन्न करती है। उदाहरण के लिए, हम पाते हैं:
यह डेटा रोगियों के इतिहास बनाए रखने और गोपनीयता नियमों के अनुपालन को सुनिश्चित करने के लिए आवश्यक है।
IoT सेंसर और स्ट्रीमिंग डेटा
IoT डिवाइसेज़ के प्रसार ने उच्च-कार्डिनैलिटी डेटासेट्स में उछाल ला दिया है:
IoT में, बड़ी संख्या में डिवाइसों से सूक्ष्म-स्तरीय, वास्तविक-समय डेटा संसाधित करने की आवश्यकता के कारण उच्च कार्डिनैलिटी पैदा होती है। यह एनालिटिक्स और मॉनिटरिंग के लिए अनिवार्य है लेकिन इन्हें कुशलता से स्टोर और क्वेरी करना चुनौतीपूर्ण होता है—इस पर आगे चर्चा करेंगे!
उच्च कार्डिनैलिटी की चुनौतियाँ
उच्च कार्डिनैलिटी डेटा प्रोसेसिंग, इंजीनियरिंग, विश्लेषण और मशीन लर्निंग में कई चुनौतियाँ पेश करती है। ऐसे डेटासेट्स जानकारी से भरपूर होते हैं, पर अक्सर बाधा बन जाते हैं और परफॉर्मेंस, व्याख्येयता तथा स्केलेबिलिटी को नुकसान पहुँचाते हैं।
डेटा स्टोरेज और परफॉर्मेंस से जुड़ी समस्याएँ
उच्च कार्डिनैलिटी की सबसे बड़ी चुनौतियों में से एक इसका डेटा स्टोरेज और सिस्टम परफॉर्मेंस पर असर है।
उदाहरण के तौर पर, अद्वितीय सेंसर IDs और सटीक टाइमस्टैम्प्स वाला IoT सेंसर डेटा स्टोर करने वाला डेटाबेस लें। किसी विशिष्ट सेंसर और समय-सीमा पर फ़िल्टर करने वाली क्वेरी के लिए डेटाबेस को लाखों अद्वितीय प्रविष्टियाँ प्रोसेस करनी पड़ सकती हैं, जिससे बेहद धीमी प्रतिक्रिया और संसाधन-गहन ऑपरेशंस होते हैं।
डेटा विज़ुअलाइज़ेशन में कठिनाइयाँ
यहाँ चुनौती बहुत बड़ी संख्या में भिन्न मानों को ऐसे प्रस्तुत करने की है जो समझने योग्य और सार्थक हो। बिना सोचे-समझे, उच्च-कार्डिनैलिटी डेटा इनसाइट्स को उजागर करने के बजाय छिपा भी सकता है।
इसका एक अच्छा उदाहरण नीचे दिया गया पाई चार्ट है। लीजेंड और मान अपठनीय हैं क्योंकि उपयोग किए गए चार्ट प्रकार के लिए अद्वितीय प्रविष्टियाँ (स्टेट्स) बहुत अधिक हैं। कभी-कभी ग्राफ़ का प्रकार बदलने से मदद मिलती है, पर हमेशा नहीं।
स्रोत: European Environment Agency
मान लीजिए एक बार चार्ट किसी ई-कॉमर्स प्लेटफ़ॉर्म की ग्राहक गतिविधि को सेशन ID के अनुसार दर्शा रहा है। हज़ारों या लाखों अद्वितीय IDs के साथ, चार्ट अपठनीय बार्स का गुच्छा बन जाएगा, और इस डेटा को प्लॉट करने के लिए चार्ट का प्रकार बदलना भी शायद फर्क न डाले।
तो फिर हम डेटा को एकत्रित करके अपने चार्ट्स से पैटर्न और रिश्ते क्यों न निकाल लें? कर सकते हैं, पर सावधानी से। उच्च-कार्डिनैलिटी डेटा का एग्रीगेशन कभी-कभी वह सूक्ष्मता खो देता है जिसकी हमें इनसाइट्स निकालने के लिए ज़रूरत होती है। उदाहरण के लिए, IoT डेटा को लोकेशन के आधार पर समूहित करने से व्यक्तिगत सेंसर-स्तर पर मौजूद हल्के लेकिन महत्वपूर्ण परिवर्तन दब सकते हैं। इन्हें ठीक करने की तकनीकें सूक्ष्म होती हैं। एक-से-एक और एक-से-अनेक रिश्तों का व्यावहारिक अनुभव लेने के लिए मैं हमारा Intermediate Data Modeling in Power BI कोर्स सुझाता/सुझाती हूँ।
मशीन लर्निंग से संबंध
उच्च कार्डिनैलिटी मशीन लर्निंग में विशेषकर फीचर इंजीनियरिंग, मॉडल जटिलता और व्याख्येयता के संदर्भ में बड़ी चुनौतियाँ पैदा कर सकती है। मशीन लर्निंग मॉडल संरचित और सार्थक इनपुट्स पर फलते-फूलते हैं, लेकिन उच्च-कार्डिनैलिटी फीचर्स इस संतुलन को बिगाड़ देते हैं, जिससे जटिलताएँ पैदा होती हैं:
उदाहरण के लिए, ई-कॉमर्स में ग्राहक चर्न की भविष्यवाणी करने वाला मॉडल "user ID" या "product ID" जैसे उच्च-कार्डिनैलिटी फीचर शामिल कर सकता है। यदि इन्हें ठीक से प्रबंधित न किया जाए, तो मॉडल प्रशिक्षण डेटा में मौजूद विशिष्ट ग्राहकों या प्रोडक्ट्स पर ओवरफ़िट हो सकता है। इससे नए उपयोगकर्ताओं के लिए चर्न का पूर्वानुमान लगाते समय इसकी क्षमता घट जाएगी, क्योंकि यह सामान्य रुझानों के बजाय प्रशिक्षण डेटासेट के लिए अद्वितीय पैटर्न सीख लेता है।
उच्च कार्डिनैलिटी को संभालने की रणनीतियाँ
उच्च कार्डिनैलिटी का प्रभावी प्रबंधन डोमेन-विशिष्ट रणनीतियों और सामान्य डेटा अनुकूलन तकनीकों के मेल की माँग करता है। ये तरीके न केवल सिस्टम परफॉर्मेंस बेहतर करते हैं बल्कि डेटा को अधिक व्याख्येय और क्रियान्वित करने योग्य बनाते हैं।
प्रौद्योगिकी और टूल्स का लाभ उठाना
खुशकिस्मती से, उच्च-कार्डिनैलिटी डेटासेट्स से पैदा होने वाली चुनौतियाँ इतनी व्यापक हैं कि उनसे निपटने के लिए अलग-अलग तकनीकें और टूल्स विशेष रूप से बनाए और परिष्कृत किए गए हैं।
डेटाबेस ऑप्टिमाइज़ेशन
डेटाबेस में उच्च कार्डिनैलिटी का प्रबंधन अक्सर इस बात के अनुकूलन से शुरू होता है कि डेटा कैसे स्टोर और क्वेरी किया जाता है—सिर्फ डुप्लिकेट हटाने से आगे बढ़कर। सबसे आम तकनीकें हैं:
विशेषीकृत सॉफ़्टवेयर
यदि आप अत्यधिक उच्च कार्डिनैलिटी से जूझ रहे हैं, तो कुछ विशेष टूल्स और प्लेटफ़ॉर्म आपकी मदद कर सकते हैं:
डेटा प्रीप्रोसेसिंग तकनीकें
डेटा साइंस और मशीन लर्निंग में प्रीप्रोसेसिंग उन चरणों को संदर्भित करती है जिनमें कच्चे डेटा को साफ़, रूपांतरित और व्यवस्थित करके विश्लेषण या मॉडलिंग के लिए उपयुक्त प्रारूप में ढाला जाता है।
यह काफ़ी व्यापक विषय है, और यदि आपका डेटा इंजीनियरिंग या डेटा साइंस का ज्ञान कम है, तो यह अनुभाग थोड़ा कठिन लग सकता है। फिर भी, मैंने साथ चलने में मदद के लिए प्रासंगिक लिंक्स और उदाहरण शामिल किए हैं!
उच्च कार्डिनैलिटी को संभालने के लिए डेटा प्रीप्रोसेसिंग एक आवश्यक कदम है, क्योंकि यह जटिलता घटाती है, परफॉर्मेंस बढ़ाती है और यह सुनिश्चित करती है कि डेटा की गुणवत्ता विश्लेषण या मशीन लर्निंग कार्यों के लिए पर्याप्त हो। कच्चे डेटा को अधिक प्रबंधनीय रूपों में बदलकर, हम स्पैरसिटी, स्टोरेज की अकार्यकुशलता और कम्प्यूटेशनल बोतलनेक्स जैसी चुनौतियों का समाधान कर सकते हैं।
डायमेंशनलिटी रिडक्शन
जब उच्च कार्डिनैलिटी के कारण ढेर सारे फीचर्स या स्पैर्स मैट्रिसेज़ बन जाती हैं, तब डायमेंशनलिटी रिडक्शन तकनीकें विशेष रूप से मूल्यवान होती हैं। ये तरीके कम आयामों में डेटा को संपीड़ित करते हुए भी महत्वपूर्ण जानकारी बनाए रखते हैं।
प्रिंसिपल कंपोनेंट एनालिसिस (PCA)
मान लीजिए आपके पास ई-कॉमर्स ग्राहकों के व्यवहार का डेटासेट है, जिसमें बहुत से फीचर्स हैं—किसी ग्राहक ने किसी प्रोडक्ट को कितनी बार देखा, अलग-अलग प्रोडक्ट कैटेगरीज़ के साथ उनकी इंटरैक्शन, वेबसाइट पर बिताया समय, वगैरह। यदि आप बड़ी संख्या में प्रोडक्ट्स ट्रैक कर रहे हैं तो इनमें से कई फीचर्स उच्च-कार्डिनैलिटी हो सकते हैं। PCA इन फीचर्स को कम कंपोनेंट्स में संयोजित कर सकता है जो डेटा के सबसे महत्वपूर्ण पैटर्न—जैसे कुल मिलाकर ग्राहक एंगेजमेंट या विशिष्ट प्रोडक्ट प्रकारों में रुचि—को पकड़ते हैं। इसे डेटा की मेरी कोंडो समझिए: यह उन्हीं फीचर्स को रखता है जो “खुशी जगाएँ” और बाकी को सलीके से अलग कर देता है!
t-SNE और UMAP
t-SNE और UMAP ऐसी तकनीकें हैं जो उच्च-आयामी डेटा को दो या तीन आयामों में मैप करके विज़ुअलाइज़ करने में बेहद सहायक हैं, साथ ही उसकी संरचना भी बनाए रखती हैं। उदाहरण के लिए, हेल्थकेयर रिकॉर्ड्स के डेटासेट्स में UMAP समान चिकित्सीय स्थितियों या उपचार-रीज़ीम वाले रोगियों को एक साथ समूहित करने में मदद कर सकता है। इससे साथ-साथ घटित होने वाली बीमारियाँ या उपचार के परिणाम जैसे रुझान पहचानने में सहायता मिलती है।
फ़ीचर चयन
यदि आप किसी ई-कॉमर्स प्लेटफ़ॉर्म के लिए बिक्री प्रदर्शन का पूर्वानुमान लगाने वाला मशीन लर्निंग मॉडल बना रहे हैं, और आपके डेटासेट में फीचर्स हैं—जैसे किसी ग्राहक ने विज्ञापन पर कितनी बार क्लिक किया, कितने प्रोडक्ट्स देखे, उनकी पिछली खरीद से कितने दिन बीते—तो पाएँगे कि इनमें से कई फीचर्स आपस में सहसंबद्ध हैं, जिससे उच्च कार्डिनैलिटी और अतिशयता पैदा होती है।
म्यूचुअल इंफॉर्मेशन या रिकर्सिव फ़ीचर एलिमिनेशन जैसी तकनीकों का उपयोग करके आप यह पहचान सकते हैं कि किन फीचर्स की भविष्यवाणी-क्षमता सबसे अधिक है (उदाहरण के लिए, "पिछली खरीद से बीता समय" शायद "विज्ञापन पर क्लिक" से अधिक महत्त्वपूर्ण हो) और अप्रासंगिक फीचर्स को हटा सकते हैं, जिससे अंततः मॉडल का परफॉर्मेंस सुधरता है।
यदि आप इस विषय पर और सीखना चाहते हैं, तो यह Preprocessing for Machine Learning कोर्स आज़माएँ। आप Python का उपयोग करके अपने डेटा को मॉडलों में देने से पहले साफ़ और तैयार करेंगे।
एन्कोडिंग विधियाँ
एन्कोडिंग श्रेणीबद्ध डेटा को संभालने के लिए एक महत्वपूर्ण प्रीप्रोसेसिंग चरण है, विशेषकर उच्च-कार्डिनैलिटी फीचर्स के साथ। एन्कोडिंग विधि का चुनाव उपयोग-परिदृश्य और डेटासेट में मौजूद कार्डिनैलिटी के स्तर पर निर्भर करता है।
निष्कर्ष
उच्च-कार्डिनैलिटी वाले डेटासेट्स कभी-कभी भारी लग सकते हैं, और उनसे मूल्यवान इनसाइट्स निकालना वाकई चुनौतीपूर्ण हो सकता है। अगली बार जब आप ऐसे डेटासेट से रूबरू हों, तो याद रखें कि गलती डेटा की नहीं—वह तो संभावनाओं से भरा है जिन्हें खोला जाना बाकी है। चाहे डायमेंशनलिटी रिडक्शन हो, स्मार्ट एन्कोडिंग तकनीकें हों, या टाइम सीरीज़ डेटाबेस जैसे टूल्स—आप अपने डेटासेट्स को प्रभावी ढंग से प्रबंधित कर उन्हें बेहद शक्तिशाली एसेट में बदल सकते हैं।
और अब जबकि आपने सिद्धांत में उच्च-कार्डिनैलिटी डेटा के साथ काम करना समझ लिया है, तो इसे व्यवहार में लाने का समय है:
और सबसे महत्वपूर्ण, चुनौती को अपनाएँ। उच्च कार्डिनैलिटी मुश्किल हो सकती है, लेकिन यह डेटा इंजीनियरिंग और विश्लेषण के बारे में बहुत कुछ सीखने का अवसर भी है!