Tôi lần đầu gặp khái niệm cardinality trong lớp Cơ học lượng tử khi học ngành Vật lý. Trong lớp đó, cardinality đề cập đến kích thước của một tập hợp, hữu hạn hoặc vô hạn, và gắn liền với những khái niệm trừu tượng như đếm được và vô cực. Khi chuyển sang kỹ thuật phần mềm, tôi nhận ra rằng với kỹ sư dữ liệu hay nhà khoa học dữ liệu, cardinality mang ý nghĩa thực tiễn hơn nhiều: mức độ khác biệt của các giá trị trong một tập dữ liệu.
Trong một trong những dự án đầu tiên phân tích dữ liệu thực tế, tôi đã hiểu high cardinality có thể thách thức đến mức nào. Nó làm các truy vấn cơ sở dữ liệu của tôi chậm như rùa và biến những thông tin lẽ ra phải rõ ràng thành một mớ hỗn độn khó hiểu. Kể từ đó, tôi đã có thêm thực hành thực tế và tổng hợp hướng dẫn này với hy vọng có thể giúp những ai ở trong hoàn cảnh tương tự. Bạn đang ở đúng nơi nếu muốn tìm hiểu high cardinality là gì, nó gây ra những thách thức nào và cách xử lý chúng theo những phương pháp thực tế, hiệu quả!
Cardinality là gì, và High Cardinality là gì?
Các khái niệm cardinality và high cardinality có thể nghe hơi trừu tượng, nên hãy cùng bóc tách chúng.
Định nghĩa và ví dụ
Cardinality đề cập đến số lượng giá trị duy nhất trong một cột dữ liệu. Một cột có high cardinality chứa số lượng rất lớn các giá trị duy nhất, trong khi các cột có low cardinality chứa ít giá trị khác nhau hơn.
High cardinality đặc biệt phổ biến trong các tập dữ liệu liên quan đến định danh duy nhất, như:
- Dấu thời gian (timestamp): Gần như mỗi giá trị đều là duy nhất khi dữ liệu được ghi ở mức mili giây hoặc nano giây.
- ID khách hàng: Mỗi khách hàng có một định danh riêng để theo dõi hoạt động.
- ID giao dịch: Các tập dữ liệu tài chính thường bao gồm mã duy nhất cho mỗi giao dịch.
Những giá trị duy nhất này quan trọng để theo dõi, tổng hợp hoặc cá nhân hóa dữ liệu. Tuy nhiên, số lượng khổng lồ của chúng có thể đặt ra thách thức lớn về lưu trữ, hiệu năng và trực quan hóa, mà chúng ta sẽ xem ngay sau đây.
Các trường hợp đời thực phổ biến
High cardinality có thể xuất hiện ở mọi lĩnh vực và ngành nghề. Tôi đã phác thảo một vài ví dụ dưới đây để giúp bạn hiểu high cardinality theo cách thực tiễn hơn.
Thương mại điện tử và dữ liệu khách hàng
Các nền tảng thương mại điện tử tạo ra lượng dữ liệu high cardinality khổng lồ mỗi ngày:
- ID khách hàng: Mỗi người dùng được gán một định danh duy nhất để theo dõi hành vi, mua sắm và sở thích.
- ID phiên: Mỗi phiên duyệt web được ghi lại duy nhất, dẫn đến số lượng giá trị khác nhau rất lớn trong các tập dữ liệu theo dõi phiên.
- SKU sản phẩm: Mã quản lý tồn kho là duy nhất cho từng biến thể sản phẩm, tạo ra một cột high cardinality trong dữ liệu tồn kho và bán hàng.
Các tập dữ liệu này rất cần thiết để hiểu hành vi người dùng, theo dõi tồn kho và tối ưu hóa chiến lược bán hàng, nhưng số lượng mục nhập duy nhất quá lớn thường khiến phân tích trở nên phức tạp.
Y tế và hồ sơ bệnh nhân
Trong y tế, nhu cầu theo dõi và định danh chính xác tự nhiên dẫn đến dữ liệu high cardinality. Chẳng hạn, có thể thấy:
- ID bệnh nhân: Mỗi bệnh nhân có một định danh duy nhất để đảm bảo lưu trữ hồ sơ chính xác và an toàn.
- Dấu thời gian cuộc hẹn: Có thể tạo dấu thời gian duy nhất cho mỗi tương tác của bệnh nhân, từ khám bác sĩ đến xét nghiệm.
- Số hồ sơ bồi thường bảo hiểm: Mỗi yêu cầu bồi thường do nhà cung cấp bảo hiểm xử lý đều được gán một mã riêng phục vụ lưu trữ và kiểm toán.
Dữ liệu này cần thiết để duy trì lịch sử bệnh nhân và đảm bảo tuân thủ các quy định về quyền riêng tư.
Cảm biến IoT và dữ liệu dòng chảy
Sự bùng nổ của thiết bị IoT đã tạo ra làn sóng các tập dữ liệu high cardinality:
- ID cảm biến: Mỗi thiết bị IoT có một định danh duy nhất để theo dõi hoạt động và vị trí.
- Dữ liệu dấu thời gian: Dòng dữ liệu liên tục thường ghi sự kiện ở khoảng thời gian mili giây hoặc nano giây, dẫn tới giá trị gần như hoàn toàn duy nhất.
- ID sự kiện: Mỗi sự kiện ghi nhận trong hệ thống, từ đo nhiệt độ đến phát hiện chuyển động, đều được gán một định danh riêng.
Trong IoT, high cardinality phát sinh do nhu cầu xử lý dữ liệu thời gian thực, chi tiết cao từ vô số thiết bị. Điều này rất quan trọng cho phân tích và giám sát nhưng lại khó lưu trữ và truy vấn hiệu quả – sẽ bàn thêm phía sau!
Những thách thức của High Cardinality
High cardinality đặt ra nhiều thách thức trong xử lý dữ liệu, kỹ thuật, phân tích và học máy. Các tập dữ liệu có high cardinality cung cấp nhiều thông tin hữu ích, nhưng thường trở thành nút thắt cổ chai, cản trở hiệu năng, khả năng diễn giải và khả năng mở rộng.
Vấn đề lưu trữ dữ liệu và hiệu năng
Một trong những thách thức lớn nhất của high cardinality là tác động của nó lên lưu trữ dữ liệu và hiệu năng hệ thống.
- Chi phí lưu trữ: Các cột high cardinality, như định danh duy nhất hoặc dấu thời gian, làm tăng kích thước tập dữ liệu. Chẳng hạn, ghi log hàng triệu tương tác người dùng trên nền tảng thương mại điện tử tạo ra chi phí lưu trữ khổng lồ do tính duy nhất của ID phiên hoặc dấu thời gian giao dịch.
- Giảm hiệu suất truy vấn: Khi truy vấn các cột high cardinality, cơ sở dữ liệu gặp khó với độ phức tạp tăng lên của việc lập chỉ mục và quét. Các truy vấn lọc hoặc join trên cột high cardinality thường mất nhiều thời gian hơn, vì CSDL phải sàng lọc qua số lượng giá trị khác nhau khổng lồ.
- Thách thức về chỉ mục: Chỉ mục, vốn thiết yếu để tăng tốc truy vấn, trở nên cồng kềnh và kém hiệu quả với các cột high cardinality. Điều này có thể dẫn đến tra cứu chậm và suy giảm hiệu năng.
Hãy lấy ví dụ một cơ sở dữ liệu lưu trữ dữ liệu cảm biến IoT với ID cảm biến duy nhất và dấu thời gian chính xác. Các truy vấn lọc theo cảm biến cụ thể và khoảng thời gian có thể buộc CSDL xử lý hàng triệu mục nhập duy nhất, dẫn đến thời gian phản hồi siêu chậm và hoạt động ngốn tài nguyên.
Khó khăn trong trực quan hóa dữ liệu
Thách thức ở đây là trình bày số lượng lớn giá trị khác nhau theo cách vừa dễ hiểu vừa có ý nghĩa. Nếu không cân nhắc kỹ, dữ liệu high cardinality có thể che giấu thay vì phơi bày thông tin.
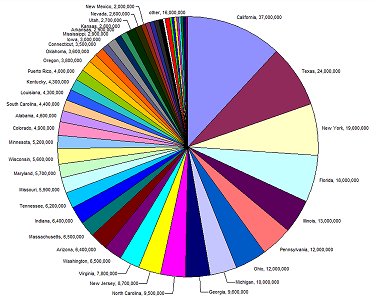
Một ví dụ điển hình là biểu đồ tròn dưới đây. Chú giải và giá trị không thể đọc được vì có quá nhiều mục (tiểu bang) khác nhau so với loại biểu đồ được dùng. Đôi khi thay đổi loại đồ thị sẽ giúp, nhưng không phải lúc nào cũng vậy.
Nguồn: Cơ quan Môi trường Châu Âu
Hãy tưởng tượng một biểu đồ cột thể hiện hoạt động khách hàng của nền tảng thương mại điện tử theo ID phiên. Với hàng nghìn hoặc hàng triệu ID duy nhất, biểu đồ sẽ trở thành một mớ cột không thể đọc, và thay đổi loại biểu đồ để vẽ dữ liệu này nhiều khả năng cũng không tạo khác biệt.
Vậy tại sao chúng ta không đơn giản là tổng hợp dữ liệu để rút ra mẫu và mối quan hệ từ biểu đồ? Có thể, nhưng phải làm cẩn thận. Tổng hợp dữ liệu high cardinality có thể khiến ta mất đi mức chi tiết cần thiết để tìm ra insight. Ví dụ, nhóm dữ liệu IoT theo vị trí có thể che mờ những biến thiên tinh tế nhưng quan trọng ở cấp độ từng cảm biến. Các kỹ thuật khắc phục vấn đề này có thể khá tinh vi. Tôi khuyến nghị khóa Mô hình dữ liệu trung cấp trong Power BI của chúng tôi để thực hành các mối quan hệ một-một và một-nhiều.
Liên quan đến học máy
High cardinality có thể gây ra thách thức đáng kể trong học máy, đặc biệt ở khâu xây dựng đặc trưng, độ phức tạp mô hình và khả năng diễn giải. Các mô hình học máy phát huy với đầu vào có cấu trúc và giàu ý nghĩa, nhưng các đặc trưng high cardinality thường phá vỡ cân bằng này, dẫn đến những phức tạp sau:
- Tăng độ thưa (sparsity): Các đặc trưng highardinality thường tạo ra tập dữ liệu thưa. Ví dụ, one-hot encoding một đặc trưng phân loại high cardinality như mã ZIP sẽ tạo ma trận với số chiều khổng lồ, trong đó đa phần là rỗng. Độ thưa này khiến các mô hình, đặc biệt là mô hình dựa trên khoảng cách như k-láng giềng gần nhất hoặc các thuật toán phân cụm, khó tìm ra mối quan hệ có ý nghĩa trong dữ liệu.
- Nguy cơ quá khớp (overfitting): Các đặc trưng high-cardinality có thể dẫn đến quá khớp ở những mô hình chia nhỏ dữ liệu thành các danh mục chi tiết như cây quyết định hoặc rừng ngẫu nhiên. Khi mỗi danh mục chỉ có vài mẫu, mô hình có thể học nhiễu thay vì mẫu thực, dẫn tới khả năng tổng quát kém với dữ liệu chưa thấy.
Chẳng hạn, trong thương mại điện tử, một mô hình dự đoán rời bỏ khách hàng có thể bao gồm đặc trưng high cardinality như "user ID" hoặc "product ID". Nếu không xử lý đúng cách, mô hình có thể quá khớp với khách hàng hoặc sản phẩm cụ thể trong dữ liệu huấn luyện, khiến nó kém hiệu quả khi dự đoán rời bỏ cho người dùng mới, vì học các mẫu chỉ đặc trưng cho tập huấn luyện thay vì xu hướng có thể tổng quát hóa.
Chiến lược quản lý High Cardinality
Quản lý hiệu quả high cardinality đòi hỏi kết hợp các chiến lược theo lĩnh vực và những kỹ thuật tối ưu hóa dữ liệu phổ quát. Những cách tiếp cận này không chỉ cải thiện hiệu năng hệ thống mà còn giúp dữ liệu dễ diễn giải và dễ hành động hơn.
Tận dụng công nghệ và công cụ
Rất may, các thách thức do tập dữ liệu high cardinality gây ra đủ phổ biến để nhiều kỹ thuật và công cụ đã được tạo ra và tinh chỉnh chuyên biệt nhằm xử lý chúng.
Tối ưu hóa cơ sở dữ liệu
Quản lý high cardinality trong cơ sở dữ liệu thường bắt đầu từ tối ưu cách lưu trữ và truy vấn dữ liệu, vượt ra ngoài việc đơn giản là loại bỏ trùng lặp. Những kỹ thuật phổ biến nhất gồm:
- Chia nhóm (bucketing/binning): Gom dữ liệu high cardinality vào các nhóm rộng hơn để giảm số lượng giá trị duy nhất. Ví dụ, nhóm mã zip theo vùng thay vì lưu từng mã riêng lẻ.
- Phân vùng (partitioning): Cấu trúc bảng theo phân vùng dựa trên các trường hay được truy vấn. Chẳng hạn, phân vùng dữ liệu khách hàng theo quốc gia có thể cải thiện hiệu năng truy vấn trong các hệ thống phân bố theo địa lý.
- Lập chỉ mục: Sử dụng các loại chỉ mục được thiết kế cho trường high cardinality, như bitmap hoặc chỉ mục tổng hợp (composite), có thể tăng tốc truy vấn đồng thời cân bằng hiệu quả lưu trữ.
Phần mềm chuyên dụng
Nếu bạn đang xử lý high cardinality cực cao, có những công cụ và nền tảng chuyên dụng có thể giúp bạn:
- Cơ sở dữ liệu dạng cột: Các CSDL như Apache Parquet hoặc Amazon Redshift được thiết kế cho truy vấn phân tích và có thể lưu trữ, xử lý hiệu quả các cột high cardinality.
- Cơ sở dữ liệu NoSQL: Trong một số trường hợp, CSDL NoSQL như MongoDB hoặc Elasticsearch có thể xử lý tốt hơn tính biến đổi và kích thước của tập dữ liệu high cardinality, đặc biệt khi kết hợp với thiết kế không lược đồ.
- Cơ sở dữ liệu chuỗi thời gian: Với các tập dữ liệu chi phối bởi dấu thời gian và sự kiện, như dữ liệu cảm biến IoT hoặc giao dịch thị trường chứng khoán, các CSDL chuỗi thời gian như InfluxDB hoặc TimescaleDB cực kỳ hữu ích. Chúng được tối ưu riêng để lưu trữ hiệu quả các chiều high cardinality và sử dụng kỹ thuật nén tiên tiến nhằm giảm chi phí lưu trữ trong khi vẫn có hiệu năng cao. Tôi đã tham gia vài dự án liên quan đến lượng dữ liệu IoT khổng lồ, và CSDL chuỗi thời gian thực sự tạo khác biệt khi rút ra xu hướng và dự báo. Tôi đã viết hướng dẫn về cơ sở dữ liệu chuỗi thời gian nếu bạn muốn tìm hiểu thêm!
- Công cụ lập hồ sơ dữ liệu: Các công cụ như Talend, OpenRefine hoặc thậm chí script Python tùy biến có thể nhanh chóng xác định các trường high cardinality và hỗ trợ xác định chiến lược tiền xử lý hay lưu trữ phù hợp.
Kỹ thuật tiền xử lý dữ liệu
Tiền xử lý trong khoa học dữ liệu và học máy đề cập đến các bước làm sạch, biến đổi và tổ chức dữ liệu thô thành định dạng phù hợp cho phân tích hoặc mô hình hóa.
Đây là một chủ đề khá nặng, và nếu bạn ít hoặc chưa có kiến thức về kỹ thuật dữ liệu hay khoa học dữ liệu, phần này có thể hơi khó theo. Dù vậy, tôi đã kèm các liên kết và ví dụ liên quan để giúp bạn theo kịp!
Tiền xử lý dữ liệu là bước thiết yếu để quản lý high cardinality, vì nó giảm độ phức tạp, nâng cao hiệu năng và đảm bảo chất lượng dữ liệu đủ tốt cho các tác vụ phân tích hoặc học máy. Bằng cách biến đổi dữ liệu thô thành dạng dễ xử lý hơn, chúng ta có thể giải quyết các thách thức như độ thưa, kém hiệu quả lưu trữ và nút thắt tính toán.
Giảm chiều dữ liệu
Các kỹ thuật giảm chiều dữ liệu đặc biệt hữu ích khi high cardinality dẫn đến tập dữ liệu có nhiều đặc trưng hoặc ma trận thưa. Những phương pháp này nén dữ liệu vào ít chiều hơn nhưng vẫn giữ lại thông tin cốt lõi.
Phân tích thành phần chính (PCA)
Hãy tưởng tượng bạn có tập dữ liệu hành vi khách hàng thương mại điện tử, với rất nhiều đặc trưng như số lần khách xem sản phẩm, tương tác với các danh mục sản phẩm khác nhau, thời gian ở trên website, v.v. Mỗi đặc trưng có thể có cardinality cao, đặc biệt nếu bạn theo dõi số lượng lớn sản phẩm. PCA có thể kết hợp các đặc trưng này thành ít thành phần hơn nhưng vẫn nắm bắt các mẫu quan trọng nhất trong dữ liệu, như mức độ tương tác tổng thể của khách hàng hoặc mối quan tâm đến các loại sản phẩm cụ thể. Hãy nghĩ về nó như Marie Kondo của dữ liệu: giữ lại những đặc trưng “gây vui” và nhẹ nhàng loại bỏ phần còn lại!
t-SNE và UMAP
t-SNE và UMAP là các kỹ thuật đặc biệt hữu ích để trực quan hóa dữ liệu đa chiều bằng cách ánh xạ xuống hai hoặc ba chiều trong khi vẫn bảo toàn cấu trúc. Chẳng hạn, trong các tập dữ liệu hồ sơ y tế, UMAP có thể giúp nhóm các bệnh nhân có tình trạng bệnh lý hoặc phác đồ điều trị tương tự lại với nhau. Điều này giúp phát hiện xu hướng như các bệnh thường đi kèm hoặc kết quả điều trị.
Lựa chọn đặc trưng
Nếu bạn đang xây dựng mô hình học máy dự đoán hiệu suất bán hàng cho một nền tảng thương mại điện tử, và tập dữ liệu bao gồm các đặc trưng như số lần khách nhấp vào quảng cáo, số sản phẩm đã xem và số ngày kể từ lần mua gần nhất, bạn sẽ thấy nhiều đặc trưng trong số này có thể tương quan với nhau, tạo nên high cardinality và dư thừa.
Bằng cách sử dụng các kỹ thuật lựa chọn đặc trưng như thông tin tương hỗ (mutual information) hoặc loại trừ đặc trưng đệ quy (RFE), bạn có thể xác định đặc trưng nào có sức dự đoán lớn nhất (ví dụ, "thời gian kể từ lần mua gần nhất" có thể quan trọng hơn "số lần nhấp quảng cáo") và loại trừ những đặc trưng không liên quan, từ đó cải thiện hiệu năng mô hình.
Nếu bạn muốn tìm hiểu sâu hơn về chủ đề này, hãy thử khóa học Tiền xử lý cho Học máy. Bạn sẽ dùng Python để làm sạch và chuẩn bị dữ liệu trước khi đưa vào mô hình.
Phương pháp mã hóa (encoding)
Mã hóa là bước tiền xử lý quan trọng để xử lý dữ liệu phân loại, đặc biệt với các đặc trưng high cardinality. Lựa chọn phương pháp mã hóa phụ thuộc vào bài toán cụ thể và mức độ cardinality trong tập dữ liệu.
- One-Hot encoding: One-hot encoding tạo một cột nhị phân cho mỗi danh mục duy nhất trong tập dữ liệu. Mặc dù đơn giản và hiệu quả với dữ liệu low cardinality, nó có thể dẫn đến ma trận cực kỳ thưa khi áp dụng cho đặc trưng high cardinality. Ví dụ, mã hóa 1.000 mã zip sẽ tạo 1.000 cột nhị phân, có thể quá tải bộ nhớ và tài nguyên tính toán. Tin tôi đi, tôi đã học điều đó theo cách khó khăn nhất…
- Target encoding (mean encoding): Trong phương pháp này, các giá trị phân loại được thay bằng giá trị trung bình của biến mục tiêu cho từng danh mục. Ví dụ, nếu bạn đang dự đoán rời bỏ khách hàng, target encoding có thể thay mỗi mã zip bằng tỷ lệ rời bỏ trung bình của khách ở khu vực đó. Cách này giảm số chiều nhưng có thể tạo thiên lệch và cần xác thực cẩn thận để tránh rò rỉ dữ liệu.
- Mã hóa theo tần suất (frequency encoding): Gán tần suất xuất hiện của danh mục làm giá trị của nó, giảm số lượng giá trị khác nhau. Ví dụ, trong tập dữ liệu thương mại điện tử, ID sản phẩm có thể được thay bằng tần suất mua. Kỹ thuật này tiết kiệm tài nguyên và thường tương quan với tầm quan trọng của đặc trưng.
- Mã hóa hashing: Hashing ánh xạ các danh mục sang số nguyên bằng hàm băm, trong đó một số danh mục sẽ được nhóm chung. Phương pháp này tiết kiệm bộ nhớ và hiệu quả với dữ liệu dòng hoặc cardinality cực cao, nhưng có nguy cơ va chạm băm. Từng thắc mắc vì sao website mua sắm của bạn gợi ý sữa bột khi bạn tìm dầu xe không? Đó chính là va chạm băm đấy.
- Lớp embedding: Đối với các mô hình học máy như mạng nơ-ron, các lớp embedding có thể biến đổi đặc trưng phân loại high cardinality thành các biểu diễn dày, ít chiều. Cách tiếp cận này được dùng rộng rãi trong hệ thống gợi ý, chẳng hạn mã hóa hàng triệu ID sản phẩm hoặc ID người dùng trên nền tảng thương mại điện tử.
Kết luận
Các tập dữ liệu high cardinality đôi khi có thể khiến bạn choáng ngợp, và việc khai thác insight giá trị từ chúng chắc chắn đầy thách thức. Lần tới khi bạn gặp một tập dữ liệu high cardinality, hãy nhớ rằng không phải lỗi của dữ liệu – nó chỉ đang chứa đầy tiềm năng chờ được khai mở. Dù là qua giảm chiều dữ liệu, kỹ thuật mã hóa thông minh hay các công cụ như cơ sở dữ liệu chuỗi thời gian, bạn có thể quản lý dữ liệu hiệu quả và biến chúng thành tài sản cực kỳ mạnh mẽ.
Và giờ khi bạn đã biết cách làm việc với dữ liệu high cardinality về mặt lý thuyết, đã đến lúc đưa vào thực hành:
- Thực hành giảm chiều và các kỹ thuật mã hóa – bắt đầu từ nhỏ và tăng dần độ phức tạp. Khóa Giảm chiều dữ liệu bằng Python của chúng tôi là lựa chọn tuyệt vời.
- Thử nghiệm một số công cụ được nhắc đến ở đây (vâng, cơ sở dữ liệu chuỗi thời gian “ngầu” đúng như tên gọi!).
Và quan trọng nhất, hãy đón nhận thử thách. High cardinality có thể rắc rối, nhưng cũng là cơ hội để học rất nhiều về kỹ thuật dữ liệu và phân tích!


Tôi lần đầu gặp khái niệm cardinality trong lớp Cơ học lượng tử khi học ngành Vật lý. Trong lớp đó, cardinality đề cập đến kích thước của một tập hợp, hữu hạn hoặc vô hạn, và gắn liền với những khái niệm trừu tượng như đếm được và vô cực. Khi chuyển sang kỹ thuật phần mềm, tôi nhận ra rằng với kỹ sư dữ liệu hay nhà khoa học dữ liệu, cardinality mang ý nghĩa thực tiễn hơn nhiều: mức độ khác biệt của các giá trị trong một tập dữ liệu.
Trong một trong những dự án đầu tiên phân tích dữ liệu thực tế, tôi đã hiểu high cardinality có thể thách thức đến mức nào. Nó làm các truy vấn cơ sở dữ liệu của tôi chậm như rùa và biến những thông tin lẽ ra phải rõ ràng thành một mớ hỗn độn khó hiểu. Kể từ đó, tôi đã có thêm thực hành thực tế và tổng hợp hướng dẫn này với hy vọng có thể giúp những ai ở trong hoàn cảnh tương tự. Bạn đang ở đúng nơi nếu muốn tìm hiểu high cardinality là gì, nó gây ra những thách thức nào và cách xử lý chúng theo những phương pháp thực tế, hiệu quả!
Cardinality là gì, và High Cardinality là gì?
Các khái niệm cardinality và high cardinality có thể nghe hơi trừu tượng, nên hãy cùng bóc tách chúng.
Định nghĩa và ví dụ
Cardinality đề cập đến số lượng giá trị duy nhất trong một cột dữ liệu. Một cột có high cardinality chứa số lượng rất lớn các giá trị duy nhất, trong khi các cột có low cardinality chứa ít giá trị khác nhau hơn.
High cardinality đặc biệt phổ biến trong các tập dữ liệu liên quan đến định danh duy nhất, như:
Những giá trị duy nhất này quan trọng để theo dõi, tổng hợp hoặc cá nhân hóa dữ liệu. Tuy nhiên, số lượng khổng lồ của chúng có thể đặt ra thách thức lớn về lưu trữ, hiệu năng và trực quan hóa, mà chúng ta sẽ xem ngay sau đây.
Các trường hợp đời thực phổ biến
High cardinality có thể xuất hiện ở mọi lĩnh vực và ngành nghề. Tôi đã phác thảo một vài ví dụ dưới đây để giúp bạn hiểu high cardinality theo cách thực tiễn hơn.
Thương mại điện tử và dữ liệu khách hàng
Các nền tảng thương mại điện tử tạo ra lượng dữ liệu high cardinality khổng lồ mỗi ngày:
Các tập dữ liệu này rất cần thiết để hiểu hành vi người dùng, theo dõi tồn kho và tối ưu hóa chiến lược bán hàng, nhưng số lượng mục nhập duy nhất quá lớn thường khiến phân tích trở nên phức tạp.
Y tế và hồ sơ bệnh nhân
Trong y tế, nhu cầu theo dõi và định danh chính xác tự nhiên dẫn đến dữ liệu high cardinality. Chẳng hạn, có thể thấy:
Dữ liệu này cần thiết để duy trì lịch sử bệnh nhân và đảm bảo tuân thủ các quy định về quyền riêng tư.
Cảm biến IoT và dữ liệu dòng chảy
Sự bùng nổ của thiết bị IoT đã tạo ra làn sóng các tập dữ liệu high cardinality:
Trong IoT, high cardinality phát sinh do nhu cầu xử lý dữ liệu thời gian thực, chi tiết cao từ vô số thiết bị. Điều này rất quan trọng cho phân tích và giám sát nhưng lại khó lưu trữ và truy vấn hiệu quả – sẽ bàn thêm phía sau!
Những thách thức của High Cardinality
High cardinality đặt ra nhiều thách thức trong xử lý dữ liệu, kỹ thuật, phân tích và học máy. Các tập dữ liệu có high cardinality cung cấp nhiều thông tin hữu ích, nhưng thường trở thành nút thắt cổ chai, cản trở hiệu năng, khả năng diễn giải và khả năng mở rộng.
Vấn đề lưu trữ dữ liệu và hiệu năng
Một trong những thách thức lớn nhất của high cardinality là tác động của nó lên lưu trữ dữ liệu và hiệu năng hệ thống.
Hãy lấy ví dụ một cơ sở dữ liệu lưu trữ dữ liệu cảm biến IoT với ID cảm biến duy nhất và dấu thời gian chính xác. Các truy vấn lọc theo cảm biến cụ thể và khoảng thời gian có thể buộc CSDL xử lý hàng triệu mục nhập duy nhất, dẫn đến thời gian phản hồi siêu chậm và hoạt động ngốn tài nguyên.
Khó khăn trong trực quan hóa dữ liệu
Thách thức ở đây là trình bày số lượng lớn giá trị khác nhau theo cách vừa dễ hiểu vừa có ý nghĩa. Nếu không cân nhắc kỹ, dữ liệu high cardinality có thể che giấu thay vì phơi bày thông tin.
Một ví dụ điển hình là biểu đồ tròn dưới đây. Chú giải và giá trị không thể đọc được vì có quá nhiều mục (tiểu bang) khác nhau so với loại biểu đồ được dùng. Đôi khi thay đổi loại đồ thị sẽ giúp, nhưng không phải lúc nào cũng vậy.
Nguồn: Cơ quan Môi trường Châu Âu
Hãy tưởng tượng một biểu đồ cột thể hiện hoạt động khách hàng của nền tảng thương mại điện tử theo ID phiên. Với hàng nghìn hoặc hàng triệu ID duy nhất, biểu đồ sẽ trở thành một mớ cột không thể đọc, và thay đổi loại biểu đồ để vẽ dữ liệu này nhiều khả năng cũng không tạo khác biệt.
Vậy tại sao chúng ta không đơn giản là tổng hợp dữ liệu để rút ra mẫu và mối quan hệ từ biểu đồ? Có thể, nhưng phải làm cẩn thận. Tổng hợp dữ liệu high cardinality có thể khiến ta mất đi mức chi tiết cần thiết để tìm ra insight. Ví dụ, nhóm dữ liệu IoT theo vị trí có thể che mờ những biến thiên tinh tế nhưng quan trọng ở cấp độ từng cảm biến. Các kỹ thuật khắc phục vấn đề này có thể khá tinh vi. Tôi khuyến nghị khóa Mô hình dữ liệu trung cấp trong Power BI của chúng tôi để thực hành các mối quan hệ một-một và một-nhiều.
Liên quan đến học máy
High cardinality có thể gây ra thách thức đáng kể trong học máy, đặc biệt ở khâu xây dựng đặc trưng, độ phức tạp mô hình và khả năng diễn giải. Các mô hình học máy phát huy với đầu vào có cấu trúc và giàu ý nghĩa, nhưng các đặc trưng high cardinality thường phá vỡ cân bằng này, dẫn đến những phức tạp sau:
Chẳng hạn, trong thương mại điện tử, một mô hình dự đoán rời bỏ khách hàng có thể bao gồm đặc trưng high cardinality như "user ID" hoặc "product ID". Nếu không xử lý đúng cách, mô hình có thể quá khớp với khách hàng hoặc sản phẩm cụ thể trong dữ liệu huấn luyện, khiến nó kém hiệu quả khi dự đoán rời bỏ cho người dùng mới, vì học các mẫu chỉ đặc trưng cho tập huấn luyện thay vì xu hướng có thể tổng quát hóa.
Chiến lược quản lý High Cardinality
Quản lý hiệu quả high cardinality đòi hỏi kết hợp các chiến lược theo lĩnh vực và những kỹ thuật tối ưu hóa dữ liệu phổ quát. Những cách tiếp cận này không chỉ cải thiện hiệu năng hệ thống mà còn giúp dữ liệu dễ diễn giải và dễ hành động hơn.
Tận dụng công nghệ và công cụ
Rất may, các thách thức do tập dữ liệu high cardinality gây ra đủ phổ biến để nhiều kỹ thuật và công cụ đã được tạo ra và tinh chỉnh chuyên biệt nhằm xử lý chúng.
Tối ưu hóa cơ sở dữ liệu
Quản lý high cardinality trong cơ sở dữ liệu thường bắt đầu từ tối ưu cách lưu trữ và truy vấn dữ liệu, vượt ra ngoài việc đơn giản là loại bỏ trùng lặp. Những kỹ thuật phổ biến nhất gồm:
Phần mềm chuyên dụng
Nếu bạn đang xử lý high cardinality cực cao, có những công cụ và nền tảng chuyên dụng có thể giúp bạn:
Kỹ thuật tiền xử lý dữ liệu
Tiền xử lý trong khoa học dữ liệu và học máy đề cập đến các bước làm sạch, biến đổi và tổ chức dữ liệu thô thành định dạng phù hợp cho phân tích hoặc mô hình hóa.
Đây là một chủ đề khá nặng, và nếu bạn ít hoặc chưa có kiến thức về kỹ thuật dữ liệu hay khoa học dữ liệu, phần này có thể hơi khó theo. Dù vậy, tôi đã kèm các liên kết và ví dụ liên quan để giúp bạn theo kịp!
Tiền xử lý dữ liệu là bước thiết yếu để quản lý high cardinality, vì nó giảm độ phức tạp, nâng cao hiệu năng và đảm bảo chất lượng dữ liệu đủ tốt cho các tác vụ phân tích hoặc học máy. Bằng cách biến đổi dữ liệu thô thành dạng dễ xử lý hơn, chúng ta có thể giải quyết các thách thức như độ thưa, kém hiệu quả lưu trữ và nút thắt tính toán.
Giảm chiều dữ liệu
Các kỹ thuật giảm chiều dữ liệu đặc biệt hữu ích khi high cardinality dẫn đến tập dữ liệu có nhiều đặc trưng hoặc ma trận thưa. Những phương pháp này nén dữ liệu vào ít chiều hơn nhưng vẫn giữ lại thông tin cốt lõi.
Phân tích thành phần chính (PCA)
Hãy tưởng tượng bạn có tập dữ liệu hành vi khách hàng thương mại điện tử, với rất nhiều đặc trưng như số lần khách xem sản phẩm, tương tác với các danh mục sản phẩm khác nhau, thời gian ở trên website, v.v. Mỗi đặc trưng có thể có cardinality cao, đặc biệt nếu bạn theo dõi số lượng lớn sản phẩm. PCA có thể kết hợp các đặc trưng này thành ít thành phần hơn nhưng vẫn nắm bắt các mẫu quan trọng nhất trong dữ liệu, như mức độ tương tác tổng thể của khách hàng hoặc mối quan tâm đến các loại sản phẩm cụ thể. Hãy nghĩ về nó như Marie Kondo của dữ liệu: giữ lại những đặc trưng “gây vui” và nhẹ nhàng loại bỏ phần còn lại!
t-SNE và UMAP
t-SNE và UMAP là các kỹ thuật đặc biệt hữu ích để trực quan hóa dữ liệu đa chiều bằng cách ánh xạ xuống hai hoặc ba chiều trong khi vẫn bảo toàn cấu trúc. Chẳng hạn, trong các tập dữ liệu hồ sơ y tế, UMAP có thể giúp nhóm các bệnh nhân có tình trạng bệnh lý hoặc phác đồ điều trị tương tự lại với nhau. Điều này giúp phát hiện xu hướng như các bệnh thường đi kèm hoặc kết quả điều trị.
Lựa chọn đặc trưng
Nếu bạn đang xây dựng mô hình học máy dự đoán hiệu suất bán hàng cho một nền tảng thương mại điện tử, và tập dữ liệu bao gồm các đặc trưng như số lần khách nhấp vào quảng cáo, số sản phẩm đã xem và số ngày kể từ lần mua gần nhất, bạn sẽ thấy nhiều đặc trưng trong số này có thể tương quan với nhau, tạo nên high cardinality và dư thừa.
Bằng cách sử dụng các kỹ thuật lựa chọn đặc trưng như thông tin tương hỗ (mutual information) hoặc loại trừ đặc trưng đệ quy (RFE), bạn có thể xác định đặc trưng nào có sức dự đoán lớn nhất (ví dụ, "thời gian kể từ lần mua gần nhất" có thể quan trọng hơn "số lần nhấp quảng cáo") và loại trừ những đặc trưng không liên quan, từ đó cải thiện hiệu năng mô hình.
Nếu bạn muốn tìm hiểu sâu hơn về chủ đề này, hãy thử khóa học Tiền xử lý cho Học máy. Bạn sẽ dùng Python để làm sạch và chuẩn bị dữ liệu trước khi đưa vào mô hình.
Phương pháp mã hóa (encoding)
Mã hóa là bước tiền xử lý quan trọng để xử lý dữ liệu phân loại, đặc biệt với các đặc trưng high cardinality. Lựa chọn phương pháp mã hóa phụ thuộc vào bài toán cụ thể và mức độ cardinality trong tập dữ liệu.
Kết luận
Các tập dữ liệu high cardinality đôi khi có thể khiến bạn choáng ngợp, và việc khai thác insight giá trị từ chúng chắc chắn đầy thách thức. Lần tới khi bạn gặp một tập dữ liệu high cardinality, hãy nhớ rằng không phải lỗi của dữ liệu – nó chỉ đang chứa đầy tiềm năng chờ được khai mở. Dù là qua giảm chiều dữ liệu, kỹ thuật mã hóa thông minh hay các công cụ như cơ sở dữ liệu chuỗi thời gian, bạn có thể quản lý dữ liệu hiệu quả và biến chúng thành tài sản cực kỳ mạnh mẽ.
Và giờ khi bạn đã biết cách làm việc với dữ liệu high cardinality về mặt lý thuyết, đã đến lúc đưa vào thực hành:
Và quan trọng nhất, hãy đón nhận thử thách. High cardinality có thể rắc rối, nhưng cũng là cơ hội để học rất nhiều về kỹ thuật dữ liệu và phân tích!