Saya pertama kali mengenal konsep kardinalitas di kelas Mekanika Kuantum saat menempuh studi Fisika. Di kelas itu, kardinalitas mengacu pada ukuran himpunan, baik hingga maupun tak hingga, dan terkait dengan konsep abstrak seperti keterhitungan dan infinitas. Ketika beralih ke rekayasa perangkat lunak, saya menyadari bahwa bagi seorang data engineer atau ilmuwan data, kardinalitas memiliki makna yang jauh lebih praktis: tingkat keberagaman nilai dalam sebuah dataset.
Dalam salah satu proyek awal saya menganalisis data dunia nyata, saya belajar betapa menantangnya kardinalitas tinggi. Kueri basis data menjadi sangat lambat dan wawasan yang seharusnya jelas berubah menjadi kekacauan yang membingungkan. Sejak itu, saya mendapat cukup banyak praktik langsung dan menyusun panduan ini dengan harapan dapat membantu orang lain dalam situasi serupa. Anda berada di tempat yang tepat jika ingin mempelajari apa itu kardinalitas tinggi, tantangan apa yang ditimbulkannya, dan cara menanganinya secara praktis dan efektif!
Apa Itu Kardinalitas, dan Apa Itu Kardinalitas Tinggi?
Konsep kardinalitas dan kardinalitas tinggi bisa terdengar agak abstrak, jadi mari kita uraikan.
Definisi dan contoh
Kardinalitas mengacu pada jumlah nilai unik dalam sebuah kolom dataset. Kolom dengan kardinalitas tinggi berisi sangat banyak nilai unik, sedangkan kolom dengan kardinalitas rendah memiliki lebih sedikit entri unik.
Kardinalitas tinggi terutama umum pada dataset yang melibatkan pengenal unik, seperti:
- Timestamp: Hampir setiap nilai unik ketika data dicatat pada level milidetik atau nanodetik.
- ID Pelanggan: Setiap pelanggan memiliki pengenal berbeda untuk melacak aktivitas mereka.
- ID Transaksi: Dataset keuangan sering menyertakan kode unik untuk setiap transaksi.
Nilai-nilai unik ini penting untuk pelacakan, pengagregasian, atau personalisasi data. Namun, jumlahnya yang besar dapat menimbulkan tantangan signifikan dalam penyimpanan, kinerja, dan visualisasi, yang akan kita bahas sebentar lagi.
Kasus nyata yang umum
Kardinalitas tinggi dapat muncul di setiap domain dan industri. Saya menguraikan beberapa contoh di bawah ini untuk membantu Anda memahami apa yang dimaksud kardinalitas tinggi secara lebih praktis.
E-commerce dan data pelanggan
Platform e-commerce menghasilkan data berkardinalitas tinggi dalam jumlah besar setiap hari:
- ID Pelanggan: Setiap pengguna diberikan pengenal unik untuk melacak perilaku, pembelian, dan preferensi mereka.
- ID Sesi: Setiap sesi penelusuran dicatat secara unik, menghasilkan banyak nilai berbeda dalam dataset pelacakan sesi.
- SKU Produk: Stock Keeping Unit bersifat unik untuk setiap variasi produk, menciptakan kolom berkardinalitas tinggi dalam data inventaris dan penjualan.
Dataset ini penting untuk memahami perilaku pengguna, melacak inventaris, dan mengoptimalkan strategi penjualan, tetapi banyaknya entri unik sering kali membuat analisis menjadi kompleks.
Kesehatan dan rekam pasien
Dalam bidang kesehatan, kebutuhan akan pelacakan dan identifikasi yang presisi secara alami menghasilkan data berkardinalitas tinggi. Misalnya, kita dapat menemukan:
- ID Pasien: Setiap pasien memiliki pengenal unik untuk memastikan pencatatan yang akurat dan aman.
- Timestamp janji temu: Timestamp unik dapat dibuat untuk setiap interaksi pasien, dari kunjungan dokter hingga tes laboratorium.
- Nomor klaim asuransi: Setiap klaim yang diproses penyedia asuransi diberi kode berbeda untuk pencatatan dan keperluan audit.
Data ini diperlukan untuk menjaga riwayat pasien dan memastikan kepatuhan terhadap peraturan privasi.
Sensor IoT dan data streaming
Maraknya perangkat IoT menciptakan lonjakan dataset berkardinalitas tinggi:
- ID Sensor: Setiap perangkat IoT memiliki pengenal unik untuk melacak aktivitas dan lokasinya.
- Data timestamp: Aliran data berkelanjutan sering mencatat peristiwa pada interval milidetik atau nanodetik, menghasilkan nilai yang hampir seluruhnya unik.
- ID Peristiwa: Setiap peristiwa yang direkam dalam sistem, dari pembacaan suhu hingga deteksi gerakan, diberi pengenal unik.
Dalam IoT, kardinalitas tinggi muncul karena kebutuhan memproses data real-time yang sangat rinci dari banyak perangkat. Ini penting untuk analitik dan pemantauan namun menantang untuk disimpan dan dikueri secara efisien – akan kita bahas lagi nanti!
Tantangan Kardinalitas Tinggi
Kardinalitas tinggi menghadirkan sejumlah tantangan di ranah pemrosesan data, rekayasa, analisis, dan pembelajaran mesin. Dataset berkardinalitas tinggi menyajikan banyak informasi berguna, tetapi sering kali menjadi hambatan dan mengurangi kinerja, keterjelasan, serta skalabilitas.
Masalah penyimpanan data dan kinerja
Salah satu tantangan terbesar kardinalitas tinggi adalah dampaknya pada penyimpanan data dan kinerja sistem.
- Beban penyimpanan: Kolom berkardinalitas tinggi, seperti pengenal unik atau timestamp, menghasilkan dataset yang lebih besar. Misalnya, mencatat jutaan interaksi pengguna di platform e-commerce menciptakan beban penyimpanan besar karena keunikan ID sesi atau timestamp transaksi.
- Penurunan kinerja kueri: Saat mengkueri kolom berkardinalitas tinggi, basis data kesulitan dengan kompleksitas pengindeksan dan pemindaian yang meningkat. Kueri yang melibatkan pemfilteran atau join pada kolom berkardinalitas tinggi cenderung lebih lama, karena basis data harus menyaring jumlah nilai berbeda yang sangat besar.
- Tantangan pengindeksan: Indeks, yang penting untuk mempercepat kueri basis data, menjadi membengkak dan kurang efisien pada kolom berkardinalitas tinggi. Ini dapat menyebabkan pencarian lebih lambat dan penurunan kinerja.
Ambil contoh basis data yang menyimpan data sensor IoT dengan ID sensor unik dan timestamp presisi. Kueri yang memfilter berdasarkan sensor tertentu dan rentang waktu dapat mengharuskan basis data memproses jutaan entri unik, yang mengarah ke waktu respons sangat lambat dan operasi yang menguras sumber daya.
Kesulitan visualisasi data
Tantangannya adalah menyajikan banyak nilai berbeda dengan cara yang dapat dipahami dan bermakna. Tanpa pemikiran matang, data berkardinalitas tinggi justru dapat menyembunyikan wawasan alih-alih mengungkapkannya.
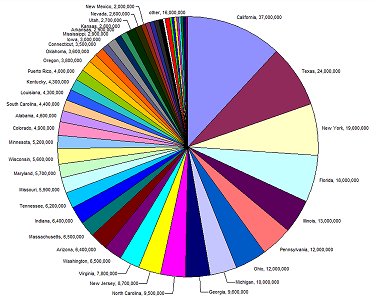
Contoh yang baik adalah diagram pai di bawah ini. Legenda dan nilainya tidak terbaca karena ada terlalu banyak entri unik (negara bagian) untuk jenis grafik yang digunakan. Terkadang, mengubah jenis grafik membantu, namun tidak selalu.
Sumber: European Environment Agency
Bayangkan diagram batang yang merepresentasikan aktivitas pelanggan sebuah platform e-niaga berdasarkan ID sesi. Dengan ribuan atau jutaan ID unik, grafik menjadi tumpukan batang yang tak terbaca, dan mengubah jenis grafik untuk memplot data ini kecil kemungkinan akan membantu.
Lalu, mengapa kita tidak cukup mengagregasikan data untuk menemukan pola dan hubungan dari grafik? Bisa, tapi harus dilakukan dengan hati-hati. Mengagregasikan data berkardinalitas tinggi dapat membuat kita kehilangan granularitas yang diperlukan untuk memperoleh wawasan. Misalnya, mengelompokkan data IoT berdasarkan lokasi bisa menyamarkan variasi halus namun krusial di level sensor individual. Teknik untuk mengatasinya bisa cukup rumit. Saya merekomendasikan kursus Intermediate Data Modeling in Power BI untuk mendapatkan pengalaman langsung dengan relasi one-to-one dan one-to-many.
Keterkaitan dengan machine learning
Kardinalitas tinggi dapat menghadirkan tantangan signifikan dalam machine learning, khususnya terkait rekayasa fitur, kompleksitas model, dan keterjelasan. Model machine learning bekerja baik dengan masukan yang terstruktur dan bermakna, tetapi fitur berkardinalitas tinggi sering mengganggu keseimbangan ini, sehingga menimbulkan komplikasi:
- Peningkatan sparsitas: Fitur berkardinalitas tinggi sering menghasilkan dataset yang jarang (sparse). Misalnya, one-hot encoding pada fitur kategorikal berkardinalitas tinggi seperti kode pos akan membuat matriks dengan jumlah dimensi sangat besar, yang sebagian besar kosong. Sparsitas ini menyulitkan model, terutama yang berbasis jarak seperti k-nearest neighbors atau algoritma klastering, untuk menemukan hubungan bermakna dalam data.
- Risiko overfitting: Fitur berkardinalitas tinggi dapat menyebabkan overfitting pada model yang membagi data menjadi kategori sangat rinci, seperti decision tree atau random forest. Ketika setiap kategori hanya diwakili oleh sedikit sampel, model dapat mempelajari noise alih-alih pola yang sesungguhnya, sehingga buruk dalam melakukan generalisasi pada data yang belum pernah dilihat.
Contohnya, dalam e-commerce, model machine learning yang memprediksi churn pelanggan mungkin menyertakan fitur berkardinalitas tinggi seperti "user ID" atau "product ID." Jika tidak dikelola dengan baik, model bisa overfit terhadap pelanggan atau produk tertentu dalam data pelatihan. Ini membuatnya kurang efektif saat diterapkan untuk memprediksi churn pengguna baru, karena ia mempelajari pola yang khas untuk dataset pelatihan alih-alih tren yang dapat digeneralisasi.
Strategi Mengelola Kardinalitas Tinggi
Mengelola kardinalitas tinggi secara efektif memerlukan perpaduan strategi spesifik domain dan teknik optimasi data umum. Pendekatan ini tidak hanya meningkatkan kinerja sistem, tetapi juga membuat data lebih mudah diinterpretasikan dan ditindaklanjuti.
Memanfaatkan teknologi dan alat
Untungnya, tantangan yang ditimbulkan dataset berkardinalitas tinggi cukup luas sehingga berbagai teknik dan alat telah diciptakan dan disempurnakan khusus untuk menanganinya.
Optimasi basis data
Mengelola kardinalitas tinggi di basis data sering dimulai dengan mengoptimalkan cara data disimpan dan dikueri, bukan sekadar menghapus duplikasi. Teknik yang paling umum digunakan adalah:
- Bucketing (atau binning): Mengelompokkan data berkardinalitas tinggi ke dalam kategori yang lebih luas untuk mengurangi jumlah nilai unik. Misalnya, mengelompokkan kode pos berdasarkan wilayah alih-alih menyimpan masing-masing secara individual.
- Partisi: Menyusun tabel berdasarkan partisi pada kolom yang sering dikueri. Misalnya, mempartisi data pelanggan berdasarkan negara dapat meningkatkan kinerja kueri pada sistem yang tersebar secara geografis.
- Pengindeksan: Menggunakan indeks yang dirancang khusus untuk kolom berkardinalitas tinggi, seperti bitmap atau indeks komposit, dapat meningkatkan kecepatan kueri dengan tetap menyeimbangkan efisiensi penyimpanan.
Perangkat lunak khusus
Jika Anda berurusan dengan kardinalitas yang sangat tinggi, ada alat dan platform khusus yang dapat membantu Anda:
- Basis data kolumnar: Basis data seperti Apache Parquet atau Amazon Redshift dirancang untuk kueri analitis dan dapat menyimpan serta memproses kolom berkardinalitas tinggi secara efisien.
- Basis data NoSQL: Dalam beberapa kasus, basis data NoSQL seperti MongoDB atau Elasticsearch lebih mampu menangani variasi dan ukuran dataset berkardinalitas tinggi, terutama bila dipasangkan dengan desain tanpa skema.
- Basis data deret waktu: Untuk dataset yang didominasi timestamp dan peristiwa, seperti data sensor IoT atau transaksi pasar saham, basis data deret waktu seperti InfluxDB atau TimescaleDB sangat membantu. Basis data ini dioptimalkan khusus untuk menyimpan dimensi berkardinalitas tinggi secara efisien dan menggunakan teknik kompresi canggih untuk meminimalkan biaya penyimpanan sambil tetap sangat andal. Saya pernah mengerjakan beberapa proyek yang melibatkan sejumlah besar data IoT, dan basis data deret waktu membuat perbedaan besar dalam menemukan tren dan prediksi. Saya menulis panduan tentang basis data deret waktu jika Anda tertarik mempelajari lebih lanjut!
- Alat profiling data: Alat seperti Talend, OpenRefine, atau bahkan skrip Python kustom dapat dengan cepat mengidentifikasi kolom berkardinalitas tinggi dan membantu menentukan strategi pra-pemrosesan atau penyimpanan terbaik.
Teknik prapemrosesan data
Prapemrosesan dalam ilmu data dan machine learning mengacu pada langkah-langkah untuk membersihkan, mentransformasi, dan mengorganisasi data mentah menjadi format yang sesuai untuk analisis atau pemodelan.
Ini adalah topik yang cukup padat, dan jika Anda memiliki sedikit atau tidak memiliki pengetahuan rekayasa data atau ilmu data, informasi di bagian ini mungkin agak sulit diikuti. Namun demikian, saya menyertakan tautan dan contoh yang relevan untuk membantu Anda mengikutinya!
Prapemrosesan data merupakan langkah penting untuk mengelola kardinalitas tinggi, karena mengurangi kompleksitas, meningkatkan kinerja, dan memastikan kualitas data memadai untuk tugas analisis atau machine learning. Dengan mentransformasi data mentah menjadi bentuk yang lebih mudah dikelola, kita dapat mengatasi tantangan seperti sparsitas, inefisiensi penyimpanan, dan hambatan komputasi.
Reduksi dimensi
Teknik reduksi dimensi sangat berharga ketika kardinalitas tinggi menghasilkan dataset dengan banyak fitur atau matriks yang jarang. Metode ini mengompresi data ke dimensi yang lebih sedikit sambil tetap mempertahankan informasi penting.
Principal Component Analysis (PCA)
Bayangkan Anda memiliki dataset perilaku pelanggan e-commerce, dengan banyak fitur seperti berapa kali pelanggan melihat suatu produk, interaksi mereka dengan berbagai kategori produk, waktu yang dihabiskan di situs, dan seterusnya. Masing-masing fitur ini mungkin sangat tinggi kardinalitasnya, terutama jika Anda melacak banyak produk. PCA dapat digunakan untuk menggabungkan fitur-fitur tersebut menjadi lebih sedikit komponen yang tetap menangkap pola paling signifikan dalam data, seperti keterlibatan pelanggan secara keseluruhan atau minat pada jenis produk tertentu. Anggap saja seperti Marie Kondo untuk data: ia menyimpan fitur-fitur yang memantik kegembiraan dan dengan lembut menyingkirkan sisanya!
t-SNE dan UMAP
t-SNE dan UMAP adalah teknik yang sangat berguna untuk memvisualisasikan data berdimensi tinggi dengan memetakannya ke dalam dua atau tiga dimensi sambil mempertahankan strukturnya. Misalnya, pada dataset rekam medis, UMAP dapat membantu dengan mengelompokkan pasien dengan kondisi medis atau regimen perawatan yang serupa. Ini membantu menemukan tren seperti penyakit yang sering muncul bersamaan atau hasil perawatan.
Seleksi fitur
Jika Anda membangun model machine learning untuk memprediksi kinerja penjualan platform e-commerce, dan dataset Anda mencakup fitur seperti berapa kali pelanggan mengeklik iklan, jumlah produk yang mereka lihat, serta jumlah hari sejak pembelian terakhir, Anda akan mendapati banyak fitur ini mungkin saling berkorelasi, yang menciptakan kardinalitas tinggi dan redundansi.
Dengan menggunakan teknik seleksi fitur seperti mutual information atau recursive feature elimination, Anda dapat mengidentifikasi fitur mana yang memiliki daya prediksi paling signifikan (misalnya, "waktu sejak pembelian terakhir" mungkin lebih penting daripada "klik pada iklan") dan mengecualikan yang tidak relevan, sehingga pada akhirnya meningkatkan kinerja model.
Jika Anda tertarik mempelajari lebih lanjut topik ini, coba kursus Preprocessing for Machine Learning. Anda akan menggunakan Python untuk membersihkan dan menyiapkan data sebelum memberikannya ke model Anda.
Metode pengkodean
Pengkodean adalah langkah prapemrosesan penting untuk menangani data kategorikal, khususnya saat berhadapan dengan fitur berkardinalitas tinggi. Pilihan metode pengkodean bergantung pada kasus penggunaan spesifik dan tingkat kardinalitas dalam dataset.
- One-Hot encoding: One-hot encoding membuat kolom biner untuk setiap kategori unik dalam dataset. Meskipun sederhana dan efektif untuk data berkardinalitas rendah, metode ini dapat menghasilkan matriks yang sangat jarang saat diterapkan pada fitur berkardinalitas tinggi. Misalnya, mengenkode 1.000 kode pos unik akan menghasilkan 1.000 kolom biner, yang dapat membebani memori dan sumber daya komputasi. Percayalah, saya mempelajarinya dengan cara yang sulit…
- Target encoding (mean encoding): Dalam metode ini, nilai kategorikal diganti dengan rata-rata variabel target untuk setiap kategori. Misalnya, jika Anda memprediksi churn pelanggan, target encoding dapat mengganti setiap kode pos dengan rata-rata tingkat churn pelanggan di area tersebut. Pendekatan ini mengurangi dimensi tetapi dapat memperkenalkan bias dan memerlukan validasi cermat untuk menghindari kebocoran data.
- Frequency encoding: Frequency encoding menetapkan frekuensi suatu kategori sebagai nilainya, mengurangi jumlah nilai unik. Misalnya, dalam dataset e-commerce, ID produk dapat diganti dengan frekuensi pembeliannya. Teknik ini hemat sumber daya dan sering berkorelasi dengan pentingnya fitur.
- Hashing encoding: Hashing encoding memetakan kategori ke bilangan bulat menggunakan fungsi hash, yang mengelompokkan sebagian kategori. Metode ini efisien memori dan cocok untuk data streaming atau kardinalitas yang sangat tinggi, tetapi memperkenalkan risiko tabrakan hash. Pernah bertanya-tanya mengapa situs belanja daring merekomendasikan susu formula bayi saat Anda mencari oli mobil? Nah, itulah akibat tabrakan hash.
- Embedding layer: Untuk model machine learning seperti neural network, embedding layer dapat mentransformasikan fitur kategorikal berkardinalitas tinggi menjadi representasi padat berkdimensi rendah. Pendekatan ini banyak digunakan dalam sistem rekomendasi, seperti mengenkode jutaan product ID atau user ID di platform e-commerce.
Kesimpulan
Dataset berkardinalitas tinggi terkadang terasa luar biasa, dan mengekstraksi wawasan berharga darinya jelas dapat menjadi tantangan. Lain kali Anda menemui dataset berkardinalitas tinggi, ingatlah bahwa ini bukan salah datanya – ia hanya penuh potensi yang menunggu untuk dibuka. Baik melalui reduksi dimensi, teknik pengkodean cerdas, atau alat seperti basis data deret waktu, Anda dapat mengelola dataset secara efektif dan mengubahnya menjadi aset yang sangat kuat.
Dan sekarang setelah Anda tahu cara bekerja dengan data berkardinalitas tinggi secara teori, saatnya mempraktikkannya:
- Berlatih langsung dengan teknik reduksi dimensi dan pengkodean – mulai dari yang kecil lalu tingkatkan. Kursus Dimensionality Reduction in Python kami adalah pilihan yang tepat.
- Coba beberapa alat yang disebutkan di sini (ya, basis data deret waktu sekeren kedengarannya!).
Dan yang terpenting, hadapi tantangannya. Kardinalitas tinggi memang rumit, tetapi juga kesempatan untuk banyak belajar tentang rekayasa dan analisis data!




Saya pertama kali mengenal konsep kardinalitas di kelas Mekanika Kuantum saat menempuh studi Fisika. Di kelas itu, kardinalitas mengacu pada ukuran himpunan, baik hingga maupun tak hingga, dan terkait dengan konsep abstrak seperti keterhitungan dan infinitas. Ketika beralih ke rekayasa perangkat lunak, saya menyadari bahwa bagi seorang data engineer atau ilmuwan data, kardinalitas memiliki makna yang jauh lebih praktis: tingkat keberagaman nilai dalam sebuah dataset.
Dalam salah satu proyek awal saya menganalisis data dunia nyata, saya belajar betapa menantangnya kardinalitas tinggi. Kueri basis data menjadi sangat lambat dan wawasan yang seharusnya jelas berubah menjadi kekacauan yang membingungkan. Sejak itu, saya mendapat cukup banyak praktik langsung dan menyusun panduan ini dengan harapan dapat membantu orang lain dalam situasi serupa. Anda berada di tempat yang tepat jika ingin mempelajari apa itu kardinalitas tinggi, tantangan apa yang ditimbulkannya, dan cara menanganinya secara praktis dan efektif!
Apa Itu Kardinalitas, dan Apa Itu Kardinalitas Tinggi?
Konsep kardinalitas dan kardinalitas tinggi bisa terdengar agak abstrak, jadi mari kita uraikan.
Definisi dan contoh
Kardinalitas mengacu pada jumlah nilai unik dalam sebuah kolom dataset. Kolom dengan kardinalitas tinggi berisi sangat banyak nilai unik, sedangkan kolom dengan kardinalitas rendah memiliki lebih sedikit entri unik.
Kardinalitas tinggi terutama umum pada dataset yang melibatkan pengenal unik, seperti:
Nilai-nilai unik ini penting untuk pelacakan, pengagregasian, atau personalisasi data. Namun, jumlahnya yang besar dapat menimbulkan tantangan signifikan dalam penyimpanan, kinerja, dan visualisasi, yang akan kita bahas sebentar lagi.
Kasus nyata yang umum
Kardinalitas tinggi dapat muncul di setiap domain dan industri. Saya menguraikan beberapa contoh di bawah ini untuk membantu Anda memahami apa yang dimaksud kardinalitas tinggi secara lebih praktis.
E-commerce dan data pelanggan
Platform e-commerce menghasilkan data berkardinalitas tinggi dalam jumlah besar setiap hari:
Dataset ini penting untuk memahami perilaku pengguna, melacak inventaris, dan mengoptimalkan strategi penjualan, tetapi banyaknya entri unik sering kali membuat analisis menjadi kompleks.
Kesehatan dan rekam pasien
Dalam bidang kesehatan, kebutuhan akan pelacakan dan identifikasi yang presisi secara alami menghasilkan data berkardinalitas tinggi. Misalnya, kita dapat menemukan:
Data ini diperlukan untuk menjaga riwayat pasien dan memastikan kepatuhan terhadap peraturan privasi.
Sensor IoT dan data streaming
Maraknya perangkat IoT menciptakan lonjakan dataset berkardinalitas tinggi:
Dalam IoT, kardinalitas tinggi muncul karena kebutuhan memproses data real-time yang sangat rinci dari banyak perangkat. Ini penting untuk analitik dan pemantauan namun menantang untuk disimpan dan dikueri secara efisien – akan kita bahas lagi nanti!
Tantangan Kardinalitas Tinggi
Kardinalitas tinggi menghadirkan sejumlah tantangan di ranah pemrosesan data, rekayasa, analisis, dan pembelajaran mesin. Dataset berkardinalitas tinggi menyajikan banyak informasi berguna, tetapi sering kali menjadi hambatan dan mengurangi kinerja, keterjelasan, serta skalabilitas.
Masalah penyimpanan data dan kinerja
Salah satu tantangan terbesar kardinalitas tinggi adalah dampaknya pada penyimpanan data dan kinerja sistem.
Ambil contoh basis data yang menyimpan data sensor IoT dengan ID sensor unik dan timestamp presisi. Kueri yang memfilter berdasarkan sensor tertentu dan rentang waktu dapat mengharuskan basis data memproses jutaan entri unik, yang mengarah ke waktu respons sangat lambat dan operasi yang menguras sumber daya.
Kesulitan visualisasi data
Tantangannya adalah menyajikan banyak nilai berbeda dengan cara yang dapat dipahami dan bermakna. Tanpa pemikiran matang, data berkardinalitas tinggi justru dapat menyembunyikan wawasan alih-alih mengungkapkannya.
Contoh yang baik adalah diagram pai di bawah ini. Legenda dan nilainya tidak terbaca karena ada terlalu banyak entri unik (negara bagian) untuk jenis grafik yang digunakan. Terkadang, mengubah jenis grafik membantu, namun tidak selalu.
Sumber: European Environment Agency
Bayangkan diagram batang yang merepresentasikan aktivitas pelanggan sebuah platform e-niaga berdasarkan ID sesi. Dengan ribuan atau jutaan ID unik, grafik menjadi tumpukan batang yang tak terbaca, dan mengubah jenis grafik untuk memplot data ini kecil kemungkinan akan membantu.
Lalu, mengapa kita tidak cukup mengagregasikan data untuk menemukan pola dan hubungan dari grafik? Bisa, tapi harus dilakukan dengan hati-hati. Mengagregasikan data berkardinalitas tinggi dapat membuat kita kehilangan granularitas yang diperlukan untuk memperoleh wawasan. Misalnya, mengelompokkan data IoT berdasarkan lokasi bisa menyamarkan variasi halus namun krusial di level sensor individual. Teknik untuk mengatasinya bisa cukup rumit. Saya merekomendasikan kursus Intermediate Data Modeling in Power BI untuk mendapatkan pengalaman langsung dengan relasi one-to-one dan one-to-many.
Keterkaitan dengan machine learning
Kardinalitas tinggi dapat menghadirkan tantangan signifikan dalam machine learning, khususnya terkait rekayasa fitur, kompleksitas model, dan keterjelasan. Model machine learning bekerja baik dengan masukan yang terstruktur dan bermakna, tetapi fitur berkardinalitas tinggi sering mengganggu keseimbangan ini, sehingga menimbulkan komplikasi:
Contohnya, dalam e-commerce, model machine learning yang memprediksi churn pelanggan mungkin menyertakan fitur berkardinalitas tinggi seperti "user ID" atau "product ID." Jika tidak dikelola dengan baik, model bisa overfit terhadap pelanggan atau produk tertentu dalam data pelatihan. Ini membuatnya kurang efektif saat diterapkan untuk memprediksi churn pengguna baru, karena ia mempelajari pola yang khas untuk dataset pelatihan alih-alih tren yang dapat digeneralisasi.
Strategi Mengelola Kardinalitas Tinggi
Mengelola kardinalitas tinggi secara efektif memerlukan perpaduan strategi spesifik domain dan teknik optimasi data umum. Pendekatan ini tidak hanya meningkatkan kinerja sistem, tetapi juga membuat data lebih mudah diinterpretasikan dan ditindaklanjuti.
Memanfaatkan teknologi dan alat
Untungnya, tantangan yang ditimbulkan dataset berkardinalitas tinggi cukup luas sehingga berbagai teknik dan alat telah diciptakan dan disempurnakan khusus untuk menanganinya.
Optimasi basis data
Mengelola kardinalitas tinggi di basis data sering dimulai dengan mengoptimalkan cara data disimpan dan dikueri, bukan sekadar menghapus duplikasi. Teknik yang paling umum digunakan adalah:
Perangkat lunak khusus
Jika Anda berurusan dengan kardinalitas yang sangat tinggi, ada alat dan platform khusus yang dapat membantu Anda:
Teknik prapemrosesan data
Prapemrosesan dalam ilmu data dan machine learning mengacu pada langkah-langkah untuk membersihkan, mentransformasi, dan mengorganisasi data mentah menjadi format yang sesuai untuk analisis atau pemodelan.
Ini adalah topik yang cukup padat, dan jika Anda memiliki sedikit atau tidak memiliki pengetahuan rekayasa data atau ilmu data, informasi di bagian ini mungkin agak sulit diikuti. Namun demikian, saya menyertakan tautan dan contoh yang relevan untuk membantu Anda mengikutinya!
Prapemrosesan data merupakan langkah penting untuk mengelola kardinalitas tinggi, karena mengurangi kompleksitas, meningkatkan kinerja, dan memastikan kualitas data memadai untuk tugas analisis atau machine learning. Dengan mentransformasi data mentah menjadi bentuk yang lebih mudah dikelola, kita dapat mengatasi tantangan seperti sparsitas, inefisiensi penyimpanan, dan hambatan komputasi.
Reduksi dimensi
Teknik reduksi dimensi sangat berharga ketika kardinalitas tinggi menghasilkan dataset dengan banyak fitur atau matriks yang jarang. Metode ini mengompresi data ke dimensi yang lebih sedikit sambil tetap mempertahankan informasi penting.
Principal Component Analysis (PCA)
Bayangkan Anda memiliki dataset perilaku pelanggan e-commerce, dengan banyak fitur seperti berapa kali pelanggan melihat suatu produk, interaksi mereka dengan berbagai kategori produk, waktu yang dihabiskan di situs, dan seterusnya. Masing-masing fitur ini mungkin sangat tinggi kardinalitasnya, terutama jika Anda melacak banyak produk. PCA dapat digunakan untuk menggabungkan fitur-fitur tersebut menjadi lebih sedikit komponen yang tetap menangkap pola paling signifikan dalam data, seperti keterlibatan pelanggan secara keseluruhan atau minat pada jenis produk tertentu. Anggap saja seperti Marie Kondo untuk data: ia menyimpan fitur-fitur yang memantik kegembiraan dan dengan lembut menyingkirkan sisanya!
t-SNE dan UMAP
t-SNE dan UMAP adalah teknik yang sangat berguna untuk memvisualisasikan data berdimensi tinggi dengan memetakannya ke dalam dua atau tiga dimensi sambil mempertahankan strukturnya. Misalnya, pada dataset rekam medis, UMAP dapat membantu dengan mengelompokkan pasien dengan kondisi medis atau regimen perawatan yang serupa. Ini membantu menemukan tren seperti penyakit yang sering muncul bersamaan atau hasil perawatan.
Seleksi fitur
Jika Anda membangun model machine learning untuk memprediksi kinerja penjualan platform e-commerce, dan dataset Anda mencakup fitur seperti berapa kali pelanggan mengeklik iklan, jumlah produk yang mereka lihat, serta jumlah hari sejak pembelian terakhir, Anda akan mendapati banyak fitur ini mungkin saling berkorelasi, yang menciptakan kardinalitas tinggi dan redundansi.
Dengan menggunakan teknik seleksi fitur seperti mutual information atau recursive feature elimination, Anda dapat mengidentifikasi fitur mana yang memiliki daya prediksi paling signifikan (misalnya, "waktu sejak pembelian terakhir" mungkin lebih penting daripada "klik pada iklan") dan mengecualikan yang tidak relevan, sehingga pada akhirnya meningkatkan kinerja model.
Jika Anda tertarik mempelajari lebih lanjut topik ini, coba kursus Preprocessing for Machine Learning. Anda akan menggunakan Python untuk membersihkan dan menyiapkan data sebelum memberikannya ke model Anda.
Metode pengkodean
Pengkodean adalah langkah prapemrosesan penting untuk menangani data kategorikal, khususnya saat berhadapan dengan fitur berkardinalitas tinggi. Pilihan metode pengkodean bergantung pada kasus penggunaan spesifik dan tingkat kardinalitas dalam dataset.
Kesimpulan
Dataset berkardinalitas tinggi terkadang terasa luar biasa, dan mengekstraksi wawasan berharga darinya jelas dapat menjadi tantangan. Lain kali Anda menemui dataset berkardinalitas tinggi, ingatlah bahwa ini bukan salah datanya – ia hanya penuh potensi yang menunggu untuk dibuka. Baik melalui reduksi dimensi, teknik pengkodean cerdas, atau alat seperti basis data deret waktu, Anda dapat mengelola dataset secara efektif dan mengubahnya menjadi aset yang sangat kuat.
Dan sekarang setelah Anda tahu cara bekerja dengan data berkardinalitas tinggi secara teori, saatnya mempraktikkannya:
Dan yang terpenting, hadapi tantangannya. Kardinalitas tinggi memang rumit, tetapi juga kesempatan untuk banyak belajar tentang rekayasa dan analisis data!