Ho incontrato per la prima volta il concetto di cardinalità in un corso di Meccanica Quantistica, durante la laurea in Fisica. In quel contesto, la cardinalità indicava la dimensione di un insieme, finito o infinito, ed era legata a concetti astratti come numerabilità e infiniti. Passando all’ingegneria del software, ho capito che, per un data engineer o uno scienziato dei dati, la cardinalità assume un significato molto più pratico: l’unicità dei valori in un dataset.
In uno dei miei primi progetti di analisi di dati reali, ho imparato quanto possa essere impegnativa l’alta cardinalità. Ha rallentato le query al punto da procedere a passo di lumaca e ha trasformato intuizioni che avrebbero dovuto essere chiare in un caos confuso. Da allora ho fatto pratica sul campo e ho messo insieme questa guida sperando possa aiutare altri nella stessa situazione. Sei nel posto giusto se vuoi capire cos’è l’alta cardinalità, quali sfide comporta e come domarle in modo pratico ed efficace!
Cos’è la cardinalità e cos’è l’alta cardinalità?
I concetti di cardinalità e alta cardinalità possono sembrare un po’ astratti, quindi scomponiamoli.
Definizione ed esempi
La cardinalità si riferisce al numero di valori unici in una colonna di un dataset. Una colonna con alta cardinalità contiene un numero vasto di valori unici, mentre colonne con bassa cardinalità contengono meno voci distinte.
L’alta cardinalità è particolarmente comune nei dataset con identificatori univoci, come:
- Timestamp: quasi ogni valore è unico quando i dati vengono registrati a livello di millisecondi o nanosecondi.
- ID cliente: ogni cliente ha un identificatore distinto per tracciare la sua attività.
- ID transazione: i dataset finanziari spesso includono codici unici per ogni transazione.
Questi valori unici sono importanti per tracciare, aggregare o personalizzare i dati. Tuttavia, il loro numero enorme può creare sfide significative in termini di archiviazione, prestazioni e visualizzazione, che vedremo a breve.
Casi comuni nella vita reale
L’alta cardinalità può manifestarsi in ogni ambito e settore. Di seguito ho riportato alcuni esempi per aiutarti a capire in termini più pratici cosa significhi alta cardinalità.
E-commerce e dati dei clienti
Le piattaforme di e-commerce generano quotidianamente enormi quantità di dati ad alta cardinalità:
- ID cliente: a ogni utente viene assegnato un identificatore univoco per tracciare comportamenti, acquisti e preferenze.
- ID di sessione: ogni sessione di navigazione è registrata in modo univoco, generando un gran numero di valori distinti nei dataset di tracciamento delle sessioni.
- SKU dei prodotti: gli Stock Keeping Unit sono univoci per ogni variante di prodotto, creando una colonna ad alta cardinalità nei dati di inventario e vendite.
Questi dataset sono essenziali per comprendere il comportamento degli utenti, monitorare l’inventario e ottimizzare le strategie di vendita, ma l’enorme numero di voci uniche rende spesso complessa l’analisi.
Sanità e cartelle cliniche
In sanità, l’esigenza di tracciamento e identificazione precisi porta naturalmente a dati ad alta cardinalità. Ad esempio, troviamo:
- ID paziente: ogni paziente ha un identificatore univoco per garantire una conservazione delle cartelle accurata e sicura.
- Timestamp degli appuntamenti: si possono creare timestamp univoci per ogni interazione del paziente, dalle visite ai test di laboratorio.
- Numeri delle richieste assicurative: ogni richiesta gestita dai fornitori di assicurazioni è assegnata a un codice distinto per registrazione e audit.
Questi dati sono necessari per mantenere la storia clinica del paziente e garantire la conformità alle norme sulla privacy.
Sensori IoT e dati in streaming
La diffusione dei dispositivi IoT ha creato un’impennata di dataset ad alta cardinalità:
- ID sensore: ogni dispositivo IoT ha un identificatore univoco per tracciarne attività e posizione.
- Dati di timestamp: i flussi continui registrano spesso eventi a intervalli di millisecondi o nanosecondi, producendo valori quasi interamente unici.
- ID evento: ogni evento registrato in un sistema, dalle letture di temperatura al rilevamento del movimento, è assegnato a un identificatore univoco.
Nell’IoT, l’alta cardinalità nasce dall’esigenza di elaborare dati in tempo reale e ad alta granularità provenienti da numerosi dispositivi. È vitale per analisi e monitoraggio, ma è impegnativa da archiviare e interrogare in modo efficiente – ne parleremo più avanti!
Le sfide dell’alta cardinalità
L’alta cardinalità presenta diverse sfide nell’elaborazione dei dati, nell’ingegneria, nell’analisi e nel machine learning. I dataset ad alta cardinalità offrono una grande ricchezza informativa, ma spesso diventano un collo di bottiglia e ostacolano prestazioni, interpretabilità e scalabilità.
Problemi di archiviazione e prestazioni
Una delle principali sfide dell’alta cardinalità è l’impatto su archiviazione e prestazioni dei sistemi.
- Overhead di storage: colonne ad alta cardinalità, come identificatori unici o timestamp, generano dataset più grandi. Per esempio, registrare milioni di interazioni utente su una piattaforma e-commerce crea un enorme overhead di archiviazione a causa dell’unicità degli ID di sessione o dei timestamp delle transazioni.
- Prestazioni delle query ridotte: quando si interrogano colonne ad alta cardinalità, i database faticano per l’aumentata complessità di indicizzazione e scansione. Le query che filtrano o fanno join su colonne ad alta cardinalità tendono a durare di più, perché il database deve setacciare un numero enorme di valori distinti.
- Sfide di indicizzazione: gli indici, fondamentali per velocizzare le query, diventano gonfi e meno efficienti con colonne ad alta cardinalità. Questo può portare a lookup più lenti e prestazioni degradate.
Prendiamo come esempio un database che memorizza dati di sensori IoT con ID sensore unici e timestamp precisi. Le query che filtrano per uno specifico sensore e intervallo temporale possono richiedere al database di elaborare milioni di voci uniche, con tempi di risposta lentissimi e operazioni ad alto impatto sulle risorse.
Difficoltà di visualizzazione dei dati
La sfida sta nel presentare un gran numero di valori distinti in modo comprensibile e significativo. Senza una progettazione attenta, i dati ad alta cardinalità possono nascondere gli insight invece di rivelarli.
Un buon esempio è il grafico a torta qui sotto. La legenda e i valori sono illeggibili perché ci sono troppe voci uniche (stati) per il tipo di grafico usato. A volte cambiare tipo di grafico aiuta, ma non sempre.
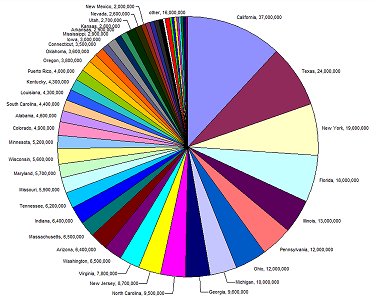
Fonte: Agenzia europea dell’ambiente
Immagina un grafico a barre che rappresenta l’attività dei clienti di una piattaforma e‑commerce per ID di sessione. Con migliaia o milioni di ID unici, il grafico diventa un groviglio illeggibile di barre, e cambiare tipo di grafico difficilmente farà la differenza.
Ok, quindi perché non aggreghiamo semplicemente i dati per ricavare pattern e relazioni dai grafici? Si può fare, ma con attenzione. Aggregare dati ad alta cardinalità può farci perdere la granularità necessaria a trarre insight. Per esempio, raggruppare i dati IoT per posizione potrebbe oscurare variazioni sottili ma critiche a livello di singolo sensore. Le tecniche per risolvere questo problema possono essere delicate. Ti consiglio il nostro corso Intermediate Data Modeling in Power BI per fare pratica con relazioni one-to-one e one-to-many.
Rilevanza per il machine learning
L’alta cardinalità può creare sfide significative nel machine learning, in particolare per feature engineering, complessità del modello e interpretabilità. I modelli di machine learning danno il meglio con input strutturati e significativi, ma le feature ad alta cardinalità spesso rompono questo equilibrio, causando complicazioni:
- Aumento della sparsità: le feature ad alta cardinalità portano spesso a dataset sparsi. Per esempio, effettuare one‑hot encoding su una variabile categorica ad alta cardinalità come i CAP crea una matrice con un numero enorme di dimensioni, la maggior parte delle quali vuote. Questa sparsità rende più difficile per i modelli, soprattutto quelli basati sulle distanze come k-nearest neighbors o gli algoritmi di clustering, trovare relazioni significative nei dati.
- Rischi di overfitting: le feature ad alta cardinalità possono portare a overfitting in modelli che suddividono i dati in categorie molto fini, come alberi decisionali o random forest. Quando ogni categoria è rappresentata da pochi campioni, il modello può imparare il rumore invece dei pattern reali, generalizzando male a dati non visti.
Per esempio, in e‑commerce, un modello che predice il churn dei clienti potrebbe includere una feature ad alta cardinalità come "ID utente" o "ID prodotto". Se non gestita correttamente, il modello potrebbe overfittare su clienti o prodotti specifici nel training set, risultando meno efficace nel prevedere il churn per nuovi utenti, perché apprende pattern unici del dataset di training anziché trend generalizzabili.
Strategie per gestire l’alta cardinalità
Gestire efficacemente l’alta cardinalità richiede un mix di strategie specifiche di dominio e tecniche generali di ottimizzazione dei dati. Questi approcci non solo migliorano le prestazioni dei sistemi, ma rendono anche i dati più interpretabili e azionabili.
Sfruttare tecnologie e strumenti
Per fortuna, le sfide poste dai dataset ad alta cardinalità sono così diffuse che sono state create e affinate tecniche e strumenti specifici per affrontarle.
Ottimizzazione del database
Gestire l’alta cardinalità nei database inizia spesso ottimizzando come i dati vengono archiviati e interrogati, oltre al semplice rimuovere i duplicati. Le tecniche più comuni sono:
- Bucketing (o binning): raggruppare dati ad alta cardinalità in categorie più ampie per ridurre il numero di valori unici. Per esempio, raggruppare i CAP per regione invece di memorizzarli singolarmente.
- Partizionamento: strutturare le tabelle in partizioni basate su campi usati spesso nelle query. Per esempio, partizionare i dati dei clienti per paese può migliorare le prestazioni in sistemi distribuiti geograficamente.
- Indicizzazione: usare indici progettati per campi ad alta cardinalità, come bitmap o indici compositi, può migliorare la velocità delle query bilanciando l’efficienza dello storage.
Software specializzati
Se stai affrontando un’alta cardinalità estrema, ci sono strumenti e piattaforme specializzati che possono aiutarti:
- Database colonnari: database come Apache Parquet o Amazon Redshift sono pensati per query analitiche e possono archiviare ed elaborare in modo efficiente colonne ad alta cardinalità.
- Database NoSQL: in alcuni casi, database NoSQL come MongoDB o Elasticsearch gestiscono meglio la variabilità e la dimensione dei dataset ad alta cardinalità, soprattutto se abbinati a design schema-less.
- Database di serie temporali: per dataset dominati da timestamp ed eventi, come i dati dei sensori IoT o le transazioni di borsa, i database di serie temporali come InfluxDB o TimescaleDB sono davvero utili. Sono specificamente ottimizzati per archiviare in modo efficiente dimensioni ad alta cardinalità e usano tecniche di compressione avanzate per minimizzare i costi di storage mantenendo alte prestazioni. Ho lavorato su alcuni progetti con enormi quantità di dati IoT, e i database di serie temporali hanno fatto una grande differenza nel ricavare trend e previsioni. Ho scritto questa guida sui database di serie temporali, se ti interessa saperne di più!
- Strumenti di data profiling: strumenti come Talend, OpenRefine o anche script Python personalizzati possono identificare rapidamente i campi ad alta cardinalità e aiutare a determinare la migliore strategia di pre‑processing o archiviazione.
Tecniche di preprocessing dei dati
Nel data science e nel machine learning, il preprocessing indica i passaggi per pulire, trasformare e organizzare i dati grezzi in un formato adatto all’analisi o alla modellazione.
È un tema piuttosto corposo e, se hai poca o nessuna esperienza di data engineering o data science, le informazioni in questa sezione potrebbero risultare un po’ difficili da seguire. Detto questo, ho incluso link ed esempi utili per aiutarti!
Il preprocessing è un passaggio essenziale per gestire l’alta cardinalità, perché riduce la complessità, migliora le prestazioni e garantisce che la qualità dei dati sia sufficiente per analisi o compiti di machine learning. Trasformando i dati grezzi in forme più gestibili, possiamo affrontare problemi come sparsità, inefficienze di storage e colli di bottiglia computazionali.
Riduzione della dimensionalità
Le tecniche di riduzione della dimensionalità sono particolarmente utili quando l’alta cardinalità genera dataset con numerose feature o matrici sparse. Questi metodi comprimono i dati in meno dimensioni mantenendo comunque le informazioni cruciali.
Principal Component Analysis (PCA)
Immagina di avere un dataset sui comportamenti dei clienti e‑commerce, con molte feature come il numero di volte in cui un cliente ha visualizzato un prodotto, l’interazione con diverse categorie, il tempo trascorso sul sito e così via. Ciascuna di queste feature può essere ad alta cardinalità, soprattutto se tracci un gran numero di prodotti. La PCA può combinare queste feature in un numero minore di componenti che catturano comunque i pattern più significativi nei dati, come il coinvolgimento complessivo del cliente o l’interesse per particolari tipi di prodotto. Pensala come la Marie Kondo dei dati: tiene le feature che danno gioia e scarta con gentilezza il resto!
t‑SNE e UMAP
t‑SNE e UMAP sono tecniche particolarmente utili per visualizzare dati ad alta dimensionalità mappandoli in due o tre dimensioni preservandone la struttura. Per esempio, in dataset di cartelle cliniche, UMAP può aiutare a raggruppare pazienti con condizioni mediche o regimi terapeutici simili. Questo aiuta a individuare trend come comorbilità frequenti o esiti dei trattamenti.
Selezione delle feature
Se stai costruendo un modello di machine learning per prevedere le performance di vendita di una piattaforma e‑commerce e il tuo dataset include feature come il numero di clic su un annuncio, il numero di prodotti visualizzati e i giorni dall’ultimo acquisto, scoprirai che molte di queste feature possono essere correlate tra loro, creando alta cardinalità e ridondanza.
Usando tecniche di selezione delle feature come mutual information o recursive feature elimination, puoi identificare quali feature hanno il maggiore potere predittivo (ad esempio, "tempo dall’ultimo acquisto" potrebbe essere più importante dei "clic sull’annuncio") ed escludere quelle irrilevanti, migliorando in definitiva le prestazioni del modello.
Se vuoi approfondire l’argomento, prova il corso Preprocessing for Machine Learning. Userai Python per pulire e preparare i dati prima di passarli ai modelli.
Metodi di encoding
L’encoding è un passaggio critico del preprocessing per gestire i dati categorici, soprattutto con feature ad alta cardinalità. La scelta del metodo dipende dallo specifico caso d’uso e dal livello di cardinalità del dataset.
- One‑Hot encoding: One‑hot encoding crea una colonna binaria per ogni categoria unica in un dataset. Sebbene sia semplice ed efficace con bassa cardinalità, può generare matrici estremamente sparse se applicato a feature ad alta cardinalità. Per esempio, codificare 1.000 CAP unici produrrà 1.000 colonne binarie, con rischio di saturare memoria e risorse computazionali. Fidati, l’ho imparato a mie spese…
- Target encoding (mean encoding): in questo metodo, i valori categorici vengono sostituiti con la media della variabile target per ciascuna categoria. Per esempio, se stai prevedendo il churn, il target encoding potrebbe sostituire ogni CAP con il tasso medio di churn dei clienti in quell’area. Questo approccio riduce la dimensionalità ma può introdurre bias e richiede una validazione attenta per evitare leakage.
- Frequency encoding: assegna alla categoria la sua frequenza come valore, riducendo il numero di valori unici. Per esempio, in un dataset e‑commerce, gli ID prodotto possono essere sostituiti con la loro frequenza di acquisto. Questa tecnica è efficiente in termini di risorse e spesso correla con l’importanza della feature.
- Hashing encoding: mappa le categorie a interi usando una funzione di hash, raggruppando alcune categorie insieme. Questo metodo è parco in memoria e funziona bene per dati in streaming o cardinalità estremamente elevata, ma introduce il rischio di collisioni di hash. Ti sei mai chiesto perché il tuo sito di shopping online ti raccomanda latte in polvere quando hai cercato olio per auto? Ecco, quelle sono collisioni di hash.
- Layer di embedding: nei modelli di machine learning come le reti neurali, i layer di embedding trasformano feature categoriche ad alta cardinalità in rappresentazioni dense e a bassa dimensionalità. Questo approccio è ampiamente usato nei sistemi di raccomandazione, ad esempio per codificare milioni di ID prodotto o ID utente nelle piattaforme di e‑commerce.
Conclusione
I dataset ad alta cardinalità a volte possono risultare travolgenti, e ricavare insight di valore può essere davvero impegnativo. La prossima volta che ti imbatti in un dataset ad alta cardinalità, ricorda che non è colpa dei dati – sono semplicemente pieni di potenziale in attesa di essere sbloccato. Che sia tramite riduzione della dimensionalità, tecniche di encoding intelligenti o strumenti come i database di serie temporali, puoi gestire efficacemente i tuoi dataset e trasformarli in risorse potentissime.
E ora che sai come lavorare con dati ad alta cardinalità in teoria, è il momento di metterlo in pratica:
- Fai pratica con riduzione della dimensionalità e tecniche di encoding – inizia in piccolo e poi alza l’asticella. Il nostro Dimensionality Reduction in Python è un’ottima scelta.
- Prova alcuni degli strumenti menzionati qui (sì, i database di serie temporali sono davvero fighi!).
E soprattutto, accetta la sfida. L’alta cardinalità può essere ostica, ma è anche un’occasione per imparare tanto su data engineering e analisi!






Ho incontrato per la prima volta il concetto di cardinalità in un corso di Meccanica Quantistica, durante la laurea in Fisica. In quel contesto, la cardinalità indicava la dimensione di un insieme, finito o infinito, ed era legata a concetti astratti come numerabilità e infiniti. Passando all’ingegneria del software, ho capito che, per un data engineer o uno scienziato dei dati, la cardinalità assume un significato molto più pratico: l’unicità dei valori in un dataset.
In uno dei miei primi progetti di analisi di dati reali, ho imparato quanto possa essere impegnativa l’alta cardinalità. Ha rallentato le query al punto da procedere a passo di lumaca e ha trasformato intuizioni che avrebbero dovuto essere chiare in un caos confuso. Da allora ho fatto pratica sul campo e ho messo insieme questa guida sperando possa aiutare altri nella stessa situazione. Sei nel posto giusto se vuoi capire cos’è l’alta cardinalità, quali sfide comporta e come domarle in modo pratico ed efficace!
Cos’è la cardinalità e cos’è l’alta cardinalità?
I concetti di cardinalità e alta cardinalità possono sembrare un po’ astratti, quindi scomponiamoli.
Definizione ed esempi
La cardinalità si riferisce al numero di valori unici in una colonna di un dataset. Una colonna con alta cardinalità contiene un numero vasto di valori unici, mentre colonne con bassa cardinalità contengono meno voci distinte.
L’alta cardinalità è particolarmente comune nei dataset con identificatori univoci, come:
Questi valori unici sono importanti per tracciare, aggregare o personalizzare i dati. Tuttavia, il loro numero enorme può creare sfide significative in termini di archiviazione, prestazioni e visualizzazione, che vedremo a breve.
Casi comuni nella vita reale
L’alta cardinalità può manifestarsi in ogni ambito e settore. Di seguito ho riportato alcuni esempi per aiutarti a capire in termini più pratici cosa significhi alta cardinalità.
E-commerce e dati dei clienti
Le piattaforme di e-commerce generano quotidianamente enormi quantità di dati ad alta cardinalità:
Questi dataset sono essenziali per comprendere il comportamento degli utenti, monitorare l’inventario e ottimizzare le strategie di vendita, ma l’enorme numero di voci uniche rende spesso complessa l’analisi.
Sanità e cartelle cliniche
In sanità, l’esigenza di tracciamento e identificazione precisi porta naturalmente a dati ad alta cardinalità. Ad esempio, troviamo:
Questi dati sono necessari per mantenere la storia clinica del paziente e garantire la conformità alle norme sulla privacy.
Sensori IoT e dati in streaming
La diffusione dei dispositivi IoT ha creato un’impennata di dataset ad alta cardinalità:
Nell’IoT, l’alta cardinalità nasce dall’esigenza di elaborare dati in tempo reale e ad alta granularità provenienti da numerosi dispositivi. È vitale per analisi e monitoraggio, ma è impegnativa da archiviare e interrogare in modo efficiente – ne parleremo più avanti!
Le sfide dell’alta cardinalità
L’alta cardinalità presenta diverse sfide nell’elaborazione dei dati, nell’ingegneria, nell’analisi e nel machine learning. I dataset ad alta cardinalità offrono una grande ricchezza informativa, ma spesso diventano un collo di bottiglia e ostacolano prestazioni, interpretabilità e scalabilità.
Problemi di archiviazione e prestazioni
Una delle principali sfide dell’alta cardinalità è l’impatto su archiviazione e prestazioni dei sistemi.
Prendiamo come esempio un database che memorizza dati di sensori IoT con ID sensore unici e timestamp precisi. Le query che filtrano per uno specifico sensore e intervallo temporale possono richiedere al database di elaborare milioni di voci uniche, con tempi di risposta lentissimi e operazioni ad alto impatto sulle risorse.
Difficoltà di visualizzazione dei dati
La sfida sta nel presentare un gran numero di valori distinti in modo comprensibile e significativo. Senza una progettazione attenta, i dati ad alta cardinalità possono nascondere gli insight invece di rivelarli.
Un buon esempio è il grafico a torta qui sotto. La legenda e i valori sono illeggibili perché ci sono troppe voci uniche (stati) per il tipo di grafico usato. A volte cambiare tipo di grafico aiuta, ma non sempre.
Fonte: Agenzia europea dell’ambiente
Immagina un grafico a barre che rappresenta l’attività dei clienti di una piattaforma e‑commerce per ID di sessione. Con migliaia o milioni di ID unici, il grafico diventa un groviglio illeggibile di barre, e cambiare tipo di grafico difficilmente farà la differenza.
Ok, quindi perché non aggreghiamo semplicemente i dati per ricavare pattern e relazioni dai grafici? Si può fare, ma con attenzione. Aggregare dati ad alta cardinalità può farci perdere la granularità necessaria a trarre insight. Per esempio, raggruppare i dati IoT per posizione potrebbe oscurare variazioni sottili ma critiche a livello di singolo sensore. Le tecniche per risolvere questo problema possono essere delicate. Ti consiglio il nostro corso Intermediate Data Modeling in Power BI per fare pratica con relazioni one-to-one e one-to-many.
Rilevanza per il machine learning
L’alta cardinalità può creare sfide significative nel machine learning, in particolare per feature engineering, complessità del modello e interpretabilità. I modelli di machine learning danno il meglio con input strutturati e significativi, ma le feature ad alta cardinalità spesso rompono questo equilibrio, causando complicazioni:
Per esempio, in e‑commerce, un modello che predice il churn dei clienti potrebbe includere una feature ad alta cardinalità come "ID utente" o "ID prodotto". Se non gestita correttamente, il modello potrebbe overfittare su clienti o prodotti specifici nel training set, risultando meno efficace nel prevedere il churn per nuovi utenti, perché apprende pattern unici del dataset di training anziché trend generalizzabili.
Strategie per gestire l’alta cardinalità
Gestire efficacemente l’alta cardinalità richiede un mix di strategie specifiche di dominio e tecniche generali di ottimizzazione dei dati. Questi approcci non solo migliorano le prestazioni dei sistemi, ma rendono anche i dati più interpretabili e azionabili.
Sfruttare tecnologie e strumenti
Per fortuna, le sfide poste dai dataset ad alta cardinalità sono così diffuse che sono state create e affinate tecniche e strumenti specifici per affrontarle.
Ottimizzazione del database
Gestire l’alta cardinalità nei database inizia spesso ottimizzando come i dati vengono archiviati e interrogati, oltre al semplice rimuovere i duplicati. Le tecniche più comuni sono:
Software specializzati
Se stai affrontando un’alta cardinalità estrema, ci sono strumenti e piattaforme specializzati che possono aiutarti:
Tecniche di preprocessing dei dati
Nel data science e nel machine learning, il preprocessing indica i passaggi per pulire, trasformare e organizzare i dati grezzi in un formato adatto all’analisi o alla modellazione.
È un tema piuttosto corposo e, se hai poca o nessuna esperienza di data engineering o data science, le informazioni in questa sezione potrebbero risultare un po’ difficili da seguire. Detto questo, ho incluso link ed esempi utili per aiutarti!
Il preprocessing è un passaggio essenziale per gestire l’alta cardinalità, perché riduce la complessità, migliora le prestazioni e garantisce che la qualità dei dati sia sufficiente per analisi o compiti di machine learning. Trasformando i dati grezzi in forme più gestibili, possiamo affrontare problemi come sparsità, inefficienze di storage e colli di bottiglia computazionali.
Riduzione della dimensionalità
Le tecniche di riduzione della dimensionalità sono particolarmente utili quando l’alta cardinalità genera dataset con numerose feature o matrici sparse. Questi metodi comprimono i dati in meno dimensioni mantenendo comunque le informazioni cruciali.
Principal Component Analysis (PCA)
Immagina di avere un dataset sui comportamenti dei clienti e‑commerce, con molte feature come il numero di volte in cui un cliente ha visualizzato un prodotto, l’interazione con diverse categorie, il tempo trascorso sul sito e così via. Ciascuna di queste feature può essere ad alta cardinalità, soprattutto se tracci un gran numero di prodotti. La PCA può combinare queste feature in un numero minore di componenti che catturano comunque i pattern più significativi nei dati, come il coinvolgimento complessivo del cliente o l’interesse per particolari tipi di prodotto. Pensala come la Marie Kondo dei dati: tiene le feature che danno gioia e scarta con gentilezza il resto!
t‑SNE e UMAP
t‑SNE e UMAP sono tecniche particolarmente utili per visualizzare dati ad alta dimensionalità mappandoli in due o tre dimensioni preservandone la struttura. Per esempio, in dataset di cartelle cliniche, UMAP può aiutare a raggruppare pazienti con condizioni mediche o regimi terapeutici simili. Questo aiuta a individuare trend come comorbilità frequenti o esiti dei trattamenti.
Selezione delle feature
Se stai costruendo un modello di machine learning per prevedere le performance di vendita di una piattaforma e‑commerce e il tuo dataset include feature come il numero di clic su un annuncio, il numero di prodotti visualizzati e i giorni dall’ultimo acquisto, scoprirai che molte di queste feature possono essere correlate tra loro, creando alta cardinalità e ridondanza.
Usando tecniche di selezione delle feature come mutual information o recursive feature elimination, puoi identificare quali feature hanno il maggiore potere predittivo (ad esempio, "tempo dall’ultimo acquisto" potrebbe essere più importante dei "clic sull’annuncio") ed escludere quelle irrilevanti, migliorando in definitiva le prestazioni del modello.
Se vuoi approfondire l’argomento, prova il corso Preprocessing for Machine Learning. Userai Python per pulire e preparare i dati prima di passarli ai modelli.
Metodi di encoding
L’encoding è un passaggio critico del preprocessing per gestire i dati categorici, soprattutto con feature ad alta cardinalità. La scelta del metodo dipende dallo specifico caso d’uso e dal livello di cardinalità del dataset.
Conclusione
I dataset ad alta cardinalità a volte possono risultare travolgenti, e ricavare insight di valore può essere davvero impegnativo. La prossima volta che ti imbatti in un dataset ad alta cardinalità, ricorda che non è colpa dei dati – sono semplicemente pieni di potenziale in attesa di essere sbloccato. Che sia tramite riduzione della dimensionalità, tecniche di encoding intelligenti o strumenti come i database di serie temporali, puoi gestire efficacemente i tuoi dataset e trasformarli in risorse potentissime.
E ora che sai come lavorare con dati ad alta cardinalità in teoria, è il momento di metterlo in pratica:
E soprattutto, accetta la sfida. L’alta cardinalità può essere ostica, ma è anche un’occasione per imparare tanto su data engineering e analisi!