
课程
面向业务的机器学习
2 小时
47.7K
在机器学习中,一个常见挑战是处理分类变量(如颜色、产品类型或地点),因为算法通常需要数值输入。一个解决方案就是一位有效编码(one-hot encoding)。
一位有效编码是一种将分类数据表示为数值向量的技术,每个唯一类别由一个二进制列表示,1 表示该类别出现,0 表示未出现。
在本文中,我们将探讨一位有效编码的概念、其优势,以及如何使用 Pandas 和 Scikit-learn 等 Python 库进行实际实现。
如果您正在寻找机器学习的精选学习路径,请查看这条包含四门课程的路径:Python 机器学习基础。
一位有效编码是一种将分类变量转换为可供机器学习算法使用的格式的方法,以提升预测效果。它会为特征中的每个唯一类别创建新的二进制列。每列代表一个唯一类别,取值 1 或 0 分别指示该类别是否存在。
我们来看一个示例来说明一位有效编码如何工作。假设我们有一个包含单个分类特征 Color 的数据集,它可以取三个值:Red、Green 和 Blue。使用一位有效编码,我们可以将该特征转换如下:
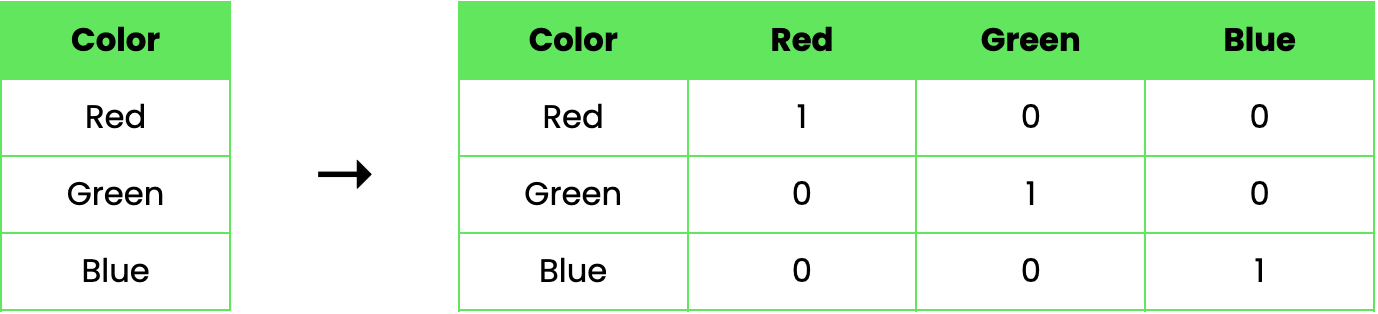
在这个示例中,原始的“Color”列被三个新的二进制列所取代,每列分别代表一种颜色。某行中值为 1 表示该颜色在该行出现,0 则表示未出现。
一位有效编码是数据预处理中的关键技术,原因有多方面。它将分类数据转换为机器学习模型易于理解和使用的格式。通过这种转换,每个类别都能被独立对待,而不会错误地暗示类别之间存在某种关系。
此外,许多数据处理和机器学习库都支持一位有效编码。它可以顺畅地融入数据预处理工作流,使得为各种机器学习算法准备数据集更加容易。
大多数机器学习算法需要数值输入来进行计算。分类数据需要被转换为数值格式,算法才能有效使用。一位有效编码提供了一种直接的方式来完成这种转换,确保分类变量能够整合进机器学习模型。
标签编码是另一种将分类数据转换为数值的方法,通过为每个类别分配一个唯一的数字。然而,这种方法可能会带来问题,因为它可能暗示类别之间存在并不存在的顺序或等级。
例如,给 Red 分配 1、给 Green 分配 2、给 Blue 分配 3,可能会让模型误以为 Green 大于 Red,而 Blue 又大于两者。这种误解会对模型性能产生负面影响。
一位有效编码通过为每个类别创建单独的二进制列来解决这个问题。这样,模型可以看到每个类别都是独立且彼此无关的。
当分类数据本身具有内在的顺序关系时,标签编码是有用的,也就是说类别具有有意义的先后或等级。在这种情况下,标签编码分配的数值可以有效表示这种顺序,因此是合适的选择。
考虑一个具有教育水平特征的数据集。类别包括:
High SchoolBachelor's DegreeMaster's DegreePhD这些类别有清晰的顺序,其中 PhD 表示高于 Master's Degree,而后者又高于 Bachelor's Degree,依此类推。在这种情况下,标签编码可以有效捕捉数据的有序性质:
在这个示例中,数值反映了教育水平的递进,因此标签编码是合适的选择。模型可以正确解读这些数值,理解数字越大表示教育程度越高。
既然我们已经理解了一位有效编码是什么以及其重要性,下面来看看如何在 Python 中实现它。
Python 提供了强大的库,如 Pandas 和 Scikit-learn,它们都支持以便捷高效的方式执行一位有效编码。
本节中,我们将逐步演示如何使用这些库应用一位有效编码。我们先从 Pandas 的 get_dummies() 函数开始,它适用于快速、简单的编码任务。然后,我们将探索 Scikit-learn 的 OneHotEncoder,它提供了更灵活的控制,特别适用于更复杂的编码需求。
get_dummies()Pandas 提供了一个非常方便的函数 get_dummies(),可直接从 DataFrame 创建一位有效编码的列。
以下是用法(我们会在下文逐步解释所有代码):
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red']}
df = pd.DataFrame(data)

# Applying one-hot encoding
df_encoded = pd.get_dummies(df, dtype=int)

# Displaying the encoded DataFrame
print(df_encoded)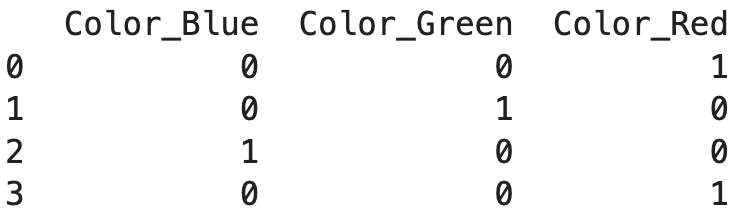
首先,我们导入 Pandas 库。然后创建一个字典 data,包含单个键 'Color',其值是颜色名称的列表。接着将该字典转换为 Pandas DataFrame df。该 DataFrame 如下所示:
   Color

0    Red

1  Green

2   Blue

3    Red
我们使用 pd.get_dummies() 对 DataFrame df 应用一位有效编码。该函数会自动检测分类列,并为每个唯一类别创建新的二进制列。参数 dtype=int 确保编码结果使用 1 和 0,而不是默认的布尔值。得到的 DataFrame df_encoded 如下:
       Color_Blue  Color_Green  Color_Red

0           0            0          1

1           0            1          0

2           1            0          0

3 0 0 1OneHotEncoder如果需要在编码过程中有更多灵活性和控制,Scikit-learn 提供了 OneHotEncoder 类。该类提供了高级选项,例如处理未知类别以及基于训练数据拟合编码器。
from sklearn.preprocessing import OneHotEncoder
import numpy as np

# Creating the encoder
enc = OneHotEncoder(handle_unknown='ignore')

# Sample data
X = [['Red'], ['Green'], ['Blue']]

# Fitting the encoder to the data
enc.fit(X)

# Transforming new data
result = enc.transform([['Red']]).toarray()

# Displaying the encoded result
print(result)
[[1. 0. 0.]]我们从 sklearn.preprocessing 导入 OneHotEncoder 类,并导入 numpy。随后创建一个 OneHotEncoder 实例。参数 handle_unknown='ignore' 告诉编码器在转换时忽略未知类别(即拟合过程中未见过的类别)。然后我们创建一个由列表构成的列表 X,每个内层列表包含一个颜色。这是我们用来拟合编码器的数据。
我们将编码器拟合在示例数据 X 上。在此步骤中,编码器会学习数据中的唯一类别。之后使用已拟合的编码器来转换新数据。在此例中,我们转换单个颜色 'Red'。.transform() 方法返回稀疏矩阵,我们用 .toarray() 方法将其转换为稠密数组。
结果 [[1. 0. 0.]] 表明 'Red' 出现(1),而 'Green' 和 'Blue' 未出现(0)。
一位有效编码的一个重要挑战是“维度灾难”。当某个分类特征具有大量唯一取值时,会导致列数激增。这样会使数据集变得稀疏,并显著增加计算成本。下面我们看看可用于解决这一问题的技术。
特征哈希(也称哈希技巧)可以通过将类别哈希到固定数量的列中来降低维度。该方法在控制特征数量的同时保持效率。下面是一个示例:
from sklearn.feature_extraction import FeatureHasher
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red', 'Yellow']}
df = pd.DataFrame(data)

# Initialize FeatureHasher
hasher = FeatureHasher(n_features=3, input_type='string')

# Apply feature hashing
hashed_features = hasher.transform(df['Color'])
hashed_df = pd.DataFrame(hashed_features.toarray(), columns=['Feature1', 'Feature2', 'Feature3'])

# Display the hashed features DataFrame
print("Hashed Features DataFrame:")
print(hashed_df)
我们导入必要的库,包括来自 sklearn.feature_extraction 的 FeatureHasher 和 pandas。然后创建一个包含分类特征 'Color' 的 DataFrame。
我们以所需的输出特征数(n_features=3)初始化 FeatureHasher,并指定输入类型为 'string'。之后对 'Color' 列应用 transform 方法,并将得到的稀疏矩阵转换为稠密数组,再转为 DataFrame。最后打印包含哈希特征的 DataFrame。
在进行一位有效编码之后,可以应用诸如主成分分析(PCA)等技术,在尽量保留数据集中关键信息的同时减少维度数量。
PCA 可以将高维数据压缩到低维空间,使其更易于机器学习算法处理。
from sklearn.preprocessing import OneHotEncoder
from sklearn.decomposition import PCA
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red', 'Yellow']}
df = pd.DataFrame(data)

# Applying one-hot encoding
encoder = OneHotEncoder(sparse=False)
one_hot_encoded = encoder.fit_transform(df[['Color']])

# Creating a DataFrame with one-hot encoded columns
# Check if get_feature_names_out is available
if hasattr(encoder, 'get_feature_names_out'):
    feature_names = encoder.get_feature_names_out(['Color'])
else:
    feature_names = [f'Color_{cat}' for cat in encoder.categories_[0]]
df_encoded = pd.DataFrame(one_hot_encoded, columns=feature_names)

# Initialize PCA
pca = PCA(n_components=2)  # Adjust the number of components based on your needs

# Apply PCA
pca_transformed = pca.fit_transform(df_encoded)

# Creating a DataFrame with PCA components
df_pca = pd.DataFrame(pca_transformed, columns=['PCA1', 'PCA2'])

# Display the PCA-transformed DataFrame
print("PCA-Transformed DataFrame:")
print(df_pca)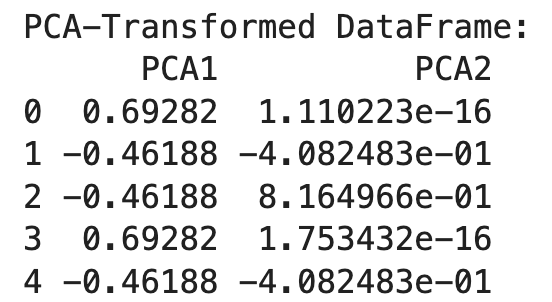
我们使用 OneHotEncoder 将分类特征转换为一位有效编码格式。结果是一个包含每个类别二进制列的 DataFrame。
随后,我们以所需主成分数量(n_components=2)初始化 PCA,并将其应用于一位有效编码后的数据。结果是一个包含两个主成分的转换后 DataFrame。
PCA 有助于降低一位有效编码数据的维度,使其在保留关键信息的同时更易管理。该方法在处理由于一位有效编码带来的高维数据时尤其有用。
尽管一位有效编码很强大,但不当实现可能导致多重共线性或在处理新数据时效率低下。下面我们来看一些最佳实践与注意事项。
在部署机器学习模型时,测试集中出现训练集中未出现的类别是很常见的。Scikit-learn 的 OneHotEncoder 可以通过忽略这些类别或将其分配至专用列来处理未知类别,从而确保模型仍能有效处理新数据。
下面的示例演示了如何在训练数据上拟合编码器,然后转换训练和测试数据(包括那些训练集中未出现的类别)。
from sklearn.preprocessing import OneHotEncoder
import numpy as np

# Training data
X_train = [['Red'], ['Green'], ['Blue']]

# Creating the encoder with handle_unknown='ignore'
enc = OneHotEncoder(handle_unknown='ignore')

# Fitting the encoder to the training data
enc.fit(X_train)

# Transforming the training data
X_train_encoded = enc.transform(X_train).toarray()
print("Encoded training data:")
print(X_train_encoded)

# Test data with an unknown category 'Yellow'
X_test = [['Red'], ['Yellow'], ['Blue']]

# Transforming the test data
X_test_encoded = enc.transform(X_test).toarray()
print("Encoded test data:")
print(X_test_encoded)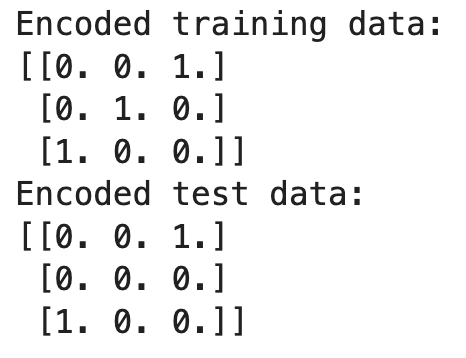
在此示例中,编码器在训练数据上拟合,学习到的类别为 'Red'、'Green' 和 'Blue'。当转换测试数据时,它遇到了训练中未见过的 'Yellow'。由于我们设置了 handle_unknown='ignore',编码器会为 'Yellow' 生成一行全 0,从而有效地忽略该未知类别。
通过这种方式处理未知类别,可以确保您的模型在包含未见类别的新数据上仍能有效运行。
应用一位有效编码后,务必从数据集中删除原始的分类列。保留原始列可能导致多重共线性,即冗余信息影响模型性能。确保每个类别在数据集中只被表示一次,以保持数据完整性。
以下示例展示了如何在应用一位有效编码后删除原始分类列,以避免多重共线性并确保每个类别仅表示一次。
import pandas as pd

# Sample data
data = {'Color': ['Red', 'Green', 'Blue', 'Red']}
df = pd.DataFrame(data)

# Applying one-hot encoding
df_encoded = pd.get_dummies(df, columns=['Color'])

# Displaying the encoded DataFrame
print("Encoded DataFrame:")
print(df_encoded)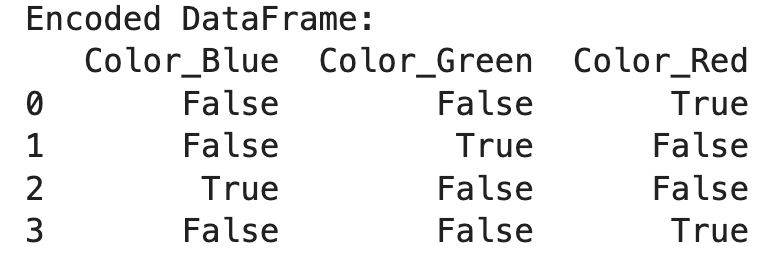
在该示例中,我们从包含分类列 'Color' 的 DataFrame 开始。我们使用 pd.get_dummies() 对 'Color' 列应用一位有效编码,并通过指定 columns=['Color'] 来指明要编码的列。这会自动删除原始的 'Color' 列,并用一位有效编码的列替代。得到的 DataFrame df_encoded 现在包含代表每个唯一类别的二进制列,确保每个类别只被表示一次,消除了多重共线性的风险。
删除原始分类列有助于维护数据集的完整性,并提升机器学习模型的性能。
OneHotEncoder 与 get_dummies() 的对比在 Pandas 的 get_dummies() 与 Scikit-learn 的 OneHotEncoder 之间进行选择取决于您的需求。对于快速、简单的编码任务,get_dummies() 方便易用。对于需要更高控制与灵活性的复杂场景,例如处理未知类别或基于特定数据拟合编码器,OneHotEncoder 更为合适。
一位有效编码是一种强大且必不可少的技术,可将分类数据转换为适用于机器学习算法的数值格式。它通过避免人为引入顺序性、促进分类数据的使用,从而提升机器学习模型的准确性与效率。
在 Python 中实现一位有效编码非常直接,您可以使用 Pandas 的 get_dummies() 和 Scikit-learn 的 OneHotEncoder。请记得考虑数据的维度问题,并有效处理未知类别。
如果您想进一步学习该主题,请查看这门关于预处理的课程:Python 机器学习中的数据预处理。