Ga naar hoofdinhoud

Cardinaliteit begrijpen: uitdagingen en oplossingen voor data-intensieve workflows

Ontdek wat cardinaliteit betekent en hoe het de gegevensverwerking, analyse en machine learning beïnvloedt. Leer praktische strategieën en technieken om hoge cardinaliteit te beheren, van datapreprocessing tot geavanceerde optimalisatietools.
Bijgewerkt 2 okt 2026  · 8 min lezen

Verken met AI

ChatGPTClaudePerplexity

Ik kwam het concept cardinaliteit voor het eerst tegen in een college Kwantummechanica, tijdens mijn studie Natuurkunde. In dat vak verwees cardinaliteit naar de grootte van een verzameling, eindig of oneindig, gekoppeld aan abstracte begrippen als telbaarheid en oneindigheden. Toen ik overstapte naar software engineering, besefte ik dat cardinaliteit voor een data engineer of -scientist een veel praktischere betekenis heeft: de onderscheidendheid van waarden in een dataset.

In een van mijn eerste projecten met real-world data leerde ik hoe uitdagend hoge cardinaliteit kan zijn. Het vertraagde mijn databasequeries tot een slakkengang en veranderde wat heldere inzichten hadden moeten zijn in een verwarrende brei. Sindsdien heb ik praktijkervaring opgedaan en deze gids samengesteld in de hoop anderen in dezelfde situatie te helpen. Je bent hier op de juiste plek als je wilt leren wat hoge cardinaliteit is, welke uitdagingen het met zich meebrengt en hoe je die in de praktijk effectief temt!

Wat is cardinaliteit, en wat is hoge cardinaliteit?

De begrippen cardinaliteit en hoge cardinaliteit kunnen wat abstract klinken, dus laten we ze ontleden.

Definitie en voorbeelden

Cardinaliteit verwijst naar het aantal unieke waarden in een kolom van een dataset. Een kolom met hoge cardinaliteit bevat enorm veel unieke waarden, terwijl kolommen met lage cardinaliteit minder verschillende waarden bevatten.

Hoge cardinaliteit komt vooral vaak voor in datasets met unieke identificatoren, zoals:

  • Tijdstempels: Bij logging op milliseconde- of nanosecondenniveau is vrijwel elke waarde uniek.
  • Klant-ID's: Elke klant heeft een eigen identificator om zijn of haar activiteit te volgen.
  • Transactie-ID's: Financiële datasets bevatten vaak een unieke code voor elke transactie.

Deze unieke waarden zijn belangrijk voor het volgen, aggregeren of personaliseren van data. Maar hun enorme aantal kan grote uitdagingen opleveren voor opslag, prestaties en visualisatie, waar we zo naar kijken.

Veelvoorkomende praktijkgevallen

Hoge cardinaliteit kan in elke sector en industrie voorkomen. Ik heb hieronder een paar voorbeelden op een rij gezet om je te helpen begrijpen wat hoge cardinaliteit in praktische termen betekent.

E-commerce en klantdata

E-commerceplatforms genereren dagelijks enorme hoeveelheden data met hoge cardinaliteit:

  • Klant-ID's: Elke gebruiker krijgt een unieke identificator om gedrag, aankopen en voorkeuren te volgen.
  • Sessie-ID's: Elke browsersessie wordt uniek gelogd, wat leidt tot veel verschillende waarden in sessietracking-datasets.
  • Product-SKU's: Stock Keeping Units zijn uniek voor elke productvariant en zorgen voor een kolom met hoge cardinaliteit in voorraad- en verkoopdata.

Deze datasets zijn essentieel om gebruikersgedrag te begrijpen, voorraad te volgen en verkoopstrategieën te optimaliseren, maar het enorme aantal unieke items maakt de analyse vaak complex.

Zorg en patiëntendossiers

In de zorg leidt de behoefte aan nauwkeurige tracking en identificatie vanzelf tot data met hoge cardinaliteit. Zo vinden we bijvoorbeeld:

  • Patiënt-ID's: Elke patiënt heeft een unieke identificator voor nauwkeurige en veilige dossiervorming.
  • Afsprakentijdstempels: Voor elke patiëntinteractie, van doktersbezoek tot labtest, kan een unieke tijdstempel worden aangemaakt.
  • Verzekeringsschadenummers: Elke claim die door verzekeraars wordt verwerkt, krijgt een aparte code voor administratie en audit.

Deze data is nodig om patiëntgeschiedenissen bij te houden en te voldoen aan privacyregels.

IoT-sensoren en streamingdata

De opkomst van IoT-apparaten heeft een golf aan datasets met hoge cardinaliteit veroorzaakt:

  • Sensor-ID's: Elk IoT-apparaat heeft een unieke identificator om activiteit en locatie te volgen.
  • Tijdstempeldata: Continue datastromen loggen vaak gebeurtenissen op milliseconde- of nanosecondenintervallen, met vrijwel uitsluitend unieke waarden tot gevolg.
  • Event-ID's: Elke geregistreerde gebeurtenis in een systeem, van temperatuuruitlezingen tot bewegingsdetecties, krijgt een unieke identificator.

In IoT ontstaat hoge cardinaliteit door de noodzaak om fijnmazige, realtime data van talloze apparaten te verwerken. Dit is cruciaal voor analytics en monitoring, maar lastig om efficiënt op te slaan en te bevragen – later meer!

Uitdagingen van hoge cardinaliteit

Hoge cardinaliteit brengt verschillende uitdagingen met zich mee binnen gegevensverwerking, engineering, analyse en machine learning. Datasets met hoge cardinaliteit bieden een schat aan nuttige informatie, maar kunnen vaak een bottleneck vormen en prestaties, uitlegbaarheid en schaalbaarheid belemmeren.

Problemen met dataopslag en prestaties

Een van de grootste uitdagingen van hoge cardinaliteit is de impact op opslag en systeemprestaties.

  • Opslagoverhead: Kolommen met hoge cardinaliteit, zoals unieke identifiers of tijdstempels, resulteren in grotere datasets. Het loggen van miljoenen gebruikersinteracties op een e-commerceplatform zorgt bijvoorbeeld voor enorme opslagoverhead door de uniciteit van sessie-ID's of transactietijdstempels.
  • Lagere queryprestaties: Bij het bevragen van kolommen met hoge cardinaliteit hebben databases moeite met de toegenomen complexiteit van indexeren en scannen. Queries die filteren of joinen op zulke kolommen duren vaak langer, omdat de database door een enorme hoeveelheid verschillende waarden moet heenzoeken.
  • Indexeringsuitdagingen: Indexen, essentieel om databasequeries te versnellen, worden opgeblazen en minder efficiënt bij kolommen met hoge cardinaliteit. Dit kan leiden tot tragere lookups en slechtere prestaties.

Neem als voorbeeld een database met IoT-sensordata met unieke sensor-ID's en precieze tijdstempels. Queries die filteren op een specifieke sensor en tijdsinterval kunnen de database dwingen miljoenen unieke items te verwerken, met super trage responstijden en resource-intensieve operaties tot gevolg.

Moeilijkheden bij datavisualisatie

De uitdaging hier is om een groot aantal verschillende waarden begrijpelijk en betekenisvol te presenteren. Zonder zorgvuldige aanpak kan data met hoge cardinaliteit inzichten eerder verbergen dan onthullen.

Een goed voorbeeld is het taartdiagram hieronder. De legenda en waarden zijn onleesbaar omdat er te veel unieke items (staten) zijn voor dit type grafiek. Soms helpt het om het type grafiek te veranderen, maar niet altijd. 
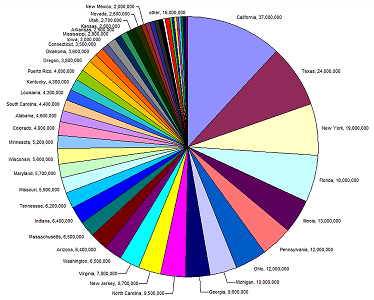
Onleesbaar taartdiagram met een segment en waarde voor elke Amerikaanse staat.

Bron: European Environment Agency

Stel je een staafdiagram voor dat de activiteit van klanten op een e-commerceplatform per sessie-ID weergeeft. Met duizenden of miljoenen unieke ID's wordt de grafiek een brij van onleesbare staven, en het veranderen van het type grafiek zal hier waarschijnlijk weinig aan veranderen. 

Oké, waarom aggregeren we de data dan niet gewoon om patronen en verbanden uit onze grafieken te halen? Dat kan, maar het moet zorgvuldig gebeuren. Het aggregeren van data met hoge cardinaliteit kan ertoe leiden dat we de detaillering verliezen die nodig is voor inzichten. Het groeperen van IoT-data op locatie kan bijvoorbeeld subtiele maar cruciale variaties op sensorniveau verdoezelen. De technieken om dit te verhelpen kunnen subtiel zijn. Ik raad onze cursus Intermediate Data Modeling in Power BI aan om hands-on te oefenen met one-to-one- en one-to-many-relaties. 

Relevantie voor machine learning

Hoge cardinaliteit kan aanzienlijke uitdagingen vormen in machine learning, met name bij feature engineering, modelcomplexiteit en uitlegbaarheid. ML-modellen gedijen bij gestructureerde en betekenisvolle input, maar features met hoge cardinaliteit verstoren dat evenwicht vaak, met complicaties tot gevolg:

  • Meer schaarste (sparsity): Features met hoge cardinaliteit resulteren vaak in schaarse datasets. One-hot encoding van een categorische feature met hoge cardinaliteit, zoals postcodes, creëert bijvoorbeeld een matrix met een enorm aantal dimensies, waarvan de meeste leegh zijn. Deze schaarste maakt het voor modellen, vooral afstandsgebaseerde zoals k-nearest neighbors of clusteringsalgoritmen, lastiger om betekenisvolle relaties in de data te vinden.
  • Overfittingrisico's: Features met hoge cardinaliteit kunnen leiden tot overfitting in modellen die data opsplitsen in zeer fijne categorieën, zoals decision trees of random forests. Als elke categorie door slechts enkele voorbeelden wordt vertegenwoordigd, kan het model ruis leren in plaats van echte patronen, met slechte generalisatie naar nieuwe data tot gevolg.

In e-commerce kan een ML-model dat klantverloop voorspelt bijvoorbeeld een feature met hoge cardinaliteit bevatten zoals "user ID" of "product ID". Als dat niet goed wordt beheerd, kan het model overfitten op specifieke klanten of producten in de trainingsdata. Daardoor werkt het slechter voor nieuwe gebruikers, omdat het patronen leert die uniek zijn voor de trainingsset in plaats van generaliseerbare trends.

Strategieën om hoge cardinaliteit te beheren

Hoge cardinaliteit effectief beheren vereist een mix van domeinspecifieke strategieën en algemene optimalisatietechnieken voor data. Deze aanpakken verbeteren niet alleen de systeemprestaties, maar maken data ook beter te interpreteren en toe te passen.

Technologie en tools benutten

Gelukkig zijn de uitdagingen van datasets met hoge cardinaliteit zo wijdverbreid dat er allerlei technieken en tools zijn ontwikkeld en verfijnd om ze aan te pakken.

Databaseoptimalisatie

Het beheren van hoge cardinaliteit in databases begint vaak met het optimaliseren van opslag en queries, verder dan alleen duplicaten verwijderen. De meest gebruikte technieken zijn:

  • Bucketing (of binning): Het groeperen van data met hoge cardinaliteit in bredere categorieën om het aantal unieke waarden te verminderen. Bijvoorbeeld: postcodes groeperen per regio in plaats van elk afzonderlijk op te slaan.
  • Partitionering: Tabellen structureren met partities op basis van vaak bevraagde velden. Bijvoorbeeld: klantdata partitioneren per land kan queryprestaties verbeteren in geografisch verspreide systemen.
  • Indexering: Het gebruik van indexen die specifiek zijn ontworpen voor velden met hoge cardinaliteit, zoals bitmap- of samengestelde indexen, kan de querysnelheid verbeteren met behoud van opslag-efficiëntie.

Gespecialiseerde software

Als je met extreem hoge cardinaliteit te maken hebt, zijn er gespecialiseerde tools en platforms die kunnen helpen:

  • Kolomgeoriënteerde databases: Deze databases, zoals Apache Parquet of Amazon Redshift, zijn ontworpen voor analytische queries en kunnen kolommen met hoge cardinaliteit efficiënt opslaan en verwerken.
  • NoSQL-databases: In sommige gevallen kunnen NoSQL-databases zoals MongoDB of Elasticsearch beter omgaan met de variabiliteit en omvang van datasets met hoge cardinaliteit, zeker in combinatie met schema-loze ontwerpen.
  • Time series-databases: Voor datasets die worden gedomineerd door tijdstempels en events, zoals IoT-sensordata of beurstransacties, zijn time series-databases zoals InfluxDB of TimescaleDB super handig. Ze zijn specifiek geoptimaliseerd om dimensies met hoge cardinaliteit efficiënt op te slaan en gebruiken geavanceerde compressietechnieken om opslagkosten te minimaliseren met behoud van hoge prestaties. Ik heb aan een paar projecten gewerkt met enorme hoeveelheden IoT-data, en time series-databases maakten een groot verschil bij het afleiden van trends en voorspellingen. Ik schreef deze gids over time series-databases als je hier meer over wilt leren! 
  • Data-profilingtools: Tools zoals Talend, OpenRefine of zelfs aangepaste Python-scripts kunnen snel velden met hoge cardinaliteit identificeren en helpen bij het bepalen van de beste preprocessing- of opslagstrategie.

Technieken voor datapreprocessing

Preprocessing in data science en machine learning verwijst naar de stappen om ruwe data schoon te maken, te transformeren en te organiseren tot een geschikt formaat voor analyse of modellering.

Het is best een stevig onderwerp en als je weinig tot geen kennis hebt van data engineering of data science, kan de informatie in deze sectie wat lastig zijn om te volgen. Toch heb ik relevante links en voorbeelden opgenomen om je op weg te helpen!

Datapreprocessing is een essentiële stap bij het beheren van hoge cardinaliteit, omdat het de complexiteit vermindert, prestaties verbetert en ervoor zorgt dat de datakwaliteit voldoende is voor analyse of ML-taken. Door ruwe data om te zetten in beter hanteerbare vormen kunnen we uitdagingen als schaarste, inefficiënte opslag en rekenkundige bottlenecks aanpakken.

Dimensiereductie

Technieken voor dimensiereductie zijn bijzonder waardevol wanneer hoge cardinaliteit resulteert in datasets met talloze features of schaarse matrices. Deze methoden comprimeren data tot minder dimensies, terwijl cruciale informatie behouden blijft.

Principal Component Analysis (PCA)

Stel, je hebt een dataset met e-commerceklantgedrag, met veel features zoals het aantal keren dat een klant een product heeft bekeken, interacties met verschillende productcategorieën, tijd op de website, enzovoort. Elk van deze features kan een hoge cardinaliteit hebben, zeker als je een groot aantal producten volgt. PCA kan worden gebruikt om deze features te combineren tot minder componenten die nog steeds de belangrijkste patronen in de data vangen, zoals algemene klantbetrokkenheid of interesse in bepaalde producttypen. Zie het als de Marie Kondo van data: het houdt de features die vreugde brengen en doet zachtjes de rest weg!

t-SNE en UMAP

t-SNE en UMAP zijn technieken die vooral nuttig zijn om hoog-dimensionale data te visualiseren door deze naar twee of drie dimensies te projecteren met behoud van de structuur. In datasets met medische dossiers kan UMAP bijvoorbeeld helpen door patiënten met vergelijkbare aandoeningen of behandeltrajecten te groeperen. Dit helpt trends te spotten, zoals veelvoorkomende comorbiditeiten of behandeluitkomsten.

Featureselectie

Als je een ML-model bouwt om de verkoopprestaties voor een e-commerceplatform te voorspellen en je dataset bevat features zoals het aantal keren dat een klant op een advertentie heeft geklikt, het aantal bekeken producten en het aantal dagen sinds de laatste aankoop, zul je merken dat veel van deze features met elkaar correleren, wat voor hoge cardinaliteit en redundantie zorgt. 

Met featureselectietechnieken zoals mutual information of recursive feature elimination kun je bepalen welke features de meeste voorspellende kracht hebben (bijv. "tijd sinds laatste aankoop" kan belangrijker zijn dan "klikken op advertentie") en de irrelevante weglaten, wat je modelprestaties uiteindelijk verbetert.

Als je meer over dit onderwerp wilt leren, probeer dan de cursus Preprocessing for Machine Learning. Je gebruikt Python om je data schoon te maken en voor te bereiden voordat je deze aan je modellen voert.

Encoderingsmethoden

Encodering is een cruciale preprocessingstap voor het omgaan met categorische data, vooral bij features met hoge cardinaliteit. De keuze voor een methode hangt af van de usecase en de mate van cardinaliteit in de dataset.

  • One-hot encoding: One-hot encoding maakt een binaire kolom voor elke unieke categorie in een dataset. Hoewel simpel en effectief voor lage cardinaliteit, kan dit leiden tot extreem schaarse matrices bij features met hoge cardinaliteit. Het encoderen van 1.000 unieke postcodes levert bijvoorbeeld 1.000 binaire kolommen op, wat geheugen en rekenkracht kan overbelasten. Geloof me, dat heb ik op de harde manier geleerd…
  • Target encoding (mean encoding): Bij deze methode worden categorische waarden vervangen door het gemiddelde van de doelvariabele voor elke categorie. Als je bijvoorbeeld klantverloop voorspelt, kan target encoding elke postcode vervangen door het gemiddelde verlooppercentage in dat gebied. Deze aanpak vermindert de dimensionaliteit, maar kan bias introduceren en vereist zorgvuldige validatie om datalekken te voorkomen.
  • Frequentie-encoding: Frequentie-encoding kent de frequentie van een categorie als waarde toe, waardoor het aantal verschillende waarden afneemt. In een e-commercedataset kun je product-ID's bijvoorbeeld vervangen door hun aankoopfrequentie. Deze techniek is zuinig met resources en correleert vaak met de belangrijkheid van de feature.
  • Hashing-encoding: Hashing-encoding mapt categorieën naar gehele getallen met een hashfunctie, waardoor sommige categorieën worden samengevoegd. Deze methode is geheugenefficiënt en werkt goed voor streamingdata of extreem hoge cardinaliteit, maar introduceert het risico op hash-collisions. Vroeg je je weleens af waarom je webwinkel babyvoeding aanraadt terwijl je zocht naar motorolie? Dat zijn hash-collisions voor je.
  • Embedding-lagen: Voor ML-modellen zoals neurale netwerken kunnen embedding-lagen categorische features met hoge cardinaliteit omzetten in dichte, laag-dimensionale representaties. Deze aanpak wordt veel gebruikt in aanbevelingssystemen, bijvoorbeeld voor het encoderen van miljoenen product-ID's of user ID's op e-commerceplatforms.

Conclusie

Datasets met hoge cardinaliteit kunnen soms overweldigend aanvoelen, en het kan zeker een uitdaging zijn om er waardevolle inzichten uit te halen. De volgende keer dat je een dataset met hoge cardinaliteit tegenkomt, onthoud dan dat het niet de schuld van de data is – ze zit gewoon vol potentieel dat ontsloten wil worden. Of het nu via dimensiereductie is, slimme encoderingstechnieken of tools zoals time series-databases, je kunt je datasets effectief beheren en omtoveren tot superkrachtige assets.

En nu je in theorie weet hoe je met data met hoge cardinaliteit werkt, is het tijd voor de praktijk:

  • Ga hands-on aan de slag met dimensiereductie en encoderingstechnieken – begin klein en bouw uit. Onze cursus Dimensionality Reduction in Python is een aanrader.
  • Test enkele van de hier genoemde tools (ja, time series-databases zijn net zo cool als ze klinken!).

En het allerbelangrijkste: omarm de uitdaging. Hoge cardinaliteit is lastig, maar ook een kans om veel te leren over data engineering en analyse!


Marie Fayard's photo
Author
Marie Fayard

Ik ben een productgerichte tech lead die gespecialiseerd is in het laten groeien van startups in een vroeg stadium, van het eerste prototype tot product‑market fit en verder. Ik ben eindeloos nieuwsgierig naar hoe mensen technologie gebruiken, en ik werk graag nauw samen met oprichters en multidisciplinaire teams om gedurfde ideeën tot leven te brengen. Als ik geen producten bouw, zoek ik inspiratie in nieuwe uithoeken van de wereld of ontspan ik me in de yogastudio.

FAQs

Hoe kan ik hoge cardinaliteit in mijn eigen datasets herkennen?

Je kunt hoge cardinaliteit herkennen door te controleren op kolommen met een groot aantal unieke waarden ten opzichte van het aantal rijen. In een klantdataset heeft een kolom als "customer ID" bijvoorbeeld waarschijnlijk een hoge cardinaliteit omdat elke invoer uniek is. Tools zoals pandas in Python kunnen je makkelijk helpen het aantal unieke waarden in een kolom te controleren met commando's als df['column_name'].nunique().

Wat zijn enkele gevolgen in de praktijk als hoge cardinaliteit in data-analyse wordt genegeerd?

Het negeren van hoge cardinaliteit kan tot verschillende problemen leiden, waaronder prestatie-issues (tragere querytijden), moeite om de data te begrijpen (te complexe visualisaties) en problemen in ML-modellen (overfitting of inefficiënte training). Zonder hoge cardinaliteit aan te pakken kan je data-analyse rommelig, onnauwkeurig of simpelweg onhanteerbaar worden.

Kan hoge cardinaliteit ooit voordelig zijn in data-analyse, of moet je het vermijden?

Hoewel hoge cardinaliteit vaak als een uitdaging wordt gezien, kan het in bepaalde contexten waardevolle informatie bieden. In aanbevelingssystemen helpen features met hoge cardinaliteit (zoals user ID of product ID) bijvoorbeeld om aanbevelingen te personaliseren. Het is echter belangrijk om zorgvuldig te beheren hoe deze features in modellen worden gebruikt om overfitting en prestatieverlies te voorkomen.

Is hoge cardinaliteit meer een probleem in gestructureerde of ongestructureerde data?

Hoge cardinaliteit kan een probleem zijn in zowel gestructureerde als ongestructureerde data, maar is doorgaans uitdagender in gestructureerde datasets (bijv. relationele databases) waar cardinaliteit vaak is gekoppeld aan specifieke kolommen zoals identifiers of tijdstempels. In ongestructureerde data, zoals tekst of beeld, kan cardinaliteit subtieler spelen, bijvoorbeeld door te veel unieke woorden of pixels, wat de verwerking complexer maakt.

Onderwerpen
Data Science
Data-engineering

Leer met DataCamp

{count, plural, one {Cursus} other {Cursussen}}

Gevorderd gegevensmodelleren in Power BI

{hours} uur
60.9K
Beheers datamodellering in Power BI.
Bekijk detailsRight Arrow
Start Cursus
Meer bekijkenRight Arrow
Gerelateerd

{count, plural, one {blog} other {blogs}}

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer BekijkenMeer Bekijken

