Databricks SQL è uno strumento potente progettato per la gestione e l’analisi dei dati all’interno della piattaforma Databricks Lakehouse. Questa piattaforma integra data engineering, data science e business analytics in un’esperienza unificata. Per questo, Databricks SQL è importante per i professionisti dei dati che vogliono snellire i flussi di lavoro, l’esecuzione delle query e i compiti di BI senza la complessità della gestione dell’infrastruttura tradizionale.
In questo articolo esplorerò i componenti, le funzionalità e gli strumenti di Databricks SQL e mostrerò esempi pratici di creazione e utilizzo di un warehouse Databricks SQL. Per iniziare, ti consiglio vivamente il corso di DataCamp Introduction to Databricks per scoprire Databricks come soluzione di data warehousing per la Business Intelligence (BI), sfruttando le capacità ottimizzate per SQL per creare query e analizzare i dati.
Cos’è Databricks SQL?
Databricks SQL è un solido strumento di analytics all’interno della piattaforma Databricks Lakehouse che consente ai professionisti dei dati di eseguire query SQL, analizzare i dati e creare dashboard interattive. Progettato con un’architettura serverless, Databricks SQL combina la flessibilità dei data lake con le capacità di governance e performance dei data warehouse.
I componenti chiave di Databricks SQL includono SQL Warehouses, SQL Editor e SQL Dashboards. Non preoccuparti se non conosci ciascuno di questi: più avanti ne spiegherò il significato.
Databricks SQL vs. SQL Server e altri
A differenza di altri dialetti SQL come MySQL, PostgreSQL o SQL Server, pensati per database transazionali, Databricks SQL è ottimizzato per analytics su larga scala in un ambiente Lakehouse. I database SQL tradizionali si concentrano sull’archiviazione di dati strutturati, mentre Databricks SQL si integra con i data lake preservando al contempo le performance di un data warehouse. Con i SQL warehouse serverless non c’è bisogno di gestire l’infrastruttura, perché le risorse vengono fornite automaticamente e scalano in modo elastico.
Inoltre, va detto che in Databricks SQL l’esecuzione delle query è più veloce grazie al motore Photon, che supporta l’elaborazione vettorializzata. Ultima cosa: Databricks SQL è pensato per la BI e la collaborazione; offre supporto nativo per Power BI, Tableau e Looker.
Componenti fondamentali di Databricks SQL
I componenti principali di Databricks SQL facilitano query efficienti, visualizzazione dei dati e collaborazione tra gli utenti. Di seguito trovi una panoramica degli strumenti e delle funzionalità principali disponibili in Databricks SQL.
SQL Warehouses
Gli SQL Warehouses sono le risorse computazionali per eseguire query SQL in Databricks SQL. Sono progettati per gestire carichi di lavoro variabili e offrono ottimizzazioni delle prestazioni in base al tipo di warehouse selezionato. Esistono tre tipologie principali di SQL Warehouses:
- Classic: supporta funzionalità di base ed è adatto a prestazioni iniziali. Utilizza il livello di calcolo esistente nel tuo account cloud ma non include funzionalità avanzate come Intelligent Workload Management (IWM) e Predictive IO.
- Pro: offre prestazioni migliorate con supporto per Photon, un motore di query vettorializzato che velocizza le operazioni SQL e migliora le opzioni di sicurezza.
- Serverless elimina la gestione dell’infrastruttura effettuando il provisioning automatico delle risorse, scalando elasticamente e garantendo un’esecuzione delle query a bassa latenza. Sono ideali per ambienti con carichi fluttuanti e offrono prestazioni convenienti in termini di costi.
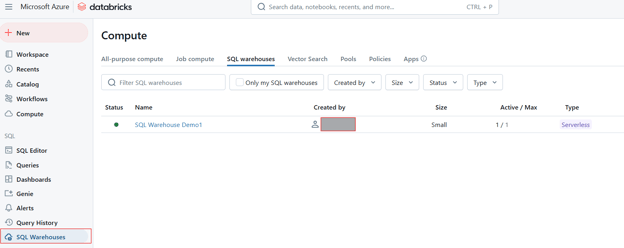
SQL Warehouse in Databricks SQL. Immagine dell’autore.
SQL Editor
Il SQL Editor è un’interfaccia intuitiva che permette di scrivere, eseguire e gestire query SQL. Le funzionalità principali includono:
- Query intuitive: supporto per evidenziazione della sintassi, completamento automatico e rilevamento degli errori per una scrittura efficiente.
- Anteprima dei dati: puoi visualizzare in anteprima i dati direttamente nell’editor, facilitando la comprensione dei dataset prima di eseguire query complesse.
- Caching dei risultati delle query: migliora le prestazioni memorizzando i risultati precedenti, permettendo tempi di risposta più rapidi per query ripetute.
- Query parametrizzate: puoi creare query dinamiche incorporando parametri, semplificando l’esecuzione di query simili con valori diversi.
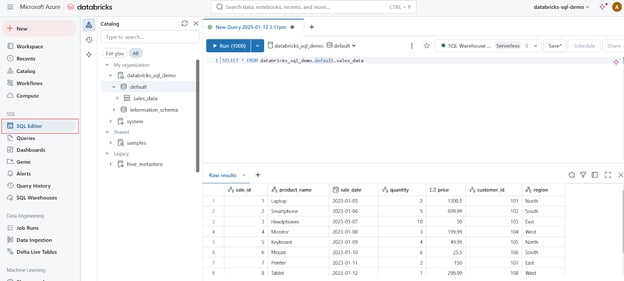
SQL Editor in Databricks SQL. Immagine dell’autore.
Dashboard
I dashboard consentono la visualizzazione dei dati trasformando i risultati delle query in grafici, diagrammi e widget interattivi. Sono ideali per monitorare metriche chiave e comunicare insight in modo efficace in tutta l’organizzazione. Le principali capacità includono:
- Analytics in tempo reale: aggiornamento automatico dei dashboard in base ai risultati live delle query.
- Collaborazione: condivisione dei dashboard tra i team per promuovere decisioni data-driven.
- Personalizzazione: ampia scelta di tipologie di visualizzazione e opzioni di layout per esigenze specifiche.
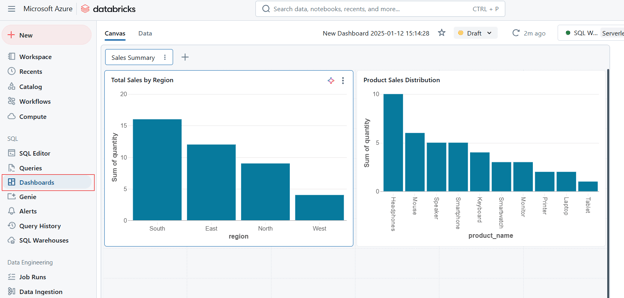
Dashboard in Databricks SQL. Immagine dell’autore.
Avvisi
Gli avvisi in Databricks SQL permettono di monitorare i cambiamenti dei dati e attivare notifiche quando si verificano condizioni specifiche. Sono essenziali per mantenere la qualità dei dati e assicurare risposte tempestive a cambiamenti importanti. Il funzionamento è il seguente.
- Definizione delle condizioni: imposta soglie o regole basate sui risultati delle query.
- Attivazione delle notifiche: ricevi avvisi via email, Slack o altre integrazioni quando le condizioni sono soddisfatte.
- Monitoraggio proattivo: rimani informato su eventi critici, come anomalie nei dati o problemi di sistema, in tempo reale.
Cronologia e profiling delle query
Infine, vale la pena dire che Databricks SQL offre strumenti per tracciare la cronologia e il profiling delle query:
- Cronologia delle query: consente di rivedere le query eseguite in precedenza, fornendo insight sulle loro performance nel tempo. Aiuta a individuare tendenze o problemi ricorrenti.
- Profiling delle query: gli strumenti di profiling analizzano l’efficienza delle query eseguite, evidenziando colli di bottiglia e suggerendo ottimizzazioni. Questa capacità è importante per migliorare le prestazioni complessive e l’utilizzo delle risorse.
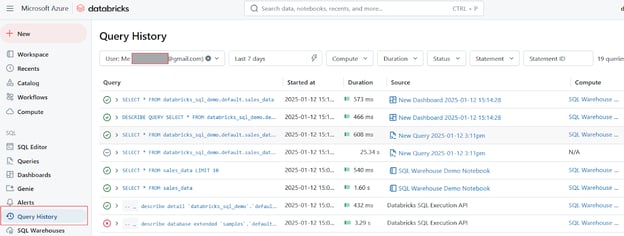
Cronologia delle query in Databricks SQL. Immagine dell’autore.
Funzionalità e strumenti chiave in Databricks SQL
Databricks SQL è ricco di funzionalità e strumenti avanzati. Queste caratteristiche sono pensate per migliorare le prestazioni, semplificare i flussi di lavoro e consentire un’integrazione senza soluzione di continuità con altri strumenti. Vediamo alcuni degli aspetti che rendono Databricks SQL una scelta eccellente.
Photon Engine
Photon Engine è un motore di query vettorializzato ad alte prestazioni sviluppato da Databricks per accelerare in modo significativo l’esecuzione delle query SQL. I principali vantaggi includono:
- Esecuzione vettorializzata: a differenza dell’elaborazione riga per riga, Photon utilizza un’esecuzione vettorializzata che processa i dati in batch. Questo approccio gli consente di sfruttare istruzioni CPU avanzate come SIMD (Single Instruction, Multiple Data) per una maggiore efficienza.
- Integrazione con i carichi di lavoro esistenti: Photon è pienamente compatibile con le API di Apache Spark, quindi può essere attivato senza modificare il codice esistente. Questa integrazione senza attriti consente alle organizzazioni di beneficiare di prestazioni migliori senza dover rifattorizzare ampiamente.
- Caching e ottimizzazione: il motore include un ottimizzatore di query avanzato e un livello di caching che seleziona in modo intelligente quali dati memorizzare, migliorando ulteriormente le prestazioni.
CloudFetch e Async I/O
CloudFetch e Async I/O sono funzionalità progettate per aumentare la velocità di trasferimento dei dati e migliorare la gestione dei file piccoli durante l’esecuzione delle query. Funzionano così:
- CloudFetch: ottimizza la scrittura dei risultati nello storage cloud consentendo scritture parallele su tutti i nodi di calcolo. Riduce significativamente il tempo necessario per trasferire grandi dataset ai client, ottenendo fino a 10 volte le prestazioni in scenari reali.
- Async I/O: migliora la gestione dei file piccoli leggendo simultaneamente più blocchi di dati mentre elabora i blocchi correnti. Questo approccio può aumentare le prestazioni complessive fino a 12 volte quando si lavora con file piccoli (ad es. 1 MB). È particolarmente efficace in scenari con molti file piccoli o “dati freddi” non in cache.
Integrazione con strumenti BI
Databricks SQL si integra perfettamente con i più diffusi strumenti di Business Intelligence (BI), facilitando l’analisi e la visualizzazione dei dati da parte dei team. Le integrazioni supportate includono:
- Power BI: puoi connettere direttamente il tuo workspace Databricks a Power BI, semplificando la sincronizzazione dei modelli di dati. Ad esempio, gli analisti possono pubblicare report direttamente da Databricks in Power BI, mantenendo le relazioni definite tra le tabelle senza interventi manuali.
- Tableau: puoi sfruttare connessioni live per visualizzare i dati archiviati in Databricks SQL. Questa integrazione consente analytics in tempo reale e dashboard interattivi che riflettono gli aggiornamenti più recenti.
- dbt: Databricks SQL si integra anche con dbt (data build tool), consentendo ai team di gestire le trasformazioni direttamente nell’ambiente Databricks. Questa integrazione supporta modelli incrementali e viste materializzate, semplificando la costruzione e la manutenzione di pipeline dati robuste.
Architettura serverless
L’architettura serverless di Databricks SQL elimina la necessità di gestire manualmente l’infrastruttura effettuando automaticamente il provisioning e la scalabilità delle risorse in base alla domanda. L’architettura serverless regola automaticamente le risorse per gestire carichi di query variabili senza downtime. Ciò garantisce che non sia necessario configurare o mantenere manualmente i cluster. È anche conveniente dal punto di vista dei costi, perché paghi solo le risorse utilizzate durante l’esecuzione delle query.
Per esempio, una società retail registra carichi elevati di query nelle ore di punta. L’architettura serverless scala automaticamente le risorse per mantenere prestazioni costanti e riduce la scala nelle ore di minor traffico per risparmiare sui costi.
Guida passo passo per creare e utilizzare i Databricks SQL Warehouses
I Databricks SQL Warehouses sono essenziali per eseguire query SQL in modo efficiente nell’ambiente Databricks. In questa sezione ti guiderò nella creazione di un SQL warehouse e nel suo utilizzo con i notebook. Se vuoi rinfrescare i concetti di data warehousing, ti consiglio il nostro corso Data Warehousing Concepts per imparare le basi del data modeling e della trasformazione dei dati.
Creare un Databricks SQL Warehouse
Segui questi passaggi per creare un SQL Warehouse usando la web UI di Databricks:
Passaggio 1: vai alla pagina Databricks SQL
Dal workspace di Databricks, fai clic sull’icona SQL nella barra laterale.
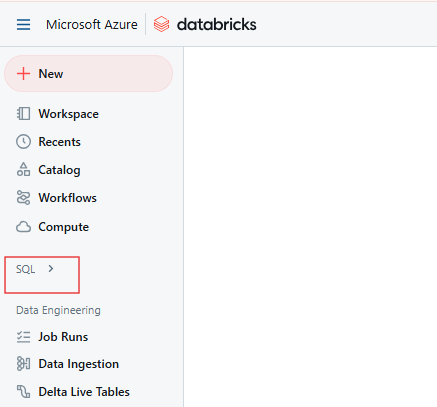
Pagina Databricks SQL. Immagine dell’autore.
Passaggio 2: apri la scheda SQL Warehouses
Nella pagina SQL, vai alla scheda SQL Warehouses.
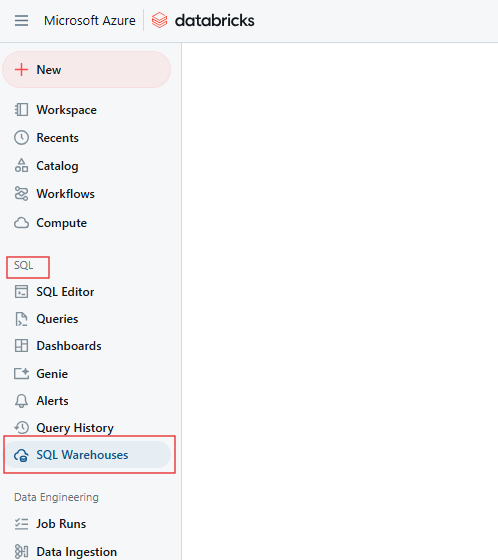
Scheda Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 3: clicca su "Create Warehouse"
Fai clic sul pulsante Create Warehouse per iniziare a configurare il nuovo SQL Warehouse.
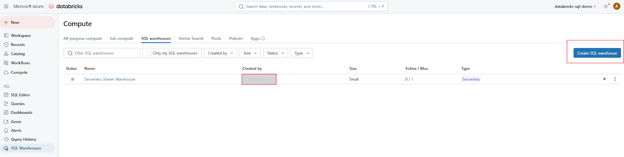
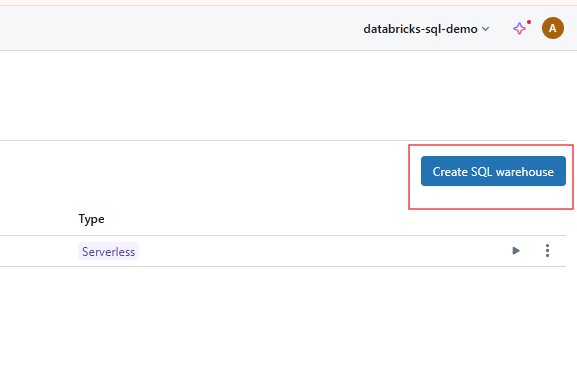
Creazione di un SQL Warehouse su Databricks SQL. Immagine dell’autore.
Passaggio 4: configura le impostazioni di base
Configura il warehouse utilizzando le seguenti opzioni.
- Name: fornisci un nome univoco e descrittivo per il tuo SQL Warehouse.
- Cluster Size: scegli la dimensione del cluster in base ai requisiti del carico di lavoro. È scontato che i cluster più grandi gestiscono più query concorrenti e dataset più ampi.
- Auto-Stop: imposta il periodo di inattività per arrestare automaticamente il warehouse quando non è in uso. Dieci minuti mi sembrano ragionevoli. Questo riduce i costi liberando risorse quando è inattivo.
- Scaling: abilita l’Auto-Scaling per regolare dinamicamente le risorse in base al carico delle query. Specifica il numero minimo e massimo di cluster entro cui scalare.
- Serverless Option: se disponibile nel tuo account, scegli il Serverless SQL Warehouse per una gestione semplificata e scalabilità automatica.
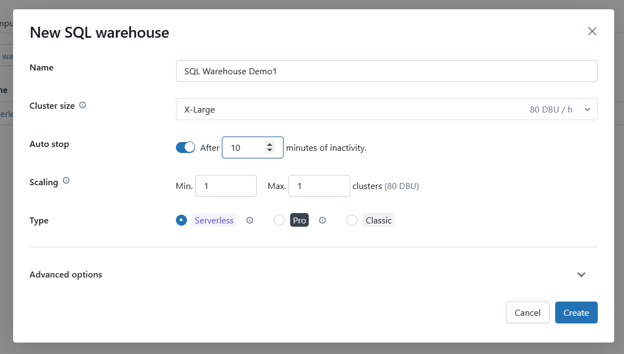
Configura le impostazioni di base per il Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 5: opzioni avanzate (facoltativo)
Se necessario, configura le opzioni avanzate come l’abilitazione di Photon o impostazioni SQL specifiche.
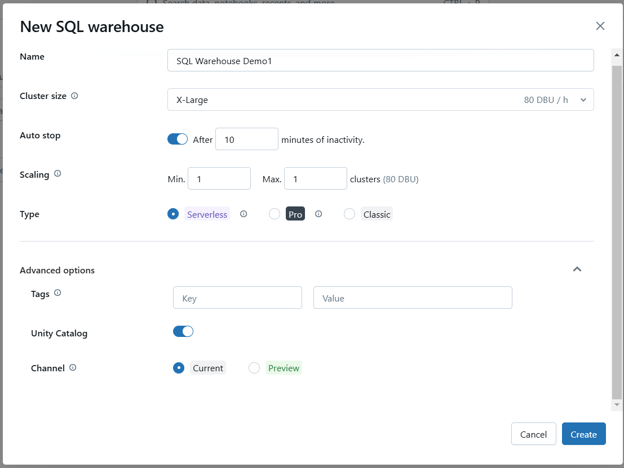
Configura le impostazioni avanzate per il Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 6: salva e avvia il warehouse
Fai clic su Create per salvare la configurazione. Una volta creato, avvia il warehouse per renderlo operativo.
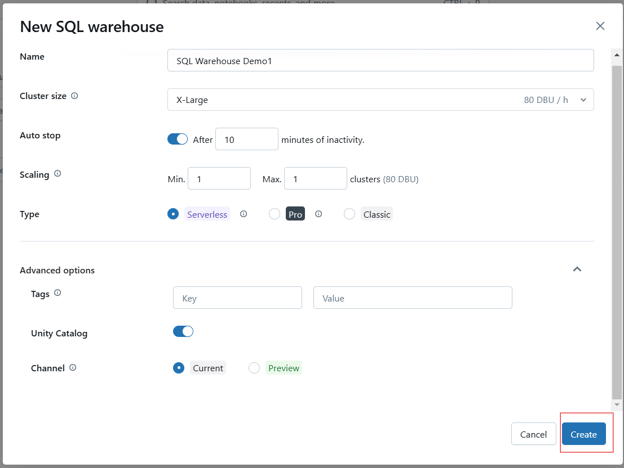
Creazione del Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 7: imposta i permessi (facoltativo)
Dopo la creazione, verrà visualizzato un modale dei permessi in cui puoi concedere l’accesso al warehouse a utenti o gruppi.
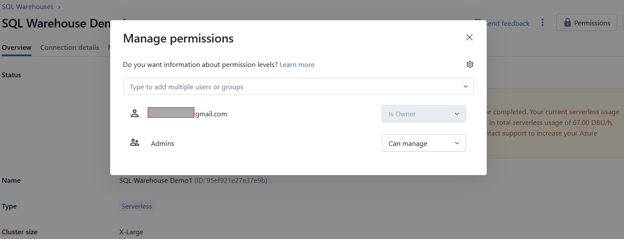
Gestione dei permessi del Databricks SQL Warehouse. Immagine dell’autore.
Una volta creato, il tuo SQL warehouse si avvierà automaticamente, consentendoti di eseguire subito le query.
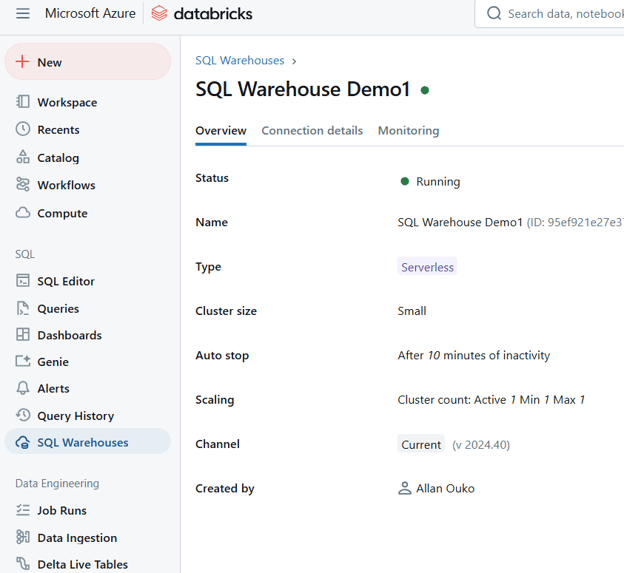
Esempio di Databricks SQL Warehouse. Immagine dell’autore.
Usare un Notebook con un Databricks SQL Warehouse
Per eseguire query SQL in un notebook utilizzando il warehouse appena creato, segui questi passaggi:
Passaggio 1: apri o crea un Notebook
Dal workspace Databricks, crea un nuovo notebook o aprine uno esistente.
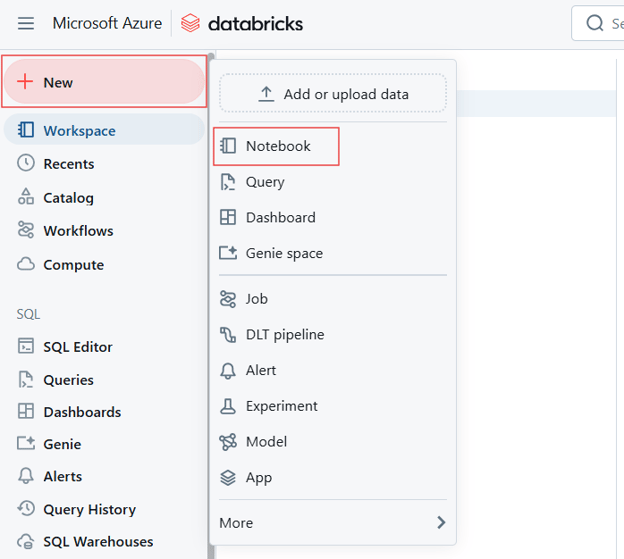
Creazione di un nuovo Notebook per creare un Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 2: collega il SQL Warehouse
Nella toolbar del Notebook, trova il selettore di compute o di connessione (di solito in alto). Cliccaci per aprire un menu a discesa con le risorse di calcolo disponibili. Seleziona il tuo SQL warehouse dall’elenco. Se non è visibile, clicca su More… per vedere tutti i warehouse disponibili. Clicca sul warehouse desiderato e poi seleziona Start and attach.
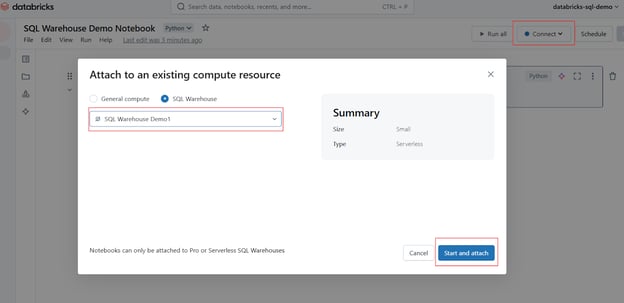
Collega il Notebook al Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 3: scrivi le query SQL
Una volta collegato, puoi creare celle nel notebook per le query SQL. Usa il magic command %sql per eseguire query SQL nel notebook.
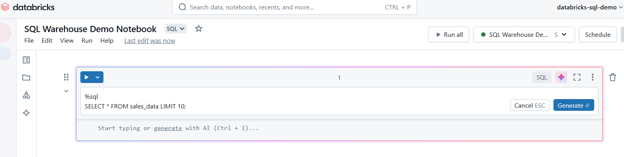
Scrivi query SQL in Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 4: esegui le query
Esegui la cella per lanciare la query. I risultati verranno mostrati subito sotto la cella, facilitando l’anteprima dei dati.
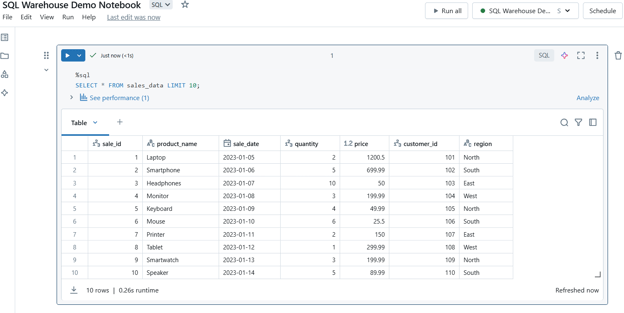
Esegui query SQL in Databricks SQL Warehouse. Immagine dell’autore.
Considerazioni per l’uso di un Notebook con un SQL Warehouse
Di seguito alcune considerazioni quando usi notebook con SQL Warehouses:
-
Limiti delle query: i SQL Warehouses sono ottimizzati per query analitiche, non per query transazionali frequenti e a bassa latenza.
-
Anteprima dei dati: per dataset di grandi dimensioni, valuta di limitare i risultati delle query, ad esempio usando la clausola LIMIT per evitare colli di bottiglia nelle prestazioni.
-
Caching delle query: sfrutta il caching dei risultati per velocizzare le query ripetute.
-
Uso delle risorse: monitora l’utilizzo del SQL Warehouse per assicurarti che dimensione del cluster e impostazioni di scaling siano adeguate al tuo carico di lavoro.
Conclusione
Databricks SQL è una potente piattaforma che colma il divario tra data lake e data warehouse, offrendo una soluzione unificata per analytics moderni e business intelligence. Che tu stia costruendo dashboard, ottimizzando query o monitorando i dati con avvisi, Databricks SQL offre la flessibilità e le prestazioni necessarie per affrontare le sfide dei dati di oggi. Ti invito a esplorare le funzionalità e le capacità di Databricks SQL per migliorare i tuoi flussi di lavoro, favorire la collaborazione e prendere decisioni più intelligenti e rapide.
Se ti interessa diventare un data engineer professionista, ti consiglio vivamente il nostro corso Understanding Data Engineering per scoprire come i data engineer archiviano ed elaborano i dati per facilitare la collaborazione con i data scientist. Ti consiglio anche il corso Data-Driven Decision-Making in SQL per imparare a usare SQL a supporto delle decisioni con progetti reali. E naturalmente, non dimenticare di dare un’occhiata alla nostra ampia selezione di cloud courses.





Databricks SQL è uno strumento potente progettato per la gestione e l’analisi dei dati all’interno della piattaforma Databricks Lakehouse. Questa piattaforma integra data engineering, data science e business analytics in un’esperienza unificata. Per questo, Databricks SQL è importante per i professionisti dei dati che vogliono snellire i flussi di lavoro, l’esecuzione delle query e i compiti di BI senza la complessità della gestione dell’infrastruttura tradizionale.
In questo articolo esplorerò i componenti, le funzionalità e gli strumenti di Databricks SQL e mostrerò esempi pratici di creazione e utilizzo di un warehouse Databricks SQL. Per iniziare, ti consiglio vivamente il corso di DataCamp Introduction to Databricks per scoprire Databricks come soluzione di data warehousing per la Business Intelligence (BI), sfruttando le capacità ottimizzate per SQL per creare query e analizzare i dati.
Cos’è Databricks SQL?
Databricks SQL è un solido strumento di analytics all’interno della piattaforma Databricks Lakehouse che consente ai professionisti dei dati di eseguire query SQL, analizzare i dati e creare dashboard interattive. Progettato con un’architettura serverless, Databricks SQL combina la flessibilità dei data lake con le capacità di governance e performance dei data warehouse.
I componenti chiave di Databricks SQL includono SQL Warehouses, SQL Editor e SQL Dashboards. Non preoccuparti se non conosci ciascuno di questi: più avanti ne spiegherò il significato.
Databricks SQL vs. SQL Server e altri
A differenza di altri dialetti SQL come MySQL, PostgreSQL o SQL Server, pensati per database transazionali, Databricks SQL è ottimizzato per analytics su larga scala in un ambiente Lakehouse. I database SQL tradizionali si concentrano sull’archiviazione di dati strutturati, mentre Databricks SQL si integra con i data lake preservando al contempo le performance di un data warehouse. Con i SQL warehouse serverless non c’è bisogno di gestire l’infrastruttura, perché le risorse vengono fornite automaticamente e scalano in modo elastico.
Inoltre, va detto che in Databricks SQL l’esecuzione delle query è più veloce grazie al motore Photon, che supporta l’elaborazione vettorializzata. Ultima cosa: Databricks SQL è pensato per la BI e la collaborazione; offre supporto nativo per Power BI, Tableau e Looker.
Componenti fondamentali di Databricks SQL
I componenti principali di Databricks SQL facilitano query efficienti, visualizzazione dei dati e collaborazione tra gli utenti. Di seguito trovi una panoramica degli strumenti e delle funzionalità principali disponibili in Databricks SQL.
SQL Warehouses
Gli SQL Warehouses sono le risorse computazionali per eseguire query SQL in Databricks SQL. Sono progettati per gestire carichi di lavoro variabili e offrono ottimizzazioni delle prestazioni in base al tipo di warehouse selezionato. Esistono tre tipologie principali di SQL Warehouses:
SQL Warehouse in Databricks SQL. Immagine dell’autore.
SQL Editor
Il SQL Editor è un’interfaccia intuitiva che permette di scrivere, eseguire e gestire query SQL. Le funzionalità principali includono:
SQL Editor in Databricks SQL. Immagine dell’autore.
Dashboard
I dashboard consentono la visualizzazione dei dati trasformando i risultati delle query in grafici, diagrammi e widget interattivi. Sono ideali per monitorare metriche chiave e comunicare insight in modo efficace in tutta l’organizzazione. Le principali capacità includono:
Dashboard in Databricks SQL. Immagine dell’autore.
Avvisi
Gli avvisi in Databricks SQL permettono di monitorare i cambiamenti dei dati e attivare notifiche quando si verificano condizioni specifiche. Sono essenziali per mantenere la qualità dei dati e assicurare risposte tempestive a cambiamenti importanti. Il funzionamento è il seguente.
Cronologia e profiling delle query
Infine, vale la pena dire che Databricks SQL offre strumenti per tracciare la cronologia e il profiling delle query:
Cronologia delle query in Databricks SQL. Immagine dell’autore.
Funzionalità e strumenti chiave in Databricks SQL
Databricks SQL è ricco di funzionalità e strumenti avanzati. Queste caratteristiche sono pensate per migliorare le prestazioni, semplificare i flussi di lavoro e consentire un’integrazione senza soluzione di continuità con altri strumenti. Vediamo alcuni degli aspetti che rendono Databricks SQL una scelta eccellente.
Photon Engine
Photon Engine è un motore di query vettorializzato ad alte prestazioni sviluppato da Databricks per accelerare in modo significativo l’esecuzione delle query SQL. I principali vantaggi includono:
CloudFetch e Async I/O
CloudFetch e Async I/O sono funzionalità progettate per aumentare la velocità di trasferimento dei dati e migliorare la gestione dei file piccoli durante l’esecuzione delle query. Funzionano così:
Integrazione con strumenti BI
Databricks SQL si integra perfettamente con i più diffusi strumenti di Business Intelligence (BI), facilitando l’analisi e la visualizzazione dei dati da parte dei team. Le integrazioni supportate includono:
Architettura serverless
L’architettura serverless di Databricks SQL elimina la necessità di gestire manualmente l’infrastruttura effettuando automaticamente il provisioning e la scalabilità delle risorse in base alla domanda. L’architettura serverless regola automaticamente le risorse per gestire carichi di query variabili senza downtime. Ciò garantisce che non sia necessario configurare o mantenere manualmente i cluster. È anche conveniente dal punto di vista dei costi, perché paghi solo le risorse utilizzate durante l’esecuzione delle query.
Per esempio, una società retail registra carichi elevati di query nelle ore di punta. L’architettura serverless scala automaticamente le risorse per mantenere prestazioni costanti e riduce la scala nelle ore di minor traffico per risparmiare sui costi.
Guida passo passo per creare e utilizzare i Databricks SQL Warehouses
I Databricks SQL Warehouses sono essenziali per eseguire query SQL in modo efficiente nell’ambiente Databricks. In questa sezione ti guiderò nella creazione di un SQL warehouse e nel suo utilizzo con i notebook. Se vuoi rinfrescare i concetti di data warehousing, ti consiglio il nostro corso Data Warehousing Concepts per imparare le basi del data modeling e della trasformazione dei dati.
Creare un Databricks SQL Warehouse
Segui questi passaggi per creare un SQL Warehouse usando la web UI di Databricks:
Passaggio 1: vai alla pagina Databricks SQL
Dal workspace di Databricks, fai clic sull’icona SQL nella barra laterale.
Pagina Databricks SQL. Immagine dell’autore.
Passaggio 2: apri la scheda SQL Warehouses
Nella pagina SQL, vai alla scheda SQL Warehouses.
Scheda Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 3: clicca su "Create Warehouse"
Fai clic sul pulsante Create Warehouse per iniziare a configurare il nuovo SQL Warehouse.
Creazione di un SQL Warehouse su Databricks SQL. Immagine dell’autore.
Passaggio 4: configura le impostazioni di base
Configura il warehouse utilizzando le seguenti opzioni.
Configura le impostazioni di base per il Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 5: opzioni avanzate (facoltativo)
Se necessario, configura le opzioni avanzate come l’abilitazione di Photon o impostazioni SQL specifiche.
Configura le impostazioni avanzate per il Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 6: salva e avvia il warehouse
Fai clic su Create per salvare la configurazione. Una volta creato, avvia il warehouse per renderlo operativo.
Creazione del Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 7: imposta i permessi (facoltativo)
Dopo la creazione, verrà visualizzato un modale dei permessi in cui puoi concedere l’accesso al warehouse a utenti o gruppi.
Gestione dei permessi del Databricks SQL Warehouse. Immagine dell’autore.
Una volta creato, il tuo SQL warehouse si avvierà automaticamente, consentendoti di eseguire subito le query.
Esempio di Databricks SQL Warehouse. Immagine dell’autore.
Usare un Notebook con un Databricks SQL Warehouse
Per eseguire query SQL in un notebook utilizzando il warehouse appena creato, segui questi passaggi:
Passaggio 1: apri o crea un Notebook
Dal workspace Databricks, crea un nuovo notebook o aprine uno esistente.
Creazione di un nuovo Notebook per creare un Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 2: collega il SQL Warehouse
Nella toolbar del Notebook, trova il selettore di compute o di connessione (di solito in alto). Cliccaci per aprire un menu a discesa con le risorse di calcolo disponibili. Seleziona il tuo SQL warehouse dall’elenco. Se non è visibile, clicca su More… per vedere tutti i warehouse disponibili. Clicca sul warehouse desiderato e poi seleziona Start and attach.
Collega il Notebook al Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 3: scrivi le query SQL
Una volta collegato, puoi creare celle nel notebook per le query SQL. Usa il magic command
%sqlper eseguire query SQL nel notebook.Scrivi query SQL in Databricks SQL Warehouse. Immagine dell’autore.
Passaggio 4: esegui le query
Esegui la cella per lanciare la query. I risultati verranno mostrati subito sotto la cella, facilitando l’anteprima dei dati.
Esegui query SQL in Databricks SQL Warehouse. Immagine dell’autore.
Considerazioni per l’uso di un Notebook con un SQL Warehouse
Di seguito alcune considerazioni quando usi notebook con SQL Warehouses:
Limiti delle query: i SQL Warehouses sono ottimizzati per query analitiche, non per query transazionali frequenti e a bassa latenza.
Anteprima dei dati: per dataset di grandi dimensioni, valuta di limitare i risultati delle query, ad esempio usando la clausola
LIMITper evitare colli di bottiglia nelle prestazioni.Caching delle query: sfrutta il caching dei risultati per velocizzare le query ripetute.
Uso delle risorse: monitora l’utilizzo del SQL Warehouse per assicurarti che dimensione del cluster e impostazioni di scaling siano adeguate al tuo carico di lavoro.
Conclusione
Databricks SQL è una potente piattaforma che colma il divario tra data lake e data warehouse, offrendo una soluzione unificata per analytics moderni e business intelligence. Che tu stia costruendo dashboard, ottimizzando query o monitorando i dati con avvisi, Databricks SQL offre la flessibilità e le prestazioni necessarie per affrontare le sfide dei dati di oggi. Ti invito a esplorare le funzionalità e le capacità di Databricks SQL per migliorare i tuoi flussi di lavoro, favorire la collaborazione e prendere decisioni più intelligenti e rapide.
Se ti interessa diventare un data engineer professionista, ti consiglio vivamente il nostro corso Understanding Data Engineering per scoprire come i data engineer archiviano ed elaborano i dati per facilitare la collaborazione con i data scientist. Ti consiglio anche il corso Data-Driven Decision-Making in SQL per imparare a usare SQL a supporto delle decisioni con progetti reali. E naturalmente, non dimenticare di dare un’occhiata alla nostra ampia selezione di cloud courses.