Databricks SQL, Databricks Lakehouse प्लेटफ़ॉर्म में डेटा प्रबंधन और एनालिटिक्स के लिए बनाया गया एक शक्तिशाली टूल है। यह प्लेटफ़ॉर्म डेटा इंजीनियरिंग, डेटा साइंस, और बिज़नेस एनालिटिक्स को एकीकृत अनुभव में समेकित करता है। इसलिए, Databricks SQL उन डेटा प्रोफेशनल्स के लिए महत्वपूर्ण है जो पारंपरिक इन्फ्रास्ट्रक्चर मैनेजमेंट की जटिलता के बिना अपने डेटा वर्कफ़्लोज़, क्वेरी निष्पादन और BI कार्यों को सरल बनाना चाहते हैं।
इस लेख में, मैं Databricks SQL के घटकों, विशेषताओं और टूल्स का अन्वेषण करूंगा और Databricks SQL वेयरहाउस बनाने व उपयोग करने के व्यावहारिक उदाहरण दिखाऊंगा। आरंभ करने से पहले, मैं DataCamp के Introduction to Databricks कोर्स की सिफारिश करता हूँ, ताकि आप Databricks को Business Intelligence (BI) के लिए एक डेटा वेयरहाउसिंग समाधान के रूप में जान सकें और SQL-ऑप्टिमाइज़्ड क्षमताओं का उपयोग करके क्वेरी बनाना और डेटा का विश्लेषण करना सीख सकें।
Databricks SQL क्या है?
Databricks SQL, Databricks Lakehouse प्लेटफ़ॉर्म के भीतर एक मज़बूत एनालिटिक्स टूल है, जो डेटा प्रोफेशनल्स को SQL क्वेरी चलाने, डेटा का विश्लेषण करने और इंटरैक्टिव डैशबोर्ड बनाने की अनुमति देता है। सर्वरलेस आर्किटेक्चर के साथ डिज़ाइन किया गया, Databricks SQL डेटा लेक्स की लचीलेपन को डेटा वेयरहाउस की गवर्नेंस और परफॉर्मेंस क्षमताओं के साथ जोड़ता है।
Databricks SQL के प्रमुख घटकों में SQL Warehouses, SQL Editors, और SQL Dashboards शामिल हैं। यदि आप इनमें से प्रत्येक से परिचित नहीं हैं तो चिंता की बात नहीं—मैं नीचे इनके अर्थ समझाऊंगा।
Databricks SQL बनाम SQL Server और अन्य
MySQL, PostgreSQL, या SQL Server जैसे अन्य SQL डायलैक्ट, जो ट्रांज़ैक्शनल डेटाबेस के लिए बनाए गए हैं, उनसे अलग, Databricks SQL Lakehouse परिवेश में बड़े पैमाने पर एनालिटिक्स के लिए ऑप्टिमाइज़्ड है। पारंपरिक SQL डेटाबेस संरचित डेटा स्टोरेज पर केंद्रित होते हैं, जबकि Databricks SQL डेटा लेक्स के साथ एकीकृत होता है और साथ ही डेटा वेयरहाउस के प्रदर्शन को बनाए रखता है। सर्वरलेस SQL वेयरहाउसेज़ के साथ, इन्फ्रास्ट्रक्चर मैनेज करने की ज़रूरत नहीं रहती—रिसोर्स अपने आप प्रोविज़न होते हैं और इलास्टिक तरीके से स्केल होते हैं।
इसके अलावा, Databricks SQL में क्वेरी निष्पादन तेज़ होता है क्योंकि इसे Photon इंजन द्वारा त्वरित किया जाता है, जो वेक्टराइज़्ड प्रोसेसिंग सपोर्ट करता है। अंत में, Databricks SQL BI और सहयोग के लिए बना है; इसमें Power BI, Tableau, और Looker के लिए नैटिव सपोर्ट उपलब्ध है।
Databricks SQL के मुख्य घटक
Databricks SQL के मुख्य घटक कुशल क्वेरीइंग, डेटा विज़ुअलाइज़ेशन और उपयोगकर्ताओं के बीच सहयोग को सुगम बनाते हैं। नीचे Databricks SQL के भीतर उपलब्ध प्रमुख टूल्स और फ़ीचर्स का एक अवलोकन दिया गया है।
SQL Warehouses
SQL Warehouses, Databricks SQL में SQL क्वेरियों को निष्पादित करने के लिए कम्प्यूटेशनल रिसोर्स के रूप में कार्य करते हैं। इन्हें विविध वर्कलोड संभालने और चुने गए वेयरहाउस के प्रकार के आधार पर परफॉर्मेंस ऑप्टिमाइज़ेशन प्रदान करने के लिए डिज़ाइन किया गया है। SQL Warehouses के तीन मुख्य प्रकार हैं:
- Classic: यह प्रकार बुनियादी क्षमताओं को सपोर्ट करता है और एंट्री-लेवल परफॉर्मेंस के लिए उपयुक्त है। यह आपके क्लाउड अकाउंट में मौजूदा कंप्यूट लेयर का उपयोग करता है, लेकिन Intelligent Workload Management (IWM) और Predictive IO जैसी उन्नत सुविधाओं की कमी है।
- Pro: Pro SQL Warehouses, Photon—एक वेक्टराइज़्ड क्वेरी इंजन—के सपोर्ट के साथ बेहतर प्रदर्शन प्रदान करते हैं, जो SQL ऑपरेशंस को तेज़ करता है और सुरक्षा विकल्पों में सुधार करता है।
- Serverless इन्फ्रास्ट्रक्चर मैनेजमेंट को समाप्त करता है—रिसोर्स अपने आप प्रोविज़न होते हैं, इलास्टिक रूप से स्केल होते हैं, और लो-लेटेंसी क्वेरी निष्पादन सुनिश्चित करते हैं। ये बदलते वर्कलोड वाले परिवेश के लिए आदर्श हैं और किफायती प्रदर्शन देते हैं।
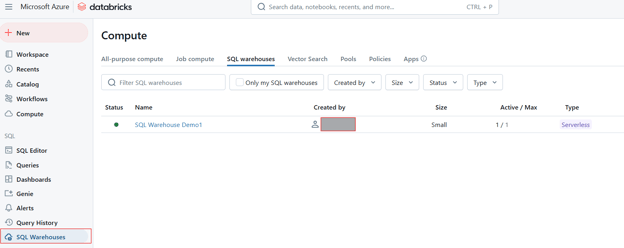
Databricks SQL में SQL Warehouse. चित्र: लेखक द्वारा।
SQL Editor
SQL Editor एक उपयोगकर्ता-अनुकूल इंटरफ़ेस है जो उपयोगकर्ताओं को SQL क्वेरी लिखने, चलाने और प्रबंधित करने में सक्षम बनाता है। SQL Editor की प्रमुख विशेषताएँ:
- इंट्यूटिव क्वेरीइंग: कुशल क्वेरी लेखन के लिए सिंटैक्स हाइलाइटिंग, ऑटोकम्प्लीट और एरर डिटेक्शन सपोर्ट करता है।
- डेटा प्रीव्यू: उपयोगकर्ता सीधे एडिटर में डेटा का प्रीव्यू कर सकते हैं, जिससे जटिल क्वेरियों के निष्पादन से पहले डेटासेट समझना आसान होता है।
- क्वेरी रिज़ल्ट कैशिंग: यह सुविधा पिछले क्वेरी परिणामों को कैश करके प्रदर्शन बढ़ाती है, जिससे दोहराई गई क्वेरियों पर तेज़ प्रतिक्रिया मिलती है।
- पैरामीटराइज्ड क्वेरियाँ: उपयोगकर्ता पैरामीटर शामिल करके डायनेमिक क्वेरियाँ बना सकते हैं, जिससे अलग-अलग मानों के साथ मिलती-जुलती क्वेरियाँ चलाना सरल हो जाता है।
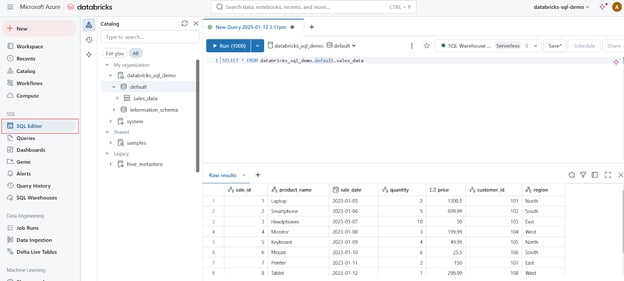
Databricks SQL में SQL Editor. चित्र: लेखक द्वारा।
Dashboards
डैशबोर्ड्स क्वेरी के परिणामों को इंटरैक्टिव चार्ट, ग्राफ़ और विजेट्स में बदलकर डेटा विज़ुअलाइज़ेशन सक्षम करते हैं। डैशबोर्ड्स प्रमुख मीट्रिक्स की निगरानी और संगठन भर में इनसाइट्स के प्रभावी संप्रेषण के लिए आदर्श हैं। डैशबोर्ड्स की प्रमुख क्षमताएँ:
- रियल-टाइम एनालिटिक्स: लाइव क्वेरी परिणामों के आधार पर डैशबोर्ड्स को अपने आप रिफ्रेश करें।
- सहयोग: टीमों के बीच डैशबोर्ड्स साझा करें ताकि डेटा-आधारित निर्णयों को बढ़ावा मिले।
- कस्टमाइज़ेशन: विशिष्ट आवश्यकताओं के अनुसार विभिन्न विज़ुअलाइज़ेशन प्रकार और लेआउट विकल्प चुनें।
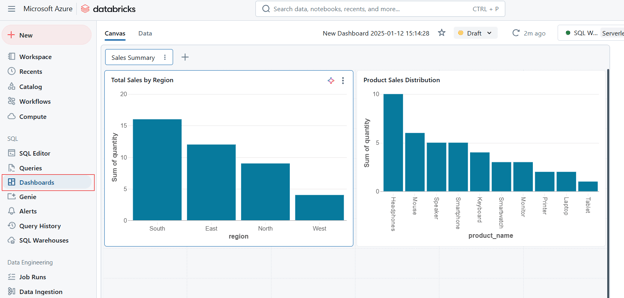
Databricks SQL में डैशबोर्ड्स। चित्र: लेखक द्वारा।
Alerts
Databricks SQL में अलर्ट्स डेटा में बदलावों की निगरानी करने और निर्दिष्ट शर्तें पूरी होने पर नोटिफिकेशन्स ट्रिगर करने का तरीका प्रदान करते हैं। अलर्ट्स डेटा गुणवत्ता बनाए रखने और महत्वपूर्ण परिवर्तनों पर समय पर प्रतिक्रिया सुनिश्चित करने के लिए आवश्यक हैं। अलर्ट की कार्यप्रणाली इस प्रकार काम करती है।
- शर्तें सेट करें: क्वेरी परिणामों के आधार पर थ्रेशहोल्ड या नियम परिभाषित करें।
- नोटिफिकेशन ट्रिगर करें: शर्तें पूरी होने पर ईमेल, Slack, या अन्य इंटीग्रेशन्स के माध्यम से अलर्ट्स प्राप्त करें।
- प्रोएक्टिव मॉनिटरिंग: डेटा में विसंगतियाँ या सिस्टम समस्याएँ जैसी महत्वपूर्ण घटनाओं के बारे में रियल-टाइम में सूचित रहें।
क्वेरी हिस्ट्री और प्रोफाइलिंग
अंत में, Databricks SQL क्वेरी हिस्ट्री और प्रोफाइलिंग को ट्रैक करने के लिए टूल्स प्रदान करता है:
- Query History: यह सुविधा उपयोगकर्ताओं को पहले निष्पादित क्वेरियों की समीक्षा करने देती है, जिससे समय के साथ उनके प्रदर्शन पर इनसाइट्स मिलते हैं। यह रुझानों या आवर्ती समस्याओं की पहचान करने में मदद करती है।
- Query Profiling: क्वेरी प्रोफाइलिंग टूल्स निष्पादित क्वेरियों की दक्षता का विश्लेषण करते हैं, बाधाओं को हाइलाइट करते हैं और ऑप्टिमाइज़ेशन सुझाते हैं। यह क्षमता समग्र क्वेरी प्रदर्शन और रिसोर्स उपयोग में सुधार के लिए महत्वपूर्ण है।
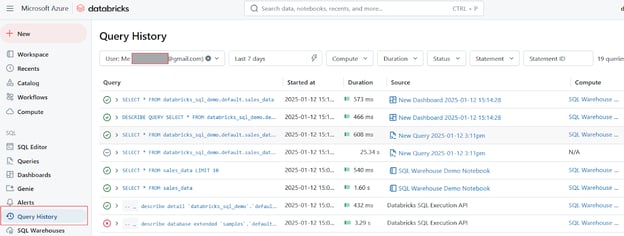
Databricks SQL में Query History. चित्र: लेखक द्वारा।
Databricks SQL की प्रमुख विशेषताएँ और टूल्स
Databricks SQL उन्नत विशेषताओं और टूल्स से भरपूर है। ये विशेषताएँ प्रदर्शन बढ़ाने, वर्कफ़्लोज़ को सुव्यवस्थित करने और अन्य टूल्स के साथ सहज इंटीग्रेशन सक्षम करने के लिए डिज़ाइन की गई हैं। आइए देखें कि कौन-सी प्रमुख बातें Databricks SQL को बेहतरीन विकल्प बनाती हैं।
Photon Engine
Photon Engine एक उच्च-प्रदर्शन, वेक्टराइज़्ड क्वेरी इंजन है जिसे Databricks ने SQL क्वेरी निष्पादन में उल्लेखनीय तेजी लाने के लिए विकसित किया है। Photon Engine के प्रमुख लाभ:
- वेक्टराइज़्ड निष्पादन: पारंपरिक रो-बाय-रो प्रोसेसिंग के विपरीत, Photon बैच में डेटा प्रोसेस करता है। यह तरीका SIMD (Single Instruction, Multiple Data) जैसे उन्नत CPU इंस्ट्रक्शन्स का लाभ उठाने देता है, जिससे दक्षता बढ़ती है।
- मौजूदा वर्कलोड्स के साथ इंटीग्रेशन: Photon, Apache Spark APIs के साथ पूर्णतः संगत है, यानी उपयोगकर्ता इसे बिना मौजूदा कोड बदले सक्षम कर सकते हैं। यह सहज इंटीग्रेशन संगठनों को व्यापक रीवर्क के बिना बेहतर प्रदर्शन का लाभ देता है।
- कैशिंग और ऑप्टिमाइज़ेशन: इंजन में एक उन्नत क्वेरी ऑप्टिमाइज़र और कैशिंग लेयर शामिल है, जो बुद्धिमानी से यह चुनती है कि किस डेटा को कैश करना है, जिससे क्वेरी प्रदर्शन और बेहतर होता है।
CloudFetch और Async I/O
CloudFetch और Async I/O डेटा ट्रांसफ़र स्पीड बढ़ाने और क्वेरी निष्पादन के दौरान छोटे फ़ाइलों के हैंडलिंग को बेहतर बनाने के लिए डिज़ाइन की गई विशेषताएँ हैं। ये इस प्रकार काम करती हैं:
- CloudFetch: यह सुविधा सभी कंप्यूट नोड्स में समानांतर लिखने की अनुमति देकर परिणामों को क्लाउड स्टोरेज में वापस लिखने के तरीके को ऑप्टिमाइज़ करती है। यह बड़े डेटासेट्स को क्लाइंट्स तक वापस ट्रांसफ़र करने में लगने वाला समय काफी कम कर देती है—वास्तविक परिदृश्यों में 10 गुना तक तेज़ प्रदर्शन हासिल होता है।
- Async I/O: यह क्षमता वर्तमान ब्लॉक्स को प्रोसेस करते समय एक साथ कई डेटा ब्लॉक्स को पढ़कर छोटे फ़ाइलों के हैंडलिंग को बेहतर बनाती है। यह तरीका छोटे फ़ाइलों (जैसे, 1MB) के साथ काम करते समय समग्र क्वेरी प्रदर्शन को 12 गुना तक बढ़ा सकता है। यह विशेष रूप से उन परिदृश्यों के लिए प्रभावी है जिनमें बहुत-सी छोटी फ़ाइलें या "कोल्ड डेटा" शामिल हो—जो कैश्ड नहीं होता।
BI टूल्स के साथ इंटीग्रेशन
Databricks SQL लोकप्रिय Business Intelligence (BI) टूल्स के साथ सहजता से इंटीग्रेट होता है, जिससे टीमों के लिए डेटा का विश्लेषण और विज़ुअलाइज़ेशन आसान हो जाता है। समर्थित इंटीग्रेशन्स में शामिल हैं:
- Power BI: उपयोगकर्ता अपने Databricks वर्कस्पेस को सीधे Power BI से कनेक्ट कर सकते हैं, जिससे डेटा मॉडल्स का आसान सिंक्रोनाइज़ेशन संभव होता है। उदाहरण के लिए, विश्लेषक Databricks से सीधे Power BI में रिपोर्ट्स पब्लिश कर सकते हैं, और टेबल्स के बीच परिभाषित रिलेशनशिप्स बिना मैन्युअल हस्तक्षेप के बनी रहती हैं।
- Tableau: उपयोगकर्ता Databricks SQL में स्टोर डेटा को विज़ुअलाइज़ करने के लिए लाइव कनेक्शन्स का लाभ उठा सकते हैं। यह इंटीग्रेशन रियल-टाइम एनालिटिक्स और इंटरैक्टिव डैशबोर्ड्स सक्षम करता है जो नवीनतम डेटा अपडेट्स को दर्शाते हैं।
- dbt: Databricks SQL, dbt (data build tool) के साथ भी इंटीग्रेट होता है, जिससे टीमें अपने ट्रांसफ़ॉर्मेशन्स को सीधे Databricks परिवेश में प्रबंधित कर सकती हैं। यह इंटीग्रेशन इन्क्रिमेंटल मॉडल्स और मैटेरियलाइज़्ड व्यूज़ को सपोर्ट करता है, जिससे मज़बूत डेटा पाइपलाइन्स बनाना और बनाए रखना सरल हो जाता है।
सर्वरलेस आर्किटेक्चर
Databricks SQL का सर्वरलेस आर्किटेक्चर वर्कलोड की माँगों के आधार पर रिसोर्स को अपने आप प्रोविज़न और स्केल करके मैन्युअल इन्फ्रास्ट्रक्चर मैनेजमेंट की आवश्यकता को समाप्त करता है। सर्वरलेस आर्किटेक्चर डाउनटाइम के बिना अलग-अलग क्वेरी लोड हैंडल करने के लिए रिसोर्स को स्वतः समायोजित करता है। इससे उपयोगकर्ताओं को क्लस्टर्स को मैन्युअल रूप से कॉन्फ़िगर या मेंटेन करने की ज़रूरत नहीं रहती। सर्वरलेस आर्किटेक्चर किफायती भी है, क्योंकि उपयोगकर्ता केवल क्वेरी निष्पादन के दौरान उपयोग किए गए रिसोर्स के लिए भुगतान करते हैं।
उदाहरण के लिए, एक रिटेल कंपनी पीक बिज़नेस आवर्स के दौरान उच्च क्वेरी लोड का अनुभव करती है। सर्वरलेस आर्किटेक्चर प्रदर्शन को स्थिर बनाए रखने के लिए अपने आप रिसोर्स स्केल-अप करता है और ऑफ-ऑवर्स में लागत बचाने के लिए स्केल-डाउन कर देता है।
Databricks SQL Warehouses बनाने और उपयोग करने की चरण-दर-चरण गाइड
Databricks SQL Warehouses, Databricks परिवेश में SQL क्वेरियों को कुशलतापूर्वक निष्पादित करने के लिए आवश्यक हैं। अब इस खंड में, मैं आपको SQL वेयरहाउस बनाने और उसे नोटबुक्स के साथ उपयोग करने की प्रक्रिया बताऊँगा। यदि आपको डेटा वेयरहाउसिंग के अपने ज्ञान को ताज़ा करने की ज़रूरत है, तो मैं हमारे Data Warehousing Concepts कोर्स को लेने की सलाह देता हूँ, जिसमें डेटा मॉडलिंग और डेटा ट्रांसफ़ॉर्मेशन की मूल बातें सिखाई जाती हैं।
Databricks SQL Warehouse बनाना
Databricks वेब UI का उपयोग करके SQL Warehouse बनाने के लिए ये चरण अपनाएँ:
चरण 1: Databricks SQL पेज पर जाएँ
Databricks वर्कस्पेस से, साइडबार में SQL आइकन पर क्लिक करें।
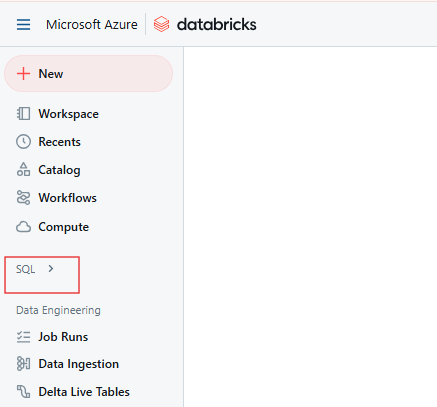
Databricks SQL पेज। चित्र: लेखक द्वारा।
चरण 2: SQL Warehouses टैब खोलें
SQL पेज पर, SQL Warehouses टैब पर जाएँ।
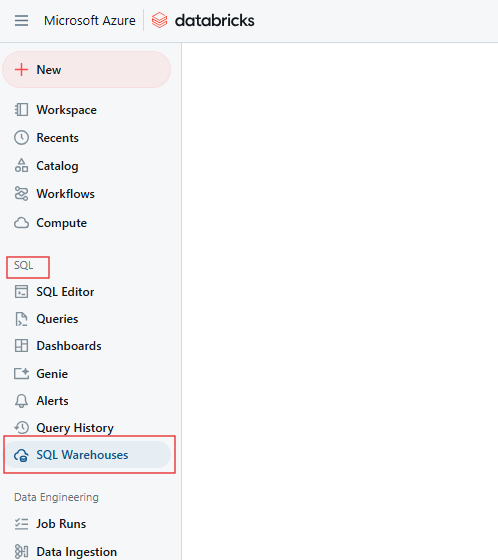
Databricks SQL Warehouse टैब। चित्र: लेखक द्वारा।
चरण 3: "Create Warehouse" पर क्लिक करें
अपने नए SQL Warehouse की कॉन्फ़िगरेशन शुरू करने के लिए Create Warehouse बटन पर क्लिक करें।
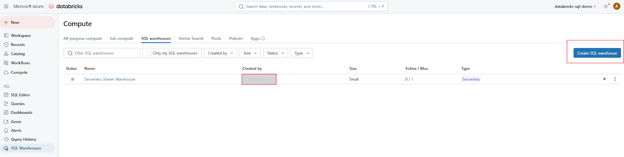
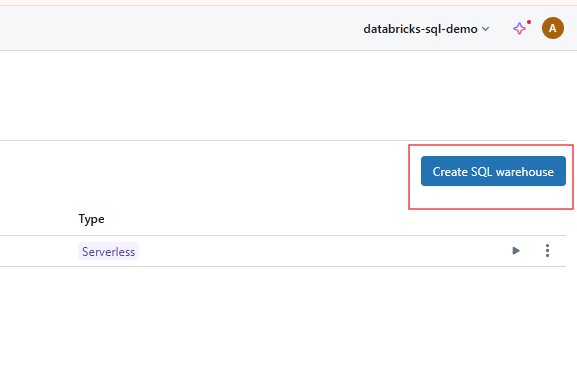
Databricks SQL पर SQL Warehouse बनाना। चित्र: लेखक द्वारा।
चरण 4: बुनियादी सेटिंग्स कॉन्फ़िगर करें
निम्न विकल्पों का उपयोग करके वेयरहाउस सेटिंग्स कॉन्फ़िगर करें।
- Name: अपने SQL Warehouse के लिए एक यूनिक और वर्णनात्मक नाम दें।
- Cluster Size: अपने वर्कलोड की आवश्यकताओं के आधार पर क्लस्टर का आकार चुनें। यह कहने की आवश्यकता नहीं कि बड़े क्लस्टर अधिक समकालिक क्वेरियाँ और बड़े डेटासेट संभालते हैं।
- Auto-Stop: वेयरहाउस के उपयोग में न होने पर उसे अपने आप रोकने के लिए idle timeout अवधि सेट करें। मुझे दस मिनट उचित लगता है। इससे आइडल होने पर रिसोर्स रिलीज़ होकर लागत बचती है।
- Scaling: ऑटो-स्केलिंग सक्षम करें ताकि क्वेरी लोड के आधार पर रिसोर्स डायनेमिक रूप से समायोजित हों। स्केल करने के लिए न्यूनतम और अधिकतम क्लस्टर्स की संख्या निर्दिष्ट करें।
- Serverless Option: यदि आपके अकाउंट में उपलब्ध हो, तो सरल प्रबंधन और स्वचालित स्केलिंग के लिए Serverless SQL Warehouse चुनें।
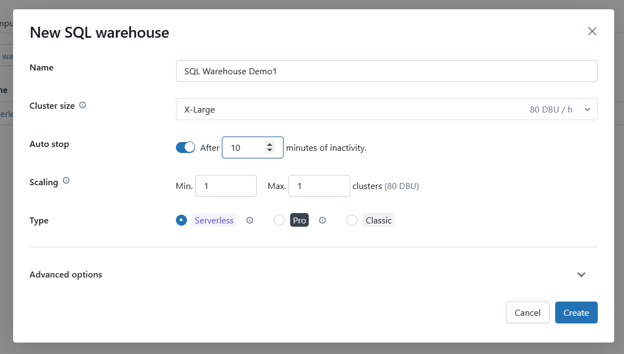
Databricks SQL Warehouse के लिए बुनियादी सेटिंग्स कॉन्फ़िगर करें। चित्र: लेखक द्वारा।
चरण 5: उन्नत विकल्प (वैकल्पिक)
आवश्यक हो तो, Photon सक्षम करने या विशिष्ट SQL कॉन्फ़िगरेशन सेट करने जैसे उन्नत विकल्प कॉन्फ़िगर करें।
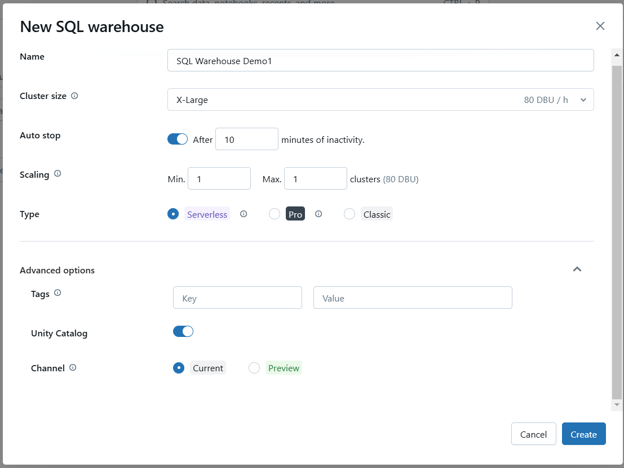
Databricks SQL Warehouse के लिए उन्नत सेटिंग्स कॉन्फ़िगर करें। चित्र: लेखक द्वारा।
चरण 6: वेयरहाउस सेव और स्टार्ट करें
अपनी कॉन्फ़िगरेशन सेव करने के लिए Create पर क्लिक करें। बन जाने के बाद, वेयरहाउस को स्टार्ट करें ताकि यह ऑपरेशनल हो जाए।
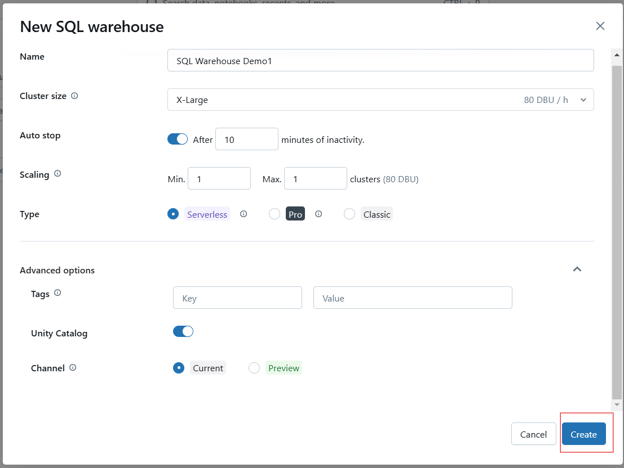
Databricks SQL Warehouse बनाना। चित्र: लेखक द्वारा।
चरण 7: परमिशन्स सेट करें (वैकल्पिक)
बनने के बाद, एक परमिशन्स मोडल दिखेगा जहाँ आप उपयोगकर्ताओं या समूहों को वेयरहाउस की एक्सेस दे सकते हैं।
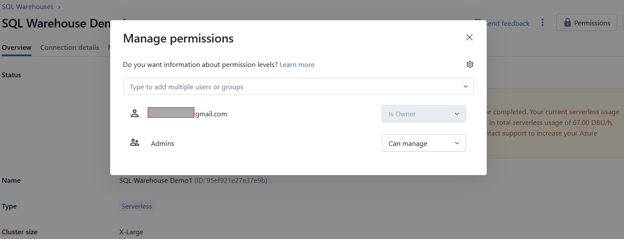
Databricks SQL Warehouse की परमिशन्स प्रबंधित करना। चित्र: लेखक द्वारा।
बनने के बाद, आपका SQL वेयरहाउस अपने आप स्टार्ट हो जाएगा, जिससे आप तुरंत क्वेरियाँ निष्पादित कर सकेंगे।
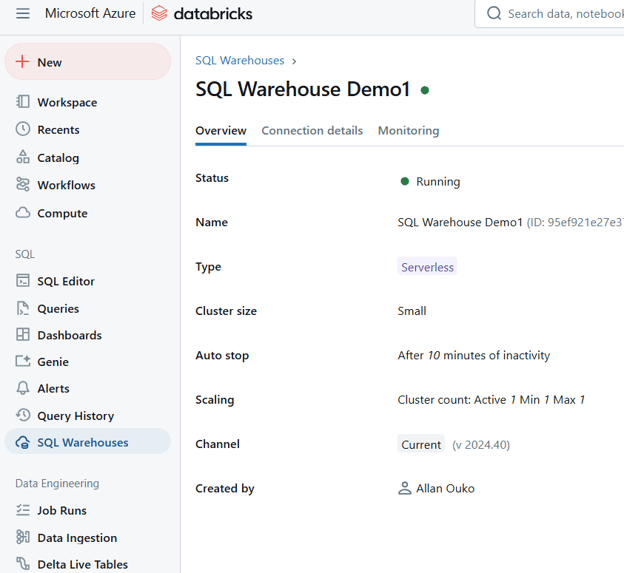
Databricks SQL Warehouse का उदाहरण। चित्र: लेखक द्वारा।
Databricks SQL Warehouse के साथ नोटबुक का उपयोग
अपने नए बनाए गए SQL वेयरहाउस का उपयोग करते हुए नोटबुक में SQL क्वेरियाँ निष्पादित करने के लिए ये चरण अपनाएँ:
चरण 1: नोटबुक खोलें या बनाएँ
Databricks वर्कस्पेस से एक नई नोटबुक बनाएँ या मौजूदा नोटबुक खोलें।
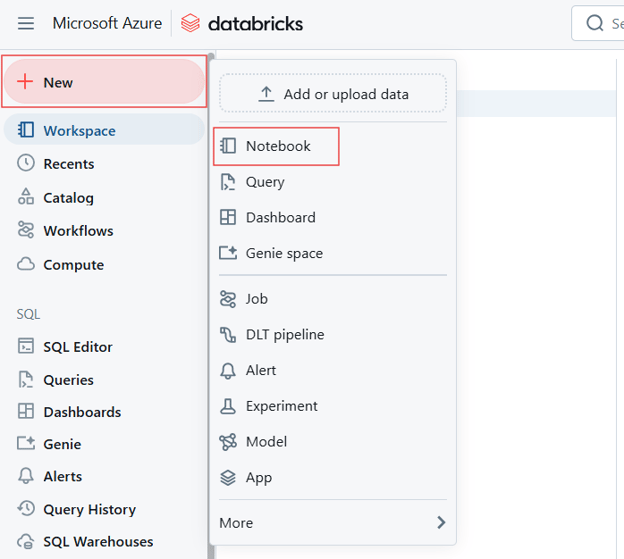
Databricks SQL Warehouse बनाने के लिए नई नोटबुक बनाना। चित्र: लेखक द्वारा।
चरण 2: SQL Warehouse अटैच करें
Notebook टूलबार में, कंप्यूट सेलेक्टर या कनेक्ट (आमतौर पर शीर्ष पर) ढूँढें। उपलब्ध कंप्यूट रिसोर्स दिखाने वाला ड्रॉपडाउन खोलने के लिए उस पर क्लिक करें। सूची में से अपना SQL वेयरहाउस चुनें। यदि यह दिखाई नहीं दे रहा हो, तो सभी उपलब्ध वेयरहाउस देखने के लिए More… पर क्लिक करें। इच्छित SQL वेयरहाउस पर क्लिक करें और फिर Start and attach चुनें।
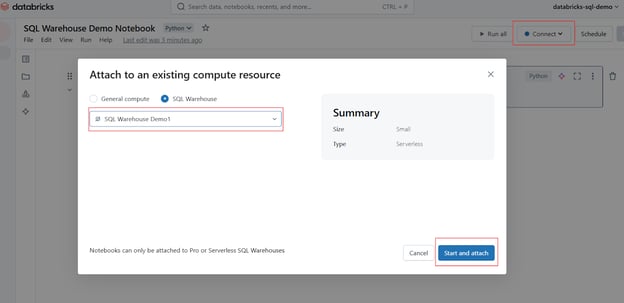
Databricks SQL Warehouse में नोटबुक अटैच करें। चित्र: लेखक द्वारा।
चरण 3: SQL क्वेरियाँ लिखें
अटैच होने के बाद, आप अपनी नोटबुक में SQL क्वेरियों के लिए सेल बना सकते हैं। नोटबुक में SQL क्वेरियाँ चलाने के लिए %sql मैजिक कमांड का उपयोग करें।
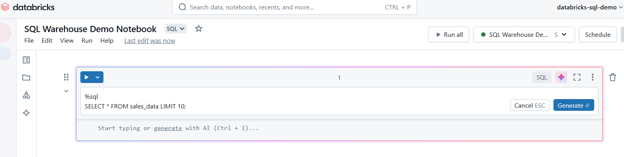
Databricks SQL Warehouse में SQL क्वेरियाँ लिखें। चित्र: लेखक द्वारा।
चरण 4: क्वेरियाँ निष्पादित करें
अपनी क्वेरी चलाने के लिए सेल रन करें। परिणाम सीधे सेल के नीचे प्रदर्शित होंगे, जिससे डेटा का प्रीव्यू करना आसान हो जाता है।
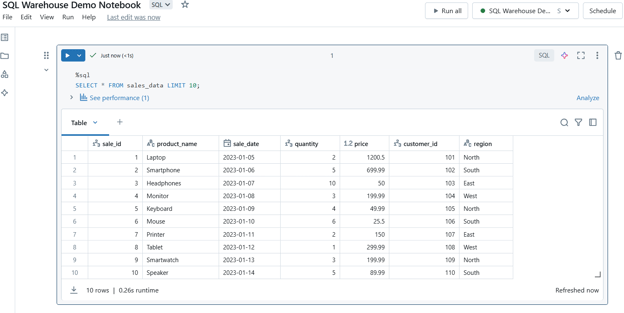
Databricks SQL Warehouse में SQL क्वेरियाँ निष्पादित करें। चित्र: लेखक द्वारा।
SQL Warehouse के साथ नोटबुक उपयोग करने के विचार
SQL Warehouses के साथ नोटबुक का उपयोग करते समय ये कुछ विचार ध्यान में रखें:
-
Query Limits: SQL Warehouses विश्लेषणात्मक क्वेरियों के लिए ऑप्टिमाइज़्ड हैं, बारंबार, लो-लेटेंसी ट्रांज़ैक्शनल क्वेरियों के लिए नहीं।
-
Data Preview: बड़े डेटासेट्स के लिए, अपने क्वेरी परिणामों को सीमित करने पर विचार करें, जैसे प्रदर्शन बाधाओं से बचने के लिए LIMIT क्लॉज़ का उपयोग।
-
Query Caching: दोहराई गई क्वेरियों को तेज़ करने के लिए रिज़ल्ट कैशिंग का फायदा उठाएँ।
-
Resource Usage: यह सुनिश्चित करने के लिए SQL Warehouse के उपयोग पर नज़र रखें कि क्लस्टर का आकार और स्केलिंग सेटिंग्स आपके वर्कलोड की ज़रूरतों को पूरा करते हैं।
निष्कर्ष
Databricks SQL एक शक्तिशाली प्लेटफ़ॉर्म है जो डेटा लेक्स और डेटा वेयरहाउस के बीच की खाई को पाटता है, और आधुनिक डेटा एनालिटिक्स व बिज़नेस इंटेलिजेंस के लिए एकीकृत समाधान प्रदान करता है। चाहे आप डैशबोर्ड बना रहे हों, क्वेरियों को ऑप्टिमाइज़ कर रहे हों, या अलर्ट्स के साथ डेटा मॉनिटर कर रहे हों—Databricks SQL आज की डेटा चुनौतियों को संभालने के लिए आवश्यक लचीलापन और प्रदर्शन देता है। मैं आपको Databricks SQL की विशेषताओं और क्षमताओं का अन्वेषण करने के लिए प्रोत्साहित करता हूँ, ताकि आप अपने डेटा वर्कफ़्लोज़ को बेहतर बना सकें, सहयोग को सशक्त कर सकें, और तेज़, अधिक समझदारी भरे निर्णय ले सकें।
यदि आप एक प्रोफेशनल डेटा इंजीनियर बनना चाहते हैं, तो मैं हमारे Understanding Data Engineering कोर्स की अत्यधिक सिफारिश करता हूँ, जिसमें आप सीखेंगे कि डेटा इंजीनियर्स डेटा को कैसे स्टोर और प्रोसेस करते हैं ताकि डेटा साइंटिस्ट्स के साथ सहयोग सुगम हो। मैं हमारे Data-Driven Decision-Making in SQL कोर्स की भी सिफारिश करता हूँ, जिसमें आप वास्तविक परियोजनाओं का उपयोग करके निर्णय-निर्माण को सपोर्ट करने के लिए SQL का उपयोग करना सीखेंगे। और, बेशक, हमारे बेहतरीन cloud courses संग्रह पर नज़र डालना न भूलें।


Databricks SQL, Databricks Lakehouse प्लेटफ़ॉर्म में डेटा प्रबंधन और एनालिटिक्स के लिए बनाया गया एक शक्तिशाली टूल है। यह प्लेटफ़ॉर्म डेटा इंजीनियरिंग, डेटा साइंस, और बिज़नेस एनालिटिक्स को एकीकृत अनुभव में समेकित करता है। इसलिए, Databricks SQL उन डेटा प्रोफेशनल्स के लिए महत्वपूर्ण है जो पारंपरिक इन्फ्रास्ट्रक्चर मैनेजमेंट की जटिलता के बिना अपने डेटा वर्कफ़्लोज़, क्वेरी निष्पादन और BI कार्यों को सरल बनाना चाहते हैं।
इस लेख में, मैं Databricks SQL के घटकों, विशेषताओं और टूल्स का अन्वेषण करूंगा और Databricks SQL वेयरहाउस बनाने व उपयोग करने के व्यावहारिक उदाहरण दिखाऊंगा। आरंभ करने से पहले, मैं DataCamp के Introduction to Databricks कोर्स की सिफारिश करता हूँ, ताकि आप Databricks को Business Intelligence (BI) के लिए एक डेटा वेयरहाउसिंग समाधान के रूप में जान सकें और SQL-ऑप्टिमाइज़्ड क्षमताओं का उपयोग करके क्वेरी बनाना और डेटा का विश्लेषण करना सीख सकें।
Databricks SQL क्या है?
Databricks SQL, Databricks Lakehouse प्लेटफ़ॉर्म के भीतर एक मज़बूत एनालिटिक्स टूल है, जो डेटा प्रोफेशनल्स को SQL क्वेरी चलाने, डेटा का विश्लेषण करने और इंटरैक्टिव डैशबोर्ड बनाने की अनुमति देता है। सर्वरलेस आर्किटेक्चर के साथ डिज़ाइन किया गया, Databricks SQL डेटा लेक्स की लचीलेपन को डेटा वेयरहाउस की गवर्नेंस और परफॉर्मेंस क्षमताओं के साथ जोड़ता है।
Databricks SQL के प्रमुख घटकों में SQL Warehouses, SQL Editors, और SQL Dashboards शामिल हैं। यदि आप इनमें से प्रत्येक से परिचित नहीं हैं तो चिंता की बात नहीं—मैं नीचे इनके अर्थ समझाऊंगा।
Databricks SQL बनाम SQL Server और अन्य
MySQL, PostgreSQL, या SQL Server जैसे अन्य SQL डायलैक्ट, जो ट्रांज़ैक्शनल डेटाबेस के लिए बनाए गए हैं, उनसे अलग, Databricks SQL Lakehouse परिवेश में बड़े पैमाने पर एनालिटिक्स के लिए ऑप्टिमाइज़्ड है। पारंपरिक SQL डेटाबेस संरचित डेटा स्टोरेज पर केंद्रित होते हैं, जबकि Databricks SQL डेटा लेक्स के साथ एकीकृत होता है और साथ ही डेटा वेयरहाउस के प्रदर्शन को बनाए रखता है। सर्वरलेस SQL वेयरहाउसेज़ के साथ, इन्फ्रास्ट्रक्चर मैनेज करने की ज़रूरत नहीं रहती—रिसोर्स अपने आप प्रोविज़न होते हैं और इलास्टिक तरीके से स्केल होते हैं।
इसके अलावा, Databricks SQL में क्वेरी निष्पादन तेज़ होता है क्योंकि इसे Photon इंजन द्वारा त्वरित किया जाता है, जो वेक्टराइज़्ड प्रोसेसिंग सपोर्ट करता है। अंत में, Databricks SQL BI और सहयोग के लिए बना है; इसमें Power BI, Tableau, और Looker के लिए नैटिव सपोर्ट उपलब्ध है।
Databricks SQL के मुख्य घटक
Databricks SQL के मुख्य घटक कुशल क्वेरीइंग, डेटा विज़ुअलाइज़ेशन और उपयोगकर्ताओं के बीच सहयोग को सुगम बनाते हैं। नीचे Databricks SQL के भीतर उपलब्ध प्रमुख टूल्स और फ़ीचर्स का एक अवलोकन दिया गया है।
SQL Warehouses
SQL Warehouses, Databricks SQL में SQL क्वेरियों को निष्पादित करने के लिए कम्प्यूटेशनल रिसोर्स के रूप में कार्य करते हैं। इन्हें विविध वर्कलोड संभालने और चुने गए वेयरहाउस के प्रकार के आधार पर परफॉर्मेंस ऑप्टिमाइज़ेशन प्रदान करने के लिए डिज़ाइन किया गया है। SQL Warehouses के तीन मुख्य प्रकार हैं:
Databricks SQL में SQL Warehouse. चित्र: लेखक द्वारा।
SQL Editor
SQL Editor एक उपयोगकर्ता-अनुकूल इंटरफ़ेस है जो उपयोगकर्ताओं को SQL क्वेरी लिखने, चलाने और प्रबंधित करने में सक्षम बनाता है। SQL Editor की प्रमुख विशेषताएँ:
Databricks SQL में SQL Editor. चित्र: लेखक द्वारा।
Dashboards
डैशबोर्ड्स क्वेरी के परिणामों को इंटरैक्टिव चार्ट, ग्राफ़ और विजेट्स में बदलकर डेटा विज़ुअलाइज़ेशन सक्षम करते हैं। डैशबोर्ड्स प्रमुख मीट्रिक्स की निगरानी और संगठन भर में इनसाइट्स के प्रभावी संप्रेषण के लिए आदर्श हैं। डैशबोर्ड्स की प्रमुख क्षमताएँ:
Databricks SQL में डैशबोर्ड्स। चित्र: लेखक द्वारा।
Alerts
Databricks SQL में अलर्ट्स डेटा में बदलावों की निगरानी करने और निर्दिष्ट शर्तें पूरी होने पर नोटिफिकेशन्स ट्रिगर करने का तरीका प्रदान करते हैं। अलर्ट्स डेटा गुणवत्ता बनाए रखने और महत्वपूर्ण परिवर्तनों पर समय पर प्रतिक्रिया सुनिश्चित करने के लिए आवश्यक हैं। अलर्ट की कार्यप्रणाली इस प्रकार काम करती है।
क्वेरी हिस्ट्री और प्रोफाइलिंग
अंत में, Databricks SQL क्वेरी हिस्ट्री और प्रोफाइलिंग को ट्रैक करने के लिए टूल्स प्रदान करता है:
Databricks SQL में Query History. चित्र: लेखक द्वारा।
Databricks SQL की प्रमुख विशेषताएँ और टूल्स
Databricks SQL उन्नत विशेषताओं और टूल्स से भरपूर है। ये विशेषताएँ प्रदर्शन बढ़ाने, वर्कफ़्लोज़ को सुव्यवस्थित करने और अन्य टूल्स के साथ सहज इंटीग्रेशन सक्षम करने के लिए डिज़ाइन की गई हैं। आइए देखें कि कौन-सी प्रमुख बातें Databricks SQL को बेहतरीन विकल्प बनाती हैं।
Photon Engine
Photon Engine एक उच्च-प्रदर्शन, वेक्टराइज़्ड क्वेरी इंजन है जिसे Databricks ने SQL क्वेरी निष्पादन में उल्लेखनीय तेजी लाने के लिए विकसित किया है। Photon Engine के प्रमुख लाभ:
CloudFetch और Async I/O
CloudFetch और Async I/O डेटा ट्रांसफ़र स्पीड बढ़ाने और क्वेरी निष्पादन के दौरान छोटे फ़ाइलों के हैंडलिंग को बेहतर बनाने के लिए डिज़ाइन की गई विशेषताएँ हैं। ये इस प्रकार काम करती हैं:
BI टूल्स के साथ इंटीग्रेशन
Databricks SQL लोकप्रिय Business Intelligence (BI) टूल्स के साथ सहजता से इंटीग्रेट होता है, जिससे टीमों के लिए डेटा का विश्लेषण और विज़ुअलाइज़ेशन आसान हो जाता है। समर्थित इंटीग्रेशन्स में शामिल हैं:
सर्वरलेस आर्किटेक्चर
Databricks SQL का सर्वरलेस आर्किटेक्चर वर्कलोड की माँगों के आधार पर रिसोर्स को अपने आप प्रोविज़न और स्केल करके मैन्युअल इन्फ्रास्ट्रक्चर मैनेजमेंट की आवश्यकता को समाप्त करता है। सर्वरलेस आर्किटेक्चर डाउनटाइम के बिना अलग-अलग क्वेरी लोड हैंडल करने के लिए रिसोर्स को स्वतः समायोजित करता है। इससे उपयोगकर्ताओं को क्लस्टर्स को मैन्युअल रूप से कॉन्फ़िगर या मेंटेन करने की ज़रूरत नहीं रहती। सर्वरलेस आर्किटेक्चर किफायती भी है, क्योंकि उपयोगकर्ता केवल क्वेरी निष्पादन के दौरान उपयोग किए गए रिसोर्स के लिए भुगतान करते हैं।
उदाहरण के लिए, एक रिटेल कंपनी पीक बिज़नेस आवर्स के दौरान उच्च क्वेरी लोड का अनुभव करती है। सर्वरलेस आर्किटेक्चर प्रदर्शन को स्थिर बनाए रखने के लिए अपने आप रिसोर्स स्केल-अप करता है और ऑफ-ऑवर्स में लागत बचाने के लिए स्केल-डाउन कर देता है।
Databricks SQL Warehouses बनाने और उपयोग करने की चरण-दर-चरण गाइड
Databricks SQL Warehouses, Databricks परिवेश में SQL क्वेरियों को कुशलतापूर्वक निष्पादित करने के लिए आवश्यक हैं। अब इस खंड में, मैं आपको SQL वेयरहाउस बनाने और उसे नोटबुक्स के साथ उपयोग करने की प्रक्रिया बताऊँगा। यदि आपको डेटा वेयरहाउसिंग के अपने ज्ञान को ताज़ा करने की ज़रूरत है, तो मैं हमारे Data Warehousing Concepts कोर्स को लेने की सलाह देता हूँ, जिसमें डेटा मॉडलिंग और डेटा ट्रांसफ़ॉर्मेशन की मूल बातें सिखाई जाती हैं।
Databricks SQL Warehouse बनाना
Databricks वेब UI का उपयोग करके SQL Warehouse बनाने के लिए ये चरण अपनाएँ:
चरण 1: Databricks SQL पेज पर जाएँ
Databricks वर्कस्पेस से, साइडबार में SQL आइकन पर क्लिक करें।
Databricks SQL पेज। चित्र: लेखक द्वारा।
चरण 2: SQL Warehouses टैब खोलें
SQL पेज पर, SQL Warehouses टैब पर जाएँ।
Databricks SQL Warehouse टैब। चित्र: लेखक द्वारा।
चरण 3: "Create Warehouse" पर क्लिक करें
अपने नए SQL Warehouse की कॉन्फ़िगरेशन शुरू करने के लिए Create Warehouse बटन पर क्लिक करें।
Databricks SQL पर SQL Warehouse बनाना। चित्र: लेखक द्वारा।
चरण 4: बुनियादी सेटिंग्स कॉन्फ़िगर करें
निम्न विकल्पों का उपयोग करके वेयरहाउस सेटिंग्स कॉन्फ़िगर करें।
Databricks SQL Warehouse के लिए बुनियादी सेटिंग्स कॉन्फ़िगर करें। चित्र: लेखक द्वारा।
चरण 5: उन्नत विकल्प (वैकल्पिक)
आवश्यक हो तो, Photon सक्षम करने या विशिष्ट SQL कॉन्फ़िगरेशन सेट करने जैसे उन्नत विकल्प कॉन्फ़िगर करें।
Databricks SQL Warehouse के लिए उन्नत सेटिंग्स कॉन्फ़िगर करें। चित्र: लेखक द्वारा।
चरण 6: वेयरहाउस सेव और स्टार्ट करें
अपनी कॉन्फ़िगरेशन सेव करने के लिए Create पर क्लिक करें। बन जाने के बाद, वेयरहाउस को स्टार्ट करें ताकि यह ऑपरेशनल हो जाए।
Databricks SQL Warehouse बनाना। चित्र: लेखक द्वारा।
चरण 7: परमिशन्स सेट करें (वैकल्पिक)
बनने के बाद, एक परमिशन्स मोडल दिखेगा जहाँ आप उपयोगकर्ताओं या समूहों को वेयरहाउस की एक्सेस दे सकते हैं।
Databricks SQL Warehouse की परमिशन्स प्रबंधित करना। चित्र: लेखक द्वारा।
बनने के बाद, आपका SQL वेयरहाउस अपने आप स्टार्ट हो जाएगा, जिससे आप तुरंत क्वेरियाँ निष्पादित कर सकेंगे।
Databricks SQL Warehouse का उदाहरण। चित्र: लेखक द्वारा।
Databricks SQL Warehouse के साथ नोटबुक का उपयोग
अपने नए बनाए गए SQL वेयरहाउस का उपयोग करते हुए नोटबुक में SQL क्वेरियाँ निष्पादित करने के लिए ये चरण अपनाएँ:
चरण 1: नोटबुक खोलें या बनाएँ
Databricks वर्कस्पेस से एक नई नोटबुक बनाएँ या मौजूदा नोटबुक खोलें।
Databricks SQL Warehouse बनाने के लिए नई नोटबुक बनाना। चित्र: लेखक द्वारा।
चरण 2: SQL Warehouse अटैच करें
Notebook टूलबार में, कंप्यूट सेलेक्टर या कनेक्ट (आमतौर पर शीर्ष पर) ढूँढें। उपलब्ध कंप्यूट रिसोर्स दिखाने वाला ड्रॉपडाउन खोलने के लिए उस पर क्लिक करें। सूची में से अपना SQL वेयरहाउस चुनें। यदि यह दिखाई नहीं दे रहा हो, तो सभी उपलब्ध वेयरहाउस देखने के लिए More… पर क्लिक करें। इच्छित SQL वेयरहाउस पर क्लिक करें और फिर Start and attach चुनें।
Databricks SQL Warehouse में नोटबुक अटैच करें। चित्र: लेखक द्वारा।
चरण 3: SQL क्वेरियाँ लिखें
अटैच होने के बाद, आप अपनी नोटबुक में SQL क्वेरियों के लिए सेल बना सकते हैं। नोटबुक में SQL क्वेरियाँ चलाने के लिए
%sqlमैजिक कमांड का उपयोग करें।Databricks SQL Warehouse में SQL क्वेरियाँ लिखें। चित्र: लेखक द्वारा।
चरण 4: क्वेरियाँ निष्पादित करें
अपनी क्वेरी चलाने के लिए सेल रन करें। परिणाम सीधे सेल के नीचे प्रदर्शित होंगे, जिससे डेटा का प्रीव्यू करना आसान हो जाता है।
Databricks SQL Warehouse में SQL क्वेरियाँ निष्पादित करें। चित्र: लेखक द्वारा।
SQL Warehouse के साथ नोटबुक उपयोग करने के विचार
SQL Warehouses के साथ नोटबुक का उपयोग करते समय ये कुछ विचार ध्यान में रखें:
Query Limits: SQL Warehouses विश्लेषणात्मक क्वेरियों के लिए ऑप्टिमाइज़्ड हैं, बारंबार, लो-लेटेंसी ट्रांज़ैक्शनल क्वेरियों के लिए नहीं।
Data Preview: बड़े डेटासेट्स के लिए, अपने क्वेरी परिणामों को सीमित करने पर विचार करें, जैसे प्रदर्शन बाधाओं से बचने के लिए
LIMITक्लॉज़ का उपयोग।Query Caching: दोहराई गई क्वेरियों को तेज़ करने के लिए रिज़ल्ट कैशिंग का फायदा उठाएँ।
Resource Usage: यह सुनिश्चित करने के लिए SQL Warehouse के उपयोग पर नज़र रखें कि क्लस्टर का आकार और स्केलिंग सेटिंग्स आपके वर्कलोड की ज़रूरतों को पूरा करते हैं।
निष्कर्ष
Databricks SQL एक शक्तिशाली प्लेटफ़ॉर्म है जो डेटा लेक्स और डेटा वेयरहाउस के बीच की खाई को पाटता है, और आधुनिक डेटा एनालिटिक्स व बिज़नेस इंटेलिजेंस के लिए एकीकृत समाधान प्रदान करता है। चाहे आप डैशबोर्ड बना रहे हों, क्वेरियों को ऑप्टिमाइज़ कर रहे हों, या अलर्ट्स के साथ डेटा मॉनिटर कर रहे हों—Databricks SQL आज की डेटा चुनौतियों को संभालने के लिए आवश्यक लचीलापन और प्रदर्शन देता है। मैं आपको Databricks SQL की विशेषताओं और क्षमताओं का अन्वेषण करने के लिए प्रोत्साहित करता हूँ, ताकि आप अपने डेटा वर्कफ़्लोज़ को बेहतर बना सकें, सहयोग को सशक्त कर सकें, और तेज़, अधिक समझदारी भरे निर्णय ले सकें।
यदि आप एक प्रोफेशनल डेटा इंजीनियर बनना चाहते हैं, तो मैं हमारे Understanding Data Engineering कोर्स की अत्यधिक सिफारिश करता हूँ, जिसमें आप सीखेंगे कि डेटा इंजीनियर्स डेटा को कैसे स्टोर और प्रोसेस करते हैं ताकि डेटा साइंटिस्ट्स के साथ सहयोग सुगम हो। मैं हमारे Data-Driven Decision-Making in SQL कोर्स की भी सिफारिश करता हूँ, जिसमें आप वास्तविक परियोजनाओं का उपयोग करके निर्णय-निर्माण को सपोर्ट करने के लिए SQL का उपयोग करना सीखेंगे। और, बेशक, हमारे बेहतरीन cloud courses संग्रह पर नज़र डालना न भूलें।