Kursus
Pengantar Databricks
3 jam
49K
Databricks SQL adalah alat yang andal untuk manajemen dan analitik data dalam platform Databricks Lakehouse. Platform ini mengintegrasikan rekayasa data, sains data, dan analitik bisnis dalam satu pengalaman terpadu. Karena itu, Databricks SQL penting bagi para profesional data yang ingin merampingkan alur kerja data, eksekusi kueri, dan tugas BI tanpa kerumitan pengelolaan infrastruktur tradisional.
Dalam artikel ini, saya akan membahas komponen, fitur, dan alat Databricks SQL serta menunjukkan contoh praktis cara membuat dan menggunakan gudang Databricks SQL. Saat kita mulai, saya sangat merekomendasikan mengikuti kursus Introduction to Databricks dari DataCamp untuk mempelajari Databricks sebagai solusi data warehousing bagi Business Intelligence (BI), memanfaatkan kapabilitas yang dioptimalkan untuk SQL guna membuat kueri dan menganalisis data.
Databricks SQL adalah alat analitik yang tangguh dalam platform Databricks Lakehouse yang memungkinkan profesional data menjalankan kueri SQL, menganalisis data, dan membuat dasbor interaktif. Dirancang dengan arsitektur serverless, Databricks SQL menggabungkan fleksibilitas data lake dengan tata kelola dan kinerja data warehouse.
Komponen utama Databricks SQL mencakup SQL Warehouse, SQL Editor, dan SQL Dashboard. Jangan khawatir jika Anda belum familiar dengan masing-masingnya karena saya akan menjelaskan artinya di bawah ini.
Berbeda dengan dialek SQL lain seperti MySQL, PostgreSQL, atau SQL Server yang dirancang untuk basis data transaksional, Databricks SQL dioptimalkan untuk analitik skala besar dalam lingkungan Lakehouse. Basis data SQL tradisional berfokus pada penyimpanan data terstruktur, sedangkan Databricks SQL terintegrasi dengan data lake sambil mempertahankan performa layaknya data warehouse. Dengan serverless SQL warehouse, Anda tidak perlu mengelola infrastruktur karena sumber daya disediakan secara otomatis dan diskalakan secara elastis.
Selain itu, saya ingin menambahkan, di Databricks SQL, eksekusi kueri lebih cepat karena dipercepat oleh mesin Photon yang mendukung pemrosesan vektorisasi. Terakhir: Databricks SQL dibangun untuk BI dan kolaborasi; platform ini menawarkan dukungan native untuk Power BI, Tableau, dan Looker.
Komponen inti Databricks SQL memfasilitasi pengkuerian yang efisien, visualisasi data, dan kolaborasi antar pengguna. Berikut gambaran umum alat dan fitur utama yang tersedia di Databricks SQL.
SQL Warehouse berfungsi sebagai sumber daya komputasi untuk menjalankan kueri SQL di Databricks SQL. Warehouse ini dirancang untuk menangani berbagai beban kerja dan memberikan pengoptimalan performa berdasarkan jenis warehouse yang dipilih. Ada tiga jenis utama SQL Warehouse:
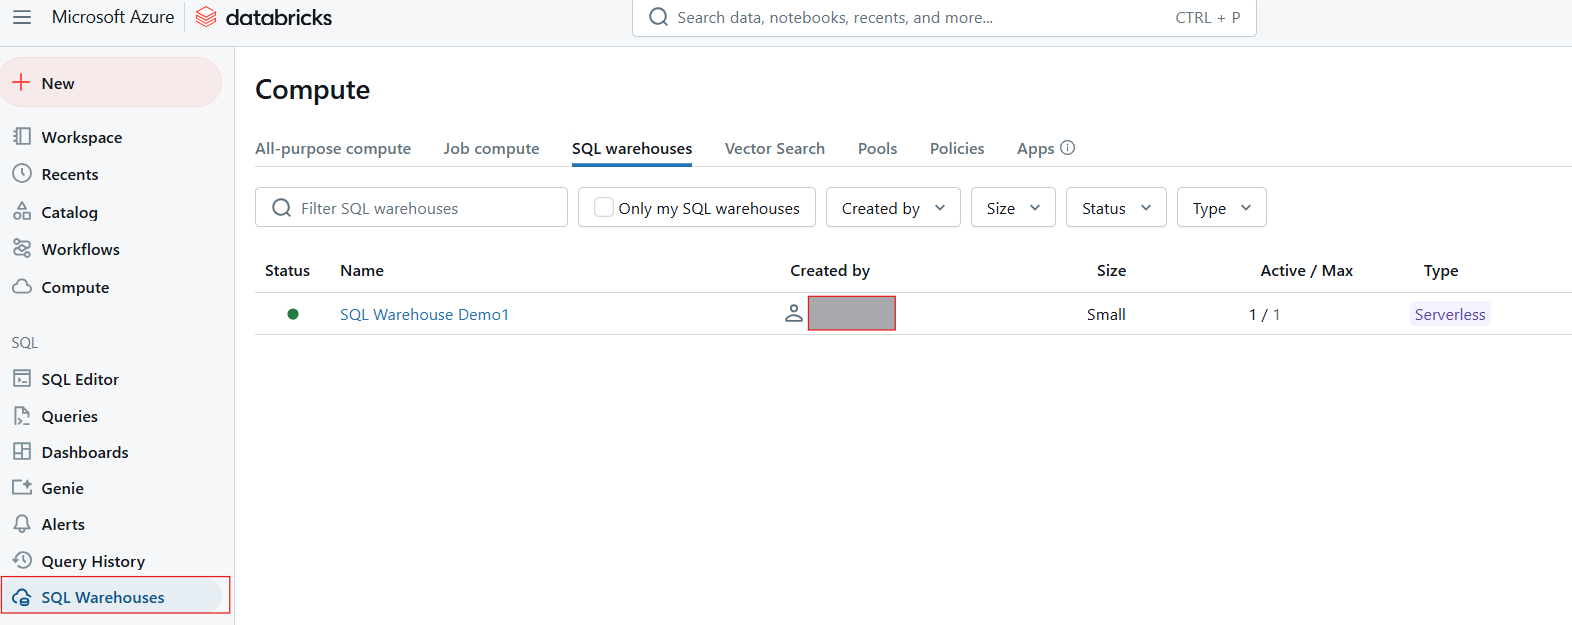
SQL Warehouse di Databricks SQL. Gambar oleh Penulis.
SQL Editor adalah antarmuka yang ramah pengguna yang memungkinkan pengguna menulis, menjalankan, dan mengelola kueri SQL. Fitur utama SQL Editor mencakup:
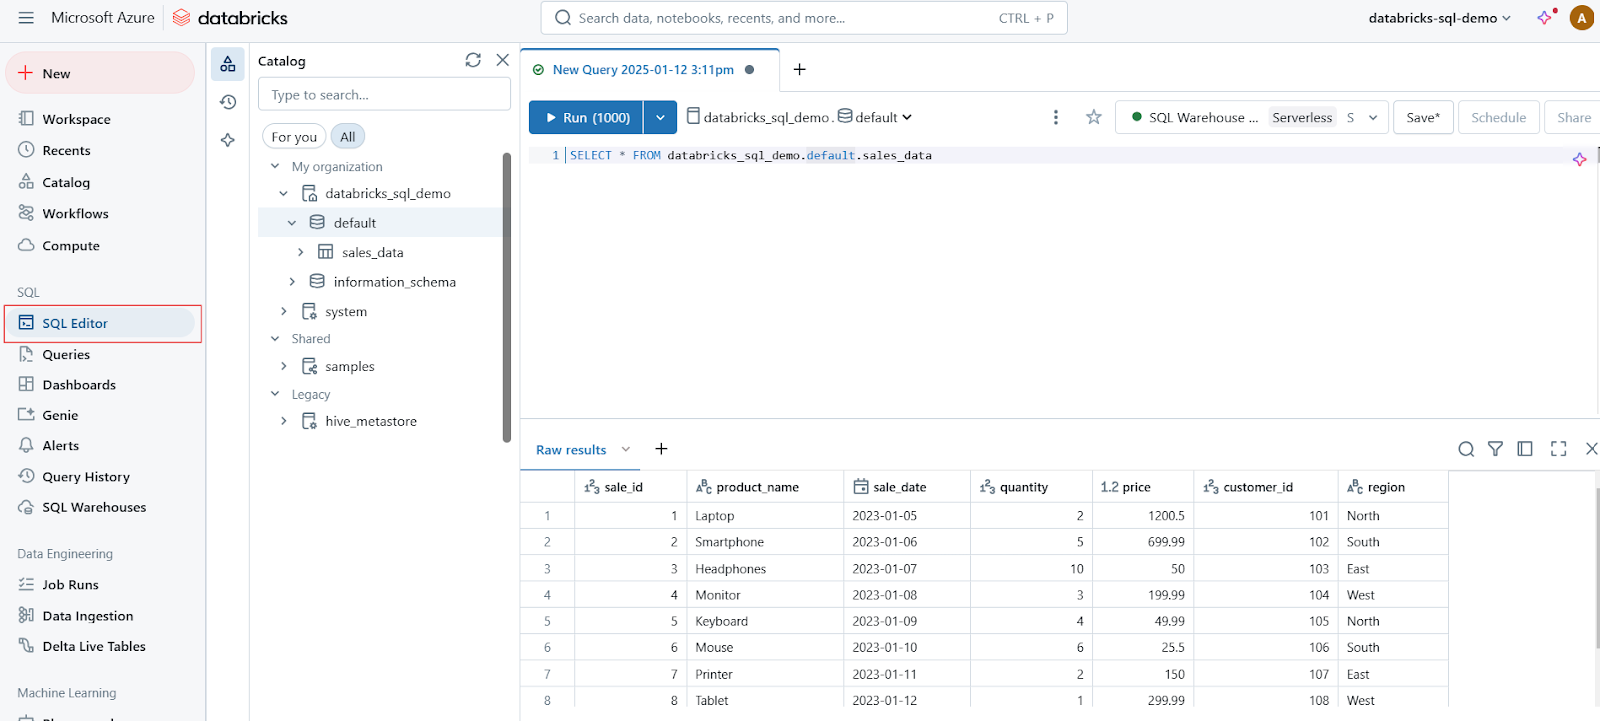
SQL Editor di Databricks SQL. Gambar oleh Penulis.
Dashboard memungkinkan visualisasi data dengan mengubah hasil kueri menjadi bagan, grafik, dan widget interaktif. Dashboard ideal untuk memantau metrik utama dan menyampaikan insight secara efektif di seluruh organisasi. Kapabilitas utama dashboard meliputi:
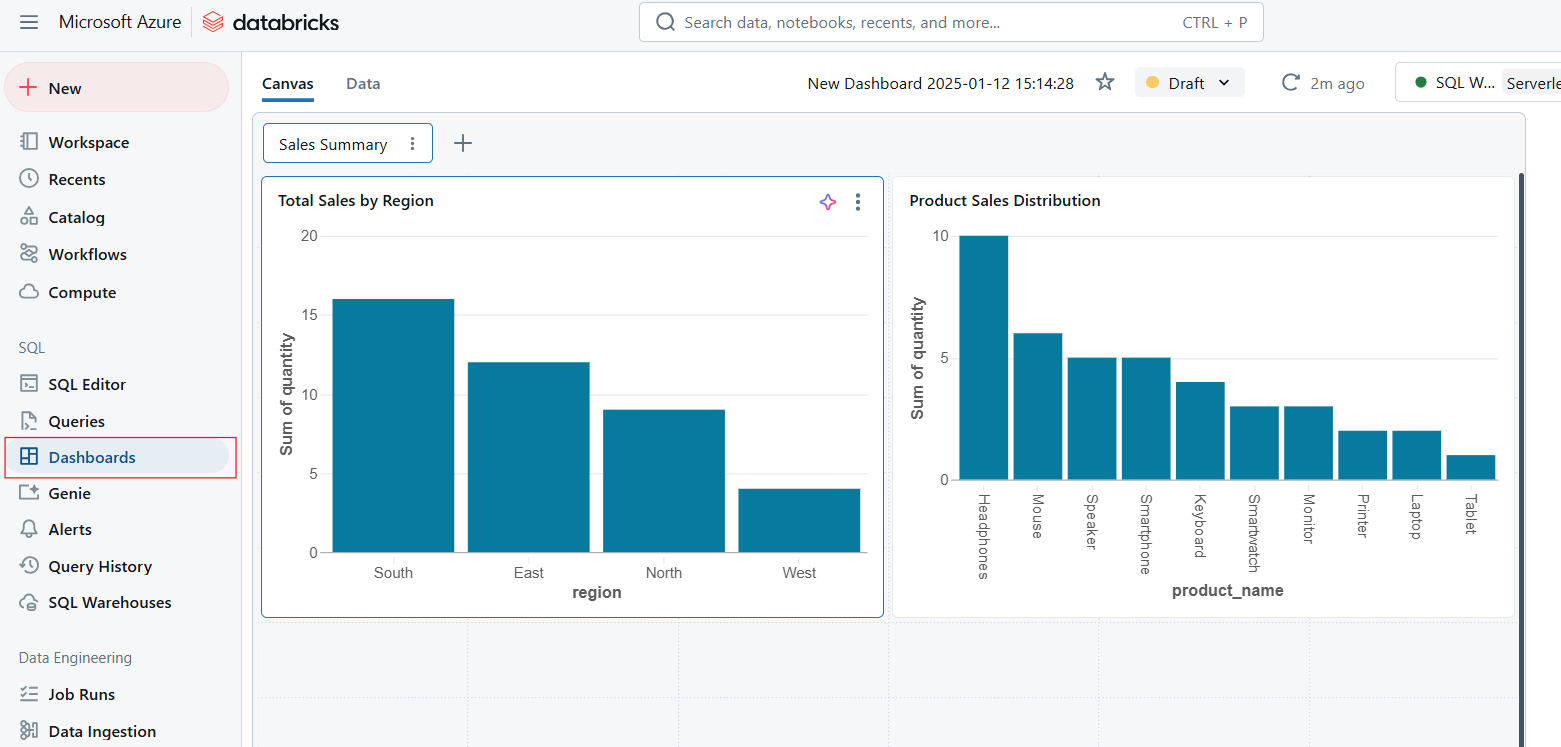
Dashboard di Databricks SQL. Gambar oleh Penulis.
Peringatan (Alerts) di Databricks SQL menyediakan cara untuk memantau perubahan data dan memicu notifikasi saat kondisi tertentu terpenuhi. Peringatan penting untuk menjaga kualitas data dan memastikan respons tepat waktu terhadap perubahan penting. Fungsionalitas peringatan bekerja sebagai berikut.
Terakhir, saya ingin menyampaikan bahwa Databricks SQL menawarkan alat untuk melacak riwayat kueri dan profiling:
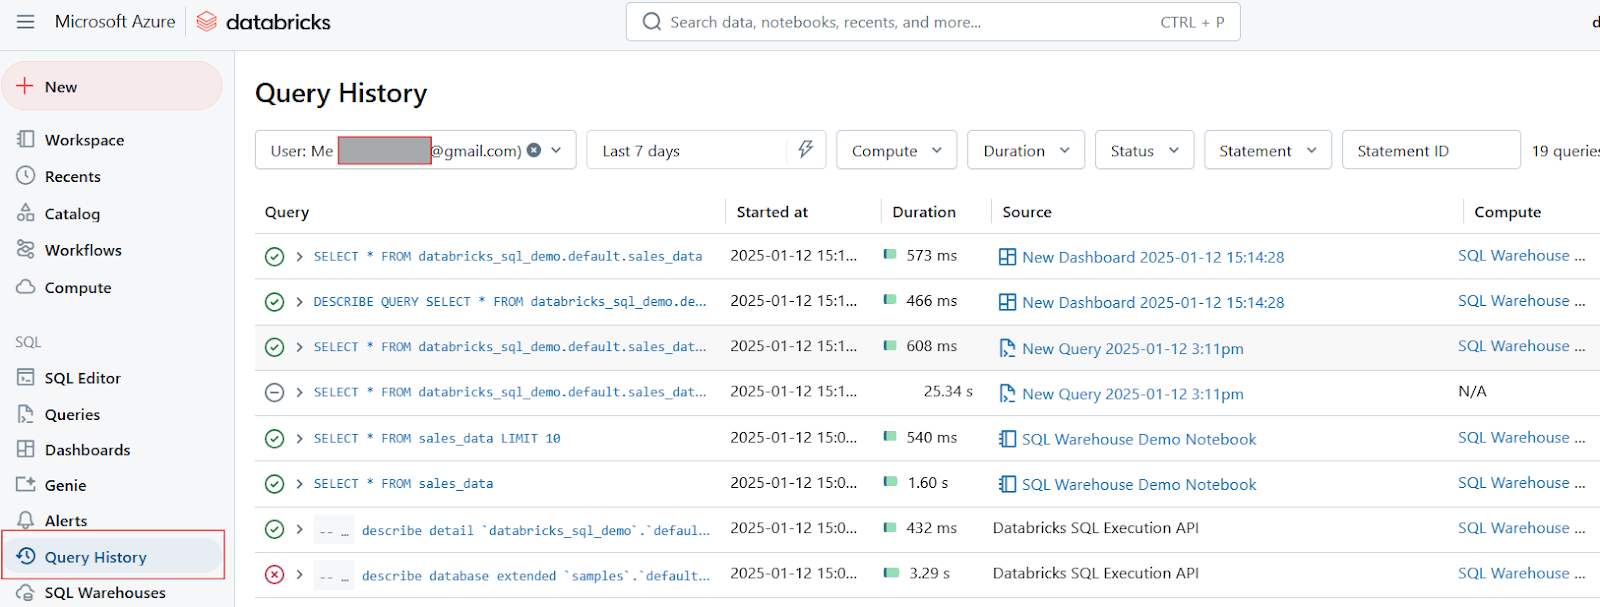
Riwayat Kueri di Databricks SQL. Gambar oleh Penulis.
Databricks SQL dilengkapi dengan fitur dan alat canggih. Fitur-fitur ini dirancang untuk meningkatkan performa, merampingkan alur kerja, dan memungkinkan integrasi mulus dengan alat lain. Mari lihat beberapa hal utama yang membuat Databricks SQL menjadi pilihan yang sangat baik.
Photon Engine adalah mesin kueri tervektorisasi berkinerja tinggi yang dikembangkan oleh Databricks untuk mempercepat eksekusi kueri SQL secara signifikan. Manfaat utama Photon Engine meliputi:
CloudFetch dan Async I/O adalah fitur yang dirancang untuk meningkatkan kecepatan transfer data dan memperbaiki penanganan berkas kecil selama eksekusi kueri. Fitur-fitur ini bekerja sebagai berikut:
Databricks SQL terintegrasi mulus dengan alat Business Intelligence (BI) populer, memudahkan tim untuk menganalisis dan memvisualisasikan data. Integrasi yang didukung meliputi:
Arsitektur serverless Databricks SQL menghilangkan kebutuhan pengelolaan infrastruktur manual dengan menyediakan dan menskalakan sumber daya secara otomatis berdasarkan permintaan beban kerja. Arsitektur serverless akan menyesuaikan sumber daya secara otomatis untuk menangani beban kueri yang bervariasi tanpa downtime. Fitur ini memastikan pengguna tidak perlu mengonfigurasi atau memelihara klaster secara manual. Arsitektur serverless juga hemat biaya, karena pengguna hanya membayar sumber daya yang digunakan selama eksekusi kueri.
Sebagai contoh, sebuah perusahaan ritel mengalami lonjakan beban kueri selama jam sibuk. Arsitektur serverless secara otomatis meningkatkan skala sumber daya untuk memastikan performa konsisten dan menurunkannya saat luar jam sibuk untuk menghemat biaya.
Databricks SQL Warehouse penting untuk menjalankan kueri SQL secara efisien dalam lingkungan Databricks. Sekarang, di bagian ini, saya akan memandu Anda melalui proses membuat gudang SQL dan menggunakannya dengan notebook. Jika Anda perlu menyegarkan pengetahuan tentang data warehouse, saya merekomendasikan mengikuti kursus Data Warehousing Concepts kami untuk mempelajari dasar-dasar pemodelan data dan transformasi data.
Ikuti langkah-langkah ini untuk membuat SQL Warehouse menggunakan antarmuka web Databricks:
Dari workspace Databricks, klik ikon SQL di bilah sisi.
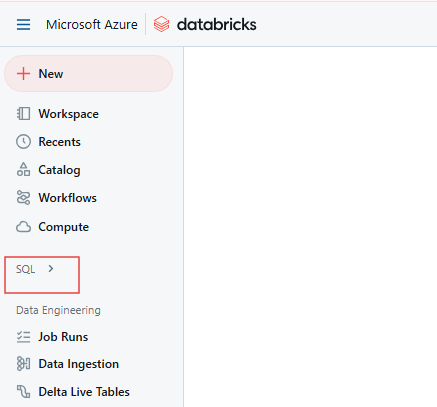
Halaman Databricks SQL. Gambar oleh Penulis.
Di halaman SQL, buka tab SQL Warehouses.
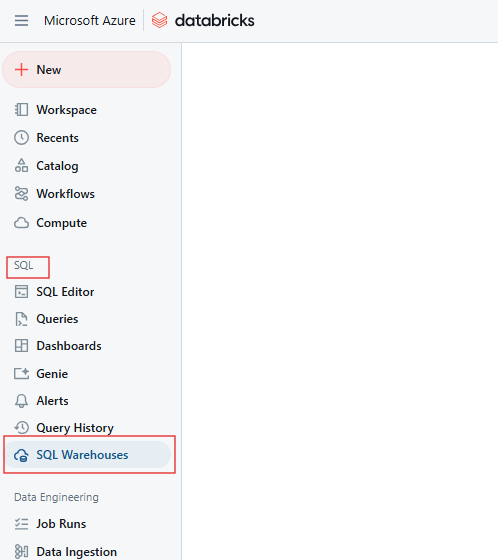
Tab Databricks SQL Warehouse. Gambar oleh Penulis.
Klik tombol Create Warehouse untuk mulai mengonfigurasi SQL Warehouse baru Anda.
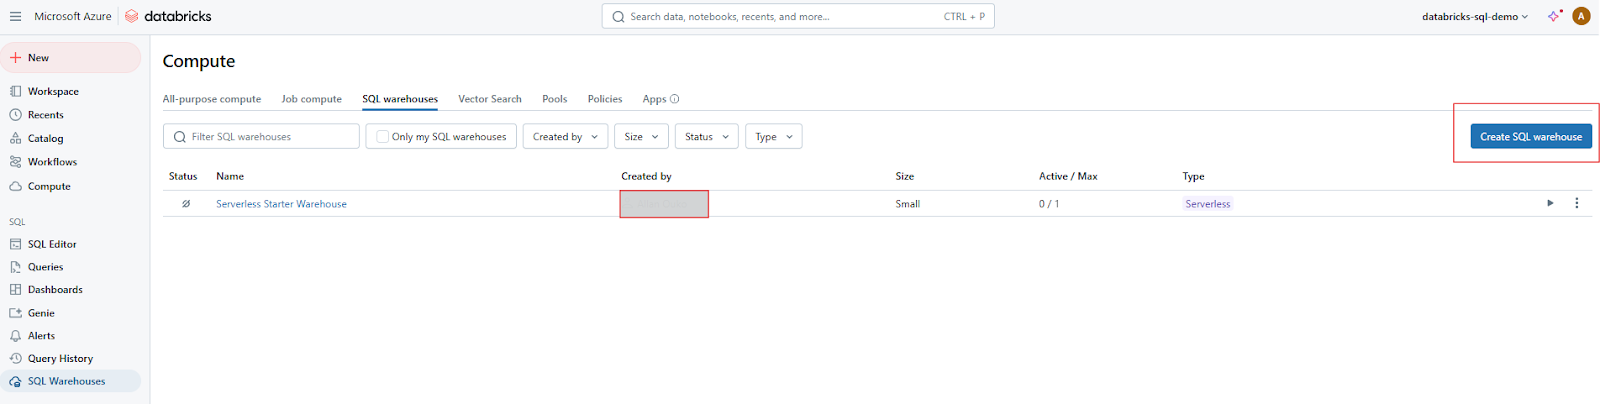
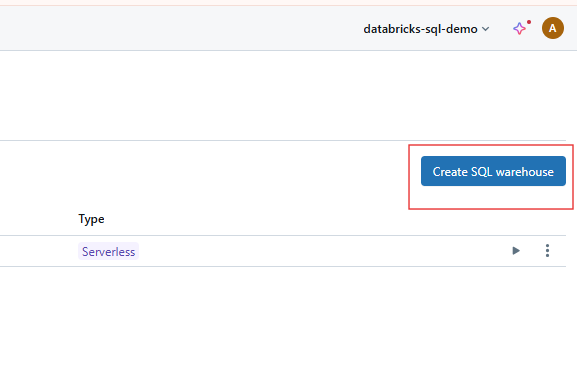
Membuat SQL Warehouse di Databricks SQL. Gambar oleh Penulis.
Konfigurasikan pengaturan warehouse menggunakan opsi berikut.
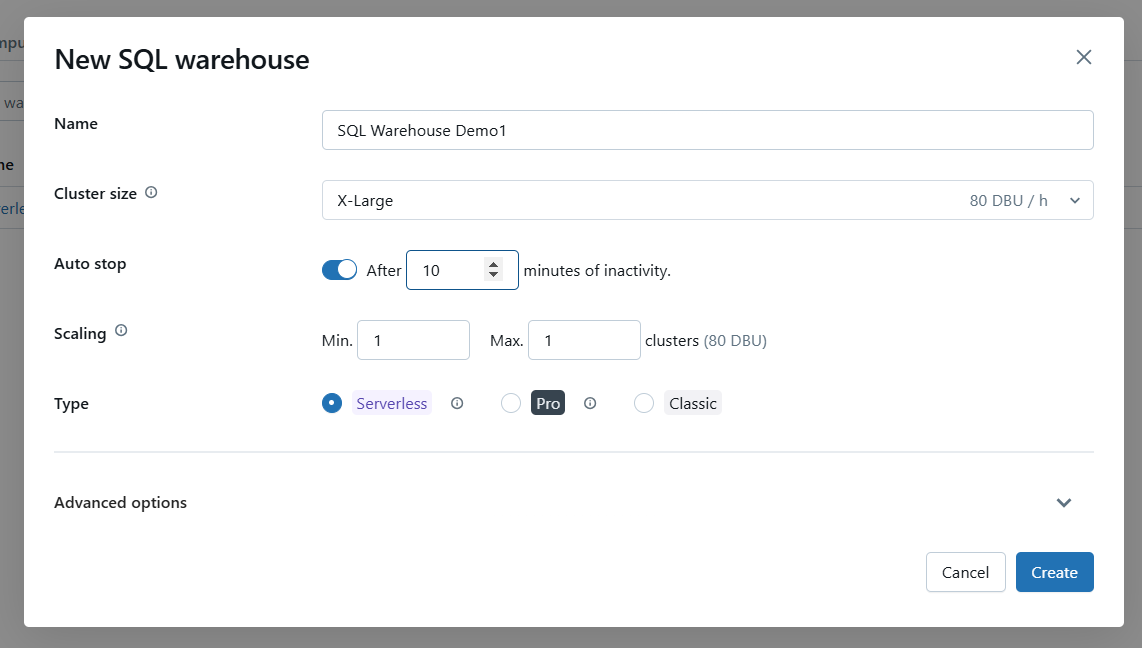
Konfigurasikan pengaturan dasar untuk Databricks SQL Warehouse. Gambar oleh Penulis.
Jika perlu, konfigurasikan opsi lanjutan seperti mengaktifkan Photon atau menetapkan konfigurasi SQL tertentu.
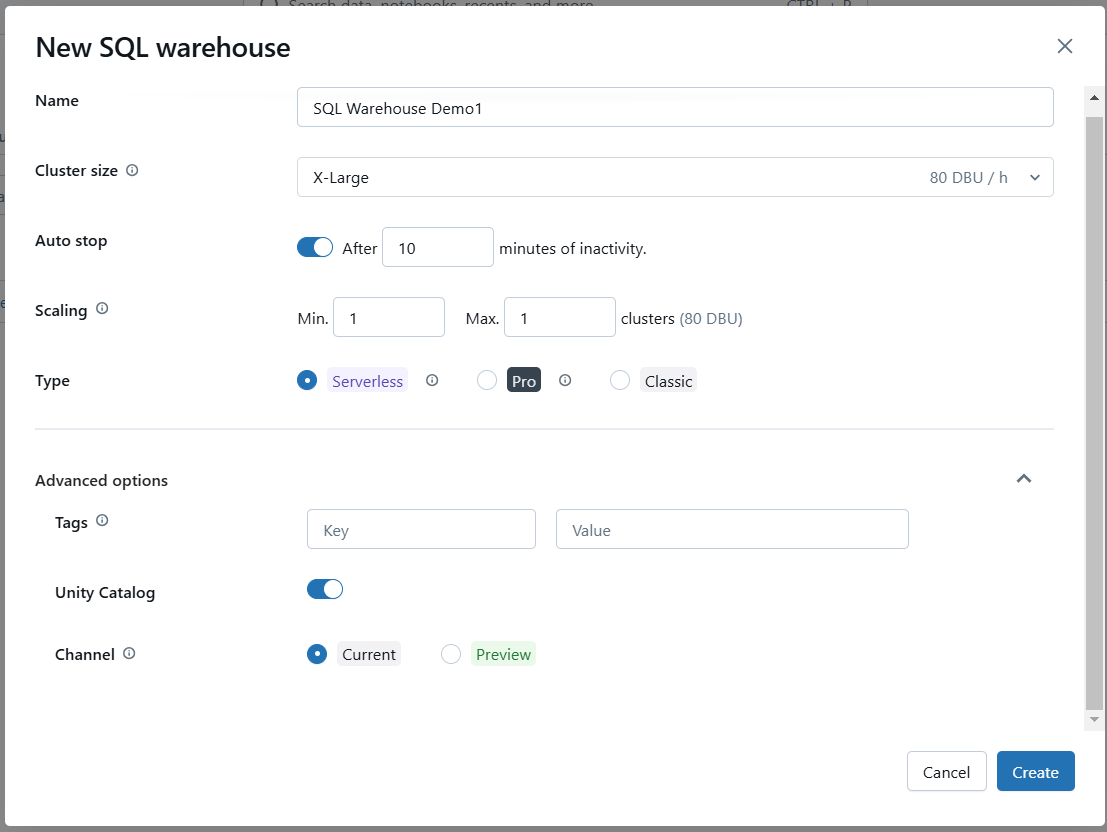
Konfigurasikan pengaturan lanjutan untuk Databricks SQL Warehouse. Gambar oleh Penulis.
Klik Create untuk menyimpan konfigurasi Anda. Setelah dibuat, mulai warehouse agar siap digunakan.
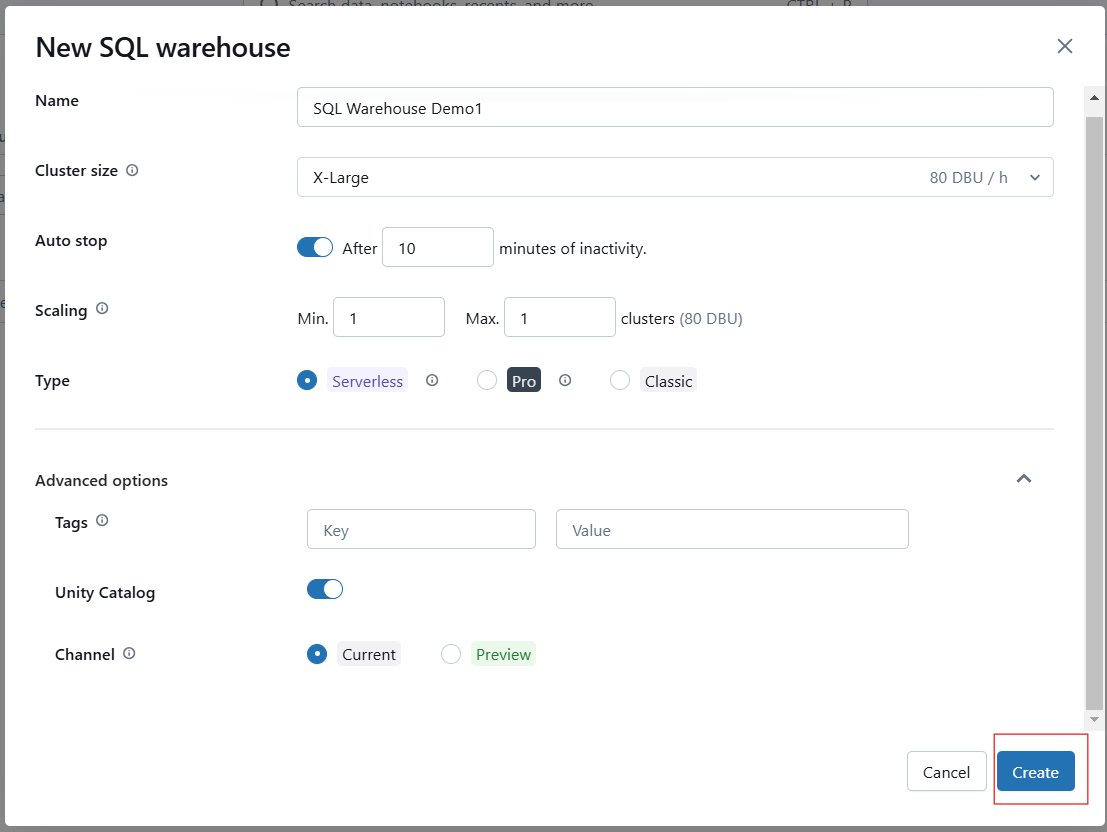
Membuat Databricks SQL Warehouse. Gambar oleh Penulis.
Setelah pembuatan, sebuah modal izin akan muncul tempat Anda dapat memberikan akses ke pengguna atau grup untuk warehouse tersebut.
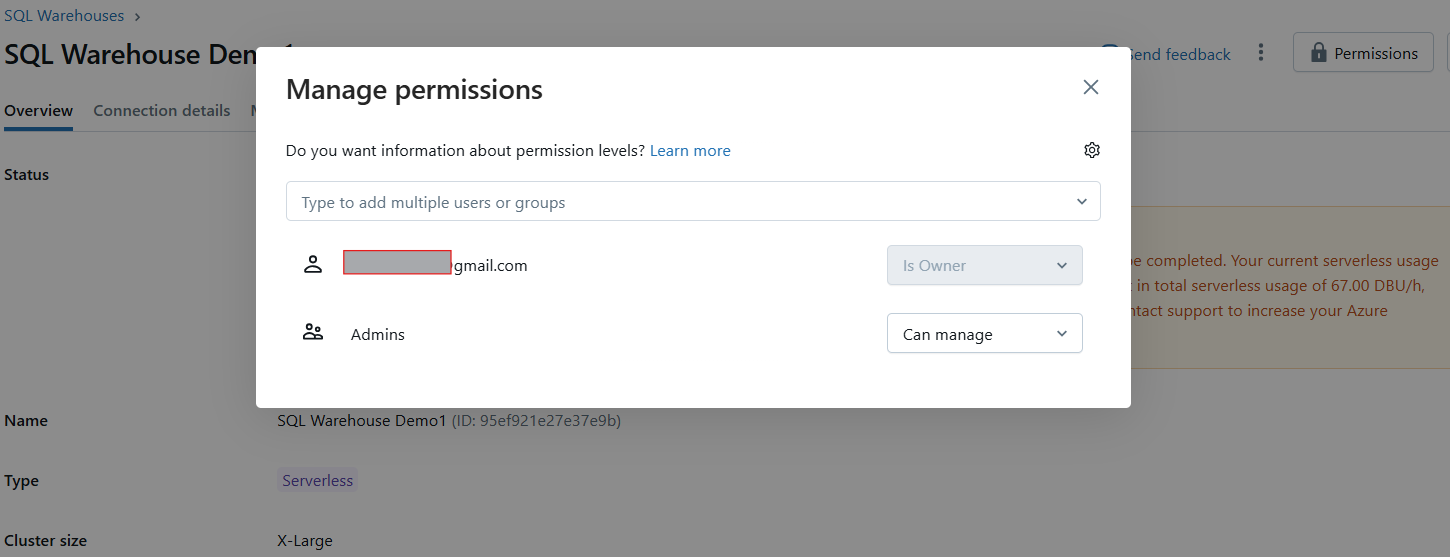
Mengelola izin Databricks SQL Warehouse. Gambar oleh Penulis.
Setelah dibuat, SQL warehouse Anda akan mulai otomatis, memungkinkan Anda mengeksekusi kueri segera.
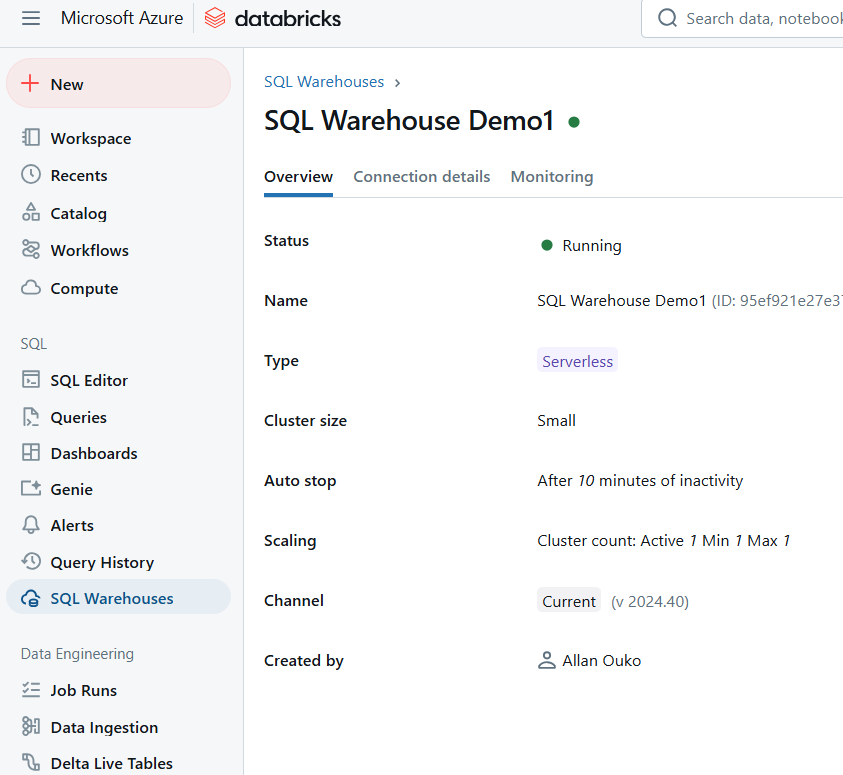
Contoh Databricks SQL Warehouse. Gambar oleh Penulis.
Untuk mengeksekusi kueri SQL di notebook menggunakan SQL warehouse yang baru Anda buat, ikuti langkah-langkah berikut:
Dari workspace Databricks, buat notebook baru atau buka yang sudah ada.
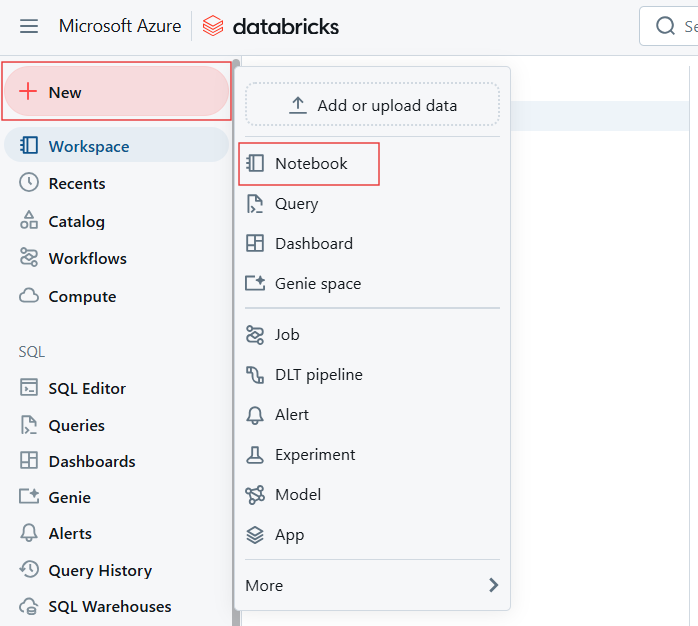
Membuat Notebook baru untuk membuat Databricks SQL Warehouse. Gambar oleh Penulis.
Di bilah alat Notebook, temukan pemilih komputasi atau connect (biasanya ditampilkan di bagian atas). Klik untuk membuka menu tarik-turun yang menampilkan sumber daya komputasi yang tersedia. Pilih SQL warehouse Anda dari daftar. Jika tidak terlihat, klik More… untuk melihat semua warehouse yang tersedia. Klik SQL warehouse yang diinginkan lalu pilih Start and attach.
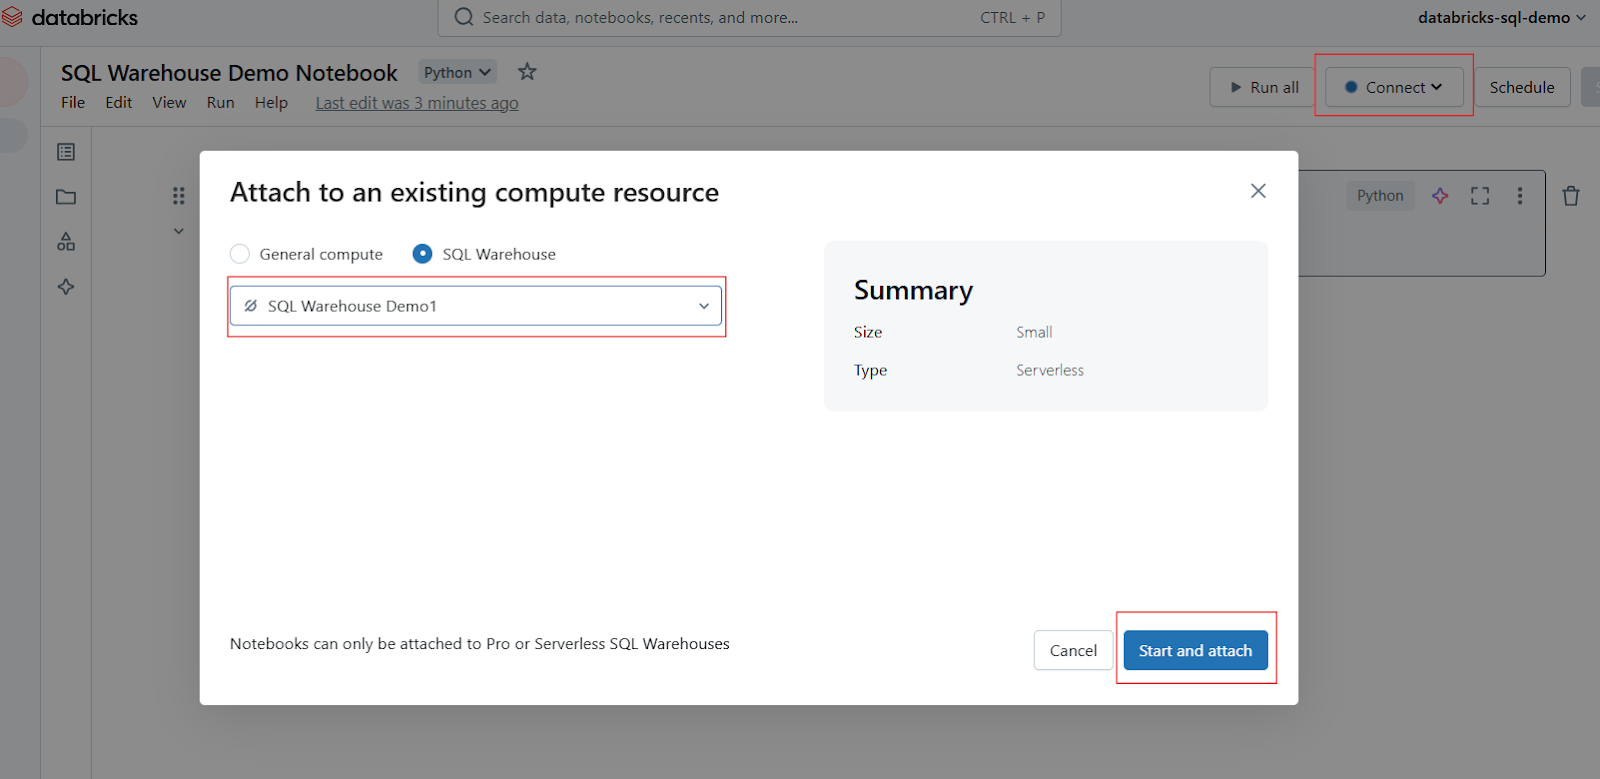
Melampirkan Notebook di Databricks SQL Warehouse. Gambar oleh Penulis.
Setelah terlampir, Anda dapat membuat sel di notebook Anda untuk kueri SQL. Gunakan perintah magic %sql untuk mengeksekusi kueri SQL di notebook.
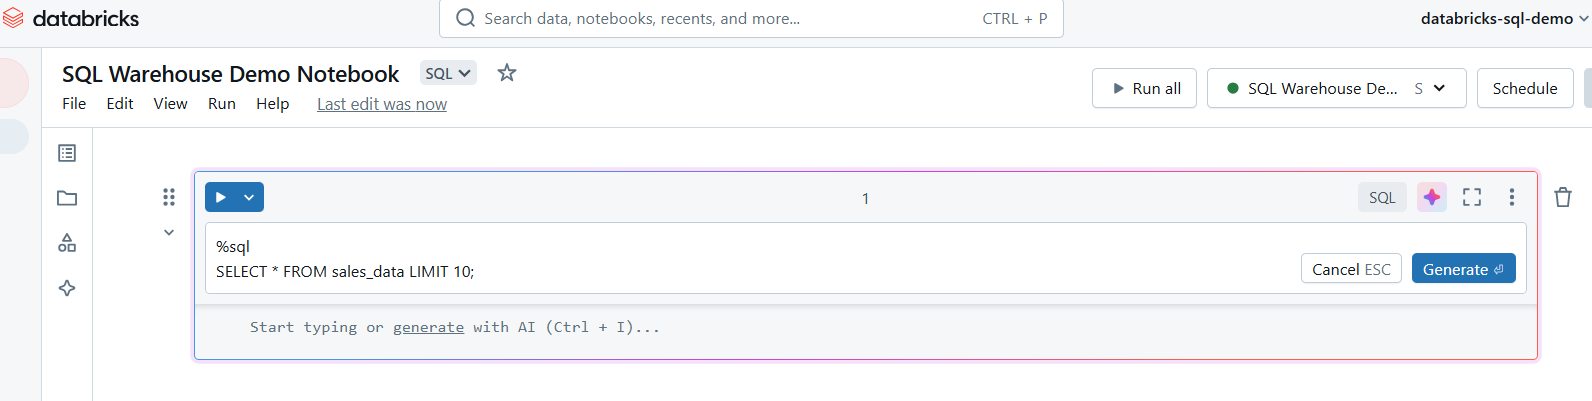
Tulis kueri SQL di Databricks SQL Warehouse. Gambar oleh Penulis.
Jalankan sel untuk mengeksekusi kueri Anda. Hasil akan ditampilkan tepat di bawah sel, sehingga mudah untuk melihat pratinjau data.
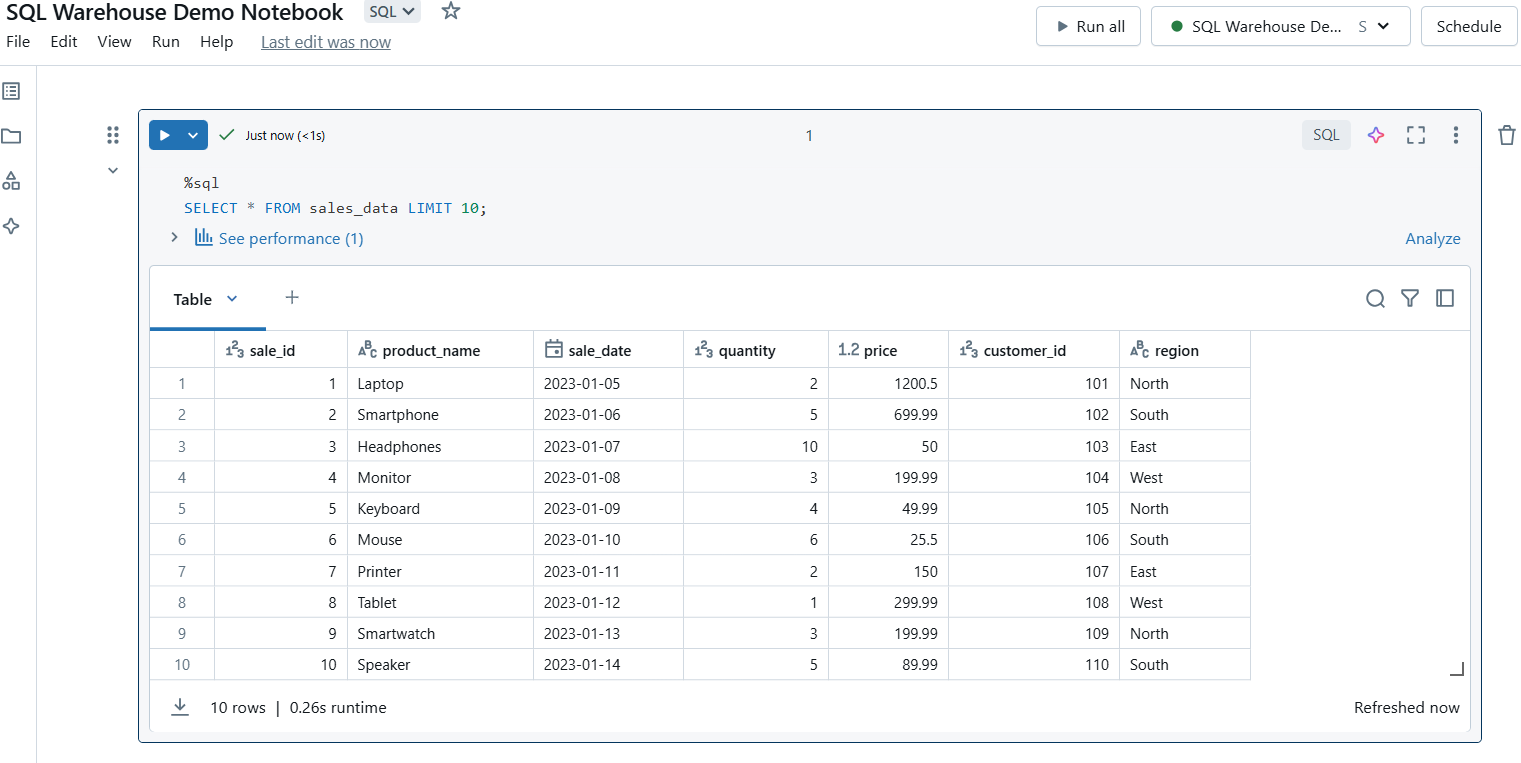
Eksekusi kueri SQL di Databricks SQL Warehouse. Gambar oleh Penulis.
Berikut beberapa pertimbangan saat menggunakan notebook dengan SQL Warehouse:
Batas Kueri: SQL Warehouse dioptimalkan untuk kueri analitis, bukan untuk kueri transaksional yang sering dan berlatensi rendah.
Pratinjau Data: Untuk set data besar, pertimbangkan membatasi hasil kueri, misalnya menggunakan klausa LIMIT untuk menghindari hambatan performa.
Penyinggahan Kueri: Manfaatkan caching hasil untuk mempercepat kueri yang diulang.
Penggunaan Sumber Daya: Pantau utilisasi SQL Warehouse untuk memastikan ukuran klaster dan pengaturan penskalaan memenuhi kebutuhan beban kerja Anda.
Databricks SQL adalah platform andal yang menjembatani kesenjangan antara data lake dan data warehouse, menyediakan solusi terpadu untuk analitik data modern dan business intelligence. Baik Anda membangun dasbor, mengoptimalkan kueri, atau memantau data dengan peringatan, Databricks SQL menawarkan fleksibilitas dan performa yang diperlukan untuk menangani tantangan data saat ini. Saya mendorong Anda untuk mengeksplorasi fitur dan kapabilitas Databricks SQL guna meningkatkan alur kerja data, memberdayakan kolaborasi, dan mendorong pengambilan keputusan yang lebih cerdas dan cepat.
Jika Anda tertarik menjadi data engineer profesional, saya sangat merekomendasikan mengikuti kursus Understanding Data Engineering kami untuk mempelajari bagaimana data engineer menyimpan dan memproses data guna memfasilitasi kolaborasi dengan data scientist. Saya juga merekomendasikan mengikuti kursus Data-Driven Decision-Making in SQL kami untuk mempelajari cara menggunakan SQL guna mendukung pengambilan keputusan melalui proyek dunia nyata. Dan tentu saja, jangan lupa melihat beragam kursus cloud kami yang luar biasa.
Pelajari Databricks bersama DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



