Cursus
Introductie tot Databricks
3 uur
49K
Databricks SQL is een krachtig hulpmiddel voor databeheer en analytics binnen het Databricks Lakehouse-platform. Dit platform integreert data engineering, data science en business analytics in één ervaring. Daarom is Databricks SQL belangrijk voor dataprofessionals die hun dataworkflows, query-uitvoering en BI-taken willen stroomlijnen zonder de complexiteit van traditioneel infrastructuurbeheer.
In dit artikel bespreek ik de componenten, functies en tools van Databricks SQL en laat ik praktische voorbeelden zien van het aanmaken en gebruiken van een Databricks SQL-warehouse. Als start raad ik je van harte aan om DataCamp’s cursus Introduction to Databricks te volgen om Databricks te leren kennen als datawarehouse-oplossing voor Business Intelligence (BI), waarbij je SQL-geoptimaliseerde mogelijkheden benut om queries te maken en data te analyseren.
Databricks SQL is een robuuste analysetool binnen het Databricks Lakehouse-platform waarmee dataprofessionals SQL-queries kunnen uitvoeren, data kunnen analyseren en interactieve dashboards kunnen maken. Ontworpen met een serverloze architectuur combineert Databricks SQL de flexibiliteit van datalakes met de governance- en prestatiemogelijkheden van datawarehouses.
De belangrijkste componenten van Databricks SQL zijn SQL Warehouses, SQL Editors en SQL Dashboards. Geen zorgen als je niet met elk van deze bekend bent, hieronder leg ik ze stuk voor stuk uit.
In tegenstelling tot andere SQL-dialecten zoals MySQL, PostgreSQL of SQL Server, die zijn ontworpen voor transactionele databases, is Databricks SQL geoptimaliseerd voor grootschalige analytics in een Lakehouse-omgeving. Traditionele SQL-databases richten zich op de opslag van gestructureerde data, terwijl Databricks SQL integreert met datalakes en tegelijkertijd de prestaties van een datawarehouse behoudt. Met serverloze SQL-warehouses hoef je geen infrastructuur te beheren, omdat resources automatisch worden ingericht en elastisch schalen.
Ook wil ik zeggen dat de uitvoering van queries in Databricks SQL sneller is dankzij de Photon-engine, die vectorized processing ondersteunt. Tot slot: Databricks SQL is gebouwd voor BI en samenwerking; het biedt native ondersteuning voor Power BI, Tableau en Looker.
De kerncomponenten van Databricks SQL maken efficiënte querying, datavisualisatie en samenwerking tussen gebruikers mogelijk. Hieronder vind je een overzicht van de belangrijkste tools en functies binnen Databricks SQL.
SQL Warehouses fungeren als de rekenresources voor het uitvoeren van SQL-queries in Databricks SQL. Ze zijn ontworpen om uiteenlopende workloads aan te kunnen en bieden prestatie-optimalisaties op basis van het geselecteerde warehousetype. Er zijn drie hoofdtypen SQL Warehouses:
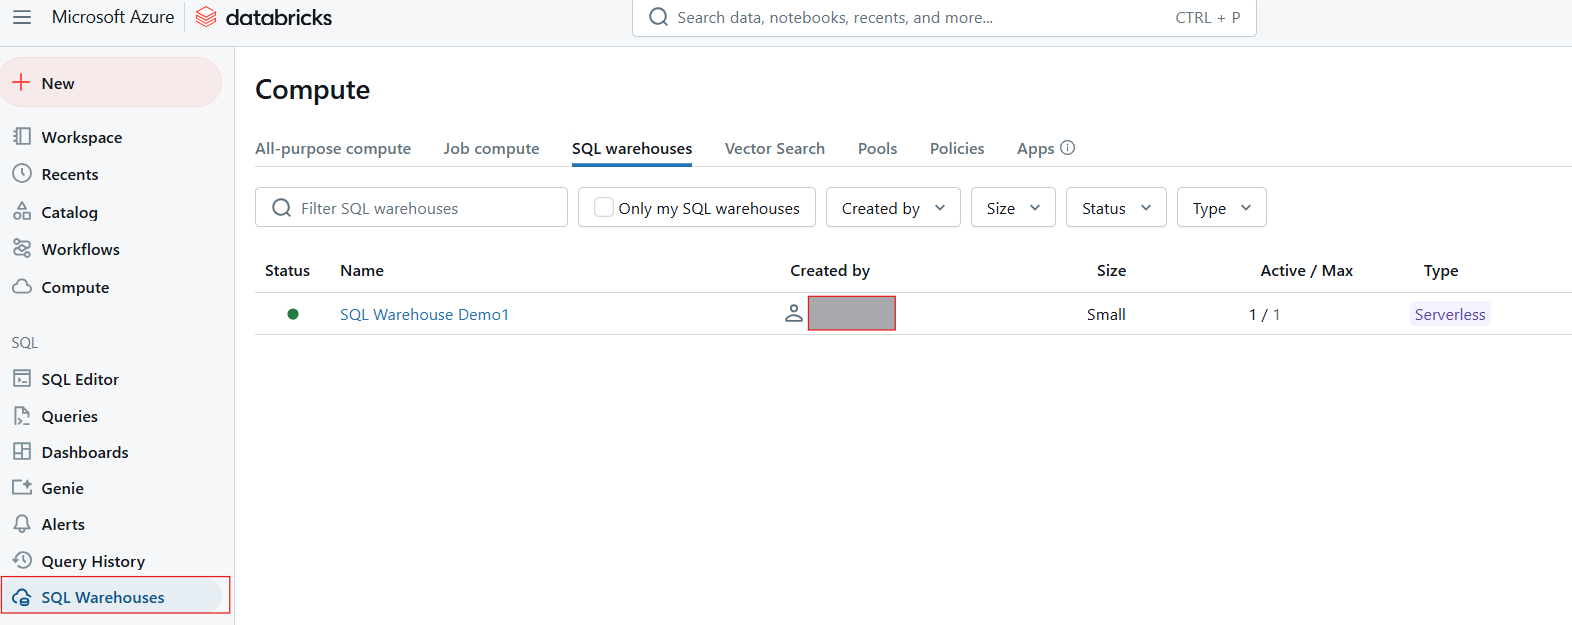
SQL Warehouse in Databricks SQL. Afbeelding door de auteur.
De SQL Editor is een gebruiksvriendelijke interface waarmee je SQL-queries kunt schrijven, uitvoeren en beheren. Belangrijke functies van de SQL Editor zijn:
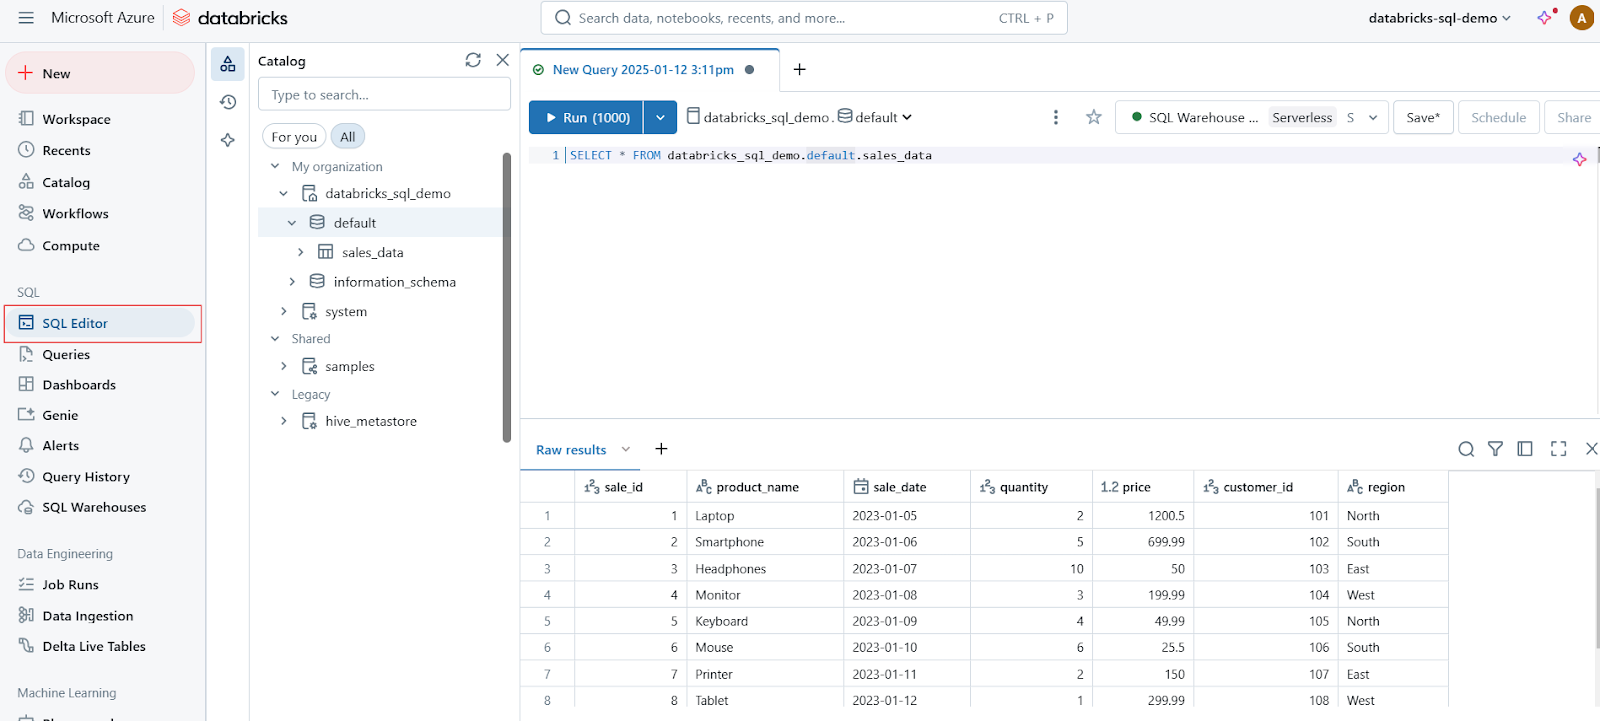
SQL Editor in Databricks SQL. Afbeelding door de auteur.
Dashboards maken datavisualisatie mogelijk door queryresultaten om te zetten in interactieve grafieken, diagrammen en widgets. Dashboards zijn ideaal om kerncijfers te monitoren en inzichten effectief binnen een organisatie te communiceren. Belangrijke mogelijkheden van dashboards zijn onder andere:
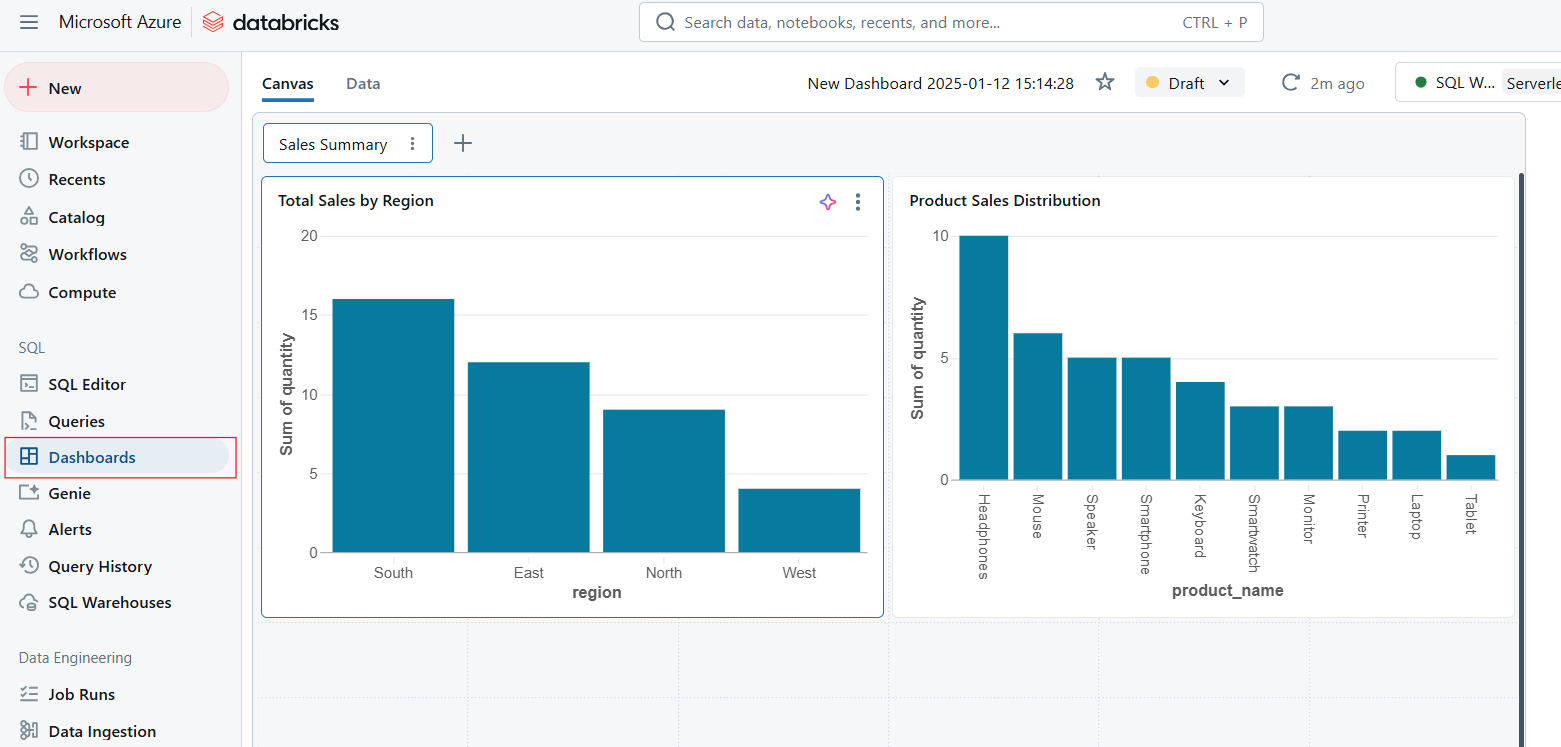
Dashboards in Databricks SQL. Afbeelding door de auteur.
Alerts in Databricks SQL bieden een manier om dataveranderingen te monitoren en meldingen te versturen wanneer aan bepaalde voorwaarden wordt voldaan. Alerts zijn essentieel om datakwaliteit te waarborgen en tijdig te reageren op belangrijke wijzigingen. De alert-functionaliteit werkt als volgt.
Tot slot wil ik aangeven dat Databricks SQL tools biedt voor het bijhouden van querygeschiedenis en -profilering:
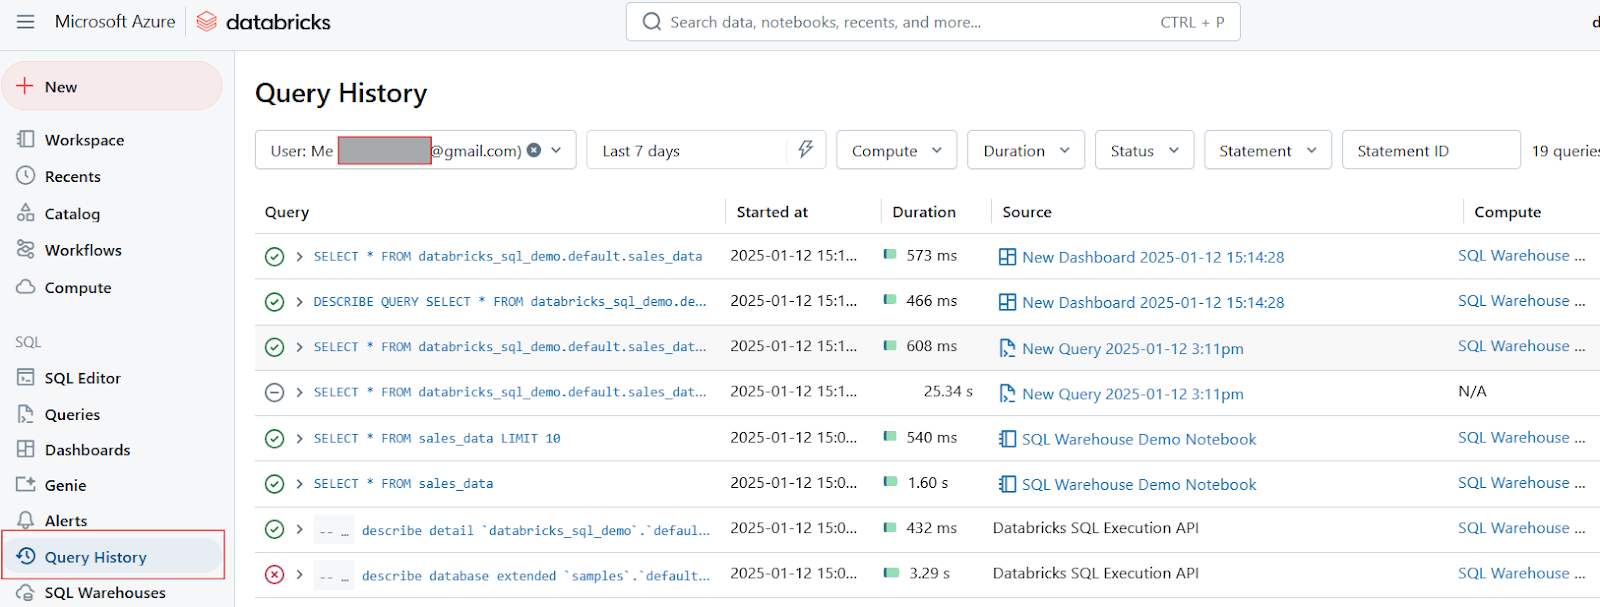
Querygeschiedenis in Databricks SQL. Afbeelding door de auteur.
Databricks SQL zit boordevol geavanceerde functies en tools. Deze functies zijn bedoeld om prestaties te verbeteren, workflows te stroomlijnen en naadloze integratie met andere tools mogelijk te maken. Laten we kijken naar enkele van de belangrijkste zaken die Databricks SQL zo’n goede keuze maken.
De Photon-engine is een high-performance, gevectoriseerde query-engine die door Databricks is ontwikkeld om SQL-query-uitvoering aanzienlijk te versnellen. De belangrijkste voordelen van de Photon-engine zijn:
CloudFetch en Async I/O zijn functies die zijn ontworpen om datasnelheden te verhogen en de afhandeling van kleine bestanden tijdens query-uitvoering te verbeteren. Deze functies werken als volgt:
Databricks SQL integreert naadloos met populaire Business Intelligence (BI)-tools, waardoor teams eenvoudiger data kunnen analyseren en visualiseren. Ondersteunde integraties zijn onder andere:
De serverloze architectuur van Databricks SQL elimineert de noodzaak van handmatig infrastructuurbeheer door resources automatisch in te richten en te schalen op basis van workloadeisen. De serverloze architectuur past resources automatisch aan om wisselende queryloads te verwerken zonder downtime. Dit zorgt ervoor dat gebruikers geen clusters handmatig hoeven te configureren of te onderhouden. De serverloze architectuur is ook kostenefficiënt, omdat je alleen betaalt voor de resources die tijdens query-uitvoering worden gebruikt.
Een voorbeeld: een retailbedrijf ervaart hoge queryloads tijdens piekuren. De serverloze architectuur schaalt resources automatisch op om consistente prestaties te garanderen en schaalt tijdens daluren weer af om kosten te besparen.
Databricks SQL Warehouses zijn essentieel voor het efficiënt uitvoeren van SQL-queries binnen de Databricks-omgeving. In deze sectie neem ik je stap voor stap mee door het proces van het aanmaken van een SQL-warehouse en het gebruik ervan met notebooks. Als je je kennis over datawarehouses wilt opfrissen, raad ik onze cursus Data Warehousing Concepts aan om de basis van datamodellering en datatransformatie te leren.
Volg deze stappen om een SQL Warehouse te maken via de web-UI van Databricks:
Klik in de Databricks-werkruimte op het pictogram SQL in de zijbalk.
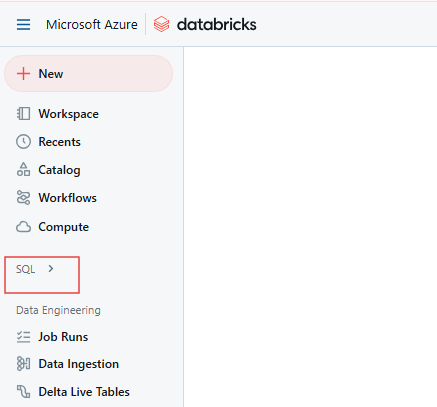
Databricks SQL-pagina. Afbeelding door de auteur.
Ga op de SQL-pagina naar het tabblad SQL Warehouses.
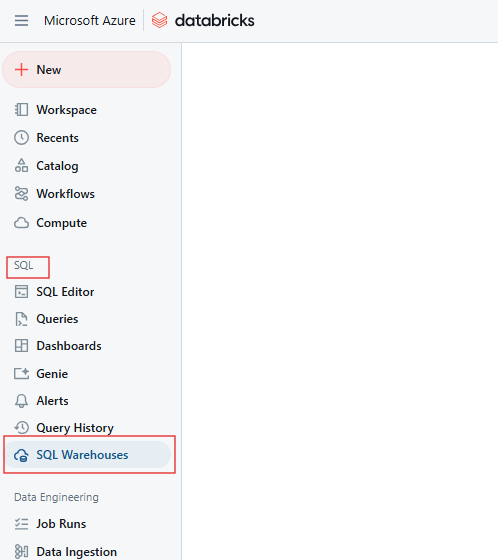
Tabblad Databricks SQL Warehouse. Afbeelding door de auteur.
Klik op de knop Create Warehouse om te beginnen met het configureren van je nieuwe SQL Warehouse.
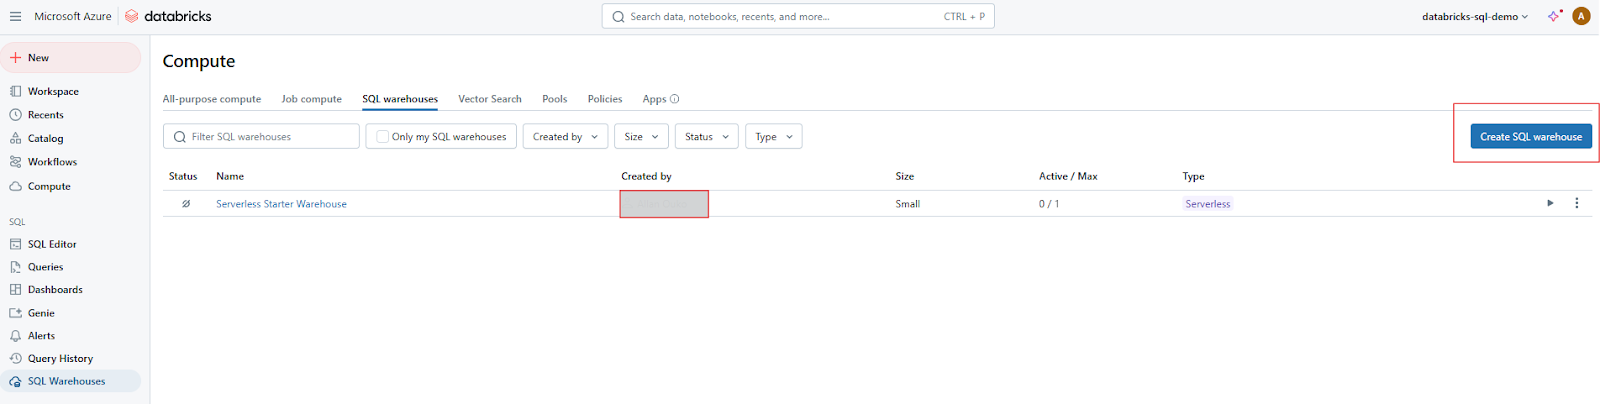
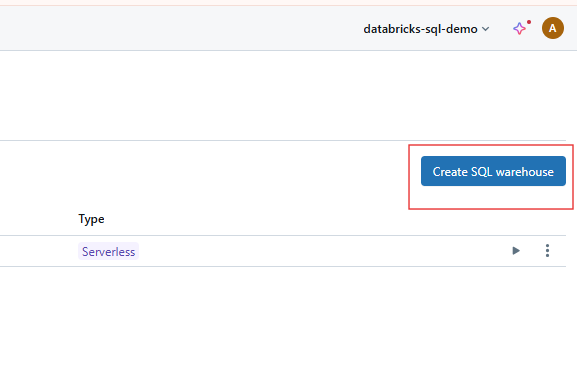
Een SQL Warehouse maken in Databricks SQL. Afbeelding door de auteur.
Configureer de warehouse-instellingen met de volgende opties.
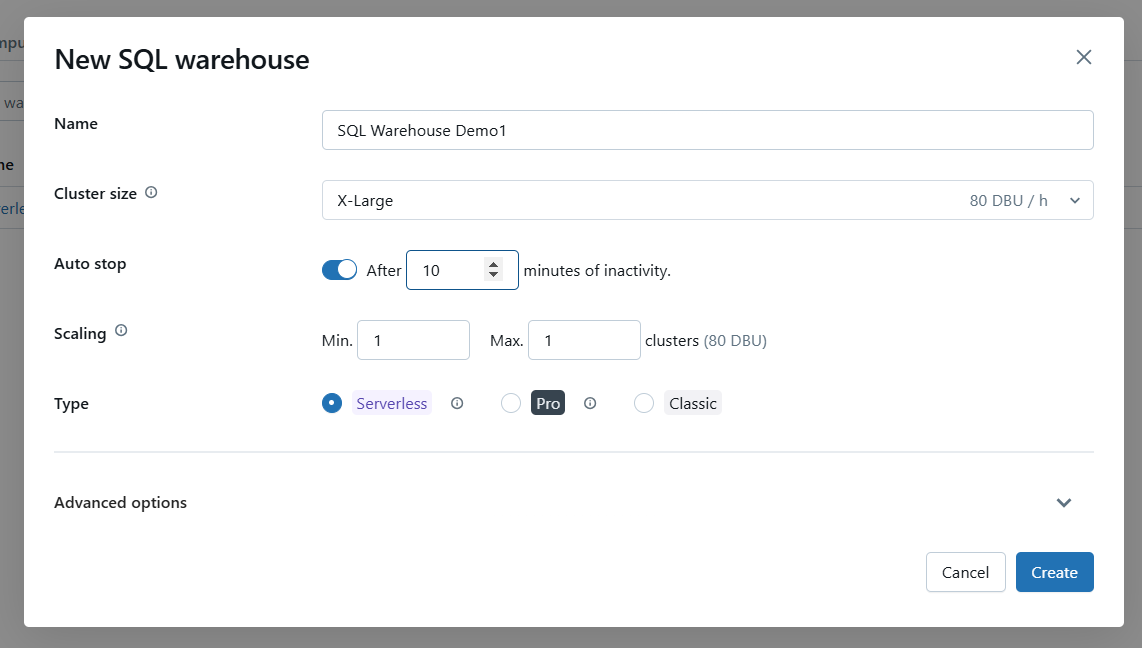
Basisinstellingen configureren voor Databricks SQL Warehouse. Afbeelding door de auteur.
Configureer indien nodig geavanceerde opties, zoals het inschakelen van Photon of het instellen van specifieke SQL-configuraties.
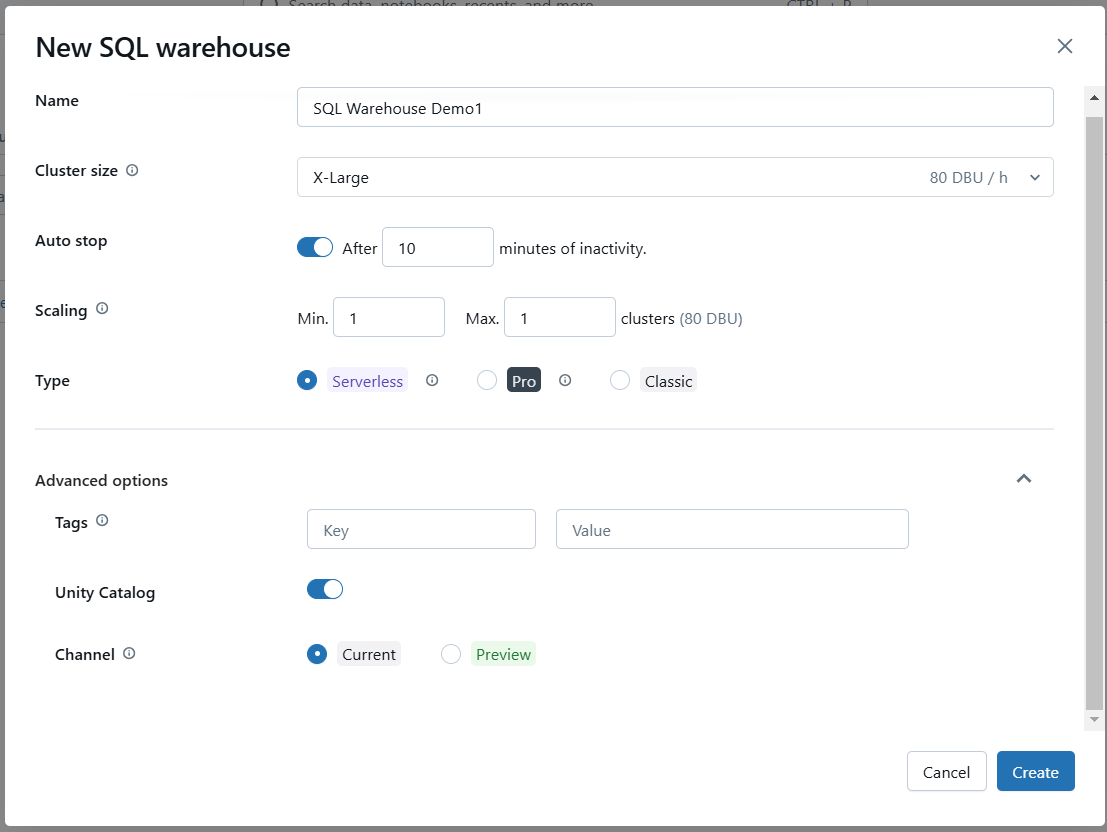
Geavanceerde instellingen configureren voor Databricks SQL Warehouse. Afbeelding door de auteur.
Klik op Create om je configuratie op te slaan. Start het warehouse zodra het is aangemaakt om het operationeel te maken.
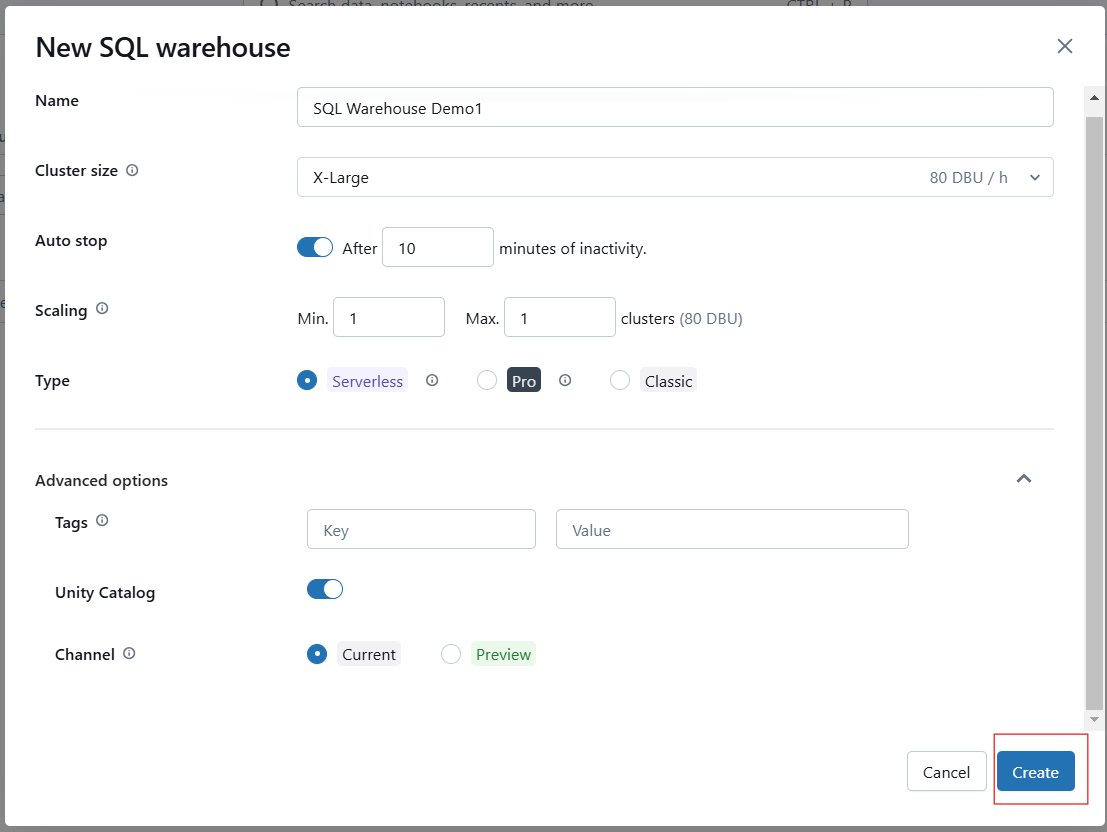
Het Databricks SQL Warehouse aanmaken. Afbeelding door de auteur.
Na het aanmaken verschijnt een venster voor rechtenbeheer waarin je gebruikers of groepen toegang kunt geven tot het warehouse.
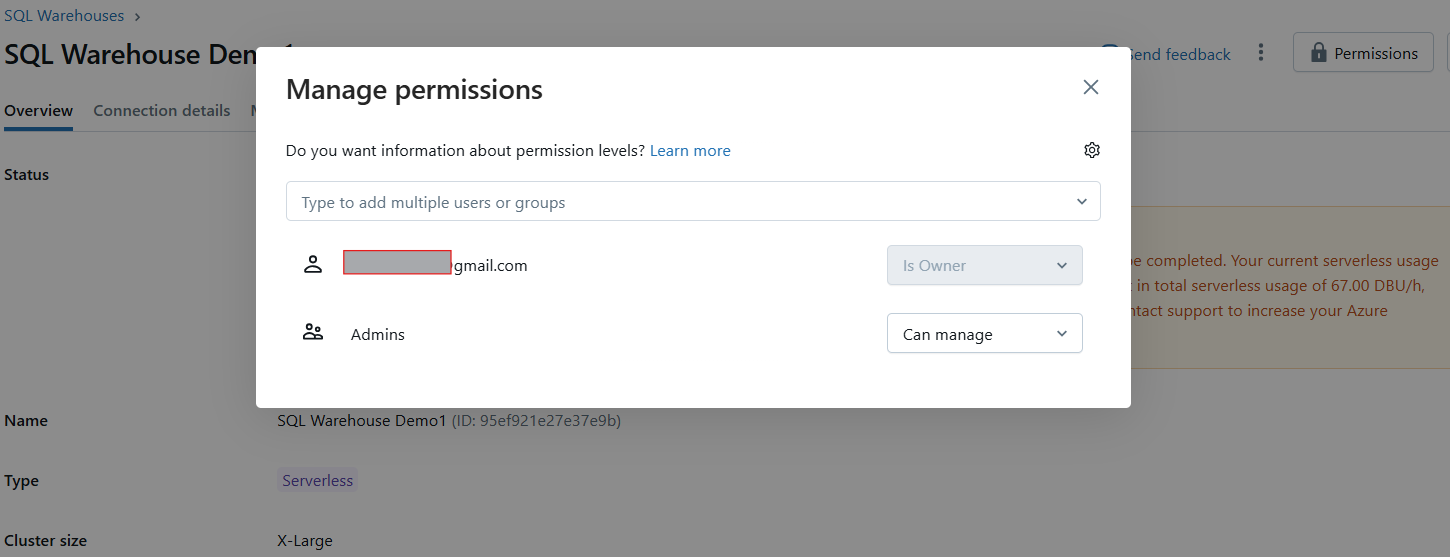
Rechten beheren van Databricks SQL Warehouse. Afbeelding door de auteur.
Zodra het is aangemaakt, start je SQL-warehouse automatisch en kun je meteen queries uitvoeren.
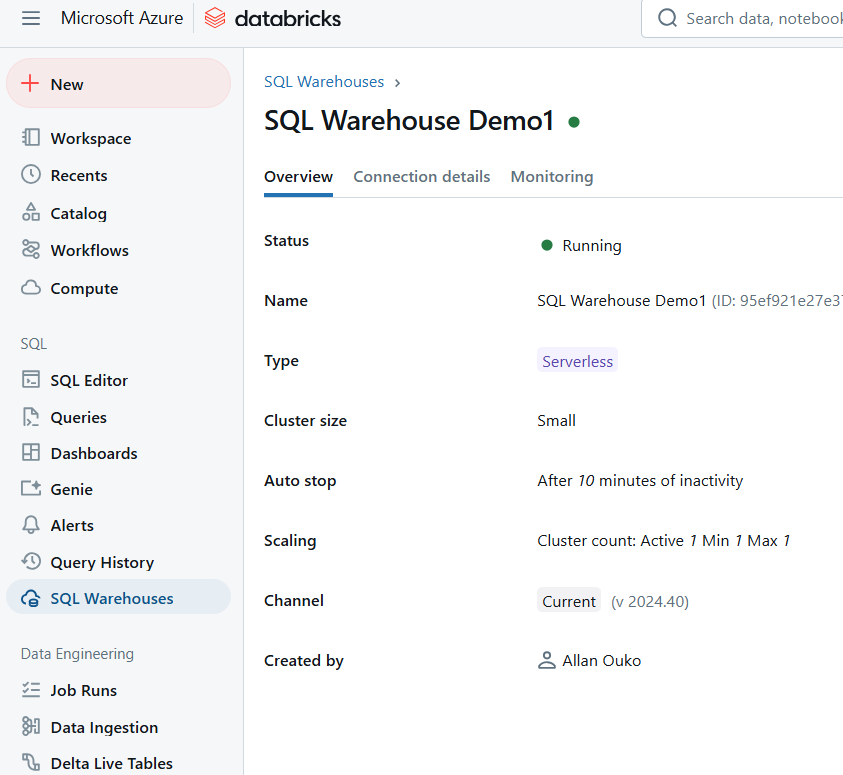
Voorbeeld van Databricks SQL Warehouse. Afbeelding door de auteur.
Volg deze stappen om SQL-queries in een notebook uit te voeren met je nieuw aangemaakte SQL-warehouse:
Maak in de Databricks-werkruimte een nieuw notebook aan of open een bestaand notebook.
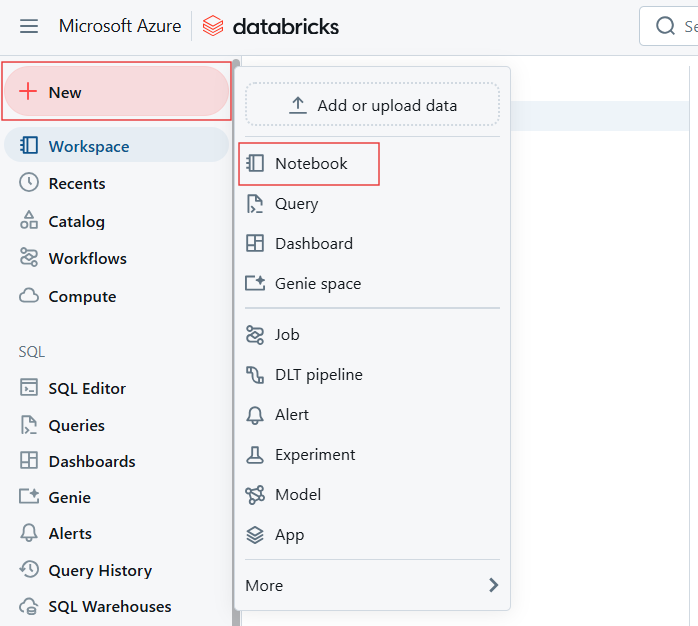
Een nieuw notebook maken om een Databricks SQL Warehouse te creëren. Afbeelding door de auteur.
Zoek in de werkbalk van het Notebook de compute-selector of connect (meestal bovenaan). Klik erop om een dropdownmenu te openen met beschikbare compute-resources. Selecteer je SQL-warehouse uit de lijst. Als het niet zichtbaar is, klik dan op More… om alle beschikbare warehouses te zien. Klik op het gewenste SQL-warehouse en kies vervolgens Start and attach.
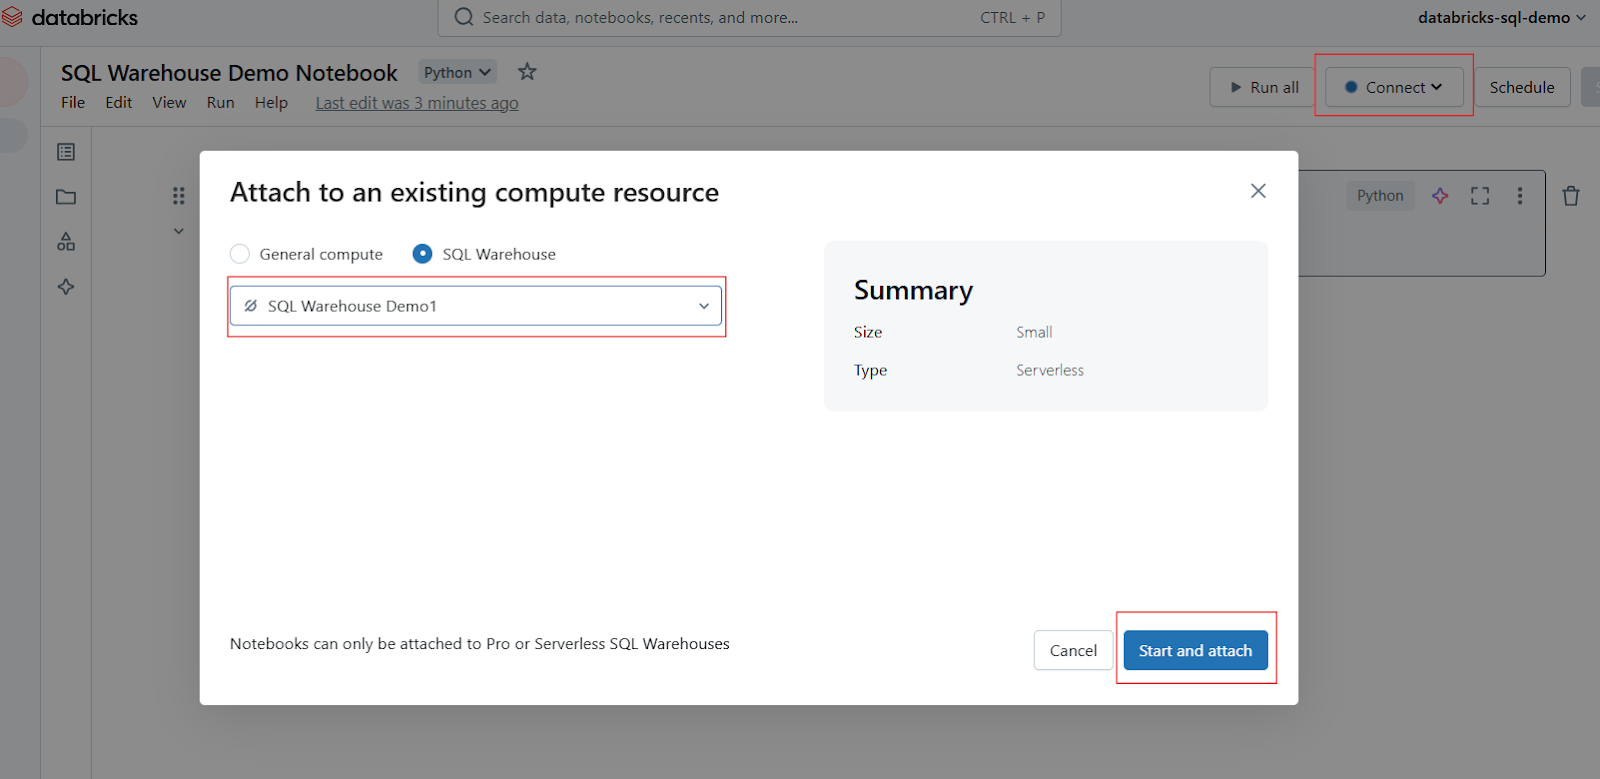
Notebook koppelen in Databricks SQL Warehouse. Afbeelding door de auteur.
Zodra het is gekoppeld, kun je in je notebook cellen maken voor SQL-queries. Gebruik de %sql-magic-opdracht om SQL-queries in het notebook uit te voeren.
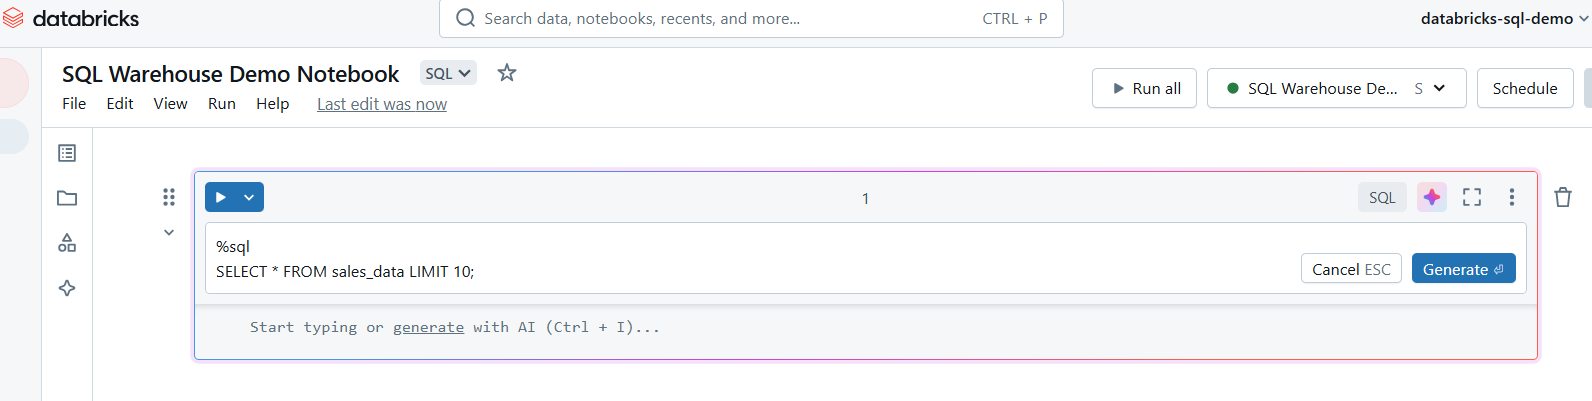
SQL-queries schrijven in Databricks SQL Warehouse. Afbeelding door de auteur.
Voer de cel uit om je query te draaien. De resultaten worden direct onder de cel weergegeven, zodat je data eenvoudig kunt bekijken.
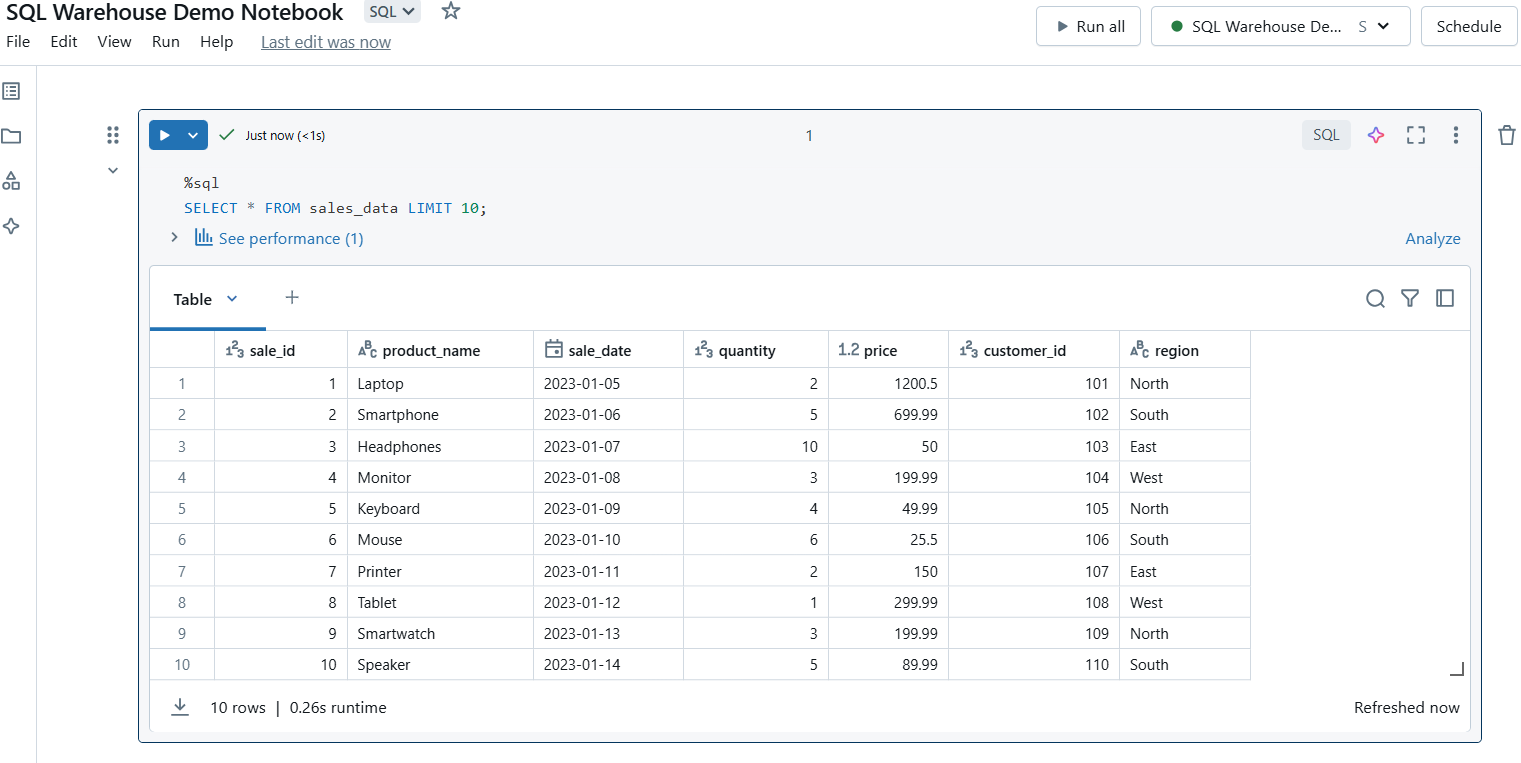
SQL-queries uitvoeren in Databricks SQL Warehouse. Afbeelding door de auteur.
Houd rekening met het volgende wanneer je notebooks gebruikt met SQL Warehouses:
Querylimieten: SQL Warehouses zijn geoptimaliseerd voor analytische queries, niet voor frequente, low-latency transactionele queries.
Datapreview: Beperk voor grote datasets je queryresultaten, bijvoorbeeld met de LIMIT-clausule, om prestatieknelpunten te voorkomen.
Querycaching: Maak gebruik van result caching om herhaalde queries te versnellen.
Resourcegebruik: Monitor het gebruik van het SQL Warehouse om te zorgen dat de clustergrootte en schaalinstellingen bij je workload passen.
Databricks SQL is een krachtig platform dat de kloof tussen datalakes en datawarehouses overbrugt en een uniforme oplossing biedt voor moderne data-analyse en business intelligence. Of je nu dashboards bouwt, queries optimaliseert of data monitort met alerts, Databricks SQL biedt de flexibiliteit en prestaties die nodig zijn om de datavraagstukken van vandaag aan te kunnen. Ik moedig je aan om de functies en mogelijkheden van Databricks SQL te verkennen om je dataworkflows te verbeteren, samenwerking te versterken en slimmere, snellere beslissingen te nemen.
Als je een professionele data engineer wilt worden, raad ik je van harte onze cursus Understanding Data Engineering aan om te leren hoe data engineers data opslaan en verwerken om de samenwerking met data scientists te faciliteren. Ik raad ook onze cursus Data-Driven Decision-Making in SQL aan om te leren hoe je SQL inzet voor besluitvorming met projecten uit de echte wereld. En vergeet natuurlijk niet om ons mooie aanbod aan cloudcursussen te bekijken.
Leer Databricks met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

