

什么是 Deep Agents?
Deep Agents 是一种先进的智能体架构,专为处理需要持续推理、工具使用与记忆的复杂多步任务而设计。与在短循环中运行或只进行简单工具调用的传统智能体不同,Deep Agents 会规划行动、管理不断演变的上下文、将子任务委派给专业子智能体,并在长时间交互中保持状态。这一架构已为 Claude Code、Deep Research 和 Manus 等真实应用提供支持。
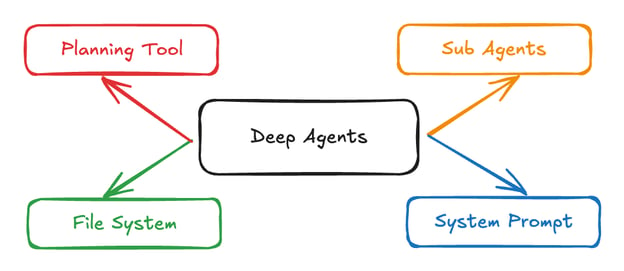
来源:LangChain
以下是 Deep Agents 的关键特性:
- 规划能力:能够将大型任务拆解为可管理的子任务,并在推进过程中调整计划。
- 上下文管理:可以在长对话与多步流程中保留并引用关键信息。
- 子智能体委派:能够启动专业化子智能体处理任务的聚焦部分。
- 文件系统集成:按需持久化与检索信息,实现超越单轮对话的真正“记忆”。
- 详尽的系统提示:在精细指令与示例的指导下,Deep Agents 按明确工作流运行,确保一致性与可靠性。
Deep Agents 的核心组件
Deep Agents 通过四个核心组件克服传统智能体的局限:
1. 详尽的系统提示
不同于简单的指令提示,Deep Agents 使用全面的系统提示,示例如下:
DEEP_AGENT_SYSTEM_PROMPT = """
You are an expert research assistant capable of conducting thorough,
multi-step investigations. Your capabilities include:
PLANNING: Break complex tasks into subtasks using the todo_write tool
RESEARCH: Use internet_search extensively to gather comprehensive information
DELEGATION: Spawn sub-agents for specialized tasks using the call_subagent tool
DOCUMENTATION: Maintain detailed notes using the file system tools
When approaching a complex task:
1. First, create a plan using todo_write
2. Research systematically, saving important findings to files
3. Delegate specialized work to appropriate sub-agents
4. Synthesize findings into a comprehensive response
Examples:
[Detailed few-shot examples follow...]
"""该提示将规划、研究、委派与文档记录整合在一起,并利用少样本示例来分解复杂任务。
2. 规划工具
规划工具通常只是一个“无操作”工具,帮助智能体组织思路:
@tool
def todo_write(tasks: List[str]) -> str:
formatted_tasks = "\n".join([f"- {task}" for task in tasks])
return f"Todo list created:\n{formatted_tasks}"这个简单工具提供了重要的上下文工程能力,强制智能体进行相应规划并在执行过程中保持该计划可见。
3. 子智能体
Deep Agents 可以为聚焦任务生成专业化子智能体。每个子智能体都有其独立的提示、描述与工具集,从而实现关注点分离与面向任务的深度优化。以下示例展示了在工作流中如何定义子智能体:
subagents = [
{
"name": "research-agent",
"description": "Conducts deep research on specific topics",
"prompt": "You are a research specialist. Focus intensively on the given topic...",
"tools": ["internet_search", "read_file", "write_file"]
},
{
"name": "analysis-agent",
"description": "Analyzes data and draws insights",
"prompt": "You are a data analyst. Examine the provided information...",
"tools": ["read_file", "write_file"]
}
]这种方式提供了上下文隔离,即每个子智能体维护其自身上下文,不会污染主智能体的记忆。通过隔离专业化任务,您可以实现:
- 提示专业化:每个智能体都可通过针对性的指令与示例,为其独特职能进行微调。
- 更清晰的上下文管理:主智能体的上下文保持聚焦且不受无关细节干扰,子智能体在其自身边界内运行。
- 模块化推理:任务可被委派、并行或迭代优化,便于将智能体系统扩展到新领域。
4. 文件系统集成
Deep Agents 使用虚拟文件系统来维护并共享状态。相比仅依赖对话历史,这些内置工具可以让智能体在整个工作流中组织信息:
tools = [
"ls", # List files
"read_file", # Read file contents
"write_file", # Write to file
"edit_file" # Edit existing file
]该虚拟文件系统具有多项优势:
- 持久记忆:智能体可将关键发现、笔记或中间结果存入文件,使其在多个步骤、甚至对子智能体都可访问。
- 共享工作区:多个智能体(或子智能体)可通过读取与写入同一文件协作,在单一工作流中实现团队配合。
- 信息组织:在需要创建、分类与引用文档或制品的情况下,复杂多步任务更易管理。
演示:使用 LangChain 的 deepagents 构建求职助手
我将通过一个实用示例,带您构建一个求职助手,能自动查找相关职位并为用户生成定制求职信。
我们的助手将:
- 根据用户指定的条件搜索当前职位发布
- 按技能匹配度筛选并排序职位
- 为每个岗位生成个性化求职信
- 将全部结果打包为可下载的格式提供给用户
步骤 1:初始设置与依赖
从基础的安装与设置开始:
pip install deepagents
pip install tavily-python
pip install streamlit
pip install langchain-openai安装完成后,设置环境变量:
export OPENAI_API_KEY=sk-projxxxxxxxxxxxxxxxxxxx
export TAVILY_API_KEY=tvly-devxxxxxxxxxxxxxxxxxxx在本次演示中,您需要 OpenAI API 密钥(用于 GPT-4o mini 模型)和 Tavily API 密钥(用于网页搜索功能)。Tavily 直接从网上为智能体提供最新岗位信息,而 OpenAI 的模型负责语言理解、推理、规划与内容生成。
注意:新的 Tavily 用户可获得 1,000 次免费 API 额度。要获取密钥,只需在 https://app.tavily.com 注册。
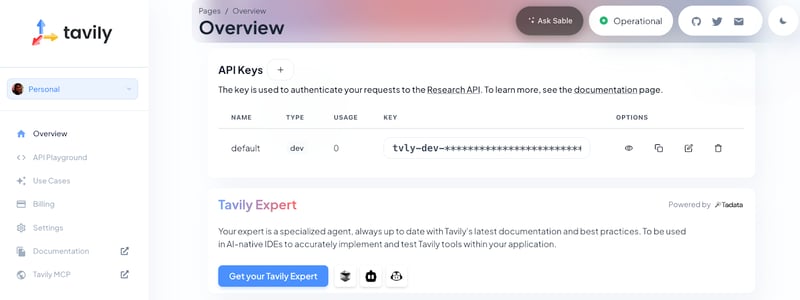
最后,我们导入必要库并设置 Streamlit 界面:
import os
import io
import json
import re
from typing import Literal, Dict, Any, List
import streamlit as st
import pandas as pd
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from tavily import TavilyClient
from deepagents import create_deep_agent这一步导入了深度智能体应用所需的全部依赖。我们使用 streamlit 构建网页界面,pandas 处理数据,langchain_openai 进行 LLM 集成,deepagents 则提供智能体框架。
步骤 2:会话状态管理
接下来,初始化 Streamlit 的会话状态,以在用户交互之间持久化数据。这样即便用户与界面交互,应用也能记住上传的文件、结果与错误状态:
if "jobs_df" not in st.session_state:
st.session_state.jobs_df = None
if "cover_doc" not in st.session_state:
st.session_state.cover_doc = None
if "last_error" not in st.session_state:
st.session_state.last_error = ""
if "raw_final" not in st.session_state:
st.session_state.raw_final = ""该设置对流畅的用户体验至关重要,使我们能在整个会话中存储岗位结果、生成的求职信以及任何错误信息。
步骤 3:用户界面搭建
我们使用 Streamlit 的列布局来组织简历上传、职位名称、地点和可选技能等输入字段:
st.set_page_config(page_title="Job Application Assistant", page_icon=" ", layout="wide")
st.title("💼 Job Application Assistant")
c0, c1, c2 = st.columns([2, 1, 1])
with c0:
uploaded = st.file_uploader("Upload your resume (PDF/DOCX/TXT)", type=["pdf", "docx", "txt"])
with c1:
target_title = st.text_input("Target title", "Senior Machine Learning Engineer")
with c2:
target_location = st.text_input("Target location(s)", "Bangalore OR Remote")
skills_hint = st.text_area(
"Add/override skills (optional)",
"",
placeholder="Python, PyTorch, LLMs, RAG, Azure, vLLM, FastAPI",
)界面按列布局,便于排版。用户可以上传多种格式的简历,指定目标职位与地点,并突出他们希望在申请中强调的特定技能。
步骤 4:文件处理辅助函数
接下来,我们实现健壮的文件处理逻辑,以支持不同简历格式并从中提取文本。
import pypdf
import docx
def extract_text(file) -> str:
if not file:
return ""
name = file.name.lower()
if name.endswith(".txt"):
return file.read().decode("utf-8", errors="ignore")
if name.endswith(".pdf"):
pdf = pypdf.PdfReader(io.BytesIO(file.read()))
return "\n".join((p.extract_text() or "") for p in pdf.pages)
if name.endswith(".docx"):
d = docx.Document(io.BytesIO(file.read()))
return "\n".join(p.text for p in d.paragraphs)
return ""
def md_to_docx(md_text: str) -> bytes:
doc = docx.Document()
for raw in md_text.splitlines():
line = raw.rstrip()
if not line:
doc.add_paragraph("")
continue
if line.startswith("#"):
level = min(len(line) - len(line.lstrip("#")), 3)
doc.add_heading(line.lstrip("#").strip(), level=level)
elif line.startswith(("- ", "* ")):
doc.add_paragraph(line[2:].strip(), style="List Bullet")
else:
doc.add_paragraph(line)
bio = io.BytesIO()
doc.save(bio)
bio.seek(0)
return bio.read()这些辅助函数处理从不同文件格式(PDF、DOCX、TXT)中提取文本的复杂性,并将 markdown 输出转换回 DOCX 以供下载。各函数作用如下:
extract_text()函数会自动识别上传文件类型(TXT、PDF 或 DOCX),并使用相应库提取内容,用户无需担心文件格式问题。md_to_docx()函数将 markdown 格式文本(例如智能体生成的求职信)转换为干净、结构良好的 Word 文档,便于下载。
这样应用即可灵活处理多样化的简历输入,并在不受原始文件格式影响的情况下输出专业结果。
步骤 5:数据处理与抽取
接下来,我们实现健壮的解析逻辑,从智能体的响应中抽取岗位数据。
def normalize_jobs(items: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
normed = []
for it in items:
if not isinstance(it, dict):
continue
# case-insensitive keys
lower_map = {str(k).strip().lower(): it[k] for k in it.keys()}
company = str(lower_map.get("company", "") or "").strip()
title = str(lower_map.get("title", "") or "").strip()
location = str(lower_map.get("location", "") or "").strip()
link = str(lower_map.get("link", "") or "").strip()
why_fit = str(lower_map.get("why_fit", lower_map.get("good match", "")) or "").strip()
if not link:
continue
normed.append({
"company": company or "—",
"title": title or "—",
"location": location or "—",
"link": link,
"Good Match": "Yes" if why_fit else "—",
})
return normed[:5]
def extract_jobs_from_text(text: str) -> List[Dict[str, Any]]:
if not text:
return []
pattern = r"<JOBS>\s*(?:```[\w-]*\s*)?(\[.*?\])\s*(?:```)?\s*</JOBS>"
m = re.search(pattern, text, flags=re.S | re.I)
if not m:
return []
raw = m.group(1).strip().strip("`").strip()
try:
obj = json.loads(raw)
return obj if isinstance(obj, list) else []
except Exception:
try:
salvaged = re.sub(r"(?<!\\)'", '"', raw)
obj = json.loads(salvaged)
return obj if isinstance(obj, list) else []
except Exception:
st.session_state.last_error = f"JSON parse failed: {raw[:1200]}"
return []我们简要理解上述函数:
extract_jobs_from_text()函数使用正则表达式,从智能体的结构化输出(位于 <JOBS>...</JOBS> 标签内)中提取岗位的 JSON 数组。还包含回退解析逻辑,以处理模型的轻微错误,例如用单引号代替 JSON 所需的双引号。- 随后
normalize_jobs()函数会对每个岗位字典进行标准化清洗,如键名大小写不敏感、必填字段与空白去除,并将输出限制为前 5 条。
步骤 6:工具集成
研究能力的核心由 Tavily 驱动。因此,我们定义一个网页搜索工具,供深度智能体用来查找最新岗位信息:
TAVILY_KEY = os.environ.get("TAVILY_API_KEY", "")
@tool
def internet_search(
query: str,
max_results: int = 5,
topic: Literal["general", "news", "finance"] = "general",
include_raw_content: bool = False,
) -> List[Dict[str, Any]]:
if not TAVILY_KEY:
raise RuntimeError("TAVILY_API_KEY is not set in the environment.")
client = TavilyClient(api_key=TAVILY_KEY)
return client.search(
query=query,
max_results=max_results,
include_raw_content=include_raw_content,
topic=topic,
)internet_search() 函数用 @tool 装饰,使其对主智能体与子智能体可用。它随后调用 Tavily API,返回相关且最新的搜索结果,非常适合动态岗位查询与研究。
注意: 您可以以相同方式添加更多工具(如文档摘要、代码执行或数据丰富),以进一步扩展深度智能体的能力。
步骤 7:深度智能体配置
现在,我们将各部分整合,通过为主智能体及其子智能体配置有针对性的指令:
INSTRUCTIONS = (
"You are a job application assistant. Do two things:\n"
"1) Use the web search tool to find exactly 5 CURRENT job postings (matching the user's target title, locations, and skills). "
"Return them ONLY as JSON in this exact wrapper:\n"
"<JOBS>\n"
"[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}, ... five total]\n"
"</JOBS>\n"
"Rules: The list must be valid JSON (no comments), real links to the job page or application page, no duplicates.\n"
"2) Produce a concise cover letter (≤150 words) for EACH job, with a subject line, appended to cover_letters.md under a heading per job.\n"
"Do not invent jobs. Prefer reputable sources (company career pages, LinkedIn, Lever, Greenhouse)."
)
JOB_SEARCH_PROMPT = (
"Search and select 5 real postings that match the user's title, locations, and skills. "
"Output ONLY this block format (no extra text before/after the wrapper):\n"
"<JOBS>\n"
"[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}]"
"\n</JOBS>"
)
COVER_LETTER_PROMPT = (
"For each job in the found list, write a subject line and a concise cover letter (≤150 words) that ties the user's skills/resume to the role. "
"Append to cover_letters.md under a heading per job. Keep writing tight and specific."
)
def build_agent():
api_key = os.environ.get("OPENAI_API_KEY")
if not api_key:
st.error("Please set OPENAI_API_KEY in your environment.")
st.stop()
llm = ChatOpenAI(model=os.environ.get("OPENAI_MODEL", "gpt-4o-mini"), temperature=0.2)
tools = [internet_search]
subagents = [
{"name": "job-search-agent", "description": "Finds relevant jobs", "prompt": JOB_SEARCH_PROMPT},
{"name": "cover-letter-writer-agent", "description": "Writes cover letters", "prompt": COVER_LETTER_PROMPT},
]
return create_deep_agent(tools, INSTRUCTIONS, subagents=subagents, model=llm)
def make_task_prompt(resume_text: str, skills_hint: str, title: str, location: str) -> str:
skills = skills_hint.strip()
skill_line = f" Prioritize these skills: {skills}." if skills else ""
return (
f"Target title: {title}\n"
f"Target location(s): {location}\n"
f"{skill_line}\n\n"
f"RESUME RAW TEXT:\n{resume_text[:8000]}"
)此步骤通过专业子智能体展现了 Deep Agents 的强大。主指令给出总体指导,而每个子智能体都有聚焦其特定任务的提示:
INSTRUCTIONS、JOB_SEARCH_PROMPT与COVER_LETTER_PROMPT定义了主系统提示和每个子智能体的专业化指令,确保智能体始终以所需格式产出结构良好的岗位结果与定制求职信。build_agent()函数检查 OpenAI API 密钥、设置语言模型,并创建包含岗位搜索与求职信撰写子智能体的深度智能体。该模块化设置使每个子智能体聚焦于其工作流部分。- 随后
make_task_prompt()函数组合用户的简历、技能、职位与地点,生成一个统一提示,为智能体启动搜索与撰写流程提供全部上下文。
这些函数共同为工作流提供结构与专业化。
步骤 8:主应用逻辑
此步骤是处理用户输入并编排深度智能体的核心应用逻辑:
resume_text = extract_text(uploaded) if uploaded else ""
run_clicked = st.button("Run", type="primary", disabled=not uploaded)
if run_clicked:
st.session_state.last_error = ""
st.session_state.raw_final = ""
try:
if not os.environ.get("OPENAI_API_KEY"):
st.error("OPENAI_API_KEY not set.")
st.stop()
if not TAVILY_KEY:
st.error("TAVILY_API_KEY not set.")
st.stop()
agent = build_agent()
task = make_task_prompt(resume_text, skills_hint, target_title, target_location)
state = {
"messages": [{"role": "user", "content": task}],
"files": {"cover_letters.md": ""},
}
with st.spinner("Finding jobs and drafting cover letters..."):
result = agent.invoke(state)
final_msgs = result.get("messages", [])
final_text = (final_msgs[-1].content if final_msgs else "") or ""
st.session_state.raw_final = final_text
files = result.get("files", {}) or {}
cover_md = (files.get("cover_letters.md") or "").strip()
st.session_state.cover_doc = md_to_docx(cover_md) if cover_md else None
raw_jobs = extract_jobs_from_text(final_text)
jobs_list = normalize_jobs(raw_jobs)
st.session_state.jobs_df = pd.DataFrame(jobs_list) if jobs_list else None
st.success("Done. Results generated and saved.")
except Exception as e:
st.session_state.last_error = str(e)
st.error(f"Error: {e}")上述代码处理用户操作、启动深度智能体并按如下方式展示结果:
- 当用户点击Run 时,应用检查必需的 API 密钥是否可用。
- 提取简历,收集输入(技能、职位、地点),并构建任务提示。
- 调用智能体,传入用户查询以及求职信的文件占位符。
- 当智能体完成其工作流后,应用将:
- 提取并保存生成的求职信(转换为 DOCX 以供下载)
- 解析、标准化并以交互式 DataFrame 展示岗位匹配结果
步骤 9:结果展示与下载
最后,以用户友好的格式呈现结果:
st.header("Jobs")
if st.session_state.jobs_df is None or st.session_state.jobs_df.empty:
st.write("No jobs to show yet.")
else:
df = st.session_state.jobs_df.copy()
def as_link(u: str) -> str:
u = u if isinstance(u, str) else ""
return f'<a href="{u}" target="_blank">Apply</a>' if u else "—"
if "link" in df.columns:
df["link"] = df["link"].apply(as_link)
cols = [c for c in ["company", "title", "location", "link", "Good Match"] if c in df.columns]
df = df[cols]
st.write(df.to_html(escape=False, index=False), unsafe_allow_html=True)
st.header("Download")
if st.session_state.cover_doc:
st.download_button(
"Download cover_letters.docx",
data=st.session_state.cover_doc,
file_name="cover_letters.docx",
mime="application/vnd.openxmlformats-officedocument.wordprocessingml.document",
key="dl_cover_letters",
)
else:
st.caption("Cover letters not produced yet.")在智能体完成后,我们以精致的布局呈现结果:
- 应用以表格展示岗位匹配结果,并为每个职位提供可点击的Apply 链接。
- 如果生成了求职信,用户可通过下载按钮将其保存为Word 文档。
这将一个多步的 AI 工作流变成一次点击即可完成的体验。
要启动应用,只需运行:
streamlit app.py结语
Deep Agents 标志着智能体架构的重大进化,从简单的工具调用迈向能够在复杂任务上进行规划、委派与持续执行的精巧系统。deepagents 包让这一架构触手可及,使开发者能够为研究、编码、分析及各类专业领域构建可投入生产的智能体。
随着 AI 智能体在商业与科研中的重要性日益提升,深度智能体架构提供了实现现实影响所需的结构与灵活性。如果您在寻找零代码方案,也推荐查看 LangSmith Agent Builder 教程。

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
当下最常见的智能体架构,是让一个大语言模型在循环中调用工具。这种方式简单、有效,但终究有限。对于简单任务它足够,但面对需要规划、上下文管理,并在更长时间跨度内持续执行的复杂多步挑战时,就显得力不从心。
LangChain 的 Deep Agents 架构将详尽的系统提示、规划工具、子智能体和文件系统结合起来,打造能够处理复杂研究、编码与分析任务的 AI 智能体。像 Claude Code、Deep Research 和 Manus 等应用已经验证了这种方法的有效性,如今
deepagentsPython 包让这一架构为所有人所用。在本教程中,我将逐步讲解如何: