

Deep Agents क्या हैं?
Deep Agents एक उन्नत एजेंट आर्किटेक्चर है जिसे जटिल, बहु-चरणीय कार्यों के लिए डिज़ाइन किया गया है, जिनमें सतत रीजनिंग, टूल उपयोग और मेमोरी की आवश्यकता होती है। पारंपरिक एजेंट जो छोटे लूप्स में काम करते हैं या साधारण टूल कॉल्स करते हैं, उनसे अलग, Deep Agents अपने कार्यों की योजना बनाते हैं, बदलते संदर्भ का प्रबंधन करते हैं, उप-कार्य विशिष्ट सब-एजेंट्स को सौंपते हैं, और लंबी इंटरेक्शन के दौरान स्टेट बनाए रखते हैं। यह आर्किटेक्चर पहले से ही Claude Code, Deep Research और Manus जैसे वास्तविक-world अनुप्रयोगों को पावर दे रहा है।
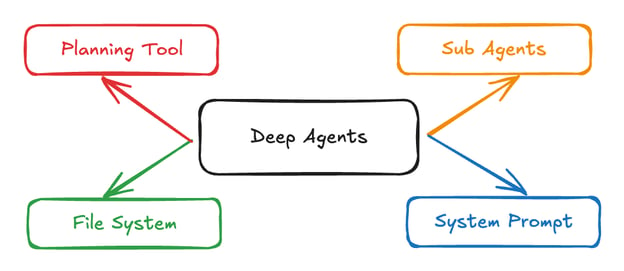
स्रोत: LangChain
ये हैं Deep Agents की प्रमुख विशेषताएं:
- योजना बनाने की क्षमता: वे बड़े कार्यों को छोटे, प्रबंधनीय उप-कार्य में तोड़ सकते हैं और जैसे-जैसे काम आगे बढ़ता है, योजना समायोजित कर सकते हैं।
- संदर्भ प्रबंधन: वे लंबी बातचीत और कई चरणों में महत्वपूर्ण जानकारी को बनाए रखते हैं और उसका संदर्भ लेते हैं।
- सब-एजेंट डेलिगेशन: Deep Agents केंद्रित हिस्सों को संभालने के लिए विशेष सब-एजेंट्स शुरू कर सकते हैं।
- फाइल सिस्टम इंटीग्रेशन: वे आवश्यकतानुसार जानकारी सहेजते और पुनः प्राप्त करते हैं, जिससे एक ही बातचीत से आगे वास्तविक "मेमोरी" संभव होती है।
- विस्तृत सिस्टम प्रॉम्प्ट्स: Deep Agents परिष्कृत निर्देशों और उदाहरणों के साथ संचालित होते हुए स्थिरता और विश्वसनीयता के लिए स्पष्ट वर्कफ्लो का पालन करते हैं।
Deep Agents के मुख्य घटक
Deep Agents पारंपरिक एजेंट्स की सीमाओं को चार मुख्य घटकों के माध्यम से पार करते हैं:
1. विस्तृत सिस्टम प्रॉम्प्ट्स
सरल निर्देश प्रॉम्प्ट्स के विपरीत, Deep Agents इस प्रकार व्यापक सिस्टम प्रॉम्प्ट्स का उपयोग करते हैं:
DEEP_AGENT_SYSTEM_PROMPT = """
You are an expert research assistant capable of conducting thorough,
multi-step investigations. Your capabilities include:
PLANNING: Break complex tasks into subtasks using the todo_write tool
RESEARCH: Use internet_search extensively to gather comprehensive information
DELEGATION: Spawn sub-agents for specialized tasks using the call_subagent tool
DOCUMENTATION: Maintain detailed notes using the file system tools
When approaching a complex task:
1. First, create a plan using todo_write
2. Research systematically, saving important findings to files
3. Delegate specialized work to appropriate sub-agents
4. Synthesize findings into a comprehensive response
Examples:
[Detailed few-shot examples follow...]
"""यह प्रॉम्प्ट योजना, रिसर्च और डेलिगेशन को डॉक्यूमेंटेशन के साथ जोड़ता है, और जटिल कार्यों को तोड़ने के लिए फ्यू-शॉट उदाहरणों का उपयोग करता है।
2. प्लानिंग टूल्स
प्लानिंग टूल अक्सर एक साधारण "no-op" ही होता है जो एजेंट को अपने विचार व्यवस्थित करने में मदद करता है:
@tool
def todo_write(tasks: List[str]) -> str:
formatted_tasks = "\n".join([f"- {task}" for task in tasks])
return f"Todo list created:\n{formatted_tasks}"यह सरल टूल महत्वपूर्ण संदर्भ इंजीनियरिंग प्रदान करता है, जो एजेंट को योजना बनाने और निष्पादन के दौरान उस योजना को दृश्य में रखने के लिए प्रेरित करता है।
3. सब-एजेंट्स
Deep Agents केन्द्रित कार्यों के लिए विशिष्टीकृत सब-एजेंट्स शुरू कर सकते हैं। प्रत्येक सब-एजेंट अपना प्रॉम्प्ट, विवरण और टूलसेट रखता है, जिससे कंसर्न्स का पृथक्करण और कार्य-विशिष्ट अनुकूलन संभव होता है। यहां आपके वर्कफ्लो में सब-एजेंट्स परिभाषित करने का एक उदाहरण है:
subagents = [
{
"name": "research-agent",
"description": "Conducts deep research on specific topics",
"prompt": "You are a research specialist. Focus intensively on the given topic...",
"tools": ["internet_search", "read_file", "write_file"]
},
{
"name": "analysis-agent",
"description": "Analyzes data and draws insights",
"prompt": "You are a data analyst. Examine the provided information...",
"tools": ["read_file", "write_file"]
}
]यह दृष्टिकोण संदर्भ क्वारंटीन प्रदान करता है, यानी प्रत्येक सब-एजेंट अपना संदर्भ बनाए रखता है और मुख्य एजेंट की मेमोरी को प्रदूषित नहीं करता। विशेष कार्यों को अलग करके, आप सक्षम होते हैं:
- प्रॉम्प्ट विशेषज्ञता: प्रत्येक एजेंट को लक्षित निर्देशों और उदाहरणों के साथ उसकी विशिष्ट भूमिका के लिए फाइन-ट्यून किया जा सकता है।
- क्लीनर संदर्भ प्रबंधन: मुख्य एजेंट का संदर्भ केन्द्रित रहता है और अप्रासंगिक विवरणों से मुक्त, जबकि सब-एजेंट्स अपनी सीमाओं के भीतर काम करते हैं।
- मॉड्यूलर रीजनिंग: कार्यों को डेलिगेट, पैरेललाइज़ या क्रमिक रूप से परिष्कृत किया जा सकता है, जिससे आपके एजेंट सिस्टम को नए डोमेन्स तक स्केल करना आसान हो जाता है।
4. फाइल सिस्टम इंटीग्रेशन
Deep Agents एक वर्चुअल फाइल सिस्टम का उपयोग करके स्टेट को बनाए रखते और साझा करते हैं। केवल बातचीत इतिहास पर निर्भर रहने के बजाय, ये बिल्ट-इन टूल्स एजेंट्स को पूरे वर्कफ्लो में जानकारी व्यवस्थित करने देते हैं:
tools = [
"ls", # List files
"read_file", # Read file contents
"write_file", # Write to file
"edit_file" # Edit existing file
]यह वर्चुअल फाइल सिस्टम कई लाभ प्रदान करता है:
- स्थायी मेमोरी: एजेंट्स मुख्य निष्कर्ष, नोट्स, या मध्यवर्ती परिणाम फाइलों में सहेज सकते हैं, जिससे यह जानकारी कई चरणों और यहां तक कि सब-एजेंट्स में भी सुलभ रहती है।
- साझा कार्यक्षेत्र: कई एजेंट (या सब-एजेंट्स) एक ही फाइलें पढ़कर और लिखकर सहयोग कर सकते हैं, जिससे एक ही वर्कफ्लो में टीमवर्क संभव होता है।
- जानकारी का संगठन: जटिल, बहु-चरणीय कार्यों का प्रबंधन आसान हो जाता है क्योंकि एजेंट्स आवश्यकतानुसार दस्तावेज़ों या आर्टिफैक्ट्स को बना, श्रेणीकृत और संदर्भित कर सकते हैं।
डेमो: LangChain के deepagents के साथ जॉब एप्लिकेशन असिस्टेंट बनाना
मैं आपको एक व्यावहारिक उदाहरण के माध्यम से ले जाऊंगा जिसमें हम एक जॉब एप्लिकेशन असिस्टेंट बनाएंगे जो स्वतः प्रासंगिक नौकरियां ढूंढेगा और उपयोगकर्ता के लिए अनुकूलित कवर लेटर जेनरेट करेगा।
हमारा असिस्टेंट यह करेगा:
- उपयोगकर्ता द्वारा निर्दिष्ट मानदंडों के आधार पर वर्तमान जॉब पोस्टिंग्स खोजेगा
- कौशल मिलान के अनुसार नौकरियों को फ़िल्टर और रैंक करेगा
- प्रत्येक भूमिका के लिए वैयक्तिकृत कवर लेटर जेनरेट करेगा
- सभी परिणामों को उपयोगकर्ता के लिए डाउनलोड योग्य प्रारूप में पैकेज करेगा
चरण 1: प्रारंभिक सेटअप और निर्भरताएं
आइए बुनियादी इंस्टॉलेशन और सेटअप से शुरू करें:
pip install deepagents
pip install tavily-python
pip install streamlit
pip install langchain-openaiइंस्टॉल होने के बाद, हम अपने environment variables सेट करेंगे:
export OPENAI_API_KEY=sk-projxxxxxxxxxxxxxxxxxxx
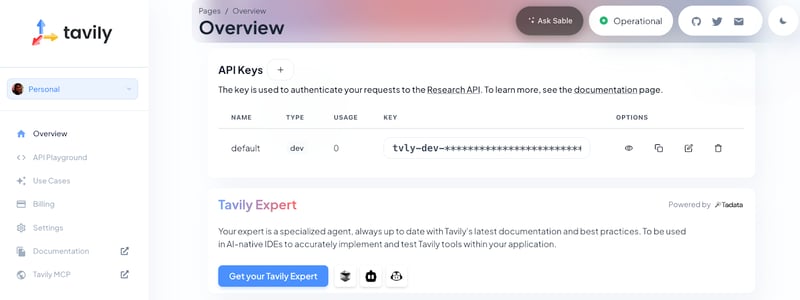
export TAVILY_API_KEY=tvly-devxxxxxxxxxxxxxxxxxxxइस डेमो के लिए, आपको OpenAI API कुंजी (GPT-4o mini मॉडल के लिए) और Tavily API कुंजी (वेब सर्च फंक्शनैलिटी के लिए) दोनों की आवश्यकता होगी। Tavily एजेंट को वेब से नवीनतम जॉब पोस्टिंग्स देता है, जबकि OpenAI का मॉडल सभी भाषा समझ, रीजनिंग, प्लानिंग और कंटेंट जेनरेशन संभालता है।
नोट: नए Tavily उपयोगकर्ताओं को 1,000 निःशुल्क API क्रेडिट मिलते हैं। अपनी कुंजी पाने के लिए, बस https://app.tavily.com पर साइन अप करें।
अंत में, हम आवश्यक लाइब्रेरीज़ इम्पोर्ट करेंगे और Streamlit इंटरफेस सेट करेंगे:
import os
import io
import json
import re
from typing import Literal, Dict, Any, List
import streamlit as st
import pandas as pd
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from tavily import TavilyClient
from deepagents import create_deep_agentयह चरण हमारे deep agent एप्लिकेशन के लिए सभी आवश्यक निर्भरताएं इम्पोर्ट करता है। हम वेब इंटरफेस के लिए streamlit, डेटा हैंडलिंग के लिए pandas, LLM इंटीग्रेशन के लिए langchain_openai, और एजेंट फ्रेमवर्क के लिए deepagents का उपयोग करते हैं।
चरण 2: सेशन स्टेट मैनेजमेंट
अगला, हम Streamlit के सेशन स्टेट को इनिशियलाइज़ करते हैं ताकि उपयोगकर्ता इंटरेक्शन के बीच डेटा बना रहे। इससे ऐप अपलोड की गई फाइलें, परिणाम और एरर स्टेट्स को याद रखता है, भले ही उपयोगकर्ता इंटरफेस के साथ आगे-पीछे करें:
if "jobs_df" not in st.session_state:
st.session_state.jobs_df = None
if "cover_doc" not in st.session_state:
st.session_state.cover_doc = None
if "last_error" not in st.session_state:
st.session_state.last_error = ""
if "raw_final" not in st.session_state:
st.session_state.raw_final = ""यह सेटअप सुगम उपयोगकर्ता अनुभव के लिए आवश्यक है, जिससे हम सेशन के दौरान जॉब परिणाम, जेनरेट किए गए कवर लेटर और किसी भी एरर संदेशों को स्टोर कर सकें।
चरण 3: यूज़र इंटरफेस सेटअप
हम UI में इनपुट फ़ील्ड्स—रिज़्यूमे अपलोड, जॉब टाइटल, लोकेशन और वैकल्पिक स्किल्स—को व्यवस्थित करने के लिए Streamlit कॉलम्स का उपयोग करते हैं:
st.set_page_config(page_title="Job Application Assistant", page_icon=" ", layout="wide")
st.title("💼 Job Application Assistant")
c0, c1, c2 = st.columns([2, 1, 1])
with c0:
uploaded = st.file_uploader("Upload your resume (PDF/DOCX/TXT)", type=["pdf", "docx", "txt"])
with c1:
target_title = st.text_input("Target title", "Senior Machine Learning Engineer")
with c2:
target_location = st.text_input("Target location(s)", "Bangalore OR Remote")
skills_hint = st.text_area(
"Add/override skills (optional)",
"",
placeholder="Python, PyTorch, LLMs, RAG, Azure, vLLM, FastAPI",
)बेहतर लेआउट के लिए UI को कॉलम्स में व्यवस्थित किया गया है। उपयोगकर्ता अपने रिज़्यूमे को कई प्रारूपों में अपलोड कर सकते हैं, अपने लक्षित जॉब टाइटल और लोकेशन निर्दिष्ट कर सकते हैं, और उन विशिष्ट स्किल्स को हाइलाइट कर सकते हैं जिन्हें वे अपने एप्लिकेशन में प्रमुखता देना चाहते हैं।
चरण 4: फाइल प्रोसेसिंग हेल्पर फंक्शंस
अब, हम विभिन्न रिज़्यूमे प्रारूपों को संभालने और उनमें से टेक्स्ट निकालने के लिए मजबूत फाइल प्रोसेसिंग लागू करते हैं।
import pypdf
import docx
def extract_text(file) -> str:
if not file:
return ""
name = file.name.lower()
if name.endswith(".txt"):
return file.read().decode("utf-8", errors="ignore")
if name.endswith(".pdf"):
pdf = pypdf.PdfReader(io.BytesIO(file.read()))
return "\n".join((p.extract_text() or "") for p in pdf.pages)
if name.endswith(".docx"):
d = docx.Document(io.BytesIO(file.read()))
return "\n".join(p.text for p in d.paragraphs)
return ""
def md_to_docx(md_text: str) -> bytes:
doc = docx.Document()
for raw in md_text.splitlines():
line = raw.rstrip()
if not line:
doc.add_paragraph("")
continue
if line.startswith("#"):
level = min(len(line) - len(line.lstrip("#")), 3)
doc.add_heading(line.lstrip("#").strip(), level=level)
elif line.startswith(("- ", "* ")):
doc.add_paragraph(line[2:].strip(), style="List Bullet")
else:
doc.add_paragraph(line)
bio = io.BytesIO()
doc.save(bio)
bio.seek(0)
return bio.read()ये हेल्पर फंक्शंस विभिन्न फाइल प्रारूपों (PDF, DOCX, TXT) से टेक्स्ट निकालने और मार्कडाउन आउटपुट को वापस DOCX प्रारूप में बदलकर डाउनलोड के लिए तैयार करने की जटिलता को संभालते हैं। प्रत्येक फ़ंक्शन इस प्रकार काम करता है:
extract_text()फ़ंक्शन अपलोड की गई फाइल टाइप (TXT, PDF, या DOCX) को स्वतः पहचानता है और उपयुक्त लाइब्रेरी का उपयोग करके सामग्री निकालता है, जिससे उपयोगकर्ताओं को फाइल फॉर्मेट की चिंता नहीं करनी पड़ती।-
md_to_docx()फ़ंक्शन मार्कडाउन-फ़ॉर्मैटेड टेक्स्ट (जैसे एजेंट द्वारा जेनरेट किए गए कवर लेटर) को एक साफ-सुथरे, सुव्यवस्थित Word दस्तावेज़ में बदलता है जो डाउनलोड के लिए तैयार होता है।
इससे एप्लिकेशन विविध रिज़्यूमे इनपुट को लचीले ढंग से संभाल सकता है और मूल फाइल प्रारूप चाहे जो भी हो, पेशेवर आउटपुट प्रदान कर सकता है।
चरण 5: डेटा प्रोसेसिंग और एक्सट्रैक्शन
अब, हम एजेंट के उत्तर से जॉब डेटा निकालने के लिए मजबूत पार्सिंग लागू करते हैं।
def normalize_jobs(items: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
normed = []
for it in items:
if not isinstance(it, dict):
continue
# case-insensitive keys
lower_map = {str(k).strip().lower(): it[k] for k in it.keys()}
company = str(lower_map.get("company", "") or "").strip()
title = str(lower_map.get("title", "") or "").strip()
location = str(lower_map.get("location", "") or "").strip()
link = str(lower_map.get("link", "") or "").strip()
why_fit = str(lower_map.get("why_fit", lower_map.get("good match", "")) or "").strip()
if not link:
continue
normed.append({
"company": company or "—",
"title": title or "—",
"location": location or "—",
"link": link,
"Good Match": "Yes" if why_fit else "—",
})
return normed[:5]
def extract_jobs_from_text(text: str) -> List[Dict[str, Any]]:
if not text:
return []
pattern = r"<JOBS>\s*(?:```[\w-]*\s*)?(\[.*?\])\s*(?:```)?\s*</JOBS>"
m = re.search(pattern, text, flags=re.S | re.I)
if not m:
return []
raw = m.group(1).strip().strip("`").strip()
try:
obj = json.loads(raw)
return obj if isinstance(obj, list) else []
except Exception:
try:
salvaged = re.sub(r"(?<!\\)'", '"', raw)
obj = json.loads(salvaged)
return obj if isinstance(obj, list) else []
except Exception:
st.session_state.last_error = f"JSON parse failed: {raw[:1200]}"
return []आइए ऊपर दिए गए फंक्शंस को संक्षेप में समझें:
extract_jobs_from_text()फ़ंक्शन एक रेगुलर एक्सप्रेशन का उपयोग करके एजेंट के संरचित आउटपुट (<JOBS>...</JOBS> टैग्स के अंदर) से जॉब्स का JSON एरे निकालता है। फॉलबैक पार्सिंग भी शामिल है ताकि छोटी मॉडल गलतियों—जैसे JSON में डबल कोट्स की जगह सिंगल कोट्स लौटाना—को संभाला जा सके।- इसके बाद
normalize_jobs()फ़ंक्शन प्रत्येक जॉब डिक्शनरी को मानकीकृत और क्लीनअप करता है—जैसे केस-इनसेंसिटिव कीज़, आवश्यक फ़ील्ड्स, और व्हाइटस्पेस स्ट्रिपिंग—और आउटपुट को शीर्ष 5 प्रविष्टियों तक सीमित कर देता है।
चरण 6: टूल इंटीग्रेशन
रिसर्च क्षमता का मूल Tavily द्वारा संचालित है। इसलिए, हम एक वेब सर्च टूल परिभाषित करते हैं जिसका उपयोग deep agent नवीनतम जॉब लिस्टिंग्स खोजने के लिए करेगा:
TAVILY_KEY = os.environ.get("TAVILY_API_KEY", "")
@tool
def internet_search(
query: str,
max_results: int = 5,
topic: Literal["general", "news", "finance"] = "general",
include_raw_content: bool = False,
) -> List[Dict[str, Any]]:
if not TAVILY_KEY:
raise RuntimeError("TAVILY_API_KEY is not set in the environment.")
client = TavilyClient(api_key=TAVILY_KEY)
return client.search(
query=query,
max_results=max_results,
include_raw_content=include_raw_content,
topic=topic,
)internet_search() फ़ंक्शन @tool से सजाया गया है, जिससे यह एजेंट और सब-एजेंट्स के लिए सुलभ हो जाता है। यह Tavily API को कॉल करता है, जो प्रासंगिक, हालिया सर्च परिणाम लौटाता है—इसे डायनामिक जॉब क्वेरीज़ और रिसर्च के लिए आदर्श बनाता है।
नोट: आप इसी तरह और टूल्स जोड़ सकते हैं (जैसे डॉक्यूमेंट सार-संक्षेपण, कोड निष्पादन, या डेटा एनरिचमेंट) ताकि अपने deep agent की क्षमताओं का विस्तार कर सकें।
चरण 7: Deep agent कॉन्फ़िगरेशन
अब, हम मुख्य एजेंट और उसके सब-एजेंट्स को लक्षित निर्देशों के साथ कॉन्फ़िगर करके सब कुछ साथ लाते हैं, इस प्रकार:
INSTRUCTIONS = (
"You are a job application assistant. Do two things:\n"
"1) Use the web search tool to find exactly 5 CURRENT job postings (matching the user's target title, locations, and skills). "
"Return them ONLY as JSON in this exact wrapper:\n"
"<JOBS>\n"
"[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}, ... five total]\n"
"</JOBS>\n"
"Rules: The list must be valid JSON (no comments), real links to the job page or application page, no duplicates.\n"
"2) Produce a concise cover letter (≤150 words) for EACH job, with a subject line, appended to cover_letters.md under a heading per job.\n"
"Do not invent jobs. Prefer reputable sources (company career pages, LinkedIn, Lever, Greenhouse)."
)
JOB_SEARCH_PROMPT = (
"Search and select 5 real postings that match the user's title, locations, and skills. "
"Output ONLY this block format (no extra text before/after the wrapper):\n"
"<JOBS>\n"
"[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
" {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}]"
"\n</JOBS>"
)
COVER_LETTER_PROMPT = (
"For each job in the found list, write a subject line and a concise cover letter (≤150 words) that ties the user's skills/resume to the role. "
"Append to cover_letters.md under a heading per job. Keep writing tight and specific."
)
def build_agent():
api_key = os.environ.get("OPENAI_API_KEY")
if not api_key:
st.error("Please set OPENAI_API_KEY in your environment.")
st.stop()
llm = ChatOpenAI(model=os.environ.get("OPENAI_MODEL", "gpt-4o-mini"), temperature=0.2)
tools = [internet_search]
subagents = [
{"name": "job-search-agent", "description": "Finds relevant jobs", "prompt": JOB_SEARCH_PROMPT},
{"name": "cover-letter-writer-agent", "description": "Writes cover letters", "prompt": COVER_LETTER_PROMPT},
]
return create_deep_agent(tools, INSTRUCTIONS, subagents=subagents, model=llm)
def make_task_prompt(resume_text: str, skills_hint: str, title: str, location: str) -> str:
skills = skills_hint.strip()
skill_line = f" Prioritize these skills: {skills}." if skills else ""
return (
f"Target title: {title}\n"
f"Target location(s): {location}\n"
f"{skill_line}\n\n"
f"RESUME RAW TEXT:\n{resume_text[:8000]}"
)यह चरण विशिष्ट सब-एजेंट्स के माध्यम से Deep Agents की शक्ति दर्शाता है। मुख्य निर्देश समग्र गाइडेंस देते हैं, जबकि प्रत्येक सब-एजेंट के पास विशिष्ट कार्यों के लिए केन्द्रित प्रॉम्प्ट्स होते हैं:
INSTRUCTIONS,JOB_SEARCH_PROMPTऔरCOVER_LETTER_PROMPTमुख्य सिस्टम प्रॉम्प्ट और प्रत्येक सब-एजेंट के लिए विशेष निर्देश परिभाषित करते हैं। इससे एजेंट आवश्यक प्रारूप में सुव्यवस्थित जॉब परिणाम और अनुकूलित कवर लेटर हमेशा तैयार करता है।build_agent()फ़ंक्शन OpenAI API कुंजी की जाँच करता है, लैंग्वेज मॉडल सेट करता है, और जॉब सर्च तथा कवर लेटर सब-एजेंट्स के साथ deep agent बनाता है। यह मॉड्यूलर सेटअप प्रत्येक सब-एजेंट को उसके वर्कफ़्लो हिस्से पर फोकस करने देता है।- फिर
make_task_prompt()फ़ंक्शन उपयोगकर्ता के रिज़्यूमे, स्किल्स, जॉब टाइटल और लोकेशन को मिलाकर एक एकीकृत प्रॉम्प्ट बनाता है। इससे एजेंट को खोज और ड्राफ्टिंग शुरू करने के लिए पूरा संदर्भ मिल जाता है।
मिलकर, ये फंक्शंस वर्कफ्लो में संरचना और विशेषज्ञता जोड़ते हैं।
चरण 8: मुख्य एप्लिकेशन लॉजिक
यह चरण मुख्य एप्लिकेशन लॉजिक है जो उपयोगकर्ता इनपुट संभालता है और deep agent को संगठित करता है:
resume_text = extract_text(uploaded) if uploaded else ""
run_clicked = st.button("Run", type="primary", disabled=not uploaded)
if run_clicked:
st.session_state.last_error = ""
st.session_state.raw_final = ""
try:
if not os.environ.get("OPENAI_API_KEY"):
st.error("OPENAI_API_KEY not set.")
st.stop()
if not TAVILY_KEY:
st.error("TAVILY_API_KEY not set.")
st.stop()
agent = build_agent()
task = make_task_prompt(resume_text, skills_hint, target_title, target_location)
state = {
"messages": [{"role": "user", "content": task}],
"files": {"cover_letters.md": ""},
}
with st.spinner("Finding jobs and drafting cover letters..."):
result = agent.invoke(state)
final_msgs = result.get("messages", [])
final_text = (final_msgs[-1].content if final_msgs else "") or ""
st.session_state.raw_final = final_text
files = result.get("files", {}) or {}
cover_md = (files.get("cover_letters.md") or "").strip()
st.session_state.cover_doc = md_to_docx(cover_md) if cover_md else None
raw_jobs = extract_jobs_from_text(final_text)
jobs_list = normalize_jobs(raw_jobs)
st.session_state.jobs_df = pd.DataFrame(jobs_list) if jobs_list else None
st.success("Done. Results generated and saved.")
except Exception as e:
st.session_state.last_error = str(e)
st.error(f"Error: {e}")ऊपर का कोड उपयोगकर्ता क्रियाओं को संभालता है, deep agent लॉन्च करता है और परिणाम दर्शाता है, इस प्रकार:
- जब उपयोगकर्ता Run पर क्लिक करता/करती है, तो ऐप आवश्यक API कुंजियों की उपलब्धता जाँचता है।
- यह रिज़्यूमे से टेक्स्ट निकालता है, इनपुट (स्किल्स, टाइटल, लोकेशन) एकत्र करता है, और टास्क प्रॉम्प्ट बनाता है।
- एजेंट को उपयोगकर्ता की क्वेरी और कवर लेटर्स के लिए फाइल प्लेसहोल्डर दोनों पास करते हुए इन्वोक किया जाता है।
- जैसे ही एजेंट अपना वर्कफ़्लो पूरा करता है, ऐप:
- जेनरेट किए गए कवर लेटर निकालता और सहेजता है (डाउनलोड के लिए DOCX में कन्वर्ट किए गए)
- जॉब मैचेस को पार्स, नॉर्मलाइज़ और एक इंटरैक्टिव DataFrame के रूप में प्रदर्शित करता है
चरण 9: परिणाम प्रदर्शन और डाउनलोड
अंत में, हम परिणामों को उपयोगकर्ता-अनुकूल प्रारूप में प्रस्तुत करते हैं:
st.header("Jobs")
if st.session_state.jobs_df is None or st.session_state.jobs_df.empty:
st.write("No jobs to show yet.")
else:
df = st.session_state.jobs_df.copy()
def as_link(u: str) -> str:
u = u if isinstance(u, str) else ""
return f'<a href="{u}" target="_blank">Apply</a>' if u else "—"
if "link" in df.columns:
df["link"] = df["link"].apply(as_link)
cols = [c for c in ["company", "title", "location", "link", "Good Match"] if c in df.columns]
df = df[cols]
st.write(df.to_html(escape=False, index=False), unsafe_allow_html=True)
st.header("Download")
if st.session_state.cover_doc:
st.download_button(
"Download cover_letters.docx",
data=st.session_state.cover_doc,
file_name="cover_letters.docx",
mime="application/vnd.openxmlformats-officedocument.wordprocessingml.document",
key="dl_cover_letters",
)
else:
st.caption("Cover letters not produced yet.")एजेंट के समाप्त होने के बाद, हम परिणामों को एक परिष्कृत लेआउट में प्रस्तुत करते हैं, जैसे:
- ऐप तालिका में जॉब मैचेस दिखाता है, प्रत्येक पद के लिए क्लिक करने योग्य Apply लिंक्स के साथ।
- यदि कवर लेटर्स उपलब्ध हैं, तो एक डाउनलोड बटन उपयोगकर्ताओं को उन्हें Word दस्तावेज़ के रूप में सहेजने देता है।
यह एक बहु-चरणीय AI वर्कफ़्लो को एक सरल वन-क्लिक अनुभव में बदल देता है।
ऐप लॉन्च करने के लिए, बस यह चलाएं:
streamlit app.pyनिष्कर्ष
Deep Agents एजेंट आर्किटेक्चर में एक महत्वपूर्ण विकास का प्रतिनिधित्व करते हैं—साधारण टूल-कॉलिंग से आगे बढ़कर ऐसे परिष्कृत सिस्टम तक, जो जटिल कार्यों पर योजना, डेलिगेशन और सतत निष्पादन करने में सक्षम हैं। deepagents पैकेज इस आर्किटेक्चर को सुलभ बनाता है, जिससे डेवलपर्स रिसर्च, कोडिंग, विश्लेषण और विशेष डोमेन्स के लिए प्रोडक्शन-रेडी एजेंट बना सकते हैं।
जैसे-जैसे AI एजेंट व्यवसाय और रिसर्च में आवश्यक बनते जा रहे हैं, deep agent आर्किटेक्चर वास्तविक दुनिया पर प्रभाव डालने के लिए आवश्यक संरचना और लचीलापन प्रदान करते हैं। यदि आप एक नो-कोड समाधान ढूंढ रहे हैं, तो मैं LangSmith Agent Builder ट्यूटोरियल देखने की भी सिफारिश करता/करती हूं।

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
आज की सबसे आम एजेंट आर्किटेक्चर में एक LLM लूप में टूल्स को कॉल करता है—यह सरल, प्रभावी, पर अंततः सीमित है। यह तरीका सीधे-सरल कार्यों के लिए काम करता है, लेकिन जब योजना, संदर्भ प्रबंधन और लंबी अवधि में सतत निष्पादन की आवश्यकता वाले जटिल, बहु-चरणीय चुनौतियों का सामना होता है, तो यह कम पड़ जाता है।
LangChain के Deep Agents आर्किटेक्चर विस्तृत सिस्टम प्रॉम्प्ट्स, प्लानिंग टूल्स, सब-एजेंट्स और फाइल सिस्टम्स को जोड़कर ऐसे AI एजेंट बनाता है जो जटिल रिसर्च, कोडिंग और विश्लेषणात्मक कार्यों को संभाल सकें। Claude Code, Deep Research और Manus जैसे अनुप्रयोगों ने इस दृष्टिकोण की प्रभावशीलता साबित की है, और अब
deepagentsPython पैकेज इस आर्किटेक्चर को सभी के लिए सुलभ बनाता है।इस ट्यूटोरियल में, मैं चरण-दर-चरण समझाऊंगा कि कैसे: