
Khóa học
Giới thiệu về AI Agents
1 giờ 30 phút
148.1K
Kiến trúc agent phổ biến nhất hiện nay là LLM gọi công cụ theo vòng lặp: đơn giản, hiệu quả, nhưng rốt cuộc vẫn có giới hạn. Cách làm này xử lý tốt các tác vụ thẳng thắn, song hụt hơi trước những thách thức phức tạp, nhiều bước, đòi hỏi lập kế hoạch, quản lý ngữ cảnh và thực thi bền bỉ trong khoảng thời gian dài hơn.
Deep Agents của LangChain kết hợp các system prompt chi tiết, công cụ lập kế hoạch, sub-agent, và hệ thống tệp để tạo ra các AI agent có khả năng xử lý những tác vụ nghiên cứu, lập trình và phân tích phức tạp. Các ứng dụng như Claude Code, Deep Research và Manus đã chứng minh hiệu quả của cách tiếp cận này, và giờ đây gói Python deepagents giúp kiến trúc này trở nên dễ tiếp cận với mọi người.
Trong hướng dẫn này, tôi sẽ giải thích từng bước cách:
Deep Agents là một kiến trúc agent tiên tiến được thiết kế để xử lý các tác vụ phức tạp, nhiều bước, đòi hỏi suy luận liên tục, sử dụng công cụ và bộ nhớ. Khác với các agent truyền thống hoạt động theo vòng lặp ngắn hoặc chỉ gọi công cụ đơn giản, Deep Agents lập kế hoạch hành động, quản lý ngữ cảnh đang thay đổi, giao phó tiểu nhiệm vụ cho sub-agent chuyên biệt và duy trì trạng thái xuyên suốt các tương tác dài. Kiến trúc này đã và đang vận hành các ứng dụng thực tiễn như Claude Code, Deep Research và Manus.
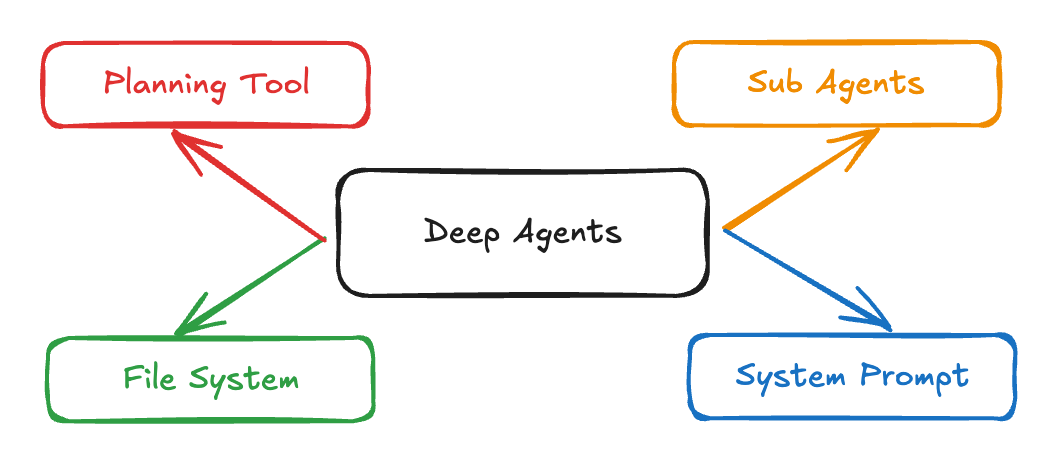
Nguồn: LangChain
Dưới đây là các đặc trưng then chốt của Deep Agents:
Deep Agents vượt qua hạn chế của agent truyền thống nhờ bốn thành phần cốt lõi:
Khác với prompt chỉ dẫn đơn giản, Deep Agents dùng system prompt toàn diện như sau:
DEEP_AGENT_SYSTEM_PROMPT = """
You are an expert research assistant capable of conducting thorough,
multi-step investigations. Your capabilities include:
PLANNING: Break complex tasks into subtasks using the todo_write tool
RESEARCH: Use internet_search extensively to gather comprehensive information
DELEGATION: Spawn sub-agents for specialized tasks using the call_subagent tool
DOCUMENTATION: Maintain detailed notes using the file system tools
When approaching a complex task:
1. First, create a plan using todo_write
2. Research systematically, saving important findings to files
3. Delegate specialized work to appropriate sub-agents
4. Synthesize findings into a comprehensive response
Examples:
[Detailed few-shot examples follow...]
"""
Prompt này tích hợp lập kế hoạch, nghiên cứu và uỷ thác với ghi chép tài liệu, sử dụng các ví dụ few-shot để phân rã nhiệm vụ phức tạp.
Công cụ lập kế hoạch thường chỉ là một "no-op" giúp agent sắp xếp suy nghĩ:
@tool
def todo_write(tasks: List[str]) -> str:
    formatted_tasks = "\n".join([f"- {task}" for task in tasks])
    return f"Todo list created:\n{formatted_tasks}"
Công cụ đơn giản này mang lại kỹ thuật ngữ cảnh quan trọng, buộc agent phải lập kế hoạch tương ứng và giữ kế hoạch đó hiển thị xuyên suốt quá trình thực thi.
Deep Agents có thể khởi tạo sub-agent chuyên biệt cho các tác vụ tập trung. Mỗi sub-agent được thiết kế với prompt, mô tả và bộ công cụ riêng, cho phép tách biệt mối quan tâm và tối ưu hoá sâu theo từng nhiệm vụ. Sau đây là ví dụ định nghĩa sub-agent trong quy trình của bạn:
subagents = [
    {
        "name": "research-agent",
        "description": "Conducts deep research on specific topics",
        "prompt": "You are a research specialist. Focus intensively on the given topic...",
        "tools": ["internet_search", "read_file", "write_file"]
    },
    {
        "name": "analysis-agent",
        "description": "Analyzes data and draws insights",
        "prompt": "You are a data analyst. Examine the provided information...",
        "tools": ["read_file", "write_file"]
    }
]
Cách tiếp cận này cung cấp vùng cách ly ngữ cảnh, nghĩa là mỗi sub-agent duy trì ngữ cảnh của riêng mình và không làm nhiễu bộ nhớ của agent chính. Bằng việc cô lập tác vụ chuyên biệt, bạn có thể bật:
Deep Agents duy trì và chia sẻ trạng thái qua một hệ thống tệp ảo. Thay vì chỉ dựa vào lịch sử hội thoại, các công cụ tích hợp này cho phép agent tổ chức thông tin xuyên suốt quy trình làm việc:
tools = [
    "ls",           # List files
    "read_file",    # Read file contents
    "write_file",   # Write to file
    "edit_file"     # Edit existing file
]
Hệ thống tệp ảo này mang lại nhiều lợi ích:
deepagents của LangChainTôi sẽ hướng dẫn bạn qua ví dụ thực tế xây dựng một trợ lý ứng tuyển tự động tìm tin tuyển dụng phù hợp và tạo thư xin việc được cá nhân hoá cho người dùng.
Trợ lý của chúng ta sẽ:
Bắt đầu với cài đặt và thiết lập cơ bản:
pip install deepagents
pip install tavily-python
pip install streamlit
pip install langchain-openai
Sau khi cài, chúng ta thiết lập biến môi trường:
export OPENAI_API_KEY=sk-projxxxxxxxxxxxxxxxxxxx
export TAVILY_API_KEY=tvly-devxxxxxxxxxxxxxxxxxxx
Trong demo này, bạn cần cả khoá OpenAI API (cho model GPT-4o mini) và khoá Tavily API (cho chức năng tìm kiếm web). Tavily cung cấp cho agent các tin tuyển dụng mới nhất trực tiếp từ web, còn model của OpenAI xử lý hiểu ngôn ngữ, suy luận, lập kế hoạch và tạo nội dung.
Lưu ý: Người dùng mới của Tavily nhận 1.000 credit API miễn phí. Để lấy khoá, chỉ cần đăng ký tại https://app.tavily.com.
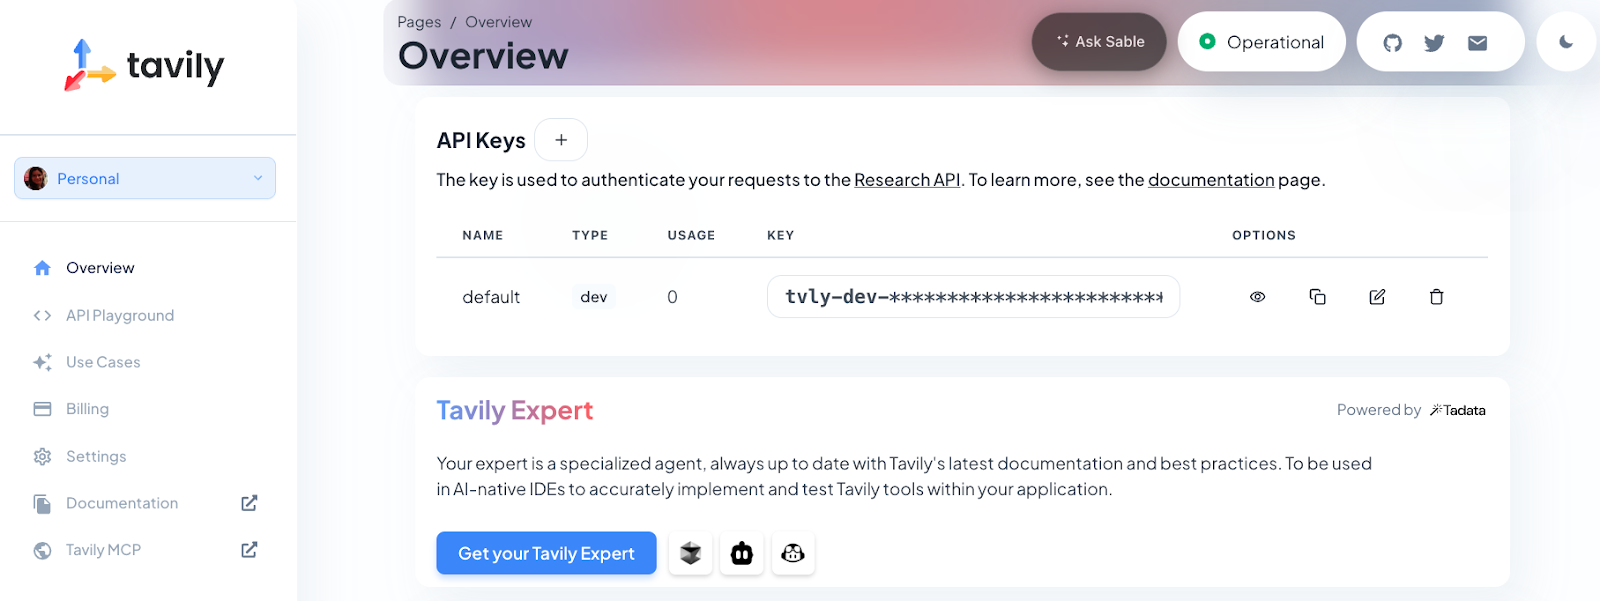
Cuối cùng, chúng ta import các thư viện cần thiết và thiết lập giao diện Streamlit:
import os
import io
import json
import re
from typing import Literal, Dict, Any, List
import streamlit as st
import pandas as pd
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from tavily import TavilyClient
from deepagents import create_deep_agent
Bước này import mọi phụ thuộc cần cho ứng dụng deep agent. Chúng ta dùng streamlit cho giao diện web, pandas cho xử lý dữ liệu, langchain_openai cho tích hợp LLM, và deepagents cho framework agent.
Tiếp theo, chúng ta khởi tạo session state của Streamlit để duy trì dữ liệu giữa các tương tác. Điều này đảm bảo ứng dụng ghi nhớ tệp đã tải, kết quả và trạng thái lỗi khi người dùng thao tác với giao diện:
if "jobs_df" not in st.session_state:
    st.session_state.jobs_df = None
if "cover_doc" not in st.session_state:
    st.session_state.cover_doc = None
if "last_error" not in st.session_state:
    st.session_state.last_error = ""
if "raw_final" not in st.session_state:
    st.session_state.raw_final = ""
Thiết lập này rất cần cho trải nghiệm mượt mà, cho phép lưu trữ kết quả công việc, thư xin việc được tạo và mọi thông báo lỗi trong suốt phiên.
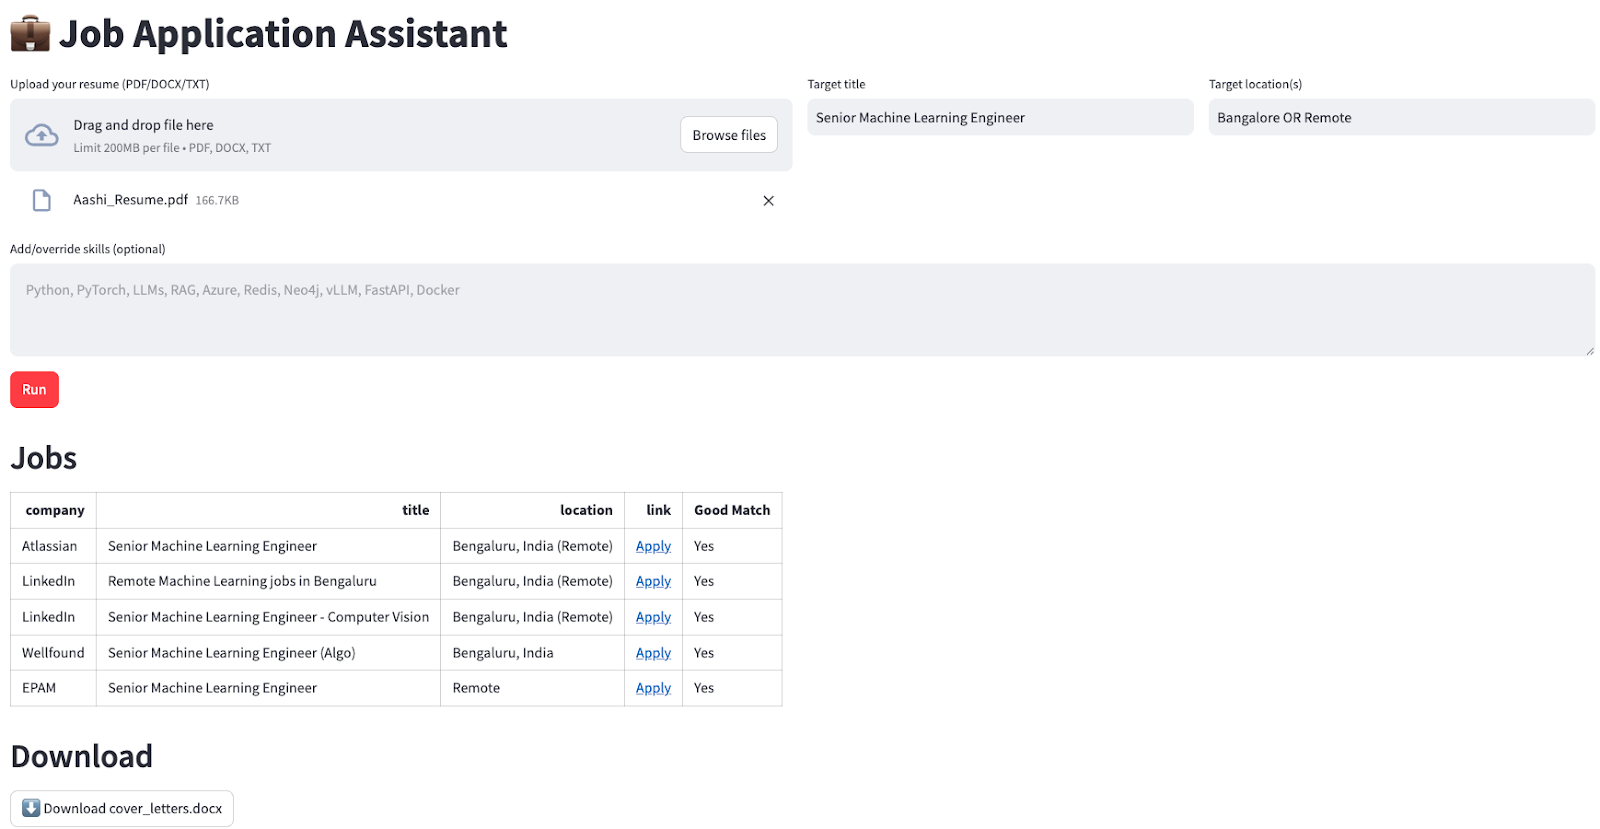
Chúng ta dùng các cột của Streamlit để sắp xếp trường nhập cho tải sơ yếu lý lịch, chức danh, địa điểm và kỹ năng tuỳ chọn:
st.set_page_config(page_title="Job Application Assistant", page_icon=" ", layout="wide")
st.title("💼 Job Application Assistant")
c0, c1, c2 = st.columns([2, 1, 1])
with c0:
    uploaded = st.file_uploader("Upload your resume (PDF/DOCX/TXT)", type=["pdf", "docx", "txt"])
with c1:
    target_title = st.text_input("Target title", "Senior Machine Learning Engineer")
with c2:
    target_location = st.text_input("Target location(s)", "Bangalore OR Remote")
skills_hint = st.text_area(
    "Add/override skills (optional)",
    "",
    placeholder="Python, PyTorch, LLMs, RAG, Azure, vLLM, FastAPI",
)
Giao diện được tổ chức theo cột để bố cục đẹp hơn. Người dùng có thể tải sơ yếu lý lịch ở nhiều định dạng, chỉ định chức danh và địa điểm mong muốn, và nêu bật các kỹ năng muốn nhấn mạnh trong hồ sơ ứng tuyển.
Tiếp theo, chúng ta triển khai xử lý tệp vững chắc để hỗ trợ các định dạng sơ yếu lý lịch khác nhau và trích xuất văn bản từ đó.
 import pypdf
 import docx
def extract_text(file) -> str:
    if not file:
        return ""
    name = file.name.lower()
    if name.endswith(".txt"):
        return file.read().decode("utf-8", errors="ignore")
    if name.endswith(".pdf"):
        pdf = pypdf.PdfReader(io.BytesIO(file.read()))
        return "\n".join((p.extract_text() or "") for p in pdf.pages)
    if name.endswith(".docx"):
        d = docx.Document(io.BytesIO(file.read()))
        return "\n".join(p.text for p in d.paragraphs)
    return ""
def md_to_docx(md_text: str) -> bytes:
    doc = docx.Document()
    for raw in md_text.splitlines():
        line = raw.rstrip()
        if not line:
            doc.add_paragraph("")
            continue
        if line.startswith("#"):
            level = min(len(line) - len(line.lstrip("#")), 3)
            doc.add_heading(line.lstrip("#").strip(), level=level)
        elif line.startswith(("- ", "* ")):
            doc.add_paragraph(line[2:].strip(), style="List Bullet")
        else:
            doc.add_paragraph(line)
    bio = io.BytesIO()
    doc.save(bio)
    bio.seek(0)
    return bio.read()
Các hàm trợ giúp này xử lý việc trích xuất văn bản từ các định dạng khác nhau (PDF, DOCX, TXT) và chuyển đổi đầu ra markdown về DOCX để tải xuống. Cụ thể:
extract_text() tự động nhận diện loại tệp tải lên (TXT, PDF, DOCX) và trích nội dung bằng thư viện phù hợp, giúp người dùng không phải lo về định dạng.md_to_docx() nhận văn bản định dạng markdown (ví dụ thư xin việc do agent tạo) và chuyển thành tài liệu Word sạch, cấu trúc tốt, sẵn sàng tải xuống.Điều này đảm bảo ứng dụng linh hoạt với đầu vào sơ yếu lý lịch đa dạng và xuất ra tài liệu chuyên nghiệp bất kể định dạng gốc.
Tiếp theo, chúng ta triển khai phân tích cú pháp vững chắc để trích xuất dữ liệu công việc từ phản hồi của agent.
def normalize_jobs(items: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
    normed = []
    for it in items:
        if not isinstance(it, dict):
            continue
        # case-insensitive keys
        lower_map = {str(k).strip().lower(): it[k] for k in it.keys()}
        company = str(lower_map.get("company", "") or "").strip()
        title = str(lower_map.get("title", "") or "").strip()
        location = str(lower_map.get("location", "") or "").strip()
        link = str(lower_map.get("link", "") or "").strip()
        why_fit = str(lower_map.get("why_fit", lower_map.get("good match", "")) or "").strip()
        if not link:
            continue
        normed.append({
            "company": company or "—",
            "title": title or "—",
            "location": location or "—",
            "link": link,
            "Good Match": "Yes" if why_fit else "—",
        })
    return normed[:5]
def extract_jobs_from_text(text: str) -> List[Dict[str, Any]]:
    if not text:
        return []
    pattern = r"<JOBS>\s*(?:```[\w-]*\s*)?(\[.*?\])\s*(?:```)?\s*</JOBS>"
    m = re.search(pattern, text, flags=re.S | re.I)
    if not m:
        return []
    raw = m.group(1).strip().strip("`").strip()
    try:
        obj = json.loads(raw)
        return obj if isinstance(obj, list) else []
    except Exception:
        try:
            salvaged = re.sub(r"(?<!\\)'", '"', raw)
            obj = json.loads(salvaged)
            return obj if isinstance(obj, list) else []
        except Exception:
            st.session_state.last_error = f"JSON parse failed: {raw[:1200]}"
            return []
Cùng điểm nhanh cách hoạt động của các hàm trên:
extract_jobs_from_text() dùng biểu thức chính quy để trích một mảng JSON các công việc từ đầu ra có cấu trúc của agent (bên trong thẻ <JOBS>...</JOBS>). Có cơ chế dự phòng để xử lý lỗi nhỏ của mô hình, như dùng dấu nháy đơn thay vì dấu nháy kép trong JSON.normalize_jobs() chuẩn hoá và làm sạch từng dictionary công việc: không phân biệt hoa thường ở khoá, đảm bảo trường bắt buộc, cắt trắng, và giới hạn đầu ra ở 5 mục hàng đầu.Trọng tâm khả năng nghiên cứu được vận hành bởi Tavily. Vì vậy, chúng ta định nghĩa công cụ tìm kiếm web để deep agent dùng tìm tin tuyển dụng cập nhật:
TAVILY_KEY = os.environ.get("TAVILY_API_KEY", "")
@tool
def internet_search(
    query: str,
    max_results: int = 5,
    topic: Literal["general", "news", "finance"] = "general",
    include_raw_content: bool = False,
) -> List[Dict[str, Any]]:
    if not TAVILY_KEY:
        raise RuntimeError("TAVILY_API_KEY is not set in the environment.")
    client = TavilyClient(api_key=TAVILY_KEY)
    return client.search(
        query=query,
        max_results=max_results,
        include_raw_content=include_raw_content,
        topic=topic,
    )
Hàm internet_search() được trang trí bằng @tool, giúp agent và sub-agent có thể truy cập. Hàm gọi API Tavily và trả về kết quả tìm kiếm phù hợp, gần đây—rất lý tưởng cho các truy vấn công việc động và nghiên cứu.
Lưu ý: Bạn có thể bổ sung thêm công cụ theo cách này (như tóm tắt tài liệu, thực thi mã, hoặc làm giàu dữ liệu) để mở rộng khả năng của deep agent.
Giờ chúng ta tổng hợp mọi thứ bằng cách cấu hình agent chính và các sub-agent, mỗi cái với hướng dẫn nhắm mục tiêu như sau:
INSTRUCTIONS = (
    "You are a job application assistant. Do two things:\n"
    "1) Use the web search tool to find exactly 5 CURRENT job postings (matching the user's target title, locations, and skills). "
    "Return them ONLY as JSON in this exact wrapper:\n"
    "<JOBS>\n"
    "[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}, ... five total]\n"
    "</JOBS>\n"
    "Rules: The list must be valid JSON (no comments), real links to the job page or application page, no duplicates.\n"
    "2) Produce a concise cover letter (≤150 words) for EACH job, with a subject line, appended to cover_letters.md under a heading per job.\n"
    "Do not invent jobs. Prefer reputable sources (company career pages, LinkedIn, Lever, Greenhouse)."
)
JOB_SEARCH_PROMPT = (
    "Search and select 5 real postings that match the user's title, locations, and skills. "
    "Output ONLY this block format (no extra text before/after the wrapper):\n"
    "<JOBS>\n"
    "[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}]"
    "\n</JOBS>"
)
COVER_LETTER_PROMPT = (
    "For each job in the found list, write a subject line and a concise cover letter (≤150 words) that ties the user's skills/resume to the role. "
    "Append to cover_letters.md under a heading per job. Keep writing tight and specific."
)
def build_agent():
    api_key = os.environ.get("OPENAI_API_KEY")
    if not api_key:
        st.error("Please set OPENAI_API_KEY in your environment.")
        st.stop()
    llm = ChatOpenAI(model=os.environ.get("OPENAI_MODEL", "gpt-4o-mini"), temperature=0.2)
    tools = [internet_search]
    subagents = [
        {"name": "job-search-agent", "description": "Finds relevant jobs", "prompt": JOB_SEARCH_PROMPT},
        {"name": "cover-letter-writer-agent", "description": "Writes cover letters", "prompt": COVER_LETTER_PROMPT},
    ]
    return create_deep_agent(tools, INSTRUCTIONS, subagents=subagents, model=llm)
def make_task_prompt(resume_text: str, skills_hint: str, title: str, location: str) -> str:
    skills = skills_hint.strip()
    skill_line = f" Prioritize these skills: {skills}." if skills else ""
    return (
        f"Target title: {title}\n"
        f"Target location(s): {location}\n"
        f"{skill_line}\n\n"
        f"RESUME RAW TEXT:\n{resume_text[:8000]}"
    )
Bước này cho thấy sức mạnh của Deep Agents thông qua các sub-agent chuyên biệt. Hướng dẫn chính đưa ra định hướng tổng thể, trong khi mỗi sub-agent có prompt tập trung cho từng tác vụ:
INSTRUCTIONS, JOB_SEARCH_PROMPT và COVER_LETTER_PROMPT định nghĩa system prompt chính và hướng dẫn chuyên biệt cho từng sub-agent. Điều này đảm bảo agent luôn tạo kết quả công việc có cấu trúc tốt và thư xin việc phù hợp theo định dạng yêu cầu.build_agent() kiểm tra khoá OpenAI API, thiết lập mô hình ngôn ngữ và tạo deep agent với cả sub-agent tìm việc và viết thư xin việc. Thiết lập mô-đun này giúp mỗi sub-agent tập trung vào phần việc của mình.make_task_prompt() tạo một prompt duy nhất kết hợp sơ yếu lý lịch, kỹ năng, chức danh và địa điểm của người dùng. Điều này cung cấp đủ ngữ cảnh để agent bắt đầu tìm kiếm và soạn thảo.Các hàm này cùng nhau bổ sung cấu trúc và chuyên biệt hoá trong quy trình.
Đây là phần lõi xử lý đầu vào người dùng và điều phối deep agent:
resume_text = extract_text(uploaded) if uploaded else ""
run_clicked = st.button("Run", type="primary", disabled=not uploaded)
if run_clicked:
    st.session_state.last_error = ""
    st.session_state.raw_final = ""
    try:
        if not os.environ.get("OPENAI_API_KEY"):
            st.error("OPENAI_API_KEY not set.")
            st.stop()
        if not TAVILY_KEY:
            st.error("TAVILY_API_KEY not set.")
            st.stop()
        agent = build_agent()
       task = make_task_prompt(resume_text, skills_hint, target_title, target_location)
        state = {
            "messages": [{"role": "user", "content": task}],
            "files": {"cover_letters.md": ""},
        }
        with st.spinner("Finding jobs and drafting cover letters..."):
            result = agent.invoke(state)
        final_msgs = result.get("messages", [])
        final_text = (final_msgs[-1].content if final_msgs else "") or ""
        st.session_state.raw_final = final_text
        files = result.get("files", {}) or {}
        cover_md = (files.get("cover_letters.md") or "").strip()
        st.session_state.cover_doc = md_to_docx(cover_md) if cover_md else None
        raw_jobs = extract_jobs_from_text(final_text)
        jobs_list = normalize_jobs(raw_jobs)
        st.session_state.jobs_df = pd.DataFrame(jobs_list) if jobs_list else None
        st.success("Done. Results generated and saved.")
    except Exception as e:
        st.session_state.last_error = str(e)
        st.error(f"Error: {e}")
Đoạn mã trên xử lý thao tác người dùng, khởi chạy deep agent và hiển thị kết quả như sau:
Cuối cùng, chúng ta trình bày kết quả ở định dạng thân thiện với người dùng:
st.header("Jobs")
if st.session_state.jobs_df is None or st.session_state.jobs_df.empty:
    st.write("No jobs to show yet.")
else:
    df = st.session_state.jobs_df.copy()
    def as_link(u: str) -> str:
        u = u if isinstance(u, str) else ""
        return f'<a href="{u}" target="_blank">Apply</a>' if u else "—"
    if "link" in df.columns:
        df["link"] = df["link"].apply(as_link)
    cols = [c for c in ["company", "title", "location", "link", "Good Match"] if c in df.columns]
    df = df[cols]
    st.write(df.to_html(escape=False, index=False), unsafe_allow_html=True)
st.header("Download")
if st.session_state.cover_doc:
    st.download_button(
        "Download cover_letters.docx",
        data=st.session_state.cover_doc,
        file_name="cover_letters.docx",
      mime="application/vnd.openxmlformats-officedocument.wordprocessingml.document",
        key="dl_cover_letters",
    )
else:
    st.caption("Cover letters not produced yet.")
Sau khi agent hoàn tất, chúng ta trình bày kết quả với bố cục chỉn chu, cụ thể:
Điều này biến một quy trình AI nhiều bước thành trải nghiệm một cú nhấp chuột.
Để khởi chạy ứng dụng, chỉ cần chạy:
streamlit app.pyHọc AI với các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
