
Cursus
Inleiding tot AI-agents
1 uur 30 min
148.1K
De meestgebruikte agentarchitectuur van nu laat een LLM tools in een lus aanroepen: eenvoudig, effectief, maar uiteindelijk beperkt. Voor rechttoe-rechtaan taken werkt dit prima, maar bij complexe, meerstapsuitdagingen die planning, contextbeheer en langdurige uitvoering vergen, schiet deze aanpak tekort.
LangChains Deep Agents-architectuur combineert gedetailleerde systeemprompts, planningstools, sub-agents en bestandssystemen om AI-agents te bouwen die complexe research-, codeer- en analysetaken aankunnen. Toepassingen als Claude Code, Deep Research en Manus hebben de effectiviteit bewezen, en met het Python-pakket deepagents is deze architectuur nu voor iedereen toegankelijk.
In deze tutorial laat ik stap voor stap zien hoe je:
Deep Agents zijn een geavanceerde agentarchitectuur voor complexe, meerstapstaken die aanhoudend redeneren, toolgebruik en geheugen vereisen. In tegenstelling tot traditionele agents die in korte lussen werken of simpele toolcalls doen, plannen Deep Agents hun acties, beheren veranderende context, delegeren subtaken aan gespecialiseerde sub-agents en behouden state over lange interacties. Deze architectuur drijft al echte toepassingen aan zoals Claude Code, Deep Research en Manus.
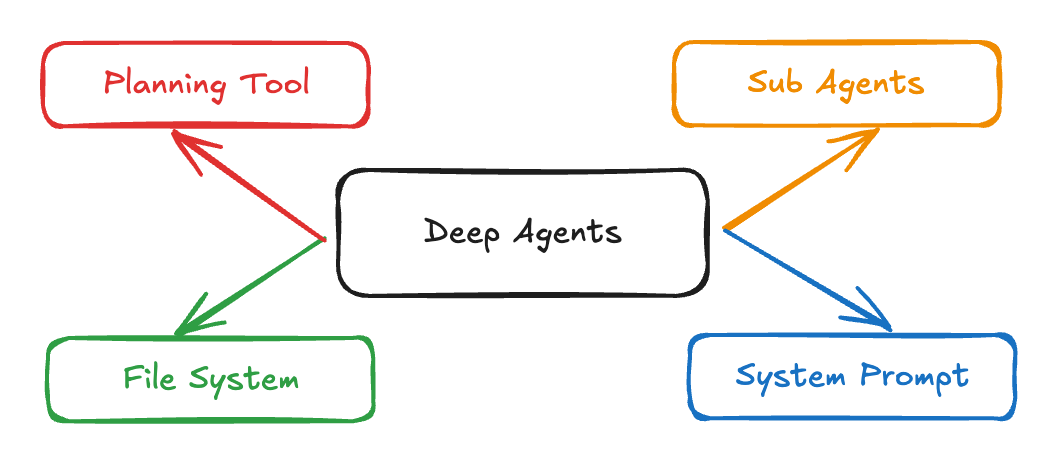
Bron: LangChain
Dit zijn de belangrijkste kenmerken van Deep Agents:
Deep Agents overwinnen de beperkingen van traditionele agents met vier kernelementen:
In plaats van simpele instructieprompts gebruiken Deep Agents uitgebreide systeemprompts zoals:
DEEP_AGENT_SYSTEM_PROMPT = """
You are an expert research assistant capable of conducting thorough,
multi-step investigations. Your capabilities include:
PLANNING: Break complex tasks into subtasks using the todo_write tool
RESEARCH: Use internet_search extensively to gather comprehensive information
DELEGATION: Spawn sub-agents for specialized tasks using the call_subagent tool
DOCUMENTATION: Maintain detailed notes using the file system tools
When approaching a complex task:
1. First, create a plan using todo_write
2. Research systematically, saving important findings to files
3. Delegate specialized work to appropriate sub-agents
4. Synthesize findings into a comprehensive response
Examples:
[Detailed few-shot examples follow...]
"""
De prompt integreert planning, research en delegatie met documentatie, met few-shotvoorbeelden om complexe taken te ontleden.
De planningstool is vaak slechts een “no-op” die de agent helpt gedachten te ordenen:
@tool
def todo_write(tasks: List[str]) -> str:
    formatted_tasks = "\n".join([f"- {task}" for task in tasks])
    return f"Todo list created:\n{formatted_tasks}"
Deze simpele tool levert belangrijke context engineering op, waardoor de agent moet plannen en dat plan tijdens de uitvoering zichtbaar houdt.
Deep Agents kunnen gespecialiseerde sub-agents starten voor gefocuste taken. Elke sub-agent heeft een eigen prompt, beschrijving en set tools, wat zowel scheiding van verantwoordelijkheden als diepe taakspecifieke optimalisatie mogelijk maakt. Zo kun je sub-agents definiëren in je workflow:
subagents = [
    {
        "name": "research-agent",
        "description": "Conducts deep research on specific topics",
        "prompt": "You are a research specialist. Focus intensively on the given topic...",
        "tools": ["internet_search", "read_file", "write_file"]
    },
    {
        "name": "analysis-agent",
        "description": "Analyzes data and draws insights",
        "prompt": "You are a data analyst. Examine the provided information...",
        "tools": ["read_file", "write_file"]
    }
]
Deze aanpak zorgt voor contextquarantaine: elke sub-agent behoudt zijn eigen context en vervuilt het geheugen van de hoofdagent niet. Door gespecialiseerde taken te isoleren, kun je het volgende mogelijk maken:
Deep Agents behouden en delen state via een virtueel bestandssysteem. In plaats van alleen op gespreksgeschiedenis te vertrouwen, laten deze ingebouwde tools agents informatie organiseren doorheen de workflow:
tools = [
    "ls",           # List files
    "read_file",    # Read file contents
    "write_file",   # Write to file
    "edit_file"     # Edit existing file
]
Dit virtuele bestandssysteem biedt meerdere voordelen:
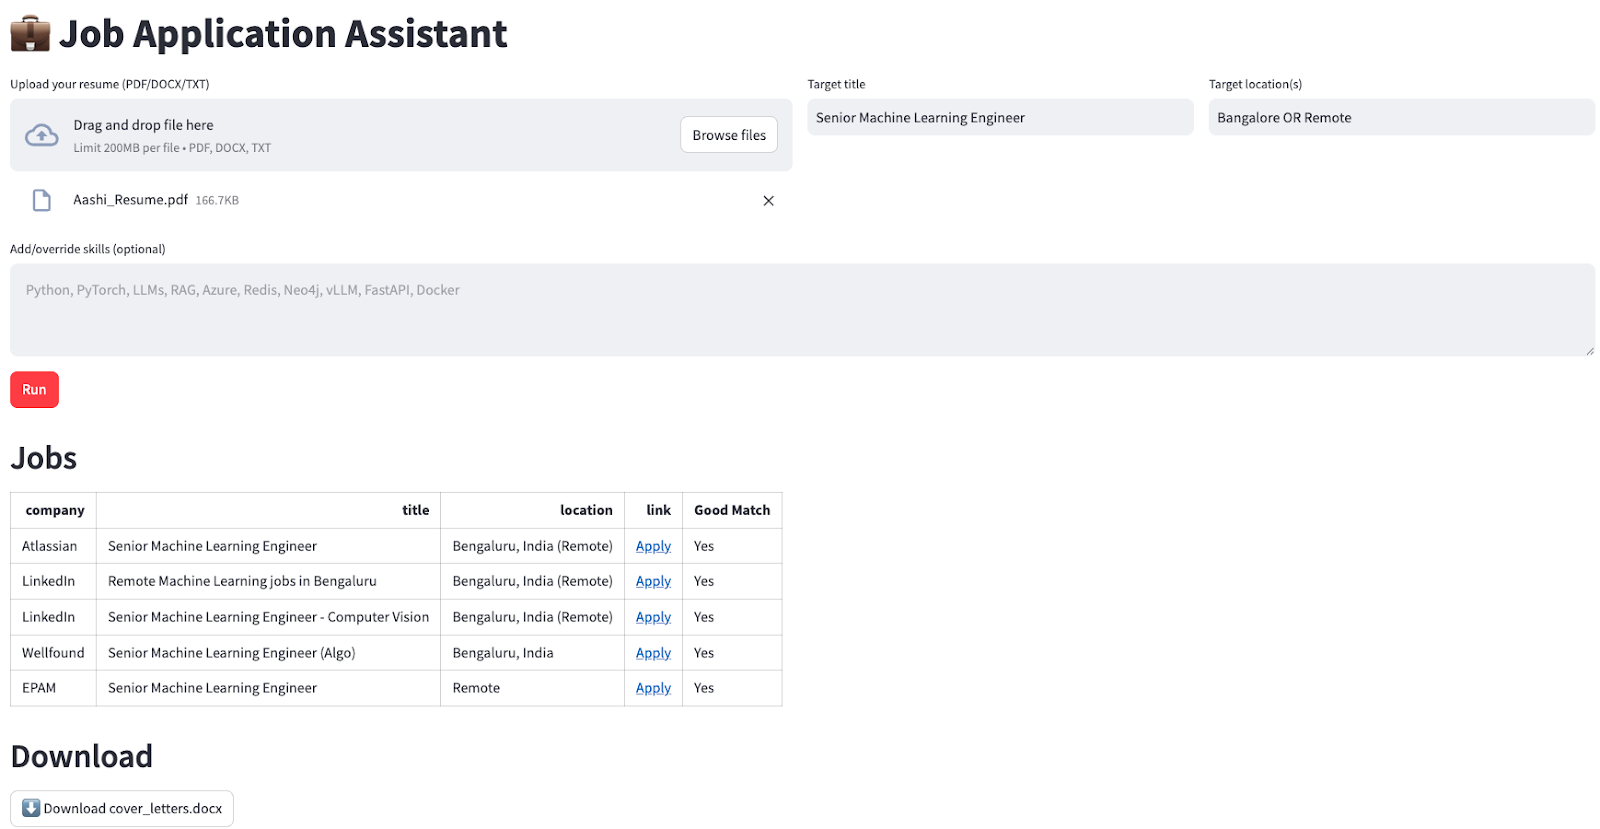
deepagentsIk neem je mee in een praktisch voorbeeld: we bouwen een sollicitatie-assistent die automatisch relevante vacatures vindt en gerichte sollicitatiebrieven voor de gebruiker opstelt.
Onze assistent zal:
We beginnen met een basisinstallatie en -setup:
pip install deepagents
pip install tavily-python
pip install streamlit
pip install langchain-openai
Na installatie stellen we onze omgevingsvariabelen in:
export OPENAI_API_KEY=sk-projxxxxxxxxxxxxxxxxxxx
export TAVILY_API_KEY=tvly-devxxxxxxxxxxxxxxxxxxx
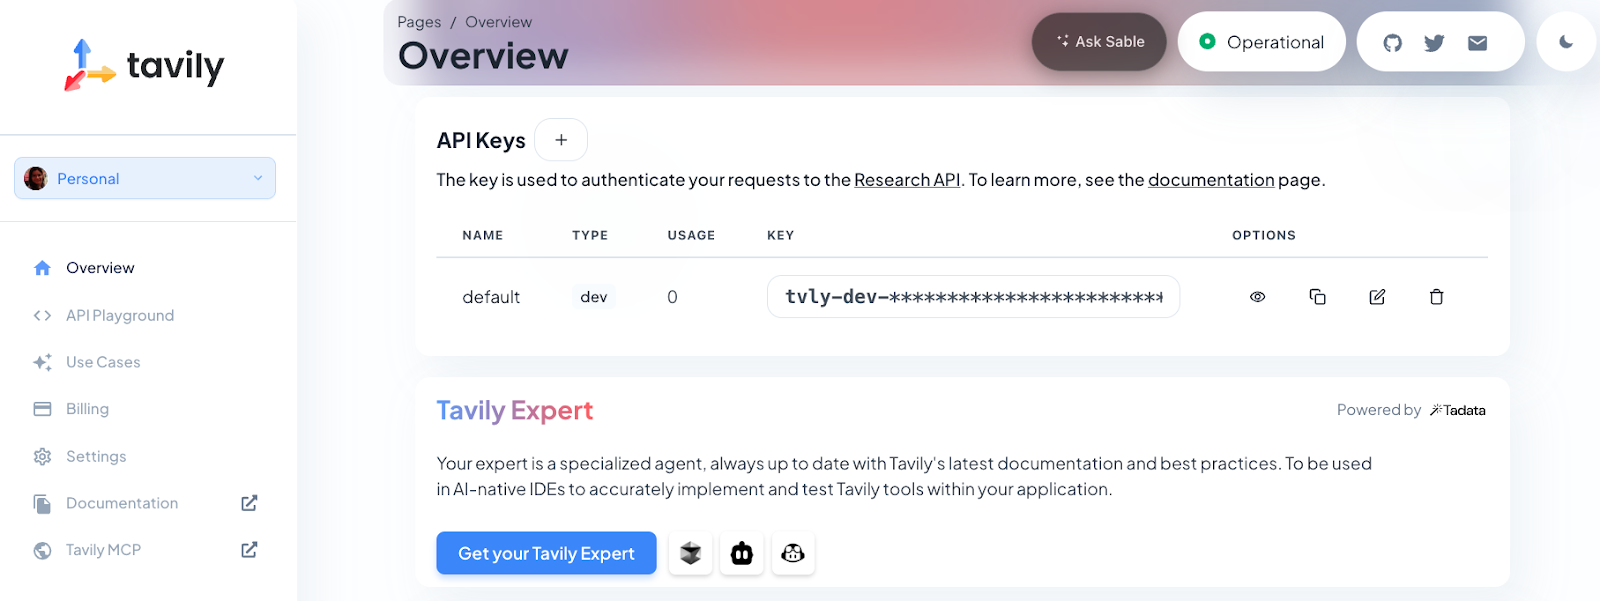
Voor deze demo heb je zowel een OpenAI API-sleutel (voor het GPT-4o mini-model) als een Tavily API-sleutel (voor webzoekfunctionaliteit) nodig. Tavily levert de agent actuele vacatures direct van het web, terwijl het model van OpenAI alle taalbegrip, redeneren, planning en contentgeneratie afhandelt.
Opmerking: nieuwe Tavily-gebruikers ontvangen 1.000 gratis API-credits. Registreer je op https://app.tavily.com om je sleutel te krijgen.
Tot slot importeren we de benodigde libraries en zetten we de Streamlit-interface op:
import os
import io
import json
import re
from typing import Literal, Dict, Any, List
import streamlit as st
import pandas as pd
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from tavily import TavilyClient
from deepagents import create_deep_agent
Deze stap importeert alle vereiste afhankelijkheden voor onze deep-agentapplicatie. We gebruiken streamlit voor de webinterface, pandas voor data-afhandeling, langchain_openai voor de LLM-integratie en deepagents voor het agentframework.
Vervolgens initialiseren we Streamlits sessiestatus om data te behouden tussen gebruikersinteracties. Zo onthoudt de app geüploade bestanden, resultaten en foutstatussen terwijl gebruikers met de interface werken:
if "jobs_df" not in st.session_state:
    st.session_state.jobs_df = None
if "cover_doc" not in st.session_state:
    st.session_state.cover_doc = None
if "last_error" not in st.session_state:
    st.session_state.last_error = ""
if "raw_final" not in st.session_state:
    st.session_state.raw_final = ""
Deze setup is essentieel voor een soepele gebruikerservaring: we kunnen de vacature-resultaten, gegenereerde sollicitatiebrieven en foutmeldingen gedurende de sessie opslaan.
We gebruiken Streamlit-kolommen om invoervelden te ordenen voor het uploaden van je cv, functietitel, locatie en optionele skills:
st.set_page_config(page_title="Job Application Assistant", page_icon=" ", layout="wide")
st.title("💼 Job Application Assistant")
c0, c1, c2 = st.columns([2, 1, 1])
with c0:
    uploaded = st.file_uploader("Upload your resume (PDF/DOCX/TXT)", type=["pdf", "docx", "txt"])
with c1:
    target_title = st.text_input("Target title", "Senior Machine Learning Engineer")
with c2:
    target_location = st.text_input("Target location(s)", "Bangalore OR Remote")
skills_hint = st.text_area(
    "Add/override skills (optional)",
    "",
    placeholder="Python, PyTorch, LLMs, RAG, Azure, vLLM, FastAPI",
)
De UI is in kolommen georganiseerd voor een betere lay-out. Gebruikers kunnen hun cv in meerdere formaten uploaden, hun beoogde functietitel en locatie opgeven en specifieke skills benadrukken die ze in hun sollicitaties willen uitlichten.
Daarna implementeren we robuuste bestandsverwerking om verschillende cv-formaten te ondersteunen en er tekst uit te extraheren.
 import pypdf
 import docx
def extract_text(file) -> str:
    if not file:
        return ""
    name = file.name.lower()
    if name.endswith(".txt"):
        return file.read().decode("utf-8", errors="ignore")
    if name.endswith(".pdf"):
        pdf = pypdf.PdfReader(io.BytesIO(file.read()))
        return "\n".join((p.extract_text() or "") for p in pdf.pages)
    if name.endswith(".docx"):
        d = docx.Document(io.BytesIO(file.read()))
        return "\n".join(p.text for p in d.paragraphs)
    return ""
def md_to_docx(md_text: str) -> bytes:
    doc = docx.Document()
    for raw in md_text.splitlines():
        line = raw.rstrip()
        if not line:
            doc.add_paragraph("")
            continue
        if line.startswith("#"):
            level = min(len(line) - len(line.lstrip("#")), 3)
            doc.add_heading(line.lstrip("#").strip(), level=level)
        elif line.startswith(("- ", "* ")):
            doc.add_paragraph(line[2:].strip(), style="List Bullet")
        else:
            doc.add_paragraph(line)
    bio = io.BytesIO()
    doc.save(bio)
    bio.seek(0)
    return bio.read()
Deze hulpfuncties behandelen de complexiteit van tekstextractie uit verschillende bestandsformaten (PDF, DOCX, TXT) en het omzetten van markdown-uitvoer terug naar DOCX-formaat voor download. Zo werken de functies:
extract_text() detecteert automatisch het type geüpload bestand (TXT, PDF of DOCX) en extraheert de inhoud met de juiste library, zodat gebruikers zich geen zorgen hoeven te maken over het formaat.md_to_docx() zet markdown-tekst (zoals sollicitatiebrieven die door de agent zijn gegenereerd) om in een nette, goed gestructureerde Word-brief die klaar is om te downloaden.Zo kan de applicatie flexibel met uiteenlopende cv’s omgaan en professionele output leveren, ongeacht het oorspronkelijke bestandsformaat.
Vervolgens implementeren we robuuste parsing om vacaturedata uit de respons van de agent te halen.
def normalize_jobs(items: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
    normed = []
    for it in items:
        if not isinstance(it, dict):
            continue
        # case-insensitive keys
        lower_map = {str(k).strip().lower(): it[k] for k in it.keys()}
        company = str(lower_map.get("company", "") or "").strip()
        title = str(lower_map.get("title", "") or "").strip()
        location = str(lower_map.get("location", "") or "").strip()
        link = str(lower_map.get("link", "") or "").strip()
        why_fit = str(lower_map.get("why_fit", lower_map.get("good match", "")) or "").strip()
        if not link:
            continue
        normed.append({
            "company": company or "—",
            "title": title or "—",
            "location": location or "—",
            "link": link,
            "Good Match": "Yes" if why_fit else "—",
        })
    return normed[:5]
def extract_jobs_from_text(text: str) -> List[Dict[str, Any]]:
    if not text:
        return []
    pattern = r"<JOBS>\s*(?:```[\w-]*\s*)?(\[.*?\])\s*(?:```)?\s*</JOBS>"
    m = re.search(pattern, text, flags=re.S | re.I)
    if not m:
        return []
    raw = m.group(1).strip().strip("`").strip()
    try:
        obj = json.loads(raw)
        return obj if isinstance(obj, list) else []
    except Exception:
        try:
            salvaged = re.sub(r"(?<!\\)'", '"', raw)
            obj = json.loads(salvaged)
            return obj if isinstance(obj, list) else []
        except Exception:
            st.session_state.last_error = f"JSON parse failed: {raw[:1200]}"
            return []
Kort de functies hierboven toegelicht:
extract_jobs_from_text() gebruikt een reguliere expressie om een JSON-array met vacatures te extraheren uit de gestructureerde output van de agent (binnen <JOBS>...</JOBS>-tags). Er is ook fallback-parsing om kleine model fouten op te vangen, zoals enkele aanhalingstekens in plaats van dubbele in JSON.normalize_jobs() elk vacature-object op: hoofdletterongevoelige sleutels, verplichte velden, witruimte, en beperken we de uitvoer tot de top 5.De kern van de researchcapaciteit draait op Tavily. Daarom definiëren we een webzoektool die de deep agent gebruikt om actuele vacatures te vinden:
TAVILY_KEY = os.environ.get("TAVILY_API_KEY", "")
@tool
def internet_search(
    query: str,
    max_results: int = 5,
    topic: Literal["general", "news", "finance"] = "general",
    include_raw_content: bool = False,
) -> List[Dict[str, Any]]:
    if not TAVILY_KEY:
        raise RuntimeError("TAVILY_API_KEY is not set in the environment.")
    client = TavilyClient(api_key=TAVILY_KEY)
    return client.search(
        query=query,
        max_results=max_results,
        include_raw_content=include_raw_content,
        topic=topic,
    )
De functie internet_search() is gedecoreerd met @tool, waardoor hij toegankelijk is voor de agent en sub-agents. Daarna roept hij de Tavily API aan, die relevante, recente zoekresultaten teruggeeft—ideaal voor dynamische vacaturezoekopdrachten en research.
Opmerking: je kunt op dezelfde manier extra tools toevoegen (zoals documentsamenvatting, code-uitvoering of data-enrichment) om de mogelijkheden van je deep agent verder uit te breiden.
Nu brengen we alles samen door de hoofdagent en zijn sub-agents te configureren, elk met gerichte instructies zoals hieronder:
INSTRUCTIONS = (
    "You are a job application assistant. Do two things:\n"
    "1) Use the web search tool to find exactly 5 CURRENT job postings (matching the user's target title, locations, and skills). "
    "Return them ONLY as JSON in this exact wrapper:\n"
    "<JOBS>\n"
    "[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}, ... five total]\n"
    "</JOBS>\n"
    "Rules: The list must be valid JSON (no comments), real links to the job page or application page, no duplicates.\n"
    "2) Produce a concise cover letter (≤150 words) for EACH job, with a subject line, appended to cover_letters.md under a heading per job.\n"
    "Do not invent jobs. Prefer reputable sources (company career pages, LinkedIn, Lever, Greenhouse)."
)
JOB_SEARCH_PROMPT = (
    "Search and select 5 real postings that match the user's title, locations, and skills. "
    "Output ONLY this block format (no extra text before/after the wrapper):\n"
    "<JOBS>\n"
    "[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}]"
    "\n</JOBS>"
)
COVER_LETTER_PROMPT = (
    "For each job in the found list, write a subject line and a concise cover letter (≤150 words) that ties the user's skills/resume to the role. "
    "Append to cover_letters.md under a heading per job. Keep writing tight and specific."
)
def build_agent():
    api_key = os.environ.get("OPENAI_API_KEY")
    if not api_key:
        st.error("Please set OPENAI_API_KEY in your environment.")
        st.stop()
    llm = ChatOpenAI(model=os.environ.get("OPENAI_MODEL", "gpt-4o-mini"), temperature=0.2)
    tools = [internet_search]
    subagents = [
        {"name": "job-search-agent", "description": "Finds relevant jobs", "prompt": JOB_SEARCH_PROMPT},
        {"name": "cover-letter-writer-agent", "description": "Writes cover letters", "prompt": COVER_LETTER_PROMPT},
    ]
    return create_deep_agent(tools, INSTRUCTIONS, subagents=subagents, model=llm)
def make_task_prompt(resume_text: str, skills_hint: str, title: str, location: str) -> str:
    skills = skills_hint.strip()
    skill_line = f" Prioritize these skills: {skills}." if skills else ""
    return (
        f"Target title: {title}\n"
        f"Target location(s): {location}\n"
        f"{skill_line}\n\n"
        f"RESUME RAW TEXT:\n{resume_text[:8000]}"
    )
Deze stap laat de kracht van Deep Agents zien via gespecialiseerde sub-agents. De hoofdinstructies geven de algemene koers, terwijl elke sub-agent gerichte prompts heeft voor specifieke taken:
INSTRUCTIONS, JOB_SEARCH_PROMPT en COVER_LETTER_PROMPT definiëren de hoofd-systeemprompt en de gespecialiseerde instructies per sub-agent. Dit zorgt ervoor dat de agent altijd goed gestructureerde vacature-resultaten en gerichte sollicitatiebrieven in het vereiste formaat oplevert.build_agent() controleert de OpenAI API-sleutel, zet het taalmodel op en maakt de deep agent met zowel de vacaturezoek- als de sollicitatiebrief-sub-agents. Deze modulaire setup laat elke sub-agent focussen op zijn deel van de workflow.make_task_prompt() genereert vervolgens één prompt die het cv, de skills, functietitel en locatie van de gebruiker combineert. Zo krijgt de agent alle context om de zoek- en schrijfprocessen te starten.Samen brengen deze functies structuur en specialisatie in de workflow.
Dit is de kernlogica die gebruikersinvoer afhandelt en de deep agent orkestreert:
resume_text = extract_text(uploaded) if uploaded else ""
run_clicked = st.button("Run", type="primary", disabled=not uploaded)
if run_clicked:
    st.session_state.last_error = ""
    st.session_state.raw_final = ""
    try:
        if not os.environ.get("OPENAI_API_KEY"):
            st.error("OPENAI_API_KEY not set.")
            st.stop()
        if not TAVILY_KEY:
            st.error("TAVILY_API_KEY not set.")
            st.stop()
        agent = build_agent()
       task = make_task_prompt(resume_text, skills_hint, target_title, target_location)
        state = {
            "messages": [{"role": "user", "content": task}],
            "files": {"cover_letters.md": ""},
        }
        with st.spinner("Finding jobs and drafting cover letters..."):
            result = agent.invoke(state)
        final_msgs = result.get("messages", [])
        final_text = (final_msgs[-1].content if final_msgs else "") or ""
        st.session_state.raw_final = final_text
        files = result.get("files", {}) or {}
        cover_md = (files.get("cover_letters.md") or "").strip()
        st.session_state.cover_doc = md_to_docx(cover_md) if cover_md else None
        raw_jobs = extract_jobs_from_text(final_text)
        jobs_list = normalize_jobs(raw_jobs)
        st.session_state.jobs_df = pd.DataFrame(jobs_list) if jobs_list else None
        st.success("Done. Results generated and saved.")
    except Exception as e:
        st.session_state.last_error = str(e)
        st.error(f"Error: {e}")
De code hierboven verwerkt gebruikersacties, start de deep agent en toont resultaten als volgt:
Tot slot presenteren we de resultaten in een gebruiksvriendelijk formaat:
st.header("Jobs")
if st.session_state.jobs_df is None or st.session_state.jobs_df.empty:
    st.write("No jobs to show yet.")
else:
    df = st.session_state.jobs_df.copy()
    def as_link(u: str) -> str:
        u = u if isinstance(u, str) else ""
        return f'<a href="{u}" target="_blank">Apply</a>' if u else "—"
    if "link" in df.columns:
        df["link"] = df["link"].apply(as_link)
    cols = [c for c in ["company", "title", "location", "link", "Good Match"] if c in df.columns]
    df = df[cols]
    st.write(df.to_html(escape=False, index=False), unsafe_allow_html=True)
st.header("Download")
if st.session_state.cover_doc:
    st.download_button(
        "Download cover_letters.docx",
        data=st.session_state.cover_doc,
        file_name="cover_letters.docx",
      mime="application/vnd.openxmlformats-officedocument.wordprocessingml.document",
        key="dl_cover_letters",
    )
else:
    st.caption("Cover letters not produced yet.")
Na afloop presenteert de app alles in een verzorgde lay-out, namelijk:
Zo wordt een meerstaps AI-workflow teruggebracht tot één simpele klik.
Start de app met:
streamlit app.pyLeer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

