
Corso
Introduzione agli AI Agents
1 ore 30 min
148.1K
L'architettura di agenti più comune oggi prevede che un LLM richiami strumenti in un loop: è semplice, efficace, ma in ultima analisi limitata. Sebbene questo approccio funzioni per compiti lineari, fatica di fronte a sfide complesse e multi-step che richiedono pianificazione, gestione del contesto ed esecuzione prolungata su orizzonti temporali più lunghi.
I Deep Agents di LangChain combinano prompt di sistema dettagliati, strumenti di pianificazione, sub-agent e file system per creare agenti AI in grado di affrontare attività complesse di ricerca, coding e analisi. Applicazioni come Claude Code, Deep Research e Manus hanno dimostrato l'efficacia di questo approccio e ora il pacchetto Python deepagents rende questa architettura accessibile a tutti.
In questo tutorial ti spiegherò passo dopo passo come:
Deep Agents è un'architettura di agenti avanzata progettata per gestire compiti complessi e multi-step che richiedono ragionamento sostenuto, uso di strumenti e memoria. A differenza degli agenti tradizionali che operano in brevi loop o effettuano semplici chiamate a strumenti, i Deep Agents pianificano le azioni, gestiscono il contesto in evoluzione, delegano sotto-task a sub-agent specializzati e mantengono lo stato in interazioni prolungate. Questa architettura alimenta già applicazioni reali come Claude Code, Deep Research e Manus.
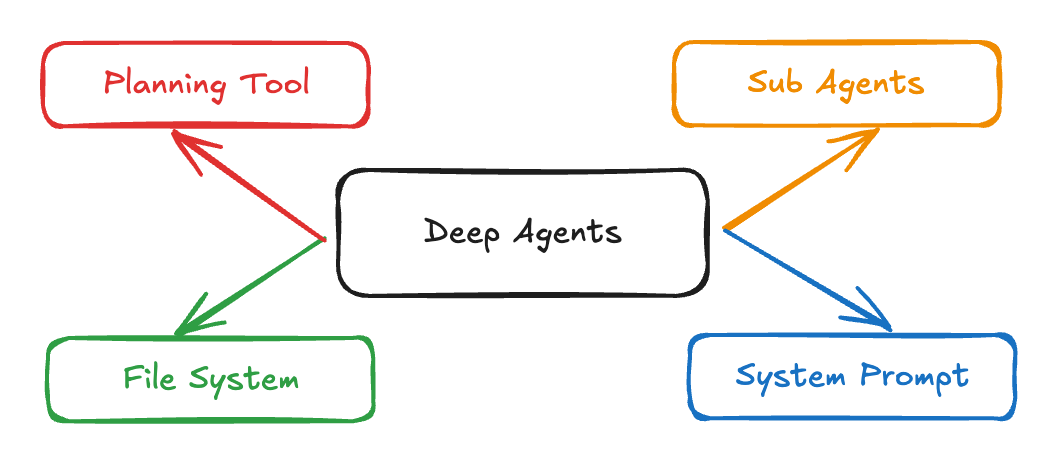
Fonte: LangChain
Queste sono le caratteristiche chiave dei Deep Agents:
I Deep Agents superano i limiti degli agenti tradizionali grazie a quattro componenti fondamentali:
Diversamente dai semplici prompt di istruzione, i Deep Agents usano prompt di sistema completi come segue:
DEEP_AGENT_SYSTEM_PROMPT = """
You are an expert research assistant capable of conducting thorough,
multi-step investigations. Your capabilities include:
PLANNING: Break complex tasks into subtasks using the todo_write tool
RESEARCH: Use internet_search extensively to gather comprehensive information
DELEGATION: Spawn sub-agents for specialized tasks using the call_subagent tool
DOCUMENTATION: Maintain detailed notes using the file system tools
When approaching a complex task:
1. First, create a plan using todo_write
2. Research systematically, saving important findings to files
3. Delegate specialized work to appropriate sub-agents
4. Synthesize findings into a comprehensive response
Examples:
[Detailed few-shot examples follow...]
"""
Il prompt integra pianificazione, ricerca e delega con documentazione, utilizzando few-shot per scomporre compiti complessi.
Lo strumento di pianificazione è spesso un semplice "no-op" che aiuta l'agente a organizzare i pensieri:
@tool
def todo_write(tasks: List[str]) -> str:
    formatted_tasks = "\n".join([f"- {task}" for task in tasks])
    return f"Todo list created:\n{formatted_tasks}"
Questo semplice tool fornisce un'importante context engineering, che obbliga l'agente a pianificare di conseguenza e a mantenere visibile il piano durante l'esecuzione.
I Deep Agents possono avviare sub-agent specializzati per compiti focalizzati. Ogni sub-agent è progettato con il proprio prompt, descrizione e set di strumenti, abilitando sia la separazione delle responsabilità sia un'ottimizzazione profonda specifica per il task. Ecco un esempio di come definire i sub-agent nel tuo workflow:
subagents = [
    {
        "name": "research-agent",
        "description": "Conducts deep research on specific topics",
        "prompt": "You are a research specialist. Focus intensively on the given topic...",
        "tools": ["internet_search", "read_file", "write_file"]
    },
    {
        "name": "analysis-agent",
        "description": "Analyzes data and draws insights",
        "prompt": "You are a data analyst. Examine the provided information...",
        "tools": ["read_file", "write_file"]
    }
]
Questo approccio fornisce una quarantena del contesto: ogni sub-agent mantiene il proprio contesto e non inquina la memoria dell'agente principale. Isolando i compiti specializzati, puoi abilitare:
I Deep Agents mantengono e condividono lo stato usando un file system virtuale. Invece di affidarsi solo alla cronologia della conversazione, questi tool integrati consentono agli agenti di organizzare le informazioni lungo il workflow:
tools = [
    "ls",           # List files
    "read_file",    # Read file contents
    "write_file",   # Write to file
    "edit_file"     # Edit existing file
]
Questo file system virtuale offre vari vantaggi:
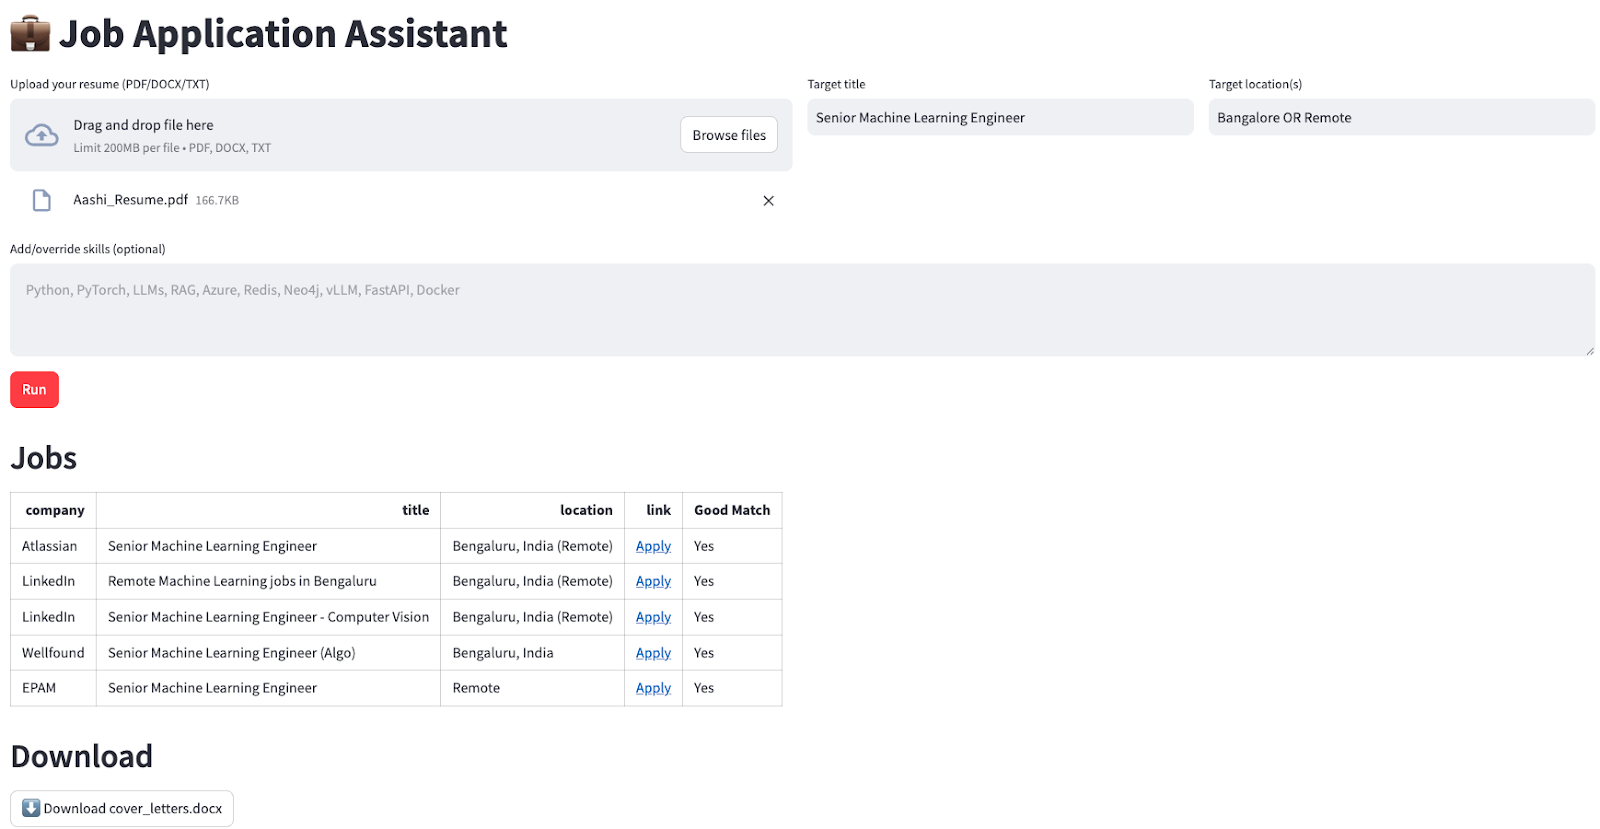
deepagents di LangChainTi guiderò con un esempio pratico per creare un assistente alle candidature che trova automaticamente offerte rilevanti e genera lettere di presentazione su misura per l'utente.
Il nostro assistente farà:
Partiamo da installazione e configurazione di base:
pip install deepagents
pip install tavily-python
pip install streamlit
pip install langchain-openai
Una volta installato, impostiamo le variabili d'ambiente:
export OPENAI_API_KEY=sk-projxxxxxxxxxxxxxxxxxxx
export TAVILY_API_KEY=tvly-devxxxxxxxxxxxxxxxxxxx
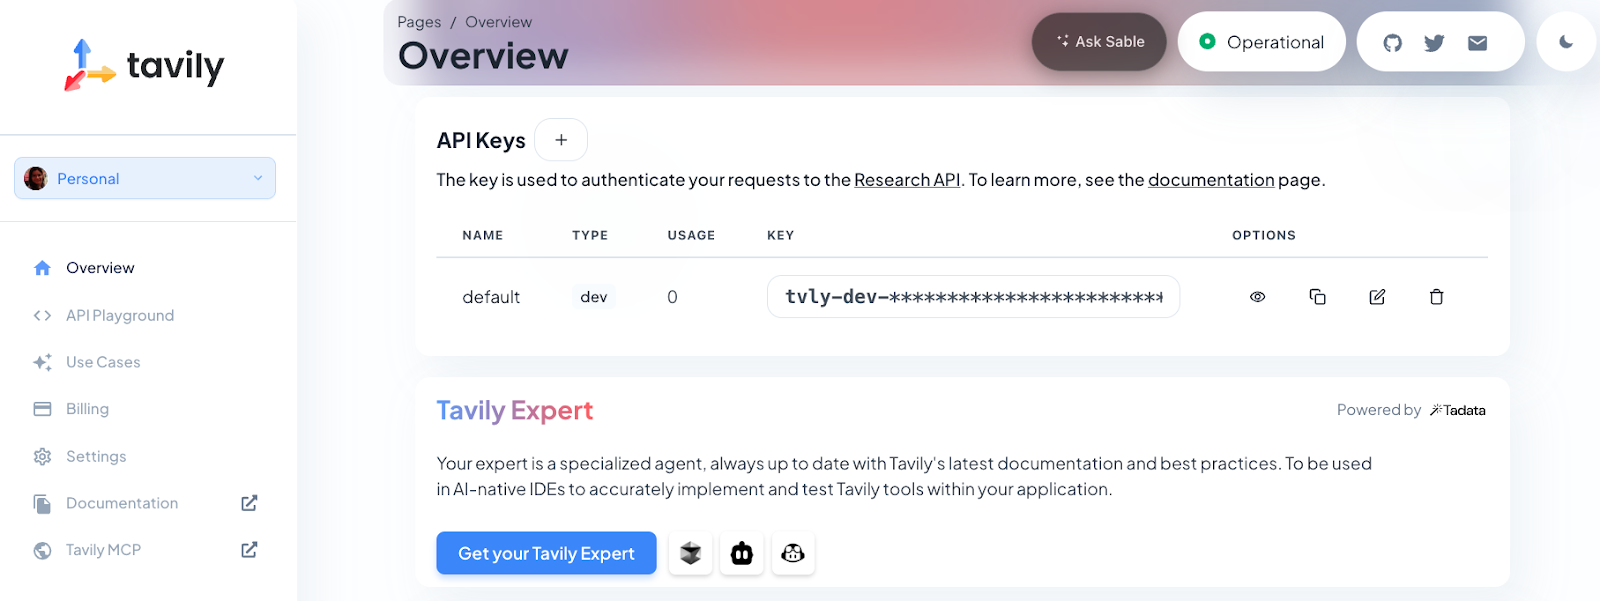
Per questa demo ti serviranno sia una chiave API OpenAI (per il modello GPT-4o mini) sia una chiave API Tavily (per la funzione di ricerca web). Tavily fornisce all'agente annunci aggiornati direttamente dal web, mentre il modello di OpenAI gestisce comprensione del linguaggio, ragionamento, pianificazione e generazione di contenuti.
Nota: i nuovi utenti Tavily ricevono 1.000 crediti API gratuiti. Per ottenere la tua chiave, registrati su https://app.tavily.com.
Infine importiamo le librerie necessarie e configuriamo l'interfaccia Streamlit:
import os
import io
import json
import re
from typing import Literal, Dict, Any, List
import streamlit as st
import pandas as pd
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from tavily import TavilyClient
from deepagents import create_deep_agent
Questo passaggio importa tutte le dipendenze necessarie per la nostra applicazione deep agent. Usiamo streamlit per l'interfaccia web, pandas per la gestione dei dati, langchain_openai per l'integrazione con l'LLM e deepagents come framework per l'agente.
Inizializziamo lo stato di sessione di Streamlit per persistere i dati tra le interazioni dell'utente. Questo assicura che l'app ricordi file caricati, risultati e stati di errore mentre l'utente interagisce con l'interfaccia:
if "jobs_df" not in st.session_state:
    st.session_state.jobs_df = None
if "cover_doc" not in st.session_state:
    st.session_state.cover_doc = None
if "last_error" not in st.session_state:
    st.session_state.last_error = ""
if "raw_final" not in st.session_state:
    st.session_state.raw_final = ""
Questa configurazione è essenziale per un'esperienza fluida, permettendoci di archiviare risultati, lettere generate ed eventuali messaggi di errore per tutta la sessione.
Usiamo le colonne di Streamlit per organizzare i campi di input nell'UI per il caricamento del CV, il titolo di lavoro, la località e le competenze opzionali:
st.set_page_config(page_title="Job Application Assistant", page_icon=" ", layout="wide")
st.title("💼 Job Application Assistant")
c0, c1, c2 = st.columns([2, 1, 1])
with c0:
    uploaded = st.file_uploader("Upload your resume (PDF/DOCX/TXT)", type=["pdf", "docx", "txt"])
with c1:
    target_title = st.text_input("Target title", "Senior Machine Learning Engineer")
with c2:
    target_location = st.text_input("Target location(s)", "Bangalore OR Remote")
skills_hint = st.text_area(
    "Add/override skills (optional)",
    "",
    placeholder="Python, PyTorch, LLMs, RAG, Azure, vLLM, FastAPI",
)
L'interfaccia è organizzata in colonne per un layout migliore. Gli utenti possono caricare il CV in più formati, specificare titolo e località target e indicare competenze da evidenziare nelle candidature.
Implementiamo un'elaborazione dei file robusta per gestire formati diversi di CV ed estrarne il testo.
 import pypdf
 import docx
def extract_text(file) -> str:
    if not file:
        return ""
    name = file.name.lower()
    if name.endswith(".txt"):
        return file.read().decode("utf-8", errors="ignore")
    if name.endswith(".pdf"):
        pdf = pypdf.PdfReader(io.BytesIO(file.read()))
        return "\n".join((p.extract_text() or "") for p in pdf.pages)
    if name.endswith(".docx"):
        d = docx.Document(io.BytesIO(file.read()))
        return "\n".join(p.text for p in d.paragraphs)
    return ""
def md_to_docx(md_text: str) -> bytes:
    doc = docx.Document()
    for raw in md_text.splitlines():
        line = raw.rstrip()
        if not line:
            doc.add_paragraph("")
            continue
        if line.startswith("#"):
            level = min(len(line) - len(line.lstrip("#")), 3)
            doc.add_heading(line.lstrip("#").strip(), level=level)
        elif line.startswith(("- ", "* ")):
            doc.add_paragraph(line[2:].strip(), style="List Bullet")
        else:
            doc.add_paragraph(line)
    bio = io.BytesIO()
    doc.save(bio)
    bio.seek(0)
    return bio.read()
Queste funzioni helper gestiscono la complessità dell'estrazione del testo da formati diversi (PDF, DOCX, TXT) e la conversione dell'output markdown in formato DOCX per il download. Ecco come lavorano:
extract_text() rileva automaticamente il tipo di file caricato (TXT, PDF o DOCX) ed estrae il contenuto usando la libreria appropriata, senza che l'utente debba preoccuparsi del formato.md_to_docx() prende testo in markdown (ad esempio lettere generate dall'agente) e lo converte in un documento Word pulito e ben strutturato, pronto per il download.Questo assicura che l'applicazione gestisca in modo flessibile input di CV diversi e produca output professionali a prescindere dal formato originale.
Implementiamo quindi un parsing robusto per estrarre i dati delle offerte dalla risposta dell'agente.
def normalize_jobs(items: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
    normed = []
    for it in items:
        if not isinstance(it, dict):
            continue
        # case-insensitive keys
        lower_map = {str(k).strip().lower(): it[k] for k in it.keys()}
        company = str(lower_map.get("company", "") or "").strip()
        title = str(lower_map.get("title", "") or "").strip()
        location = str(lower_map.get("location", "") or "").strip()
        link = str(lower_map.get("link", "") or "").strip()
        why_fit = str(lower_map.get("why_fit", lower_map.get("good match", "")) or "").strip()
        if not link:
            continue
        normed.append({
            "company": company or "—",
            "title": title or "—",
            "location": location or "—",
            "link": link,
            "Good Match": "Yes" if why_fit else "—",
        })
    return normed[:5]
def extract_jobs_from_text(text: str) -> List[Dict[str, Any]]:
    if not text:
        return []
    pattern = r"<JOBS>\s*(?:```[\w-]*\s*)?(\[.*?\])\s*(?:```)?\s*</JOBS>"
    m = re.search(pattern, text, flags=re.S | re.I)
    if not m:
        return []
    raw = m.group(1).strip().strip("`").strip()
    try:
        obj = json.loads(raw)
        return obj if isinstance(obj, list) else []
    except Exception:
        try:
            salvaged = re.sub(r"(?<!\\)'", '"', raw)
            obj = json.loads(salvaged)
            return obj if isinstance(obj, list) else []
        except Exception:
            st.session_state.last_error = f"JSON parse failed: {raw[:1200]}"
            return []
Capiremo brevemente le funzioni sopra:
extract_jobs_from_text() usa un'espressione regolare per estrarre un array JSON di offerte dall'output strutturato dell'agente (all'interno dei tag <JOBS>...</JOBS>). È incluso anche un fallback di parsing per gestire piccoli errori del modello, come l'uso di apici singoli al posto dei doppi nelle stringhe JSON.normalize_jobs() standardizza e ripulisce ciascun dizionario dell'offerta: chiavi case-insensitive, campi richiesti, trimming degli spazi e limita l'output ai primi 5 elementi.Il cuore della capacità di ricerca è alimentato da Tavily. Definiamo quindi uno strumento di ricerca web che il deep agent userà per trovare annunci aggiornati:
TAVILY_KEY = os.environ.get("TAVILY_API_KEY", "")
@tool
def internet_search(
    query: str,
    max_results: int = 5,
    topic: Literal["general", "news", "finance"] = "general",
    include_raw_content: bool = False,
) -> List[Dict[str, Any]]:
    if not TAVILY_KEY:
        raise RuntimeError("TAVILY_API_KEY is not set in the environment.")
    client = TavilyClient(api_key=TAVILY_KEY)
    return client.search(
        query=query,
        max_results=max_results,
        include_raw_content=include_raw_content,
        topic=topic,
    )
La funzione internet_search() è decorata con @tool, rendendola accessibile all'agente e ai sub-agent. Chiama poi l'API Tavily, che restituisce risultati di ricerca pertinenti e recenti: ideale per query dinamiche sulle offerte e per la ricerca.
Nota: puoi aggiungere altri strumenti in questo modo (come sintesi documentale, esecuzione di codice o arricchimento dati) per estendere ulteriormente le capacità del tuo deep agent.
Ora mettiamo tutto insieme configurando l'agente principale e i suoi sub-agent, ciascuno con istruzioni mirate, come segue:
INSTRUCTIONS = (
    "You are a job application assistant. Do two things:\n"
    "1) Use the web search tool to find exactly 5 CURRENT job postings (matching the user's target title, locations, and skills). "
    "Return them ONLY as JSON in this exact wrapper:\n"
    "<JOBS>\n"
    "[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}, ... five total]\n"
    "</JOBS>\n"
    "Rules: The list must be valid JSON (no comments), real links to the job page or application page, no duplicates.\n"
    "2) Produce a concise cover letter (≤150 words) for EACH job, with a subject line, appended to cover_letters.md under a heading per job.\n"
    "Do not invent jobs. Prefer reputable sources (company career pages, LinkedIn, Lever, Greenhouse)."
)
JOB_SEARCH_PROMPT = (
    "Search and select 5 real postings that match the user's title, locations, and skills. "
    "Output ONLY this block format (no extra text before/after the wrapper):\n"
    "<JOBS>\n"
    "[{\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"},"
    " {\"company\":\"...\",\"title\":\"...\",\"location\":\"...\",\"link\":\"https://...\",\"Good Match\":\"one sentence\"}]"
    "\n</JOBS>"
)
COVER_LETTER_PROMPT = (
    "For each job in the found list, write a subject line and a concise cover letter (≤150 words) that ties the user's skills/resume to the role. "
    "Append to cover_letters.md under a heading per job. Keep writing tight and specific."
)
def build_agent():
    api_key = os.environ.get("OPENAI_API_KEY")
    if not api_key:
        st.error("Please set OPENAI_API_KEY in your environment.")
        st.stop()
    llm = ChatOpenAI(model=os.environ.get("OPENAI_MODEL", "gpt-4o-mini"), temperature=0.2)
    tools = [internet_search]
    subagents = [
        {"name": "job-search-agent", "description": "Finds relevant jobs", "prompt": JOB_SEARCH_PROMPT},
        {"name": "cover-letter-writer-agent", "description": "Writes cover letters", "prompt": COVER_LETTER_PROMPT},
    ]
    return create_deep_agent(tools, INSTRUCTIONS, subagents=subagents, model=llm)
def make_task_prompt(resume_text: str, skills_hint: str, title: str, location: str) -> str:
    skills = skills_hint.strip()
    skill_line = f" Prioritize these skills: {skills}." if skills else ""
    return (
        f"Target title: {title}\n"
        f"Target location(s): {location}\n"
        f"{skill_line}\n\n"
        f"RESUME RAW TEXT:\n{resume_text[:8000]}"
    )
Questo passaggio dimostra la potenza dei Deep Agents tramite sub-agent specializzati. Le istruzioni principali forniscono la guida generale, mentre ogni sub-agent ha prompt focalizzati per compiti specifici:
INSTRUCTIONS, JOB_SEARCH_PROMPT e COVER_LETTER_PROMPT definiscono il prompt di sistema principale e le istruzioni specializzate per ciascun sub-agent. Questo assicura che l'agente produca sempre risultati strutturati e lettere di presentazione su misura nel formato richiesto.build_agent() verifica la presenza della chiave API OpenAI, configura il modello linguistico e crea il deep agent con i sub-agent per ricerca offerte e lettere di presentazione. Questa impostazione modulare consente a ciascun sub-agent di concentrarsi sulla propria parte del workflow.make_task_prompt() genera un unico prompt che combina CV, competenze, titolo e località dell'utente. Fornisce all'agente tutto il contesto necessario per avviare la ricerca e la stesura.Insieme, queste funzioni aggiungono struttura e specializzazione al workflow.
Questo passaggio contiene la logica core che gestisce l'input dell'utente e orchestra il deep agent:
resume_text = extract_text(uploaded) if uploaded else ""
run_clicked = st.button("Run", type="primary", disabled=not uploaded)
if run_clicked:
    st.session_state.last_error = ""
    st.session_state.raw_final = ""
    try:
        if not os.environ.get("OPENAI_API_KEY"):
            st.error("OPENAI_API_KEY not set.")
            st.stop()
        if not TAVILY_KEY:
            st.error("TAVILY_API_KEY not set.")
            st.stop()
        agent = build_agent()
       task = make_task_prompt(resume_text, skills_hint, target_title, target_location)
        state = {
            "messages": [{"role": "user", "content": task}],
            "files": {"cover_letters.md": ""},
        }
        with st.spinner("Finding jobs and drafting cover letters..."):
            result = agent.invoke(state)
        final_msgs = result.get("messages", [])
        final_text = (final_msgs[-1].content if final_msgs else "") or ""
        st.session_state.raw_final = final_text
        files = result.get("files", {}) or {}
        cover_md = (files.get("cover_letters.md") or "").strip()
        st.session_state.cover_doc = md_to_docx(cover_md) if cover_md else None
        raw_jobs = extract_jobs_from_text(final_text)
        jobs_list = normalize_jobs(raw_jobs)
        st.session_state.jobs_df = pd.DataFrame(jobs_list) if jobs_list else None
        st.success("Done. Results generated and saved.")
    except Exception as e:
        st.session_state.last_error = str(e)
        st.error(f"Error: {e}")
Il codice sopra gestisce le azioni dell'utente, avvia il deep agent e mostra i risultati come segue:
Infine, presentiamo i risultati in un formato facile da usare:
st.header("Jobs")
if st.session_state.jobs_df is None or st.session_state.jobs_df.empty:
    st.write("No jobs to show yet.")
else:
    df = st.session_state.jobs_df.copy()
    def as_link(u: str) -> str:
        u = u if isinstance(u, str) else ""
        return f'<a href="{u}" target="_blank">Apply</a>' if u else "—"
    if "link" in df.columns:
        df["link"] = df["link"].apply(as_link)
    cols = [c for c in ["company", "title", "location", "link", "Good Match"] if c in df.columns]
    df = df[cols]
    st.write(df.to_html(escape=False, index=False), unsafe_allow_html=True)
st.header("Download")
if st.session_state.cover_doc:
    st.download_button(
        "Download cover_letters.docx",
        data=st.session_state.cover_doc,
        file_name="cover_letters.docx",
      mime="application/vnd.openxmlformats-officedocument.wordprocessingml.document",
        key="dl_cover_letters",
    )
else:
    st.caption("Cover letters not produced yet.")
Dopo che l'agente ha terminato, presentiamo i risultati con un layout curato, ovvero:
Questo trasforma un workflow AI multi-step in un'esperienza a un click.
Per avviare l'app, esegui semplicemente:
streamlit app.pyImpara l'AI con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



