

什么是 DeepSeek OCR 2?
DeepSeek-OCR 2 是一款端到端的文档阅读与 OCR 视觉-语言模型,能够通过学习更优的阅读顺序来处理复杂版式(多栏页面、表单、表格、公式),而不是将图像块按固定的自左上至右下栅格扫描进行扁平化处理。
其核心理念是Visual Causal Flow(视觉因果流),即模型尝试模拟人类阅读文档的方式,按语义渐进地解析,而不是将页面视为均匀网格。从架构上看,DeepSeek-OCR 2 延续了 DeepSeek-OCR 的编码器—解码器框架,但将编码器升级为 DeepEncoder V2,在解码器生成文本之前引入因果 token 重排序机制。
DeepSeek OCR-2 如何工作?
从高层看,DeepSeek OCR-2 通过视觉-语言管线将文档转为文本,并学习阅读顺序,而非依赖固定坐标排序。这包括:
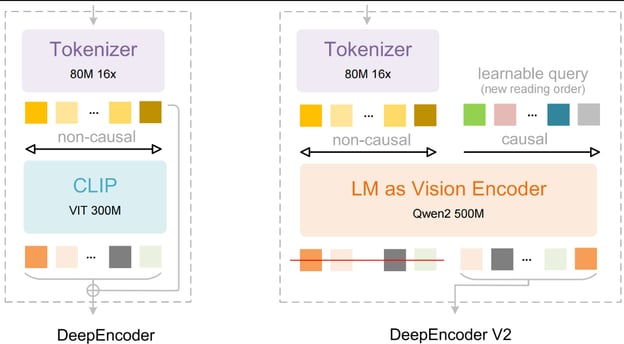
图示:DeepSeek-OCR 2:Visual Causal Flow
- 多尺度页面编码:每个 PDF 页面被渲染为一个全局视图和可选的高分辨率本地裁剪。这些图像被转换为视觉补丁 token,使模型既能捕捉整体布局(章节、栏)也能关注细节,如小字号文字、表格和公式。
- 双向注意力的版面理解:在 DeepEncoder V2 中,视觉 token 先经过非因果(双向)注意力处理,使模型理解空间关系,如栏结构、表格边界和区域分组。
- 视觉因果流(学习到的阅读顺序):编码器附加可学习的因果查询 token,按顺序关注视觉特征和先前查询。该机制按学习到的阅读序列提取内容,使模型在多栏页面、表单和复杂布局下更稳健。
- 文本生成:有序的视觉表征被传递给语言解码器,后者以自回归方式按正确的逻辑顺序生成文档文本。
- 端到端的文档理解:与传统 OCR 流水线不同,DeepSeek OCR-2 将版面理解与转写联合建模,输出更干净的文本和更可靠的结构,便于后续任务如搜索、摘要和 RAG。
您可以参考 DeepSeek OCR-2 的GitHub 仓库以深入了解代码细节。
DeepSeek OCR-2 教程:构建“索引中可提问”的 PDF 问答应用
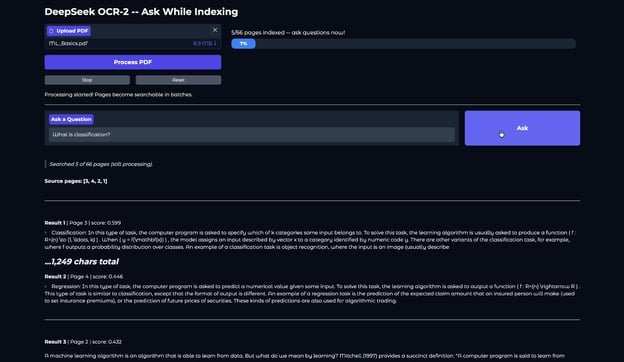
本节中,我们将构建一个实时文档智能应用:您可以上传 PDF,使用 DeepSeek OCR-2 抽取其内容,并在文档仍在处理时开始提问。无需等待完整 OCR 完成,页面会按批次变为可检索状态,从而带来更快、更具交互感的体验。
从高层看,系统执行四项核心任务:
- 将每个 PDF 页面转换为高质量图像
- 通过 vLLM 运行 DeepSeek OCR-2 以抽取结构化文本
- 使用 FAISS 与基于向量嵌入的RAG 流水线对抽取内容进行增量索引
- 在页面被索引的同时允许用户实时查询文档
该应用生成两类主要输出:
- 可检索的文档内容,支持页级检索
- 基于来源的答案,展示相关页码与文本片段
注意:本教程基于 DeepSeek 的官方 OCR-2 vLLM 演示代码,包括 PDF 渲染辅助、多模态输入封装、OCR 文本清理,以及 vLLM 引擎/采样配置。在此基础上,我增加了轻量 RAG 层、用于增量索引的小批量 OCR 处理,以及一个 Gradio 应用。
步骤 1:环境配置
在通过 vLLM 运行 DeepSeek OCR-2 之前,我们需要确保运行环境就绪。本教程假设使用支持 GPU 的环境,如配备 A100 或 T4 的 Google Colab,因为 vLLM 与 DeepSeek OCR-2 都需要 CUDA 才能高效推理。
在此步骤,我们将:
- 验证 GPU 可用并检查其显存需求
- 克隆 DeepSeek OCR-2 的仓库
- 确认 vLLM 集成目录存在
这样可确保管线的其余部分能正常加载模型与相关工具,无路径或依赖问题。
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
zip_candidates = [
'/content/DeepSeek-OCR-2-main.zip',
]
found_zip = None
for zp in zip_candidates:
if os.path.isfile(zp):
found_zip = zp
break
if found_zip:
!unzip -qo {found_zip} -d /content/
print(f'Extracted {found_zip}')
else:
!git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')此步骤会验证 GPU 是否可用,然后在本地准备 DeepSeek OCR-2 代码库。上述脚本先通过 nvidia-smi 检查可用 GPU 和显存,确保环境具备足够 VRAM 以运行 vLLM 推理。
随后定义仓库路径并检查所需的 vLLM 集成目录是否已存在;若不存在,则从本地 ZIP 解压或直接从 GitHub 克隆官方 DeepSeek OCR-2 仓库。
下一步,我们将安装所需依赖,并为基于 vLLM 的推理准备运行时环境。
步骤 2:安装依赖
DeepSeek OCR-2 与 vLLM 对版本十分敏感,因此本步骤将为 CUDA 11.8 固定一组可用的包版本,安装匹配的 vLLM wheel,并添加 flash-attn 以加速注意力算子。
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
--index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')上述代码片段安装了与 vLLM 搭配可用的 DeepSeek OCR-2 运行时。同时也安装了应用所需的配套栈,包括Transformers、用于 UI 的Gradio、用于 PDF/图像处理的PyMuPDF 与 Pillow,以及用于构建检索索引的 SentenceTransformers 与 FAISS。
安装完成后,还会配置环境变量以保障 vLLM 稳定执行并与Triton 兼容。仓库的 vLLM 集成目录被加入 sys.path,以便导入自定义的 DeepSeek OCR-2 模型与预处理模块;最后还加载轻量嵌入模型(all-MiniLM-L6-v2)来支持增量的页级 RAG 索引。
下一步,我们将实现预处理工具,把 PDF 转换为页面图像,将每页打包为 DeepSeek OCR-2 期望的多模态输入格式,并清理 OCR 输出以便检索。
步骤 3:预处理工具
在运行 DeepSeek OCR-2 之前,我们需要一小套预处理工具,将 PDF 转换为可供模型使用的输入,并清洗原始 OCR 输出以便检索。
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
images = []
pdf_document = fitz.open(pdf_path)
zoom = dpi / 72.0
matrix = fitz.Matrix(zoom, zoom)
for page_num in range(pdf_document.page_count):
page = pdf_document[page_num]
pixmap = page.get_pixmap(matrix=matrix, alpha=False)
Image.MAX_IMAGE_PIXELS = None
if image_format.upper() == 'PNG':
img_data = pixmap.tobytes('png')
img = Image.open(io.BytesIO(img_data))
else:
img_data = pixmap.tobytes('png')
img = Image.open(io.BytesIO(img_data))
if img.mode in ('RGBA', 'LA'):
background = Image.new('RGB', img.size, (255, 255, 255))
background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
img = background
images.append(img)
pdf_document.close()
return images
def process_single_image(image, prompt_str):
return {
'prompt': prompt_str,
'multi_modal_data': {
'image': DeepseekOCR2Processor().tokenize_with_images(
images=[image], bos=True, eos=True, cropping=config.CROP_MODE
)
},
}
def clean_ocr_output(content):
if '<|end▁of▁sentence|>' in content:
content = content.replace('<|end▁of▁sentence|>', '')
else:
if config.SKIP_REPEAT:
return ''
content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
return content.strip()上述工具定义了三个关键组件:
用于增量搜索的批处理(“索引中可提问”)
我们设置 BATCH_SIZE = 5 来权衡首批结果出现的速度与 GPU 使用效率。对于 20 页的 PDF,进度会从 0% 以 25% 为步进更新至 100%,而不是直接从 0% 跳到 100%。
这使用户在前 5 页索引完成后即可开始提问。较小批次改善“首个结果时间”,而较大批次则提升吞吐与 GPU 利用率。
高质量 PDF 渲染为图像
我们使用原始实现中的 PyMuPDF 库,将每页渲染为 144 DPI 的 PIL 图像,即原生的 pdf_to_images_high_quality() 函数代码(来自 zoom = 144 / 72.0 = 2.0,将默认 72 DPI 翻倍)。
dpi/72 的缩放矩阵控制栅格化质量,alpha=False 可避免透明伪影。若图像仍含 alpha 通道,函数会将其铺白合成,避免异常混合影响 OCR 质量。
多模态输入
process_single_image() 函数(来自原始代码库)将每页图像包装为 vLLM 所需的精确字典结构(prompt + multi_modal_data.image),并使用 DeepseekOCR2Processor().tokenize_with_images() 处理完整图像预处理流程,包括基于纵横比通过 dynamic_preprocess() 将大图划分为 2–6 个切片、创建填充到 1024×1024 的全局视图、张量归一化,以及生成包含图像掩码的完整 token 序列,供 DeepseekOCR2ForCausalLM 消费。
OCR 清理
仓库中的 config.CROP_MODE 控制是否启用该动态切片,这能在密集布局且字体较小的场景下提升准确率。
生成后,clean_ocr_output() 会移除特殊的句子结束 token、去除检测标注块(<|ref|>...<|/ref|><|det|>...<|/det|>),规范少量类 LaTeX 运算符,并合并多余换行,从而得到更干净的文本,利于下游 RAG 索引的切分与检索稳定性。
接下来,我们将利用清理后的输出构建轻量的页级 RAG 索引,使页面在每个批次完成后即可被搜索。
步骤 4:RAG 引擎
现在我们已能从每页抽取干净文本,下一步就是让其立刻可检索。我们将构建一个轻量的页级检索增强生成(RAG)引擎,以增量方式对内容进行索引,而不是等待整个文档处理完成。
每处理一批页面,其文本就会被向量化并添加到 FAISS 索引中,使用户能在索引构建过程中进行查询。
class PageRAG:
def __init__(self, chunk_size=1000):
self.chunk_size = chunk_size
self.index = faiss.IndexFlatIP(EMBED_DIM)
self.chunks = []
self.page_count = 0
self._lock = threading.Lock()
def reset(self):
with self._lock:
self.index = faiss.IndexFlatIP(EMBED_DIM)
self.chunks, self.page_count = [], 0
def add_page(self, page_num, text):
if not text or not text.strip():
with self._lock: self.page_count += 1
return
new_chunks = self._split(text, page_num)
texts = [c[1] for c in new_chunks]
embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
with self._lock:
self.index.add(np.array(embs, dtype=np.float32))
self.chunks.extend(new_chunks)
self.page_count += 1
def query(self, question, top_k=5):
with self._lock:
if self.index.ntotal == 0: return []
q = EMBED_MODEL.encode([question], normalize_embeddings=True)
k = min(top_k, self.index.ntotal)
scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
for s, i in zip(scores[0], ids[0]) if i >= 0]
def _split(self, text, pn):
if len(text) <= self.chunk_size: return [(pn, text)]
parts, cur = [], ''
for p in re.split(r'\n{2,}', text):
if len(cur) + len(p) > self.chunk_size and cur:
parts.append((pn, cur.strip())); cur = p
else: cur += ('\n\n' + p if cur else p)
if cur.strip(): parts.append((pn, cur.strip()))
return parts or [(pn, text[:self.chunk_size])]
@property
def indexed_pages(self):
with self._lock: return self.page_count以上类定义了四个关键组成部分:
- 使用 FAISS 的向量索引:引擎采用
faiss.IndexFlatIP对归一化嵌入进行快速相似度搜索。每处理一页,其内容就会被立即嵌入并加入索引,实现无需重建索引的实时检索。 - 页级切分:
_split()方法会按段落边界将较长页面文本拆分为约 1000 字符的块。这能提升语义匹配、避免嵌入过长且嘈杂的上下文,同时保留页码用于来源标注。 - 面向后台处理的更新:由于 OCR 与索引在后台线程运行,而用户可能同时发起查询,
threading.Lock()用于保护索引的写入与读取。 - 带溯源的快速语义搜索:
query()方法会对用户问题进行嵌入,检索 top-k 相似文本块,并返回匹配文本、页码和相似度分数。indexed_pages属性用于追踪进度,便于 UI 显示当前可检索页数。
步骤 5:vLLM 引擎
此步骤中,我们使用 vLLM 初始化 DeepSeek OCR-2 推理引擎。这是执行多模态生成的核心组件:接收已分词的页面图像并输出结构化 OCR 文本。配置遵循 DeepSeek OCR-2 vLLM 的官方参考设置,但我们将其封装在延迟加载器 load_ocr_engine() 中,以便仅在开始处理时加载模型,从而缩短启动时间并避免不必要的 GPU 占用。
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
global ocr_llm, ocr_sampling_params
if ocr_llm is not None:
return
print(f'Loading {config.MODEL_PATH} via vLLM...')
ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
ocr_llm = LLM(
model=config.MODEL_PATH,
hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
block_size=256,
enforce_eager=False,
trust_remote_code=True,
max_model_len=8192,
swap_space=0,
max_num_seqs=config.MAX_CONCURRENCY,
tensor_parallel_size=1,
gpu_memory_utilization=0.9,
disable_mm_preprocessor_cache=True,
)
ocr_sampling_params = SamplingParams(
temperature=0.0,
max_tokens=8192,
logits_processors=[
NoRepeatNGramLogitsProcessor(
ngram_size=20, window_size=50,
whitelist_token_ids={128821, 128822},
)
],
skip_special_tokens=False,
include_stop_str_in_output=True,
)
print('vLLM engine loaded')该代码片段包含以下核心组件:
- 模型注册:通过
ModelRegistry.register_model() 将仓库中的自定义DeepseekOCR2ForCausalLM类注册给 vLLM,使其可以处理由DeepseekOCR2Processor产生的图像 token 输入。 - vLLM 引擎配置:
LLM()的参数与仓库参考设置一致,包括block_size=256、max_model_len=8192、gpu_memory_utilization=0.9和disable_mm_preprocessor_cache=True。这些设置在保持 GPU 内存可控的同时,兼顾高吞吐的 OCR 推理稳定性。 - 受控解码:
SamplingParams 与原始配置一致,即确定性解码temperature=0.0、较大的输出上限,并使用NoRepeatNGramLogitsProcessor避免重复模式,这在长文本 OCR 生成中常见。 - 延迟加载:引擎并非在导入时初始化,而是在首次调用
load_ocr_engine()时加载。后续调用会复用同一实例,避免反复进行 GPU 初始化,并保持 UI 响应性。
现在,让我们将此引擎接入一个批处理循环,按页执行 OCR 并将结果流式写入 RAG 索引,以实现实时查询。
步骤 6:“索引中可提问”的管线
这是应用的核心步骤。我们实现一个后台工作器,将上传的 PDF 渐进式地转换为可搜索的索引,而不是等待整份文档 OCR 完成。
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
global total_pages, is_processing, processing_error, stop_requested
try:
is_processing = True
processing_error = None
stop_requested = False
load_ocr_engine()
if stop_requested: return
print('PDF loading...')
images = pdf_to_images_high_quality(pdf_path)
total_pages = len(images)
print(f'Rendered {total_pages} pages.')
if stop_requested: return
print('Preprocessing all images with DeepseekOCR2Processor...')
prompt = config.PROMPT
preprocess_fn = partial(process_single_image, prompt_str=prompt)
with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
all_inputs = list(executor.map(preprocess_fn, images))
print(f'Preprocessed {len(all_inputs)} pages.')
if stop_requested: return
num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
for batch_idx in range(num_batches):
if stop_requested:
print(f'Stopped before batch {batch_idx + 1}.')
return
start = batch_idx * BATCH_SIZE
end = min(start + BATCH_SIZE, total_pages)
batch_inputs = all_inputs[start:end]
print(f' Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
outputs_list = ocr_llm.generate(
batch_inputs,
sampling_params=ocr_sampling_params,
)
for i, output in enumerate(outputs_list):
page_num = start + i + 1
cleaned = clean_ocr_output(output.outputs[0].text)
rag.add_page(page_num, cleaned)
print(f' Page {page_num}/{total_pages} ({len(cleaned)} chars)')
print(f' Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
except Exception as e:
import traceback
processing_error = f'{e}\n\n{traceback.format_exc()}'
print(f'ERROR: {processing_error}')
finally:
is_processing = False
if stop_requested:
print(f'Stopped. {rag.indexed_pages} pages indexed.')
else:
print('Processing complete.')我们的管线流程包括:渲染页面、预处理输入、以小批量运行 vLLM 推理、清理 OCR 输出,并将每页添加至由 FAISS 支持的 PageRAG 中。以下是各步骤的详细说明:
- 状态管理:
total_pages、is_processing、processing_error、stop_requested等全局变量追踪进度与失败模式,便于 UI 显示实时状态、处理停止/重置并避免并发运行冲突。 - 并行预处理:
ThreadPoolExecutor(max_workers=config.NUM_WORKERS)并行地将页面图像转换为可供模型使用的多模态输入。这样可确保在后续推理阶段 GPU 保持忙碌,因为输入已提前准备好。 - 小批量推理:不同于官方脚本对所有页面一次性调用
ocr_llm.generate(),此处计算num_batches并按BATCH_SIZE进行分批处理。这使索引可逐步推进,用户可在首批 5 页(BATCH_SIZE = 5)索引完成后开始提问,而无需等待整份文档处理完毕。 - 在批次间停止:
stop_requested会在耗时阶段之前与每个批次开始时检查。这样 Stop 按钮的行为可预期:它会在当前批次结束后停止,避免出现半写入或部分输出的状态。
至此,我们已有一条端到端管线,可将 PDF 转化为不断增长的搜索索引,使用户在后台处理继续的同时查询文档。接下来,我们将为 Gradio 应用添加与此工作器相连的 UI 回调。
步骤 7:应用回调
目前 OCR 与索引管线已在后台运行,但应用仍需一层控制逻辑,将用户操作与处理流程连接起来。
def start_processing(pdf_file):
global total_pages
if pdf_file is None: return 'Upload a PDF first.'
if is_processing: return 'Already processing.'
rag.reset()
total_pages = 0
threading.Thread(
target=process_pdf_background,
args=(pdf_file.name,),
daemon=True,
).start()
return 'Processing started! Pages become searchable in batches.'
def stop_processing():
global stop_requested
if not is_processing:
return 'Nothing is running.'
stop_requested = True
return 'Stop requested. Will halt after current batch.'
def reset_all():
global total_pages, processing_error, stop_requested
if is_processing:
return 'Cannot reset while processing. Stop first.'
rag.reset()
total_pages = 0
processing_error = None
stop_requested = False
return 'Reset complete. Upload a new PDF.'
def refresh_progress():
idx, tp = rag.indexed_pages, total_pages
if processing_error:
msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
elif stop_requested and is_processing:
pct = int(idx / tp * 100) if tp > 0 else 0
msg, c = 'Stopping after current batch...', '#f59e0b'
elif not is_processing and stop_requested:
pct = int(idx / tp * 100) if tp > 0 else 0
msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
elif not is_processing and idx == 0:
msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
elif is_processing and tp == 0:
msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
elif is_processing:
pct = int(idx / tp * 100)
msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
else:
msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
bar_min = '32px' if pct > 0 else '0'
pct_text = f'{pct}%' if pct > 5 else ''
return (f'<div style=">'
f'<div style="font-weight:500">{msg}</div>'
f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
f'transition:width .6s;display:flex;align-items:center;'
f'justify-content:center;color:white;font-weight:600;'
f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
if not question.strip(): return ''
idx = rag.indexed_pages
if idx == 0:
if is_processing:
return ('**Processing in progress -- first batch not done yet.**\n\n'
'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
'Try again shortly!')
return 'Upload a PDF and click **Process** first.'
results = rag.query(question, top_k=5)
if not results: return 'No relevant results found.'
lines = []
if is_processing:
lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
for i, r in enumerate(results, 1):
lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
r['text'][:600]]
if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
return '\n'.join(lines)该控制层承担五项核心职责:
- 异步启动处理:
start_processing()函数会校验输入、重置 RAG 索引,并以守护线程方式启动process_pdf_background()。 - 在批次间安全中断:
stop_processing()仅设置stop_requested标志,而非立即终止。后台工作器会在批次之间检查该标志,从而干净停止且不破坏索引。 - 状态重置:
reset_all()会清空 FAISS 索引、进度计数和错误状态;同时避免在处理仍在进行时进行重置,防止应用状态不一致。 - 实时进度汇报:我们使用
refresh_progress()从PageRAG读取已索引页数,并生成动态 HTML 进度条。同时展示系统状态,如加载、处理中、停止中、完成或错误。 - 带来源溯源的增量问答:最后,
answer_question() 会查询 FAISS 索引并返回匹配度最高的文本块及其页码与相似度分数。若索引仍在构建,响应会明确告知已检索的页数,强化“索引中可提问”的体验。
最后一步,我们将把这些回调接入 Gradio 界面,通过一个简单的 Web UI 暴露完整工作流。
步骤 8:Gradio 界面
在最后一步中,我们将所有内容封装进一个简单的 Gradio 应用。该 UI 允许用户上传 PDF、开始处理,并在索引完成前就开始提问。
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
with gr.Row(equal_height=True):
with gr.Column(scale=1, min_width=250):
pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
process_btn = gr.Button('Process PDF', variant='primary', size='lg')
with gr.Row():
stop_btn = gr.Button('Stop', variant='stop', size='sm')
reset_btn = gr.Button('Reset', variant='secondary', size='sm')
status_output = gr.Markdown()
with gr.Column(scale=2):
progress_bar = gr.HTML(
value='<div style=">Upload a PDF and click Process.</div>')
gr.Markdown('---')
with gr.Row(equal_height=True):
question_input = gr.Textbox(
label='Ask a Question',
placeholder='What is this document about?',
lines=1, scale=4)
ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
answer_output = gr.Markdown()
timer = gr.Timer(2)
timer.tick(fn=refresh_progress, outputs=progress_bar)
process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
stop_btn.click(fn=stop_processing, outputs=status_output)
reset_btn.click(fn=reset_all, outputs=status_output)
ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)Gradio 应用包含两列:左侧为 PDF 上传组件和 Process/Stop/Reset 按钮,右侧显示实时 HTML 进度条。即使 OCR 仍在进行,应用也能保持响应。以下是一些关键特性:
- 基于轮询的进度指示:
gr.Timer(2)每两秒调用refresh_progress()并更新进度条 HTML。由于索引按批进行,用户会看到阶梯状的进度推进(消息也会随“加载中”“停止中”“错误”或“完成”等状态变化)。 - 事件回调绑定:按钮的
.click()事件直接连接到后端函数,如start_processing()启动后台工作器、stop_processing()请求干净停止、reset_all()清空状态、answer_question()基于当前已索引的页面执行检索。 - 问答交互:可通过点击Ask 或按Enter 提交问题。答案以 Markdown 渲染,这对纯文本效果较好,但对于包含代码、公式或特殊字符的文本则一般。
最后,demo.launch() 会在 Colab 中启动应用,提供可分享链接、内联渲染,并启用调试日志,便于开发过程中的问题诊断。
结语
在本教程中,我们使用 DeepSeek OCR-2 构建了一条完整的“视觉优先”文档智能管线:从原始 PDF 出发,将页面渲染为高质量图像,通过 vLLM 运行多模态 OCR,对抽取文本进行清洗与结构化,并将其增量写入基于 FAISS 的 RAG 存储。
通过小批量处理页面,应用实现了“索引中可提问”的体验:用户无需等待全部完成,首批就绪后即可查询文档。
但在测试中也发现了两点明显局限:对公式密集区域的转写并不总是准确——即便使用提示词进行约束,这仍是视觉-语言 OCR 模型的已知难题。
此外,部分较长页面会出现重复输出模式。官方流水线通过 NoRepeatNGramLogitsProcessor(ngram_size=20)缓解这一问题,但在密集表格与多栏布局下仍可能触发生成循环;此时会通过 SKIP_REPEAT 标志静默跳过该页。
要进一步改进,读者可尝试加入轻量 LLM 层(例如调用 Anthropic 或 OpenAI 的 API),对检索到的文本块进行摘要,而非直接返回原始片段。
其他实用改进包括:将 FAISS 索引持久化到磁盘以便跨会话复用、在单一索引中支持多个 PDF、在 Gradio UI 中直接暴露 BATCH_SIZE 与 top_k 等可调参数,或添加结构感知的切分(标题、表格与章节边界)以提升检索精度。
FAQs
该项目是否使用官方 DeepSeek OCR-2 流水线?
是的。后端遵循仓库的 DeepSeek-OCR2-vllm 方案,包括 DeepseekOCR2Processor 预处理,将 DeepseekOCR2ForCausalLM 注册到 vLLM,以及使用 LLM.generate() 函数。
为何不使用 `AutoModel.from_pretrained()`?
使用 AutoModel.from_pretrained() 的路径经常因 transformers / flash-attn / CUDA ABI 不匹配和内部 API 变更而失效。对于本工作流,仓库提供的 vLLM 路径更稳定。
如何提升表格的识别质量?
尝试更高的 dpi(144 到 168 或 192),并保持 crop_mode 与仓库配置一致。需注意表格往往对分辨率较为敏感。

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
DeepSeek OCR-2 专为“视觉优先”的文档理解而设计,尤其适用于传统文本抽取难以处理的扫描版或图片较多的 PDF。在本教程中,我们将通过 vLLM 服务化 DeepSeek OCR-2,并用 Gradio 构建一个轻量的“索引中可提问”文档助手。
在应用中,用户上传 PDF;每一页被渲染为高质量图像,并以小批量执行 OCR。抽取的文本会被逐步写入基于 SentenceTransformers 的 FAISS 存储,使文档在处理过程中就能被检索。用户无需等待整个文件处理完毕,在第一批索引完成后即可开始提问。
最终实现的是一种实用的文档聊天工作流,强调更快的首答时间、高效的 GPU 利用率,以及流式般的交互体验。
我也建议您查看我们的DeepSeek OCR 基础教程以及DeepSeek-V3.2-Speciale 教程。