
Last chance! 50% off DataCamp Premium
Sale ends in
DeepSeek-OCR 2 è un modello visione-linguaggio end-to-end per la lettura dei documenti con OCR, progettato per gestire layout complessi (pagine multi-colonna, moduli, tabelle, formule) imparando un ordine di lettura migliore invece di appiattire le patch d’immagine con una scansione raster fissa dall’alto a sinistra verso il basso a destra.
L’idea centrale è Visual Causal Flow, cioè il modello cerca di imitare come gli esseri umani leggono i documenti, in modo progressivo e semantico, piuttosto che trattare la pagina come una griglia uniforme. A livello architetturale, DeepSeek-OCR 2 mantiene lo schema encoder–decoder di DeepSeek-OCR, ma aggiorna l’encoder a DeepEncoder V2, che introduce un meccanismo di riordinamento causale dei token prima che il decoder generi il testo.
A livello alto, DeepSeek OCR-2 converte un documento in testo tramite una pipeline visione-linguaggio che apprende l’ordine di lettura invece di basarsi su un ordinamento a coordinate fisse. Questo include:
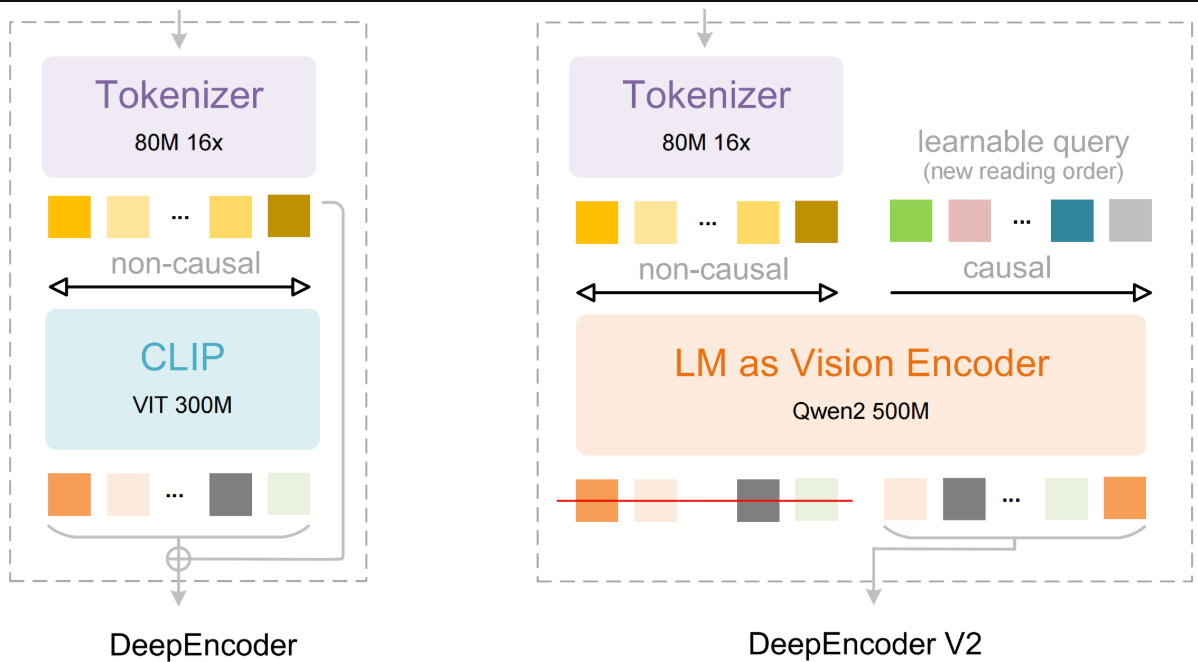
Figura: DeepSeek-OCR 2: Visual Causal Flow
Puoi consultare il repository GitHub di DeepSeek OCR-2 per esplorare il codice in dettaglio.
In questa sezione costruiremo un’applicazione di document intelligence in tempo reale che ti permette di caricare un PDF, estrarne il contenuto con DeepSeek OCR-2 e iniziare a fare domande mentre il documento è ancora in elaborazione. Invece di attendere il completamento dell’OCR, le pagine diventano ricercabili batch dopo batch, abilitando un’esperienza molto più rapida e interattiva.
A livello alto, il sistema esegue quattro task principali:
L’applicazione produce due output principali:
Nota: questo tutorial si basa sul codice demo ufficiale OCR-2 vLLM di DeepSeek, incluso l’helper per il rendering dei PDF, l’impacchettamento degli input multimodali, la pulizia del testo OCR e la configurazione del motore/sampling vLLM. Su questa base, aggiungo uno strato RAG leggero, l’elaborazione OCR in mini-batch per abilitare l’indicizzazione incrementale e un’app Gradio.
Prima di eseguire DeepSeek OCR-2 con vLLM, dobbiamo assicurarci che l’ambiente runtime sia pronto. In questo tutorial assumiamo un ambiente con GPU, come Google Colab con A100 o T4, poiché sia vLLM sia DeepSeek OCR-2 richiedono CUDA per un’inferenza efficiente.
In questo passo faremo:
Questo garantisce che il resto della pipeline possa caricare il modello e le utility di supporto senza problemi di path o dipendenze.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
Questo passo verifica la disponibilità di una GPU e prepara localmente il codebase di DeepSeek OCR-2. Lo script sopra controlla prima la GPU e la memoria disponibili con nvidia-smi per assicurarsi che l’ambiente abbia VRAM sufficiente per l’inferenza vLLM.
Quindi definisce i path del repository e verifica se la directory di integrazione vLLM richiesta esiste già. In caso contrario, estrae il repository da uno ZIP locale oppure clona il repository ufficiale DeepSeek OCR-2 da GitHub.
Nel prossimo passo installeremo le dipendenze richieste e prepareremo il runtime per l’inferenza basata su vLLM.
DeepSeek OCR-2 e vLLM sono molto sensibili alle versioni, quindi in questo passo fissiamo un set di pacchetti funzionante per CUDA 11.8, installiamo una wheel vLLM compatibile e aggiungiamo flash-attn per kernel di attenzione più veloci.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
Il codice sopra installa un runtime compatibile per DeepSeek OCR-2 con vLLM. Installa anche lo stack di supporto per l’applicazione, inclusi Transformers, Gradio per la UI, PyMuPDF e Pillow per l’elaborazione di PDF/immagini, e SentenceTransformers con FAISS per costruire l’indice di retrieval.
Dopo l’installazione, le variabili d’ambiente vengono configurate per un’esecuzione vLLM stabile e la compatibilità con Triton. L’integrazione vLLM del repository è aggiunta a sys.path così che il modello personalizzato DeepSeek OCR-2 e i moduli di preprocessing possano essere importati; infine, viene caricato un modello di embedding leggero (all-MiniLM-L6-v2) per supportare l’indicizzazione RAG incrementale a livello di pagina.
Nel prossimo passo implementeremo le utility di preprocessing per convertire un PDF in immagini di pagina, impacchettare ciascuna pagina nel formato di input multimodale atteso da DeepSeek OCR-2 e ripulire gli output OCR per il retrieval.
Prima di poter eseguire DeepSeek OCR-2, ci serve un piccolo set di utility di preprocessing che convertano un PDF in input pronti per il modello e ripuliscano l’output OCR grezzo per il retrieval.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
Le utility sopra definiscono tre componenti chiave:
Impostiamo BATCH_SIZE = 5 per controllare quanto velocemente compaiono i primi risultati rispetto a quanto efficientemente usiamo la GPU. Per un PDF di 20 pagine, gli aggiornamenti avanzano a step da 0% a 25%, 50%, 75% e 100%, invece di saltare direttamente da 0% a 100%.
Questo permette agli utenti di iniziare a fare domande non appena le prime 5 pagine sono indicizzate. Batch più piccoli migliorano il tempo-al-primo-risultato, mentre batch più grandi migliorano il throughput e l’utilizzo della GPU.
Abbiamo usato il codice nativo della funzione pdf_to_images_high_quality() dell’implementazione originale con la libreria PyMuPDF per renderizzare ogni pagina in un’immagine PIL a 144 DPI (deriva da zoom = 144 / 72.0 = 2.0, che raddoppia la risoluzione predefinita di 72 DPI).
La matrice di zoom dpi/72 controlla la qualità di rasterizzazione, e alpha=False evita artefatti di trasparenza. Se un’immagine contiene ancora un canale alpha, la funzione la appiattisce su sfondo bianco per evitare miscelazioni anomale che possono degradare l’OCR.
La funzione process_single_image() (dal codebase originale) incapsula ogni immagine di pagina nell’esatto dizionario che vLLM si aspetta (prompt + multi_modal_data.image), usando DeepseekOCR2Processor().tokenize_with_images(), che gestisce l’intera pipeline di preprocessing delle immagini, inclusa la suddivisione delle immagini grandi in 2–6 tile tramite dynamic_preprocess() in base al rapporto d’aspetto, la creazione di una vista globale 1024×1024 con padding, l’applicazione della normalizzazione dei tensori e la generazione della sequenza completa di token con maschere immagine consumate da DeepseekOCR2ForCausalLM.
Il config.CROP_MODE del repository controlla se applicare questo tiling dinamico, che migliora l’accuratezza su layout densi con testo piccolo.
Dopo la generazione, clean_ocr_output() rimuove gli special token di fine frase, elimina i blocchi di markup di detection (<|ref|>...<|/ref|><|det|>...<|/det|>), normalizza alcuni operatori in stile LaTeX e riduce le righe vuote eccessive, producendo testo più pulito che si segmenta meglio e recupera in modo più affidabile nell’indice RAG a valle.
Ora useremo questo output ripulito per costruire un indice RAG leggero a livello di pagina, così le pagine diventano ricercabili subito dopo ogni batch.
Ora che possiamo estrarre testo pulito da ogni pagina, il passo successivo è renderlo immediatamente ricercabile. Invece di attendere che l’intero documento finisca l’elaborazione, costruiamo un motore RAG (Retrieval-Augmented Generation) leggero a livello di pagina che indicizza il contenuto in modo incrementale.
Man mano che ogni batch di pagine viene elaborato, il testo viene trasformato in embedding e aggiunto a un indice FAISS, consentendo agli utenti di interrogare il documento mentre l’indicizzazione è ancora in corso.
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
La classe sopra definisce quattro componenti chiave:
faiss.IndexFlatIP per ricerche di similarità veloci su embedding normalizzati. Quando ogni pagina viene elaborata, il suo contenuto è immediatamente convertito in embedding e aggiunto all’indice, abilitando il retrieval in tempo reale senza ricostruire l’indice._split() suddivide il testo lungo della pagina in chunk di circa 1000 caratteri basati sui confini di paragrafo. Questo migliora l’allineamento semantico ed evita di fare embedding su contesti troppo lunghi e rumorosi, preservando al contempo i numeri di pagina per l’attribuzione delle fonti.threading.Lock() protegge gli aggiornamenti e le letture dell’indice. query() calcola l’embedding della domanda dell’utente, recupera i top-k chunk più simili e restituisce il testo corrispondente insieme ai numeri di pagina e ai punteggi di similarità. La proprietà indexed_pages traccia i progressi in modo che la UI possa mostrare quante pagine sono già ricercabili.In questo passo inizializziamo il motore d’inferenza DeepSeek OCR-2 usando vLLM. Questo è il componente principale che esegue la generazione multimodale prendendo le immagini delle pagine tokenizzate e producendo testo OCR strutturato. La configurazione segue il setup di riferimento vLLM ufficiale di DeepSeek OCR-2, ma la incapsuliamo in un loader lazy load_ocr_engine() così il modello si carica solo all’avvio dell’elaborazione, riducendo i tempi di startup ed evitando allocazioni GPU non necessarie.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
Questo snippet definisce i seguenti componenti principali:
DeepseekOCR2ForCausalLM dal repository a vLLM in modo che possa gestire gli input token immagine prodotti da DeepseekOCR2Processor.LLM() coincidono con le impostazioni di riferimento del repository, tra cui block_size=256, max_model_len=8192, gpu_memory_utilization=0.9 e disable_mm_preprocessor_cache=True. Queste impostazioni sono calibrate per un’inferenza OCR ad alto throughput e stabile, mantenendo prevedibile l’uso della memoria GPU.temperature=0.0, limiti di output ampi e un NoRepeatNGramLogitsProcessor per prevenire pattern ripetitivi di testo, un problema comune nella generazione OCR long-form.load_ocr_engine(). Le chiamate successive riutilizzano la stessa istanza, evitando inizializzazioni GPU ripetute e mantenendo la UI reattiva.Ora colleghiamo questo motore a un ciclo di elaborazione a batch che esegue l’OCR pagina per pagina e invia i risultati allo strato RAG per query in tempo reale.
Questo passo è il cuore dell’app. Implementiamo un worker in background che prende un PDF caricato e lo trasforma progressivamente in un indice ricercabile, invece di attendere che l’intero documento completi l’OCR.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
Il flusso della pipeline include il rendering delle pagine, il preprocessing degli input, l’esecuzione dell’inferenza vLLM in mini-batch, quindi la pulizia dell’output OCR e infine l’aggiunta di ogni pagina al PageRAG basato su FAISS. Ecco un’analisi dettagliata di ogni passo:
total_pages, is_processing, processing_error, stop_requested) tracciano progressi e modalità di errore così che la UI possa mostrare lo stato in tempo reale, gestire stop/reset ed evitare esecuzioni in conflitto.ThreadPoolExecutor(max_workers=config.NUM_WORKERS) converte le immagini di pagina in input multimodali pronti per il modello in parallelo. Questo mantiene la GPU occupata in seguito assicurando che gli input siano pronti prima dell’inferenza.ocr_llm.generate() una volta su tutte le pagine (default dello script ufficiale), il codice calcola num_batches ed elabora le pagine in chunk di dimensione BATCH_SIZE. Questo abilita l’indicizzazione progressiva, così gli utenti possono iniziare a fare domande dopo che le prime 5 pagine (BATCH_SIZE = 5) sono indicizzate, invece di aspettare l’intero documento.stop_requested è verificato prima delle fasi costose e all’inizio di ogni batch. Questo rende prevedibile il pulsante Stop: si ferma tra i batch, dopo il completamento del batch corrente, così non si finisce con uno stato a metà o output parziali.A questo punto abbiamo una pipeline end-to-end che converte un PDF in un indice in crescita, così gli utenti possono interrogare il documento mentre l’elaborazione continua in background. Ora aggiungeremo le callback della UI che collegano questo worker all’app Gradio.
A questo stadio, la pipeline di OCR e indicizzazione è in esecuzione in background, ma all’applicazione serve ancora uno strato di controllo che colleghi le azioni dell’utente alla logica di elaborazione.
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
Questo strato di controllo gestisce cinque responsabilità principali:
start_processing() valida l’input, azzera l’indice RAG e avvia process_pdf_background() in un thread daemon. stop_processing() imposta un flag stop_requested invece di terminare subito l’esecuzione. Il worker in background controlla questo flag tra un batch e l’altro, garantendo un arresto pulito senza corrompere l’indice.reset_all() svuota l’indice FAISS, i contatori di avanzamento e lo stato di errore. Impedisce inoltre reset accidentali mentre l’elaborazione è attiva, proteggendo da stati incoerenti dell’app.refresh_progress() per leggere il numero di pagine indicizzate da PageRAG e generare una barra di avanzamento HTML dinamica. Comunica anche stati di sistema come caricamento, elaborazione attiva, arresto, completamento o errore.Nel passo finale collegheremo queste callback a un’interfaccia Gradio per esporre l’intero workflow tramite una semplice web UI.
In questo passo finale, impacchettiamo tutto in una semplice applicazione Gradio. La UI è progettata per consentire agli utenti di caricare un PDF, avviare l’elaborazione e iniziare a fare domande prima che l’indicizzazione sia completa.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
L’applicazione Gradio contiene due colonne. La colonna di sinistra include il widget di upload del PDF e i pulsanti Process/Stop/Reset, mentre la colonna di destra mostra una barra di avanzamento HTML live. Questo rende l’app reattiva anche quando l’OCR è ancora in esecuzione. Ecco alcune caratteristiche chiave della nostra app:
gr.Timer(2) chiama refresh_progress() ogni due secondi e aggiorna l’HTML della barra di avanzamento. Poiché l’indicizzazione avviene a batch, gli utenti vedono il progresso muoversi a step (e i messaggi cambiano in base a stati come caricamento, arresto, errore o completamento)..click() dei pulsanti connettono le azioni della UI direttamente alle funzioni di backend: start_processing() avvia il worker in background, stop_processing() richiede un arresto pulito, reset_all() azzera lo stato e answer_question() esegue il retrieval sulle pagine già indicizzate.Infine, demo.launch() avvia l’app in Colab, fornisce un link condivisibile, la rende inline e abilita i log di debug per aiutare a diagnosticare problemi durante lo sviluppo.
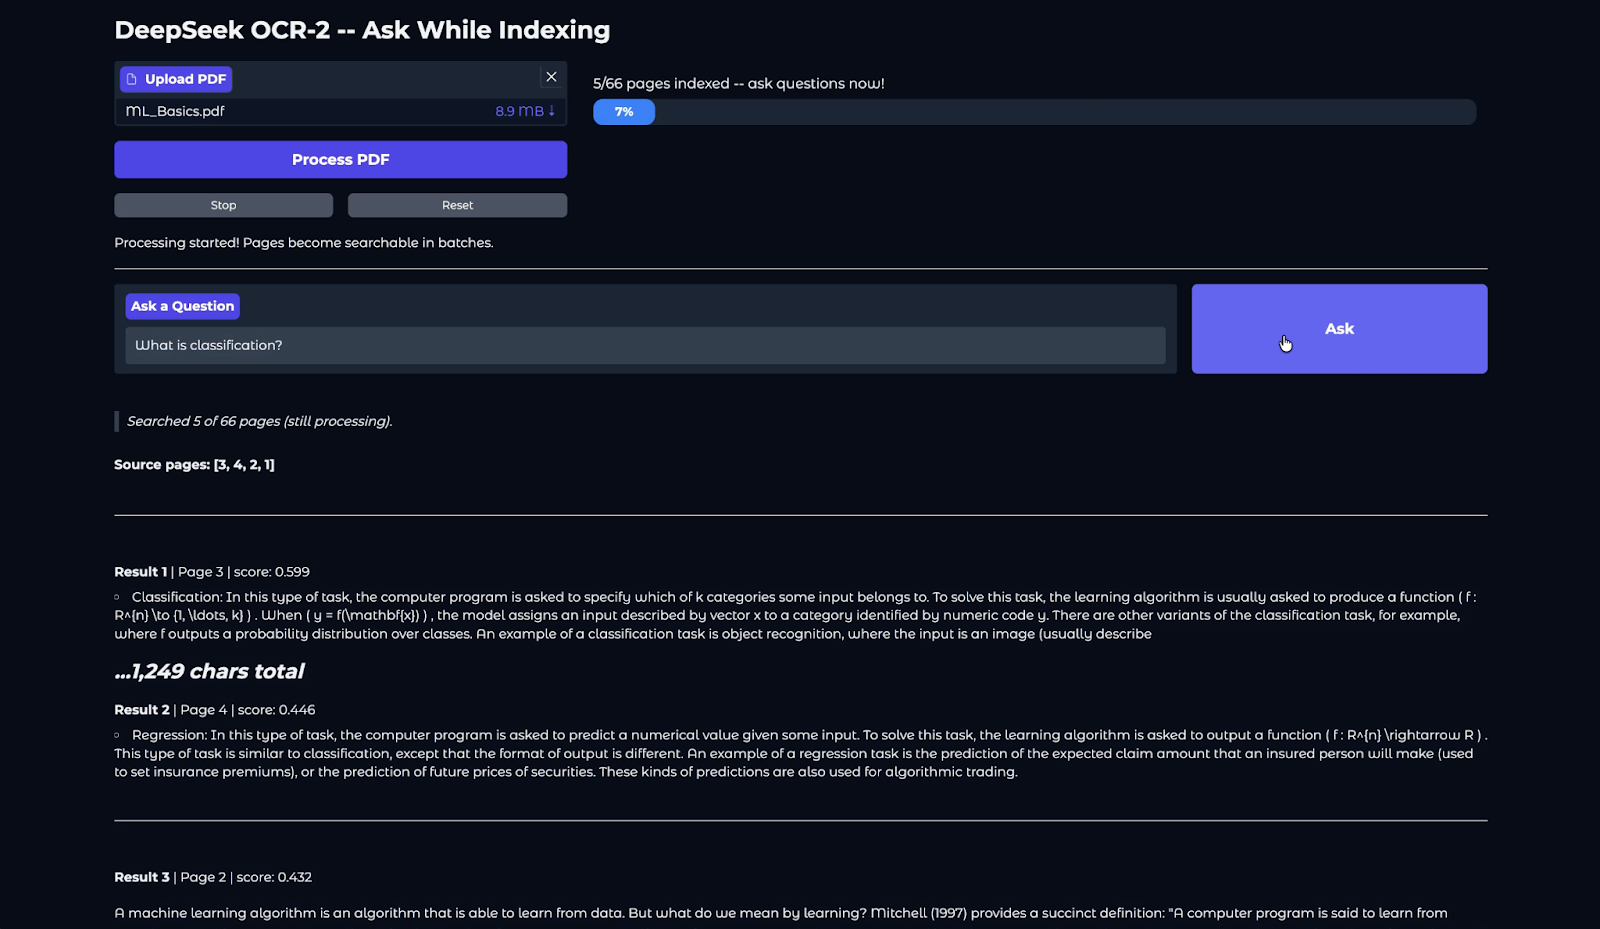
In questo tutorial abbiamo costruito una pipeline completa di document intelligence vision-first usando DeepSeek OCR-2. Partendo da un PDF grezzo, abbiamo renderizzato le pagine in immagini di alta qualità, eseguito l’OCR multimodale tramite vLLM, ripulito e strutturato il testo estratto e lo abbiamo indicizzato in modo incrementale in un archivio RAG basato su FAISS.
Elaborando le pagine in mini-batch, l’applicazione abilita un’esperienza “ask while indexing” in cui gli utenti possono iniziare a interrogare il documento dopo il primo batch invece di attendere il completamento.
Tuttavia, durante i test sono emerse due limitazioni evidenti. Le aree ricche di formule non sono sempre trascritte accuratamente, il che è una sfida nota per i modelli OCR visione-linguaggio, anche con prompt di grounding.
Inoltre, alcune pagine più lunghe mostrano pattern di output ripetitivi. La pipeline ufficiale mitiga questo aspetto con un NoRepeatNGramLogitsProcessor (ngram_size=20), ma tabelle dense e layout multi-colonna possono ancora innescare loop di generazione; in tal caso, la pagina viene ignorata silenziosamente tramite il flag SKIP_REPEAT.
Per andare oltre, si può sperimentare aggiungendo uno strato LLM leggero (ad es., chiamando le API di Anthropic o OpenAI) per riassumere i chunk recuperati invece di restituire snippet grezzi.
Altri miglioramenti pratici includono il salvataggio su disco dell’indice FAISS per riuso tra sessioni, il supporto di più PDF in un singolo indice, l’esposizione di parametri regolabili come BATCH_SIZE e top_k direttamente nella UI di Gradio, o l’aggiunta di un chunking sensibile alla struttura (intestazioni, tabelle e confini di sezione) per migliorare la precisione del retrieval.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min




