
कोर्स
Python में DeepSeek के साथ काम करना
3 घंटा
1.3K
DeepSeek-OCR 2 एक एंड-टू-एंड दस्तावेज़ पठन-सहित OCR विज़न-लैंग्वेज मॉडल है जिसे जटिल लेआउट (मल्टी-कॉलम पेज, फ़ॉर्म, टेबल, फ़ॉर्मूला) संभालने के लिए डिज़ाइन किया गया है। यह तय टॉप-लेफ़्ट से बॉटम-राइट रैस्टर स्कैन में इमेज पैच फ्लैट करने के बजाय बेहतर रीडिंग ऑर्डर सीखता है।
मुख्य विचार है Visual Causal Flow, यानी मॉडल पेज को एक समान ग्रिड की तरह ट्रीट करने के बजाय इंसानों की तरह दस्तावेज़ को क्रमशः और अर्थपूर्ण तरीके से पढ़ने की नकल करने की कोशिश करता है। आर्किटेक्चर के स्तर पर, DeepSeek-OCR 2, DeepSeek-OCR की ही एन्कोडर–डिकोडर फ़्रेमिंग रखता है, लेकिन एन्कोडर को DeepEncoder V2 में अपग्रेड करता है, जो डिकोडर द्वारा टेक्स्ट जनरेट करने से पहले एक causal टोकन रीऑर्डरिंग मैकेनिज़्म लाता है।
ऊँचे स्तर पर, DeepSeek OCR-2 एक विज़न-लैंग्वेज पाइपलाइन के माध्यम से दस्तावेज़ को टेक्स्ट में बदलता है जो फिक्स्ड कोऑर्डिनेट सॉर्टिंग पर निर्भर होने के बजाय रीडिंग ऑर्डर सीखती है। इसमें शामिल है:
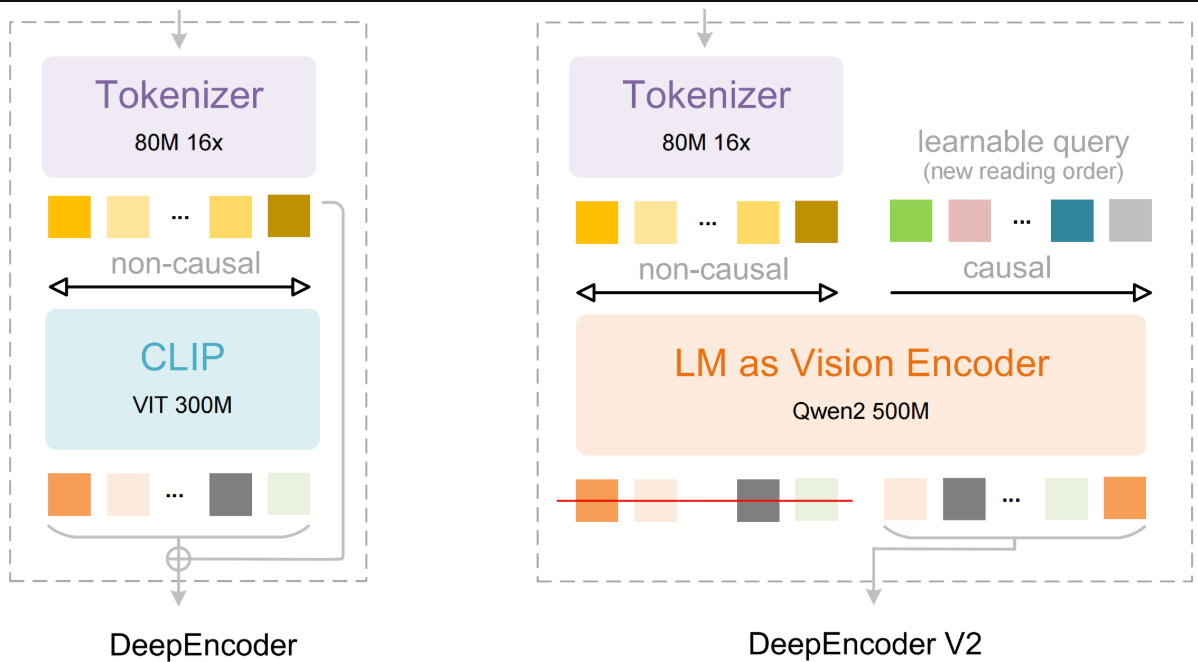
चित्र: DeepSeek-OCR 2: Visual Causal Flow
विस्तार से कोड देखने के लिए आप DeepSeek OCR-2 के GitHub रिपॉजिटरी का संदर्भ ले सकते हैं।
इस सेक्शन में, हम एक रियल-टाइम डॉक्यूमेंट इंटेलिजेंस एप्लिकेशन बनाएंगे जो आपको PDF अपलोड करने, DeepSeek OCR-2 के साथ उसकी सामग्री निकालने, और दस्तावेज़ के प्रोसेस होते समय ही प्रश्न पूछना शुरू करने देता है। पूर्ण OCR के पूरा होने का इंतज़ार करने के बजाय, पेज बैच-दर-बैच सर्चेबल बनते जाते हैं, जिससे अनुभव तेज़ और अधिक इंटरैक्टिव हो जाता है।
ऊँचे स्तर पर, सिस्टम चार मुख्य कार्य करता है:
एप्लिकेशन दो प्रमुख आउटपुट देता है:
ध्यान दें: यह ट्यूटोरियल DeepSeek के आधिकारिक OCR-2 vLLM डेमो कोड पर आधारित है, जिसमें PDF रेंडरिंग हेल्पर, मल्टीमॉडल इनपुट पैकेजिंग, OCR टेक्स्ट क्लीनअप, और vLLM इंजन/सैंपलिंग कॉन्फ़िगरेशन शामिल हैं। इसके ऊपर, मैं एक हल्की RAG लेयर, इन्क्रिमेंटल इंडेक्सिंग सक्षम करने के लिए मिनी-बैच OCR प्रोसेसिंग, और एक Gradio ऐप जोड़ता/जोड़ती हूँ।
vLLM के साथ DeepSeek OCR-2 चलाने से पहले, हमें रनटाइम एनवायरनमेंट तैयार करना होगा। इस ट्यूटोरियल में, हम GPU-सक्षम एनवायरनमेंट (जैसे Google Colab में A100 या T4) मानते हैं, क्योंकि vLLM और DeepSeek OCR-2, दोनों को कुशल इन्फ़रेंस के लिए CUDA की आवश्यकता होती है।
इस चरण में, हम यह करेंगे:
यह सुनिश्चित करता है कि पाइपलाइन का बाकी हिस्सा बिना पाथ या डिपेंडेंसी समस्याओं के मॉडल और सपोर्टिंग यूटिलिटीज़ लोड कर सके।
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
यह चरण सुनिश्चित करता है कि GPU उपलब्ध है और फिर लोकली DeepSeek OCR-2 कोडबेस तैयार करता है। ऊपर का स्क्रिप्ट पहले nvidia-smi का उपयोग करके उपलब्ध GPU और मेमोरी जाँचता है ताकि यह सुनिश्चित हो कि vLLM इन्फ़रेंस के लिए पर्याप्त VRAM है।
इसके बाद यह रिपॉजिटरी पाथ तय करता है और देखता है कि आवश्यक vLLM इंटीग्रेशन डायरेक्टरी पहले से मौजूद है या नहीं। यदि नहीं, तो यह या तो लोकल ZIP से रिपॉजिटरी एक्सट्रैक्ट करता है या GitHub से आधिकारिक DeepSeek OCR-2 रिपॉजिटरी क्लोन करता है।
अगले चरण में, हम आवश्यक डिपेंडेंसी इंस्टॉल करेंगे और vLLM-आधारित इन्फ़रेंस के लिए रनटाइम तैयार करेंगे।
DeepSeek OCR-2 और vLLM वर्ज़न-सेंसिटिव हैं, इसलिए इस चरण में हम CUDA 11.8 के लिए पैकेजों का एक कामयाब सेट पिन करेंगे, मिलती-जुलती vLLM व्हील इंस्टॉल करेंगे, और तेज़ अटेंशन कर्नेल के लिए flash-attn जोड़ेंगे।
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
ऊपर दिया गया कोड स्निपेट vLLM के साथ DeepSeek OCR-2 के लिए एक संगत रनटाइम इंस्टॉल करता है। यह एप्लिकेशन के लिए सपोर्टिंग स्टैक भी इंस्टॉल करता है, जिसमें Transformers, UI के लिए Gradio, PDF/इमेज प्रोसेसिंग के लिए PyMuPDF और Pillow, और रिट्रीवल इंडेक्स बनाने के लिए SentenceTransformers सहित FAISS शामिल है।
इंस्टॉलेशन के बाद, एनवायरनमेंट वेरिएबल्स को स्थिर vLLM एक्ज़िक्यूशन और Triton संगतता के लिए कॉन्फ़िगर किया जाता है। रिपॉजिटरी का vLLM इंटीग्रेशन sys.path में जोड़ा जाता है ताकि कस्टम DeepSeek OCR-2 मॉडल और प्रीप्रोसेसिंग मॉड्यूल इम्पोर्ट हो सकें, और अंत में, एक हल्का एम्बेडिंग मॉडल (all-MiniLM-L6-v2) लोड किया जाता है जो इन्क्रिमेंटल पेज-स्तरीय RAG इंडेक्सिंग का समर्थन करता है।
अगले चरण में, हम प्रीप्रोसेसिंग यूटिलिटीज़ लागू करेंगे ताकि PDF को पेज इमेज में बदलें, हर पेज को DeepSeek OCR-2 द्वारा अपेक्षित मल्टीमॉडल इनपुट फ़ॉर्मेट में पैक करें, और रिट्रीवल के लिए OCR आउटपुट को साफ़ करें।
DeepSeek OCR-2 चलाने से पहले, हमें कुछ छोटी प्रीप्रोसेसिंग यूटिलिटीज़ चाहिए जो PDF को मॉडल-रेडी इनपुट में बदलें और रिट्रीवल के लिए कच्चे OCR आउटपुट को साफ़ करें।
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
ऊपर दी गई यूटिलिटीज़ तीन प्रमुख घटक परिभाषित करती हैं:
हम BATCH_SIZE = 5 सेट करते हैं ताकि पहली बार परिणाम कितनी जल्दी आएँ और GPU का उपयोग कितनी कुशलता से हो—दोनों को संतुलित किया जा सके। 20-पेज के PDF के लिए, प्रोग्रेस 0% से 25% से 50% से 75% से 100% तक चरणों में बढ़ती है, सीधे 0% से 100% पर छलांग नहीं लगती।
इससे उपयोगकर्ता पहले 5 पेज इंडेक्स होते ही प्रश्न पूछना शुरू कर सकते हैं। छोटे बैच समय-से-पहला-परिणाम सुधारते हैं, जबकि बड़े बैच थ्रूपुट और GPU उपयोगिता में सुधार करते हैं।
हमने PyMuPDF लाइब्रेरी का उपयोग करते हुए मूल इम्प्लीमेंटेशन के नेटिव pdf_to_images_high_quality() फ़ंक्शन कोड का उपयोग किया ताकि हर पेज को 144 DPI पर PIL इमेज में रेंडर किया जा सके (zoom = 144 / 72.0 = 2.0 से, जो डिफ़ॉल्ट 72 DPI को दोगुना करता है)।
dpi/72 ज़ूम मैट्रिक्स रैस्टराइज़ेशन गुणवत्ता नियंत्रित करता है, और alpha=False ट्रांसपेरेंसी आर्टिफ़ैक्ट्स से बचाता है। यदि किसी इमेज में फिर भी अल्फ़ा चैनल है, तो फ़ंक्शन उसे सफेद बैकग्राउंड पर फ्लैट कर देता है ताकि अजीब ब्लेंडिंग न हो जो OCR को बिगाड़ सकती है।
process_single_image() फ़ंक्शन (मूल कोडबेस से) हर पेज इमेज को vLLM द्वारा अपेक्षित सटीक डिक्ट स्ट्रक्चर (prompt + multi_modal_data.image) में रैप करता है, DeepseekOCR2Processor().tokenize_with_images() का उपयोग करते हुए, जो संपूर्ण इमेज प्रीप्रोसेसिंग पाइपलाइन संभालता है—जिसमें आस्पेक्ट रेशियो के आधार पर dynamic_preprocess() द्वारा बड़ी इमेजों को 2–6 टाइल में बाँटना, 1024×1024 का पैडेड ग्लोबल व्यू बनाना, टेन्सर नॉर्मलाइज़ेशन लागू करना, और इमेज मास्क सहित पूरा टोकन अनुक्रम बनाना शामिल है जिसे DeepseekOCR2ForCausalLM कंज़्यूम करता है।
रिपोज़ का config.CROP_MODE नियंत्रित करता है कि यह डायनेमिक टाइलिंग लागू हो या नहीं, जो छोटे टेक्स्ट वाले घने लेआउट पर सटीकता सुधारता है।
जनरेशन के बाद, clean_ocr_output() विशेष end-of-sentence टोकन हटाता है, डिटेक्शन मार्कअप ब्लॉक (<|ref|>...<|/ref|><|det|>...<|/det|>) निकालता है, कुछ LaTeX-जैसे ऑपरेटर सामान्य करता है, और अतिरिक्त नई पंक्तियों को समेटता है—जिससे साफ़ टेक्स्ट बनता है जो बेहतर तरीके से चंक्स में बँटता है और डाउनस्ट्रीम RAG इंडेक्स में अधिक भरोसेमंद ढंग से रिट्रीव होता है।
अगला, हम इस साफ़ आउटपुट का उपयोग हल्का-फुल्का पेज-स्तरीय RAG इंडेक्स बनाने के लिए करेंगे, ताकि हर बैच के पूरा होते ही पेज सर्चेबल हो जाएँ।
अब जब हम हर पेज से साफ़ टेक्स्ट निकाल सकते हैं, अगला कदम है उसे तुरंत सर्चेबल बनाना। पूरे दस्तावेज़ के प्रोसेस होने का इंतज़ार करने के बजाय, हम एक हल्का पेज-स्तरीय Retrieval-Augmented Generation (RAG) इंजन बनाते हैं जो सामग्री को क्रमिक रूप से इंडेक्स करता है।
जैसे ही पेजों का कोई बैच प्रोसेस होता है, उनका टेक्स्ट एम्बेड किया जाता है और FAISS इंडेक्स में जोड़ दिया जाता है, जिससे उपयोगकर्ता इंडेक्सिंग चलते समय भी डॉक्यूमेंट क्वेरी कर सकते हैं।
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
ऊपर की कक्षा चार मुख्य घटक परिभाषित करती है:
faiss.IndexFlatIP का उपयोग करता है। जैसे ही हर पेज प्रोसेस होता है, उसकी सामग्री तुरंत एम्बेड होकर इंडेक्स में जुड़ जाती है, जिससे बिना इंडेक्स रीबिल्ड किए रियल-टाइम रिट्रीवल संभव होता है।_split() मेथड लंबे पेज टेक्स्ट को लगभग 1000-अक्षर के चंक्स में पैराग्राफ सीमाओं के आधार पर तोड़ता है। इससे सिमेंटिक मैचिंग सुधरती है और अत्यधिक लंबे, शोरयुक्त कॉन्टेक्स्ट को एम्बेड करने से बचा जाता है, जबकि सोर्स एट्रिब्यूशन के लिए पेज नंबर संरक्षित रहते हैं।threading.Lock() इंडेक्स अपडेट और रीड को सुरक्षित रखता है। query() मेथड उपयोगकर्ता प्रश्न को एम्बेड करता है, टॉप-k समान चंक्स रिट्रीव करता है, और पेज नंबर व समानता स्कोर सहित मिला हुआ टेक्स्ट लौटाता है। indexed_pages प्रॉपर्टी प्रगति को ट्रैक करती है ताकि UI दिखा सके कि कितने पेज पहले से सर्चेबल हैं।इस चरण में, हम vLLM का उपयोग करके DeepSeek OCR-2 इन्फ़रेंस इंजन इनिशियलाइज़ करते हैं। यह कोर कंपोनेंट है जो टोकनाइज़ की गई पेज इमेज लेकर संरचित OCR टेक्स्ट जनरेट करते हुए मल्टीमॉडल जनरेशन करता है। कॉन्फ़िगरेशन आधिकारिक DeepSeek OCR-2 vLLM रेफ़रेंस सेटअप का अनुसरण करता है, पर हम इसे एक लेज़ी लोडर load_ocr_engine() में रैप करते हैं ताकि प्रोसेसिंग शुरू होने पर ही मॉडल लोड हो—स्टार्टअप समय घटे और अनावश्यक GPU आवंटन से बचा जा सके।
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
यह कोड स्निपेट निम्नलिखित मुख्य कम्पोनेंट परिभाषित करता है:
DeepseekOCR2ForCausalLM क्लास को vLLM से जोड़ता है ताकि वह DeepseekOCR2Processor द्वारा उत्पन्न इमेज-टोकन इनपुट हैंडल कर सके।LLM() के पैरामीटर रिपॉजिटरी के रेफ़रेंस सेटिंग्स से मेल खाते हैं, जैसे block_size=256, max_model_len=8192, gpu_memory_utilization=0.9, और disable_mm_preprocessor_cache=True। ये सेटिंग्स उच्च थ्रूपुट OCR इन्फ़रेंस के लिए स्थिर और पूर्वानुमेय GPU मेमोरी उपयोग हेतु ट्यून की गई हैं।temperature=0.0, बड़े आउटपुट लिमिट, और दोहरावदार पैटर्न रोकने के लिए NoRepeatNGramLogitsProcessor, जो लंबे OCR जनरेशन में आम समस्या है।load_ocr_engine() कॉल होने पर ही लोड होता है। बाद की कॉल्स उसी इंस्टेंस का पुनः उपयोग करती हैं, जिससे बार-बार GPU इनिशियलाइज़ेशन से बचाव होता है और UI उत्तरदायी रहता है।अब, इस इंजन को एक बैच प्रोसेसिंग लूप से जोड़ते हैं जो पेज-बाय-पेज OCR चलाता है और रियल-टाइम क्वेरींग के लिए परिणामों को RAG इंडेक्स में स्ट्रीम करता है।
यह चरण ऐप का हृदय है। हम एक बैकग्राउंड वर्कर लागू करते हैं जो अपलोड किए गए PDF को क्रमशः एक सर्चेबल इंडेक्स में बदलता है—पूरे दस्तावेज़ के OCR के पूरा होने की प्रतीक्षा करने के बजाय।
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
हमारी पाइपलाइन का फ़्लो पेज रेंडरिंग, इनपुट प्री-प्रोसेसिंग, मिनी-बैच में vLLM इन्फ़रेंस चलाना, फिर OCR आउटपुट क्लीन करना, और अंततः हर पेज को FAISS-समर्थित PageRAG में जोड़ना शामिल करता है। हर चरण का विस्तृत विश्लेषण इस प्रकार है:
total_pages, is_processing, processing_error, stop_requested) प्रगति और फ़ेल्योर मोड्स ट्रैक करते हैं ताकि UI लाइव स्टेटस दिखा सके, स्टॉप/रीसेट हैंडल कर सके, और कॉन्फ़्लिक्टिंग रन से बचे।ThreadPoolExecutor(max_workers=config.NUM_WORKERS) पेज इमेजों को पैरलल में मॉडल-रेडी मल्टीमॉडल इनपुट में बदलता है। इससे बाद में GPU व्यस्त रहता है क्योंकि इन्फ़रेंस से पहले इनपुट तैयार हो जाते हैं।ocr_llm.generate() को सभी पेजों पर एक साथ चलाने (आधिकारिक स्क्रिप्ट का डिफ़ॉल्ट) के बजाय, कोड num_batches निकालता है और पेजों को BATCH_SIZE के चंक्स में प्रोसेस करता है। यह प्रोग्रेसिव इंडेक्सिंग सक्षम करता है, जिससे उपयोगकर्ता पहले 5 पेज (BATCH_SIZE = 5) इंडेक्स होने के बाद ही प्रश्न पूछना शुरू कर सकते हैं, पूरे दस्तावेज़ का इंतज़ार नहीं करना पड़ता।stop_requested महँगे चरणों से पहले और हर बैच की शुरुआत में जाँचा जाता है। इससे स्टॉप बटन का व्यवहार पूर्वानुमेय बनता है: यह हर बैच के बीच में रुकता है—वर्तमान बैच के बाद—ताकि आधा-लिखा स्टेट या आंशिक आउटपुट न रह जाए।इस बिंदु पर, हमारे पास एक एंड-टू-एंड पाइपलाइन है जो PDF को एक बढ़ते सर्च इंडेक्स में बदलती है, ताकि उपयोगकर्ता बैकग्राउंड में प्रोसेसिंग जारी रहते हुए भी डॉक्यूमेंट को क्वेरी कर सकें। अब हम UI कॉलबैक्स जोड़ेंगे जो इस वर्कर को Gradio एप्लिकेशन से जोड़ते हैं।
इस चरण पर, OCR और इंडेक्सिंग पाइपलाइन बैकग्राउंड में चल रही है, लेकिन एप्लिकेशन को अभी भी एक कंट्रोल लेयर चाहिए जो उपयोगकर्ता की क्रियाओं को प्रोसेसिंग लॉजिक से जोड़ती है।
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
यह कंट्रोल लेयर पाँच मुख्य ज़िम्मेदारियाँ सँभालता है:
start_processing() फ़ंक्शन इनपुट वेरिफाई करता है, RAG इंडेक्स रीसेट करता है, और process_pdf_background() को डेमन थ्रेड में लॉन्च करता है। stop_processing() फ़ंक्शन तुरंत एक्ज़िक्यूशन रोकने के बजाय stop_requested फ़्लैग सेट करता है। बैकग्राउंड वर्कर यह फ़्लैग बैचों के बीच जाँचता है, जिससे सिस्टम साफ़-सुथरे ढंग से रुकता है और इंडेक्स करप्ट नहीं होता।reset_all() फ़ंक्शन FAISS इंडेक्स, प्रगति काउंटर और एरर स्टेट साफ़ करता है। यह प्रोसेसिंग के सक्रिय रहते हुए आकस्मिक रीसेट को भी रोकता है, जिससे असंगत एप्लिकेशन स्टेट से बचाव होता है।refresh_progress() फ़ंक्शन का उपयोग करके PageRAG से इंडेक्स हुए पेजों की संख्या पढ़ते हैं और एक डायनेमिक HTML प्रोग्रेस बार बनाते हैं। यह लोडिंग, सक्रिय प्रोसेसिंग, स्टॉपिंग, कंप्लीशन या एरर जैसे सिस्टम स्टेट भी बताता है।अंतिम चरण में, हम इन कॉलबैक्स को Gradio इंटरफेस से जोड़ेंगे ताकि पूरी वर्कफ़्लो एक सरल वेब UI से उपलब्ध हो।
अंतिम चरण में, हम सब कुछ एक सरल Gradio एप्लिकेशन में रैप करते हैं। UI इस तरह डिज़ाइन किया गया है कि उपयोगकर्ता PDF अपलोड करें, प्रोसेसिंग शुरू करें, और इंडेक्सिंग पूरी होने से पहले ही प्रश्न पूछना शुरू कर दें।
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
Gradio एप्लिकेशन में दो कॉलम हैं। बाएँ कॉलम में PDF अपलोड विजेट और Process/Stop/Reset बटन हैं, जबकि दाएँ कॉलम में लाइव HTML प्रोग्रेस बार दिखता है। इससे ऐप, OCR चलते समय भी, उत्तरदायी महसूस होता है। हमारे ऐप की कुछ प्रमुख विशेषताएँ:
gr.Timer(2) हर दो सेकंड में refresh_progress() कॉल करता है और प्रोग्रेस बार HTML अपडेट करता है। चूँकि इंडेक्सिंग बैचों में होती है, उपयोगकर्ताओं को प्रगति चरणों में बढ़ती दिखती है (और संदेश भी लोडिंग, स्टॉपिंग, एरर, या कंप्लीशन जैसी स्टेट्स के आधार पर बदलते हैं)।.click() हैंडलर्स UI क्रियाओं को सीधे बैकएंड फ़ंक्शंस से जोड़ते हैं, जैसे start_processing() बैकग्राउंड वर्कर लॉन्च करता है, stop_processing() क्लीन स्टॉप का अनुरोध करता है, reset_all() स्टेट साफ़ करता है, और answer_question() अब तक इंडेक्स हुए पेजों पर रिट्रीवल चलाता है।अंत में, demo.launch() ऐप को Colab में लॉन्च करता है, एक शेयर करने योग्य लिंक देता है, इसे इनलाइन रेंडर करता है, और डेवलपमेंट के दौरान समस्याओं के निदान में मदद के लिए डिबग लॉग सक्षम करता है।
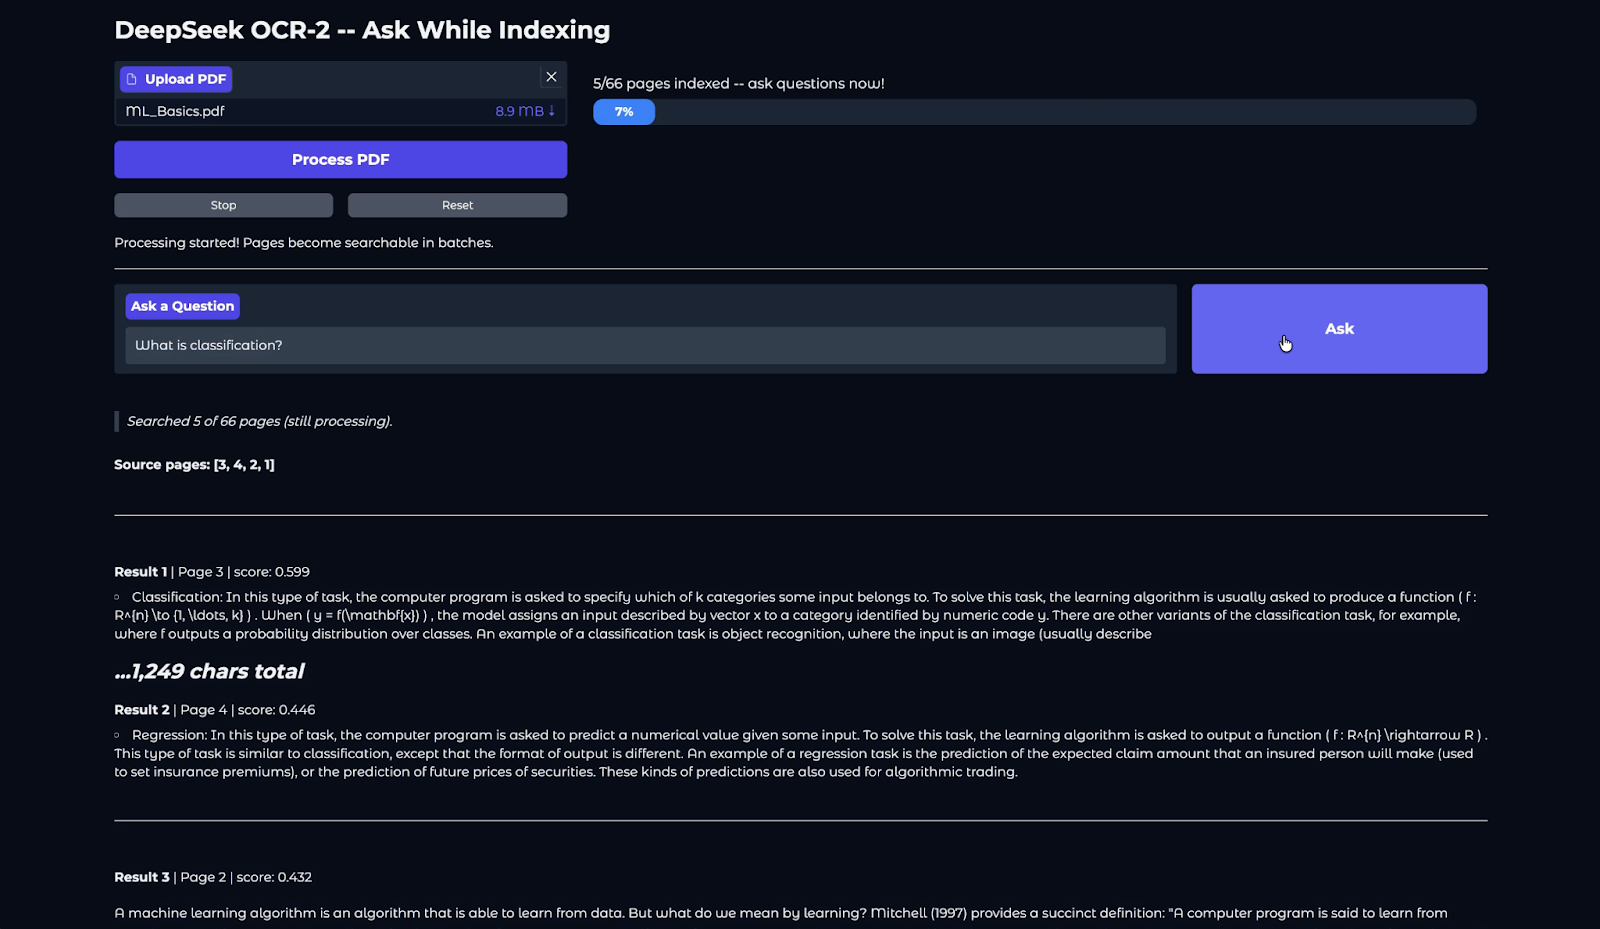
इस ट्यूटोरियल में, हमने DeepSeek OCR-2 का उपयोग करते हुए एक संपूर्ण विज़न-फर्स्ट डॉक्यूमेंट इंटेलिजेंस पाइपलाइन बनाई। कच्चे PDF से शुरुआत कर, हमने पेजों को उच्च-गुणवत्ता इमेज में रेंडर किया, vLLM के माध्यम से मल्टीमॉडल OCR चलाया, निकाले गए टेक्स्ट को साफ़ और संरचित किया, और उसे FAISS-आधारित RAG स्टोर में क्रमिक रूप से इंडेक्स किया।
पेजों को मिनी-बैच में प्रोसेस करके, एप्लिकेशन “इंडेक्सिंग के दौरान पूछें” अनुभव सक्षम करता है, जहाँ उपयोगकर्ता पहले बैच के बाद ही डॉक्यूमेंट को क्वेरी करना शुरू कर सकते हैं—पूरी कंप्लीशन का इंतज़ार नहीं करना पड़ता।
हालाँकि, परीक्षण के दौरान दो उल्लेखनीय सीमाएँ सामने आईं। फ़ॉर्मूला-प्रधान क्षेत्रों का ट्रांसक्रिप्शन हमेशा सटीक नहीं होता—यह विज़न-लैंग्वेज OCR मॉडलों के लिए एक ज्ञात चुनौती है, भले ही ग्राउंडिंग प्रॉम्प्ट दिए जाएँ।
साथ ही, कुछ लंबे पेज दोहरावदार आउटपुट पैटर्न दिखाते हैं। आधिकारिक पाइपलाइन इसे NoRepeatNGramLogitsProcessor (ngram_size=20) से कम करती है, लेकिन घनी तालिकाएँ और मल्टी-कॉलम लेआउट फिर भी जनरेशन लूप ट्रिगर कर सकते हैं—ऐसी स्थिति में SKIP_REPEAT फ़्लैग के माध्यम से पेज चुपचाप स्किप हो जाता है।
इसे आगे ले जाने के लिए, पाठक एक हल्की LLM लेयर (जैसे, Anthropic या OpenAI API कॉल करना) जोड़कर रिट्रीव्ड चंक्स का सारांश बनवाने के साथ प्रयोग कर सकते हैं—कच्चे स्निपेट लौटाने के बजाय।
अन्य व्यावहारिक सुधारों में FAISS इंडेक्स को डिस्क पर सहेजना ताकि सत्रों में दोबारा उपयोग हो सके, एक ही इंडेक्स में कई PDFs का समर्थन, Gradio UI में सीधे BATCH_SIZE और top_k जैसे ट्यूनेबल पैरामीटर उजागर करना, या रिट्रीवल प्रीसिशन सुधारने के लिए स्ट्रक्चर-अवेयर चंकिंग (हैडिंग्स, टेबल और सेक्शन सीमाएँ) जोड़ना शामिल हैं।
Top DataCamp Courses
कोर्स
कोर्स
कोर्स