
Kurs
Arbeiten mit DeepSeek in Python
3 Std.
1.3K
DeepSeek-OCR 2 ist ein End-to-End Vision-Language-Modell für Dokumentlesen und OCR. Es meistert komplexe Layouts (mehrspaltige Seiten, Formulare, Tabellen, Formeln), indem es eine bessere Lesereihenfolge lernt, statt Bild-Patches in einer festen Rasterfolge von links oben nach rechts unten abzuflachen.
Der Kernansatz ist der Visual Causal Flow, also ein Vorgehen, bei dem das Modell menschliches Lesen nachahmt: progressiv und semantisch, statt eine Seite als gleichförmiges Gitter zu behandeln. Architektonisch behält DeepSeek-OCR 2 das Encoder–Decoder-Gerüst von DeepSeek-OCR bei, aktualisiert aber den Encoder auf DeepEncoder V2, der vor der Textgenerierung im Decoder einen kausalen Token-Reorder-Mechanismus einführt.
Auf hoher Ebene wandelt DeepSeek OCR-2 Dokumente über eine Vision-Language-Pipeline in Text um, die die Lesereihenfolge lernt, statt sich auf eine starre Koordinatensortierung zu verlassen. Dazu gehören:
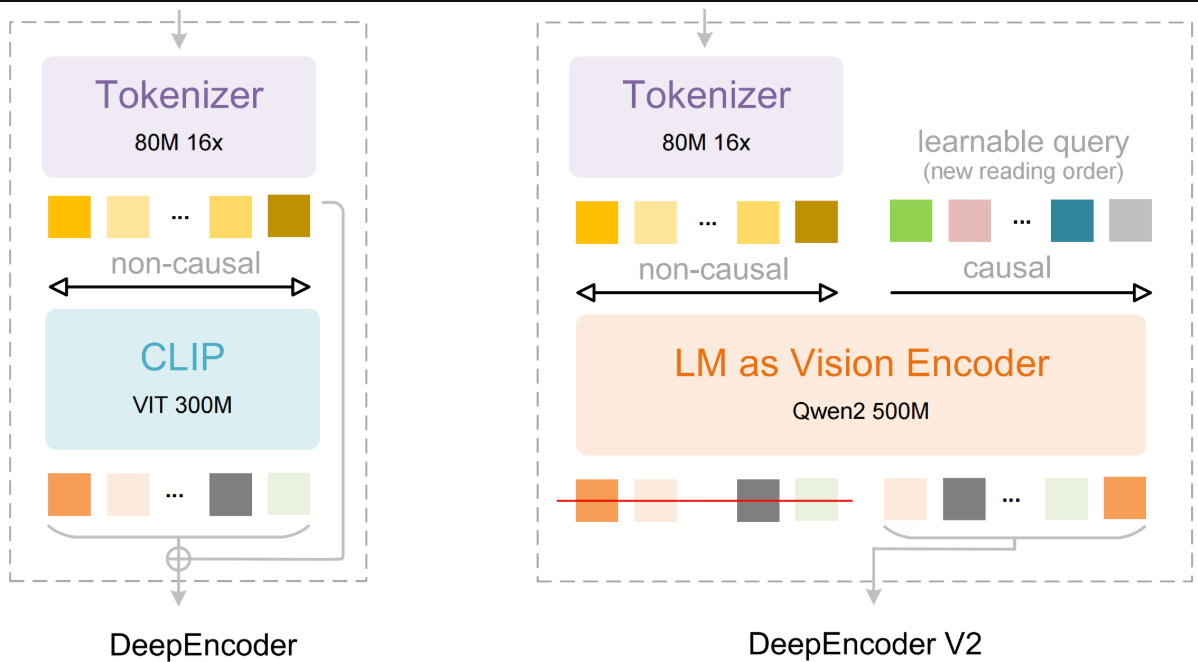
Abbildung: DeepSeek-OCR 2: Visual Causal Flow
Details findest du im DeepSeek OCR-2 GitHub-Repository.
In diesem Abschnitt bauen wir eine Echtzeit-Dokumentintelligenz-App, mit der du ein PDF hochlädst, den Inhalt per DeepSeek OCR-2 extrahierst und Fragen stellen kannst, während die Verarbeitung noch läuft. Statt auf die vollständige OCR zu warten, werden Seiten batchweise durchsuchbar, was die Interaktion deutlich beschleunigt.
Auf hoher Ebene erledigt das System vier Kernaufgaben:
Die Anwendung liefert zwei Hauptausgaben:
Hinweis: Dieses Tutorial baut auf DeepSeeks offiziellem OCR-2 vLLM-Democode auf, inklusive PDF-Rendering-Helfer, Multimodal-Input-Verpackung, OCR-Textbereinigung sowie vLLM-Engine/Sampling-Konfiguration. Zusätzlich ergänze ich eine leichte RAG-Schicht, Mini-Batch-OCR für inkrementelles Indexieren und eine Gradio-App.
Bevor wir DeepSeek OCR-2 mit vLLM ausführen, richten wir die Laufzeitumgebung ein. In diesem Tutorial gehen wir von einer GPU-Umgebung wie Google Colab mit A100 oder T4 aus, da sowohl vLLM als auch DeepSeek OCR-2 für effizientes Inferenzieren CUDA benötigen.
In diesem Schritt werden wir:
So stellen wir sicher, dass der Rest der Pipeline Modell und Hilfsfunktionen ohne Pfad- oder Abhängigkeitsprobleme laden kann.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
Dieser Schritt prüft die GPU-Verfügbarkeit und richtet anschließend den DeepSeek OCR-2 Code lokal ein. Das Skript ermittelt zunächst per nvidia-smi die verfügbare GPU und deren Speicher, um sicherzustellen, dass genügend VRAM für vLLM-Inferenz bereitsteht.
Danach werden die Repository-Pfade definiert und geprüft, ob das benötigte vLLM-Integrationsverzeichnis existiert. Falls nicht, wird das Repository aus einem lokalen ZIP entpackt oder direkt von GitHub geklont.
Im nächsten Schritt installieren wir die benötigten Abhängigkeiten und bereiten die Laufzeit für die vLLM-basierte Inferenz vor.
DeepSeek OCR-2 und vLLM reagieren sensibel auf Versionen. Daher pinnen wir in diesem Schritt einen funktionierenden Satz an Paketen für CUDA 11.8, installieren ein passendes vLLM-Wheel und ergänzen flash-attn für schnellere Attention-Kerne.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
Der obige Code richtet eine kompatible Laufzeit für DeepSeek OCR-2 mit vLLM ein. Außerdem installiert er den Supporting-Stack für die Anwendung, darunter Transformers, Gradio für die UI, PyMuPDF und Pillow für PDF-/Bildverarbeitung sowie SentenceTransformers mit FAISS zum Aufbau des Retrieval-Index.
Nach der Installation werden Umgebungsvariablen für eine stabile vLLM-Ausführung und Triton-Kompatibilität gesetzt. Das vLLM-Integrationsverzeichnis des Repos wird zu sys.path hinzugefügt, damit das benutzerdefinierte DeepSeek OCR-2 Modell und die Preprocessing-Module importiert werden können. Abschließend wird ein leichtgewichtiges Embedding-Modell (all-MiniLM-L6-v2) geladen, um das inkrementelle Seiten-RAG zu unterstützen.
Im nächsten Schritt implementieren wir Preprocessing-Helfer, die ein PDF in Seitenbilder umwandeln, jede Seite in das von DeepSeek OCR-2 erwartete Multimodal-Format packen und die OCR-Ausgaben für das Retrieval bereinigen.
Bevor wir DeepSeek OCR-2 ausführen, benötigen wir ein kleines Set an Utilities, die ein PDF in modelbereite Inputs konvertieren und die rohe OCR-Ausgabe für das Retrieval bereinigen.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
Die obigen Utilities definieren drei zentrale Bausteine:
Wir setzen BATCH_SIZE = 5, um die Balance zwischen schneller erster Antwort und effizienter GPU-Auslastung zu steuern. Bei einem 20-seitigen PDF siehst du Fortschrittsschritte von 0% zu 25% zu 50% zu 75% zu 100% statt eines Sprungs von 0% direkt auf 100%.
So können Nutzer bereits nach den ersten 5 indizierten Seiten Fragen stellen. Kleinere Batches verbessern die Time-to-First-Result, größere Batches erhöhen Durchsatz und GPU-Nutzung.
Wir verwenden die native pdf_to_images_high_quality()-Funktion aus der Original-Implementierung mit PyMuPDF, um jede Seite als PIL-Bild bei 144 DPI zu rendern (aus zoom = 144 / 72.0 = 2.0, verdoppelt die Standardauflösung von 72 DPI).
Die dpi/72-Zoom-Matrix steuert die Rasterqualität, und alpha=False vermeidet Transparenzartefakte. Falls ein Bild dennoch einen Alphakanal enthält, wird es auf einen weißen Hintergrund gelegt, um Mischartefakte zu verhindern, die die OCR-Qualität beeinträchtigen könnten.
Die Funktion process_single_image() (aus dem Original-Code) verpackt jede Seitenabbildung in die von vLLM erwartete Dict-Struktur (prompt + multi_modal_data.image) und nutzt DeepseekOCR2Processor().tokenize_with_images(). Dieser übernimmt die komplette Bildvorverarbeitung, inklusive Aufteilung großer Bilder in 2–6 Kacheln via dynamic_preprocess() je nach Seitenverhältnis, Erstellen einer gepaddeten 1024×1024-Gesamtansicht, Normalisierung und Generierung der vollständigen Token-Sequenz mit Bildmasken für DeepseekOCR2ForCausalLM.
Der Repo-Parameter config.CROP_MODE steuert, ob dieses dynamische Tiling angewendet wird. Das verbessert die Genauigkeit bei dichten Layouts mit kleiner Schrift.
Nach der Generierung entfernt clean_ocr_output() spezielle End-of-Sentence-Tokens, tilgt Erkennungs-Markup-Blöcke (<|ref|>...<|/ref|><|det|>...<|/det|>), normalisiert einige LaTeX-ähnliche Operatoren und reduziert übermäßige Zeilenumbrüche. So entsteht sauberer Text, der sich besser chunken lässt und im nachgelagerten RAG zuverlässiger abgerufen wird.
Als Nächstes nutzen wir diese bereinigte Ausgabe, um einen leichten Seiten-RAG-Index zu bauen, damit Seiten direkt nach jedem Batch durchsuchbar sind.
Jetzt, da wir pro Seite sauberen Text extrahieren, machen wir ihn sofort durchsuchbar. Statt auf die gesamte Dokumentverarbeitung zu warten, bauen wir eine leichte Retrieval-Augmented-Generation-(RAG)-Engine auf Seitenebene, die Inhalte schrittweise indiziert.
Sobald ein Batch verarbeitet ist, werden seine Texte eingebettet und dem FAISS-Index hinzugefügt. So können Nutzer das Dokument abfragen, während die Indizierung noch läuft.
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
Die Klasse oben umfasst vier zentrale Elemente:
faiss.IndexFlatIP für schnelle Ähnlichkeitssuche über normalisierten Embeddings. Jede verarbeitete Seite wird sofort eingebettet und dem Index hinzugefügt, sodass Echtzeit-Retrieval ohne Rebuild möglich ist._split() zerlegt langen Seitentext in ~1000-Zeichen-Chunks entlang von Absatzgrenzen. Das verbessert semantisches Matching, vermeidet zu lange, verrauschte Kontexte und behält zugleich die Seitennummer für Quellenangaben.threading.Lock() Index-Updates und -Reads. query() embeddiert die Nutzerfrage, ruft die Top-k-ähnlichen Chunks ab und liefert Text mit Seitennummern und Scores zurück. Die Property indexed_pages trackt den Fortschritt, damit die UI zeigen kann, wie viele Seiten bereits durchsuchbar sind.In diesem Schritt initialisieren wir die DeepSeek OCR-2 Inferenz-Engine mit vLLM. Das ist die zentrale Komponente für multimodale Generierung: Sie nimmt tokenisierte Seitenbilder und erzeugt strukturierten OCR-Text. Die Konfiguration folgt der offiziellen DeepSeek OCR-2 vLLM-Referenz, wird aber in einen Lazy Loader load_ocr_engine() gepackt, damit das Modell erst beim Start der Verarbeitung lädt. Dadurch verkürzen sich Startzeiten, und unnötige GPU-Belegung wird vermieden.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
Der Code kapselt folgende Kernelemente:
DeepseekOCR2ForCausalLM aus dem Repository in vLLM eingebunden, damit Bild-Token-Inputs aus DeepseekOCR2Processor verarbeitet werden können.LLM() entsprechen den Referenzeinstellungen des Repos, u. a. block_size=256, max_model_len=8192, gpu_memory_utilization=0.9 und disable_mm_preprocessor_cache=True. Diese Settings sind auf stabile, performante OCR-Inferenz bei kalkulierbarer GPU-Nutzung ausgelegt.temperature=0.0, großzügigen Ausgabebeschränkungen und einem NoRepeatNGramLogitsProcessor, um Wiederholungsmuster in langen OCR-Texten zu vermeiden.load_ocr_engine()-Ausführung. Spätere Aufrufe nutzen dieselbe Instanz, vermeiden erneute GPU-Initialisierung und halten die UI reaktionsschnell.Jetzt verbinden wir die Engine mit einer Batch-Verarbeitungsschleife, die Seite für Seite OCR ausführt und die Ergebnisse für das Echtzeit-Retrieval in den RAG-Index streamt.
Dieser Schritt ist das Herz der App. Wir implementieren einen Hintergrund-Worker, der ein hochgeladenes PDF schrittweise in einen durchsuchbaren Index verwandelt, statt auf die komplette OCR zu warten.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
Der Pipeline-Ablauf umfasst Seitenrendering, Input-Preprocessing, vLLM-Inferenz in Mini-Batches, die Bereinigung der OCR-Ausgabe und schließlich das Hinzufügen jeder Seite zu PageRAG (mit FAISS). Die Schritte im Detail:
total_pages, is_processing, processing_error, stop_requested) tracken Fortschritt und Fehlerfälle, damit die UI Status live anzeigt, Stop/Reset ermöglicht und Konflikte zwischen Läufen vermeidet.ThreadPoolExecutor(max_workers=config.NUM_WORKERS) wandelt Seitenbilder parallel in modelbereite Multimodal-Inputs um. So ist die GPU später stets ausgelastet, weil Inputs rechtzeitig vorbereitet sind.ocr_llm.generate() einmal über alle Seiten laufen zu lassen (Standard im offiziellen Skript), berechnet der Code num_batches und verarbeitet Seiten in Blöcken der Größe BATCH_SIZE. Dadurch kann schrittweise indiziert werden, und Nutzer können bereits nach den ersten 5 Seiten (BATCH_SIZE = 5) fragen, statt bis zum Ende zu warten.stop_requested wird vor teuren Schritten und zu Beginn jedes Batches geprüft. Der Stop-Button wirkt damit vorhersehbar: Er hält zwischen Batches an, nach Abschluss des aktuellen Batches, ohne halbfertige Zustände zu hinterlassen.Damit haben wir eine End-to-End-Pipeline, die ein PDF in einen wachsenden Suchindex verwandelt, sodass Nutzer bereits während der Verarbeitung Anfragen stellen können. Als Nächstes verbinden wir diesen Worker per Callbacks mit der Gradio-Anwendung.
Die OCR- und Indexierungspipeline läuft nun im Hintergrund, doch die Anwendung braucht noch eine Steuerschicht, die Nutzeraktionen mit der Verarbeitung verknüpft.
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
Diese Steuerschicht übernimmt fünf zentrale Aufgaben:
start_processing() prüft die Eingabe, setzt den RAG-Index zurück und startet process_pdf_background() in einem Daemon-Thread. stop_processing() setzt ein Flag stop_requested, anstatt sofort abzubrechen. Der Worker prüft es zwischen den Batches und stoppt so konsistent, ohne den Index zu beschädigen.reset_all() werden FAISS-Index, Fortschrittszähler und Fehlerstatus gelöscht. Während der Verarbeitung ist ein Reset gesperrt, um Inkonsistenzen zu vermeiden.refresh_progress() liest die Zahl indizierter Seiten aus PageRAG und erzeugt eine dynamische HTML-Fortschrittsanzeige. Sie kommuniziert Zustände wie Laden, Aktiv, Stoppen, Fertig oder Fehler.Im letzten Schritt verbinden wir diese Callbacks mit einer Gradio-Oberfläche und stellen den kompletten Workflow über eine schlanke Web-UI bereit.
Zum Abschluss packen wir alles in eine einfache Gradio-App. Die UI erlaubt es, ein PDF hochzuladen, die Verarbeitung zu starten und schon vor Abschluss der Indizierung Fragen zu stellen.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
Die Gradio-App besteht aus zwei Spalten. Links findest du den PDF-Upload und die Buttons Process/Stop/Reset, rechts eine Live-HTML-Fortschrittsanzeige. So bleibt die App responsiv, auch wenn die OCR noch läuft. Wichtige Merkmale:
gr.Timer(2) ruft alle zwei Sekunden refresh_progress() auf und aktualisiert das Fortschritts-HTML. Da in Batches indiziert wird, bewegt sich der Balken in Stufen, und die Meldungen passen sich Status wie Laden, Stoppen, Fehler oder Abschluss an..click()-Handler verbinden UI-Aktionen direkt mit den Backend-Funktionen: start_processing() startet den Worker, stop_processing() fordert einen sauberen Stopp an, reset_all() setzt den Zustand zurück, und answer_question() sucht über die bisher indizierten Seiten.Zum Schluss startet demo.launch() die App in Colab, liefert einen teilbaren Link, rendert inline und aktiviert Debug-Logs zur Fehlersuche während der Entwicklung.
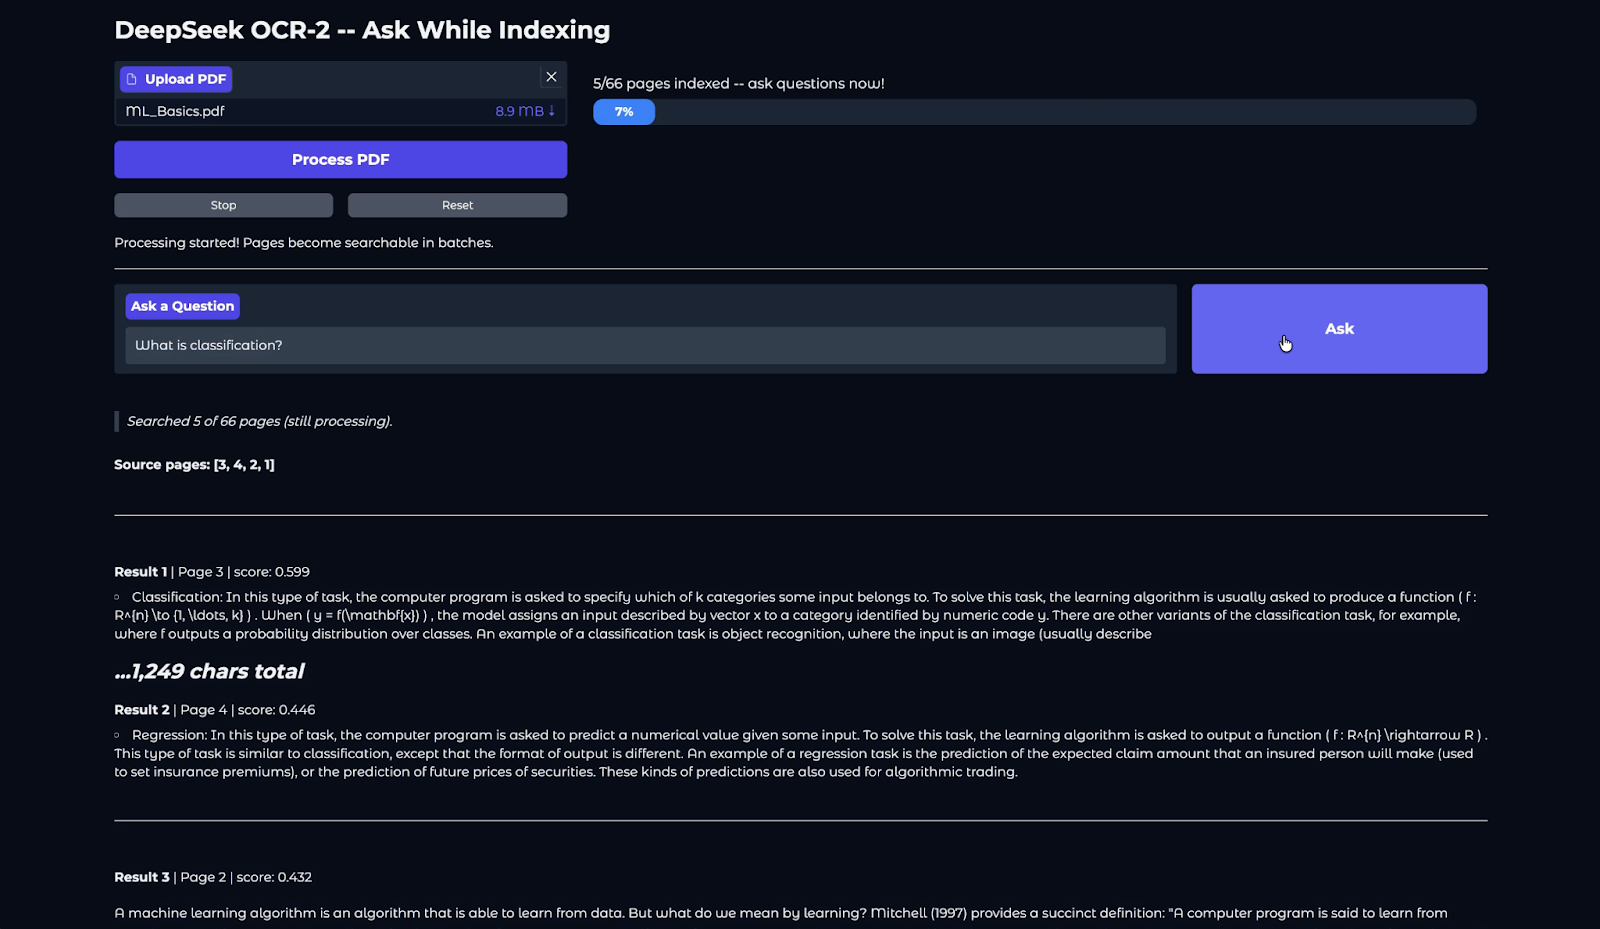
In diesem Tutorial haben wir eine vollständige, visuell geführte Dokumentintelligenz-Pipeline mit DeepSeek OCR-2 gebaut. Ausgehend von einem Roh-PDF haben wir Seiten in hochwertige Bilder gerendert, multimodale OCR über vLLM ausgeführt, den Text bereinigt und strukturiert und ihn schrittweise in einen FAISS-basierten RAG-Store indiziert.
Durch die Verarbeitung in Mini-Batches ermöglicht die Anwendung ein „Ask While Indexing“-Erlebnis: Nutzer können nach dem ersten Batch fragen, statt auf den vollständigen Abschluss zu warten.
Beim Testen zeigten sich zwei spürbare Limitierungen. Formellastige Bereiche werden nicht immer korrekt transkribiert – ein bekanntes Problem von Vision-Language-OCR-Modellen, selbst mit Grounding-Prompts.
Zudem zeigen manche längeren Seiten repetitive Ausgabemuster. Die offizielle Pipeline entschärft dies mit NoRepeatNGramLogitsProcessor (ngram_size=20), doch dichte Tabellen und mehrspaltige Layouts können weiterhin Generationsschleifen auslösen; in diesen Fällen wird die Seite über das Flag SKIP_REPEAT stillschweigend übersprungen.
Wer weitergehen möchte, kann eine leichte LLM-Schicht ergänzen (z. B. Aufruf der Anthropic- oder OpenAI-API), um abgerufene Chunks zu summarizen, statt Rohtext auszugeben.
Weitere sinnvolle Verbesserungen: Den FAISS-Index auf Disk persistieren und über Sessions hinweg wiederverwenden, mehrere PDFs in einem Index unterstützen, Parameter wie BATCH_SIZE und top_k direkt in der Gradio-UI einstellbar machen oder strukturbewusstes Chunking (Überschriften, Tabellen, Abschnittsgrenzen) hinzufügen, um die Retrieval-Genauigkeit zu erhöhen.
Top DataCamp Courses
Kurs
Kurs
Kurs