
Cours
Working with DeepSeek in Python
3 h
1.3K
DeepSeek-OCR 2 est un modèle vision-langage de lecture de documents de bout en bout avec OCR, conçu pour gérer des mises en page complexes (pages multi-colonnes, formulaires, tableaux, formules) en apprenant un meilleur ordre de lecture plutôt qu’en aplatissant des patchs d’image dans un balayage fixe de haut gauche à bas droite.
L’idée centrale est le Visual Causal Flow : le modèle tente d’imiter la lecture humaine, de façon progressive et sémantique, plutôt que de traiter la page comme une grille uniforme. Côté architecture, DeepSeek-OCR 2 conserve le cadre encodeur–décodeur de DeepSeek-OCR, mais met à niveau l’encodeur vers DeepEncoder V2, qui introduit un mécanisme causal de réordonnancement des tokens avant la génération de texte par le décodeur.
À haut niveau, DeepSeek OCR-2 convertit un document en texte via une chaîne vision-langage qui apprend l’ordre de lecture au lieu de s’appuyer sur un tri par coordonnées fixes. Cela inclut :
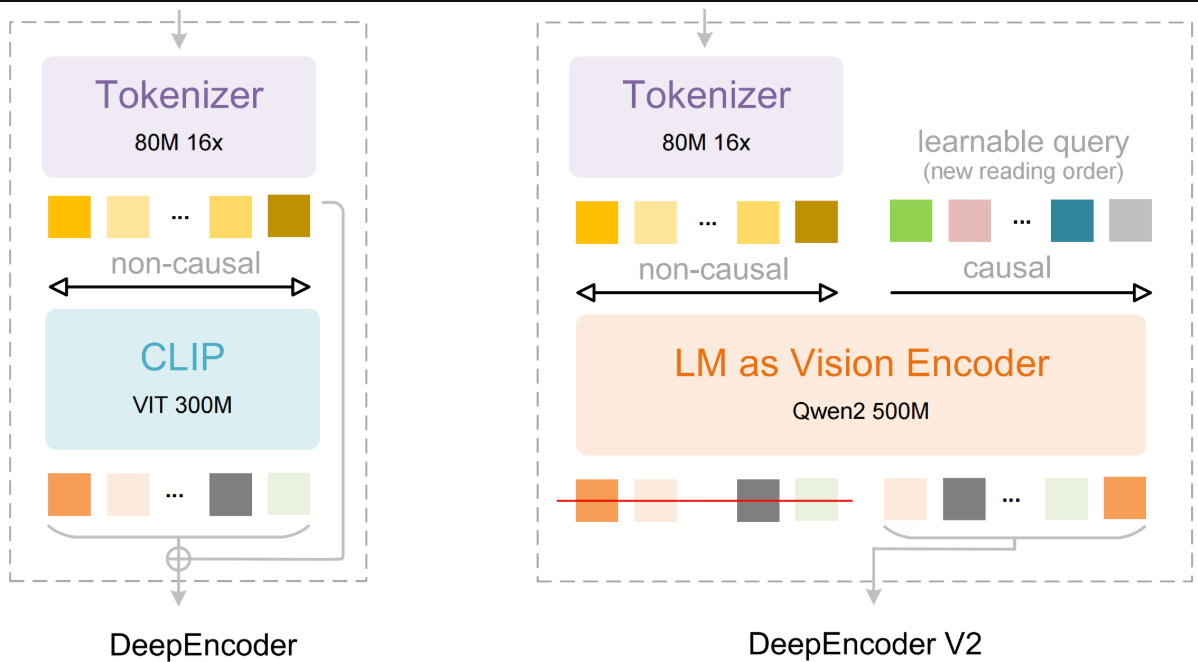
Figure : DeepSeek-OCR 2 : Visual Causal Flow
Vous pouvez consulter le dépôt GitHub DeepSeek OCR-2 pour explorer le code en détail.
Dans cette section, nous allons créer une application de veille documentaire en temps réel qui vous permet de téléverser un PDF, d’en extraire le contenu avec DeepSeek OCR-2 et de commencer à poser des questions pendant que le document est encore en cours de traitement. Plutôt que d’attendre la fin de l’OCR, les pages deviennent interrogeables lot par lot, pour une expérience plus rapide et interactive.
À haut niveau, le système effectue quatre tâches principales :
L’application produit deux résultats principaux :
Remarque : ce tutoriel s’appuie sur le code de démo officiel OCR-2 vLLM de DeepSeek, incluant l’aide au rendu PDF, l’emballage des entrées multimodales, le nettoyage du texte OCR et la configuration moteur/échantillonnage vLLM. Par-dessus, j’ajoute une fine couche RAG, un traitement OCR en mini-lots pour permettre l’indexation incrémentale, et une application Gradio.
Avant d’exécuter DeepSeek OCR-2 avec vLLM, nous devons nous assurer que l’environnement d’exécution est prêt. Dans ce tutoriel, nous supposons un environnement avec GPU, comme Google Colab avec une A100 ou une T4, car vLLM et DeepSeek OCR-2 nécessitent CUDA pour une inférence efficace.
Dans cette étape, nous allons :
Ainsi, le reste du pipeline peut charger le modèle et ses utilitaires sans problèmes de chemin ou de dépendances.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
Cette étape vérifie la présence d’un GPU puis prépare localement la base de code DeepSeek OCR-2. Le script ci-dessus contrôle d’abord le GPU et la mémoire avec nvidia-smi pour s’assurer que l’environnement dispose de suffisamment de VRAM pour l’inférence vLLM.
Il définit ensuite les chemins du dépôt et vérifie l’existence du répertoire d’intégration vLLM requis. À défaut, il extrait le dépôt depuis un ZIP local ou clone le dépôt officiel DeepSeek OCR-2 depuis GitHub.
À l’étape suivante, nous installerons les dépendances nécessaires et préparerons l’exécution pour l’inférence avec vLLM.
DeepSeek OCR-2 et vLLM sont très sensibles aux versions ; dans cette étape, nous figeons un ensemble de paquets compatible avec CUDA 11.8, installons une roue vLLM correspondante et ajoutons flash-attn pour des kernels d’attention plus rapides.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
Le code ci-dessus installe un environnement compatible pour DeepSeek OCR-2 avec vLLM. Il installe également la pile de support de l’application, incluant Transformers, Gradio pour l’interface, PyMuPDF et Pillow pour le traitement PDF/image, ainsi que SentenceTransformers avec FAISS pour construire l’index de recherche.
Après l’installation, des variables d’environnement sont configurées pour une exécution vLLM stable et la compatibilité Triton. Le répertoire d’intégration vLLM du dépôt est ajouté à sys.path pour importer le modèle DeepSeek OCR-2 et les modules de prétraitement, puis un modèle d’embedding léger (all-MiniLM-L6-v2) est chargé pour l’indexation RAG incrémentale au niveau des pages.
À l’étape suivante, nous implémenterons des utilitaires de prétraitement pour convertir un PDF en images de pages, empaqueter chaque page dans le format d’entrée multimodal attendu par DeepSeek OCR-2 et nettoyer les sorties OCR pour la recherche.
Avant d’exécuter DeepSeek OCR-2, nous avons besoin d’un petit ensemble d’utilitaires qui convertissent un PDF en entrées prêtes pour le modèle et nettoient la sortie OCR brute pour la recherche.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
Les utilitaires ci-dessus définissent trois composants clés :
Nous définissons BATCH_SIZE = 5 pour équilibrer rapidité d’apparition des premiers résultats et efficacité d’utilisation du GPU. Pour un PDF de 20 pages, la progression s’affiche par paliers : 0 % → 25 % → 50 % → 75 % → 100 %, plutôt que de passer de 0 % à 100 % d’un coup.
Ainsi, les utilisateurs peuvent commencer à poser des questions dès que les 5 premières pages sont indexées. Des lots plus petits réduisent le temps jusqu’au premier résultat, tandis que des lots plus grands améliorent le débit et l’utilisation du GPU.
Nous utilisons le code natif de la fonction pdf_to_images_high_quality() de l’implémentation originale avec PyMuPDF pour rendre chaque page en image PIL à 144 DPI (issu de zoom = 144 / 72.0 = 2.0, qui double la résolution par défaut de 72 DPI).
La matrice de zoom dpi/72 contrôle la qualité de rastérisation, et alpha=False évite les artefacts de transparence. Si une image contient encore un canal alpha, la fonction l’aplatit sur fond blanc pour éviter des mélanges visuels pouvant dégrader l’OCR.
La fonction process_single_image() (issue du code source original) encapsule chaque image de page dans la structure exacte attendue par vLLM (prompt + multi_modal_data.image), via DeepseekOCR2Processor().tokenize_with_images() qui gère l’ensemble du pipeline de prétraitement, y compris le découpage des grandes images en 2–6 tuiles via dynamic_preprocess() selon le ratio, la création d’une vue globale 1024×1024 avec padding, la normalisation tensorielle et la génération de la séquence complète de tokens avec masques d’image consommée par DeepseekOCR2ForCausalLM.
Le config.CROP_MODE du dépôt contrôle l’application de ce carrelage dynamique, ce qui améliore la précision sur des mises en page denses avec petit texte.
Après génération, clean_ocr_output() supprime des tokens spéciaux de fin de phrase, retire les blocs de balisage de détection (<|ref|>...<|/ref|><|det|>...<|/det|>), normalise quelques opérateurs de type LaTeX et réduit les sauts de ligne en excès, produisant un texte plus propre, mieux découpable et plus fiable pour l’index RAG en aval.
Ensuite, nous utiliserons cette sortie nettoyée pour construire un index RAG léger au niveau des pages, afin que celles-ci deviennent interrogeables immédiatement après chaque lot.
Maintenant que nous pouvons extraire un texte propre de chaque page, l’étape suivante consiste à le rendre immédiatement interrogeable. Au lieu d’attendre la fin du traitement du document, nous construisons un moteur RAG (Retrieval-Augmented Generation) léger au niveau des pages, qui indexe le contenu de manière incrémentale.
À mesure que chaque lot de pages est traité, leur texte est vectorisé et ajouté à un index FAISS, permettant aux utilisateurs d’interroger le document alors même que l’indexation est en cours.
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
La classe ci-dessus définit quatre composants clés :
faiss.IndexFlatIP pour une recherche de similarité rapide sur des embeddings normalisés. À mesure que chaque page est traitée, son contenu est immédiatement vectorisé et ajouté à l’index, permettant une recherche en temps réel sans reconstruire l’index._split() segmente les longs textes de page en morceaux d’environ 1 000 caractères en se basant sur les séparations de paragraphes. Cela améliore la correspondance sémantique et évite d’indexer des contextes trop longs et bruités, tout en conservant le numéro de page pour l’attribution des sources.threading.Lock() protège les mises à jour et lectures de l’index. query() vectorise la question de l’utilisateur, récupère les top-k morceaux similaires et renvoie le texte correspondant avec les numéros de page et les scores de similarité. La propriété indexed_pages suit la progression afin que l’interface affiche combien de pages sont déjà interrogeables.Ici, nous initialisons le moteur d’inférence DeepSeek OCR-2 avec vLLM. C’est le composant central qui réalise la génération multimodale : il prend les images de page tokenisées et produit un texte OCR structuré. La configuration suit la référence vLLM officielle de DeepSeek OCR-2, mais nous l’encapsulons dans un chargeur paresseux load_ocr_engine() pour ne charger le modèle qu’au démarrage du traitement, ce qui réduit le temps d’initialisation et évite une allocation GPU inutile.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
Ce code définit les éléments suivants :
DeepseekOCR2ForCausalLM du dépôt à vLLM afin de gérer les entrées image-token produites par DeepseekOCR2Processor.LLM() correspondent aux réglages de référence du dépôt, notamment block_size=256, max_model_len=8192, gpu_memory_utilization=0.9 et disable_mm_preprocessor_cache=True. Ces réglages sont adaptés pour une inférence OCR à haut débit et stable, avec une utilisation mémoire GPU prévisible.temperature=0.0, limites de sortie élevées et NoRepeatNGramLogitsProcessor pour éviter les répétitions, problème fréquent en génération OCR longue.load_ocr_engine(). Les appels suivants réutilisent la même instance, évitant les ré-initialisations GPU et gardant l’interface réactive.Connectons maintenant ce moteur à une boucle de traitement par lots qui exécute l’OCR page par page et alimente en continu l’index RAG pour des requêtes en temps réel.
C’est le cœur de l’application. Nous implémentons un travailleur en arrière-plan qui prend un PDF téléversé et le transforme progressivement en index interrogeable, au lieu d’attendre la fin complète de l’OCR.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
Le flux du pipeline inclut le rendu des pages, le prétraitement des entrées, l’inférence vLLM en mini-lots, le nettoyage de la sortie OCR, puis l’ajout de chaque page au PageRAG adossé à FAISS. Voici une analyse détaillée de chaque étape :
total_pages, is_processing, processing_error, stop_requested) suivent la progression et les modes de défaillance pour que l’interface affiche l’état en direct, gère l’arrêt/réinitialisation et évite les exécutions concurrentes.ThreadPoolExecutor(max_workers=config.NUM_WORKERS) convertit en parallèle les images de pages en entrées multimodales prêtes pour le modèle. Cela maintient le GPU occupé ensuite en garantissant des entrées préparées avant l’inférence.ocr_llm.generate() une seule fois sur toutes les pages (comportement par défaut du script officiel), le code calcule num_batches et traite les pages par blocs de BATCH_SIZE. Cela permet une indexation progressive ; les utilisateurs peuvent démarrer les questions après les 5 premières pages indexées (BATCH_SIZE = 5), plutôt que d’attendre la fin du document.stop_requested est vérifié avant les étapes coûteuses et au début de chaque lot. Le bouton Stop est ainsi prévisible : il s’arrête entre les lots, après la fin du lot courant, évitant des états partiellement écrits ou des sorties incomplètes.À ce stade, nous avons un pipeline de bout en bout qui convertit un PDF en un index de recherche croissant, permettant d’interroger le document pendant que le traitement se poursuit en arrière-plan. Ajoutons maintenant les callbacks d’interface qui connectent ce travailleur à l’application Gradio.
À ce stade, le pipeline d’OCR et d’indexation tourne en arrière-plan, mais l’application a encore besoin d’une couche de contrôle reliant les actions utilisateur à la logique de traitement.
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
Cette couche de contrôle gère cinq responsabilités essentielles :
start_processing() valide l’entrée, réinitialise l’index RAG et lance process_pdf_background() dans un thread daemon. stop_processing() définit un indicateur stop_requested au lieu d’arrêter immédiatement. Le travailleur d’arrière-plan vérifie ce drapeau entre les lots pour un arrêt propre sans corrompre l’index.reset_all() vide l’index FAISS, les compteurs de progression et l’état d’erreur. Il empêche aussi les réinitialisations accidentelles pendant le traitement, pour éviter un état incohérent.refresh_progress() pour lire le nombre de pages indexées depuis PageRAG et générer une barre de progression HTML dynamique. Elle communique aussi les états système : chargement, traitement actif, arrêt, achèvement ou erreur.Dans la dernière étape, nous relierons ces callbacks à une interface Gradio pour exposer tout le flux via une interface web simple.
Dans cette étape finale, nous empaquetons tout dans une application Gradio simple. L’interface permet aux utilisateurs de téléverser un PDF, de démarrer le traitement et de poser des questions avant la fin de l’indexation.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
L’application Gradio comporte deux colonnes. À gauche : le widget d’envoi de PDF et les boutons Process/Stop/Reset ; à droite : une barre de progression HTML en direct. L’application reste ainsi réactive même pendant l’OCR. Principales fonctionnalités :
gr.Timer(2) appelle refresh_progress() toutes les deux secondes et met à jour la barre. Comme l’indexation se fait par lots, la progression avance par paliers (et les messages changent selon les états : chargement, arrêt, erreur, fin)..click() relient les actions de l’interface aux fonctions backend : start_processing() lance le travailleur, stop_processing() demande un arrêt propre, reset_all() réinitialise l’état, et answer_question() effectue la recherche sur les pages déjà indexées.Enfin, demo.launch() lance l’application dans Colab, fournit un lien partageable, l’affiche en ligne et active les journaux de debug pour diagnostiquer les problèmes durant le développement.
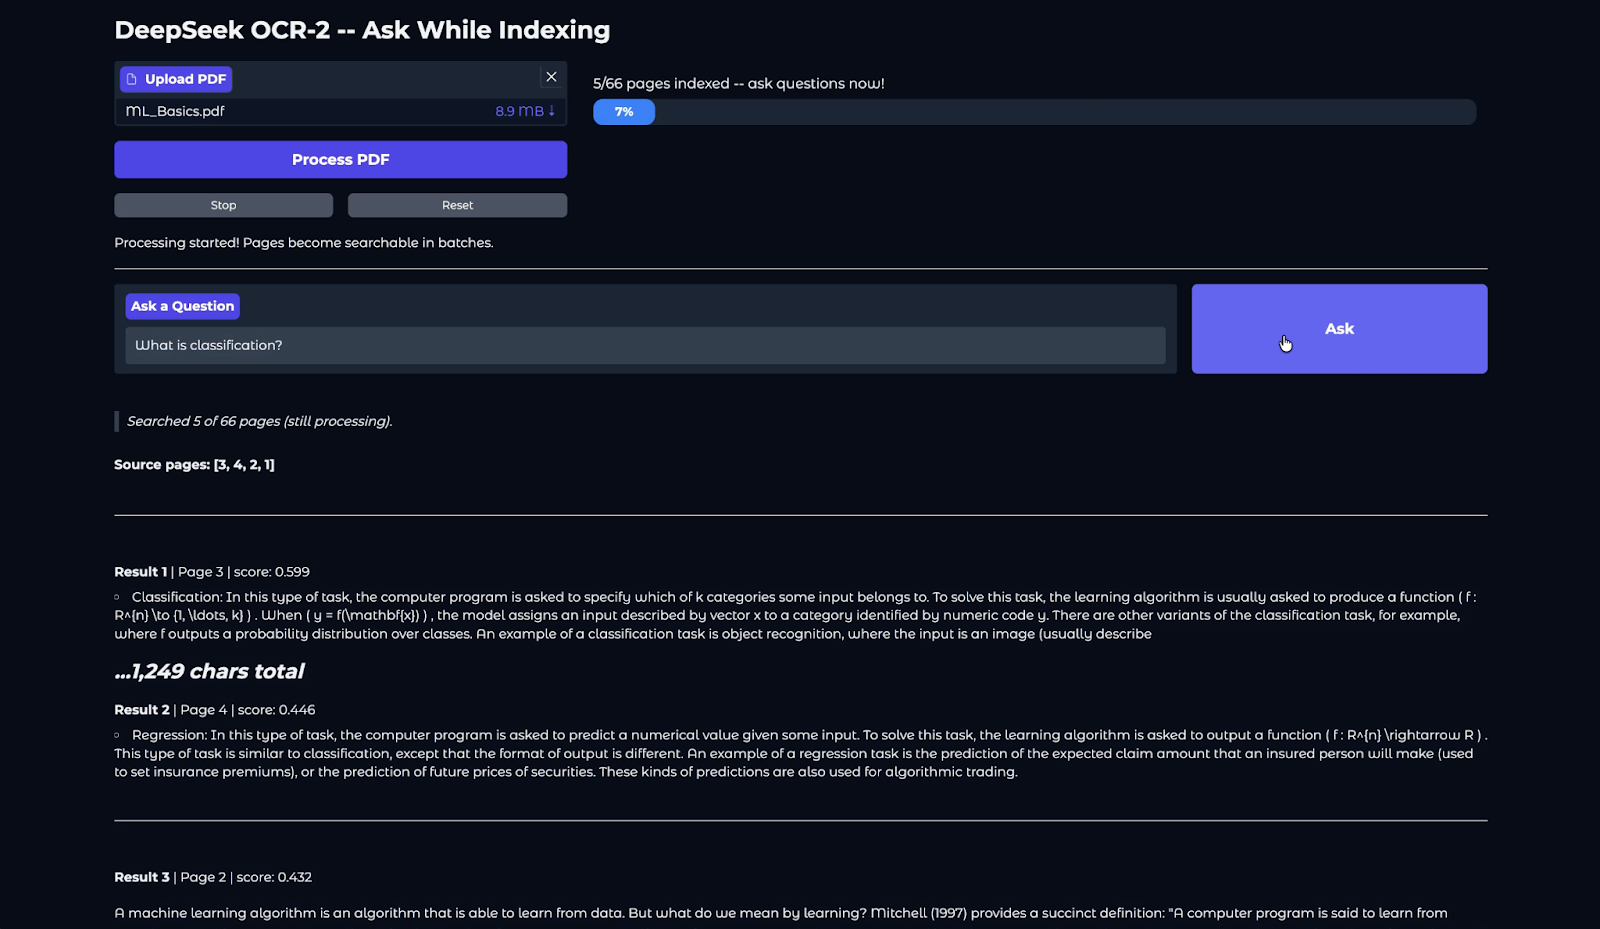
Dans ce tutoriel, nous avons construit un pipeline complet de veille documentaire orientée vision avec DeepSeek OCR-2. À partir d’un PDF brut, nous avons rendu les pages en images haute qualité, exécuté l’OCR multimodal via vLLM, nettoyé et structuré le texte extrait, puis l’avons indexé de manière incrémentale dans un magasin RAG basé sur FAISS.
En traitant les pages en mini-lots, l’application permet une expérience « poser en indexant », où l’on peut interroger le document après le premier lot au lieu d’attendre la fin complète.
Deux limites notables sont toutefois apparues pendant les tests. Les zones riches en formules ne sont pas toujours transcrites avec précision, ce qui reste un défi pour les modèles OCR vision-langage, même avec des prompts d’ancrage.
De plus, certaines pages longues présentent des motifs de répétition. Le pipeline officiel atténue cela via NoRepeatNGramLogitsProcessor (ngram_size=20), mais les tableaux denses et les mises en page multi-colonnes peuvent encore déclencher des boucles de génération ; dans ce cas, la page est ignorée silencieusement via le drapeau SKIP_REPEAT.
Pour aller plus loin, vous pouvez expérimenter l’ajout d’une fine couche LLM (par exemple via l’API Anthropic ou OpenAI) pour résumer les extraits récupérés au lieu de renvoyer des snippets bruts.
Autres améliorations pratiques : persister l’index FAISS sur disque pour le réutiliser entre sessions, prendre en charge plusieurs PDF dans un même index, exposer des paramètres ajustables comme BATCH_SIZE et top_k directement dans l’interface Gradio, ou ajouter un découpage sensible à la structure (titres, tableaux, limites de sections) pour améliorer la précision de la recherche.
Top DataCamp Courses
Cours
Cours
Cours