

DeepSeek OCR 2 là gì?
DeepSeek-OCR 2 là mô hình thị giác-ngôn ngữ OCR kiêm đọc tài liệu đầu-cuối, được thiết kế để xử lý bố cục phức tạp (trang nhiều cột, biểu mẫu, bảng, công thức) bằng cách học thứ tự đọc tốt hơn thay vì làm phẳng các mảnh ảnh theo quy tắc quét raster cố định từ trên-trái xuống dưới-phải.
Ý tưởng cốt lõi là Dòng nhân quả trực quan (Visual Causal Flow), tức mô hình cố gắng mô phỏng cách con người đọc tài liệu, tuần tự và theo ngữ nghĩa, thay vì coi trang như một lưới đồng nhất. Về kiến trúc, DeepSeek-OCR 2 giữ khung mã hoá–giải mã như DeepSeek-OCR, nhưng nâng cấp bộ mã hoá lên DeepEncoder V2, đưa cơ chế sắp xếp lại token nhân quả trước khi bộ giải mã sinh văn bản.
DeepSeek OCR-2 hoạt động như thế nào?
Ở mức cao, DeepSeek OCR-2 chuyển đổi tài liệu thành văn bản qua một pipeline thị giác-ngôn ngữ học thứ tự đọc thay vì dựa vào sắp xếp theo toạ độ cố định. Bao gồm:
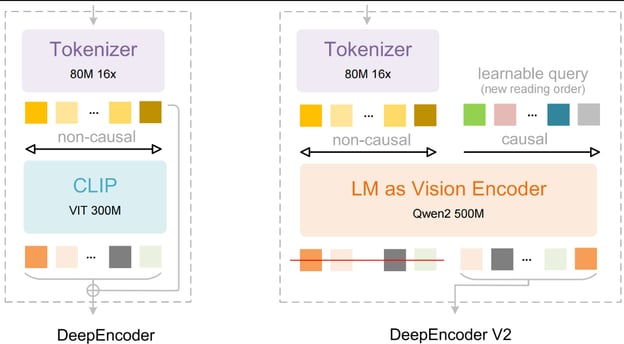
Hình: DeepSeek-OCR 2: Visual Causal Flow
- Mã hoá trang đa tỉ lệ: Mỗi trang PDF được kết xuất thành một ảnh toàn cục và một phần cắt cục bộ độ phân giải cao tuỳ chọn. Những ảnh này được chuyển thành các token mảnh thị giác, cho phép mô hình nắm bắt cả bố cục tổng thể (phần, cột) lẫn chi tiết nhỏ như chữ nhỏ, bảng và công thức.
- Hiểu bố cục với attention hai chiều: Các token thị giác trước tiên được xử lý với attention không nhân quả (hai chiều) trong DeepEncoder V2, giúp mô hình hiểu quan hệ không gian như cấu trúc cột, ranh giới bảng và nhóm vùng.
- Visual Causal Flow (thứ tự đọc được học): Bộ mã hoá nối thêm các token truy vấn nhân quả có thể học, lần lượt chú ý tới đặc trưng thị giác và các truy vấn trước đó. Cơ chế này trích xuất nội dung theo một thứ tự đọc được học, giúp mô hình bền vững với trang nhiều cột, biểu mẫu và bố cục phức tạp.
- Sinh văn bản: Biểu diễn thị giác đã sắp thứ tự được chuyển cho bộ giải mã ngôn ngữ, bộ này sinh văn bản tài liệu theo kiểu tự hồi quy theo đúng thứ tự logic.
- Hiểu tài liệu đầu-cuối: Khác với pipeline OCR truyền thống, DeepSeek OCR-2 thực hiện hiểu bố cục và ghi biên âm đồng thời, tạo ra văn bản sạch hơn và cấu trúc đáng tin cậy hơn cho các tác vụ hạ nguồn như tìm kiếm, tóm tắt và RAG.
Bạn có thể tham khảo kho GitHub DeepSeek OCR-2 để khám phá mã chi tiết.
Hướng dẫn DeepSeek OCR-2: Xây dựng ứng dụng Hỏi-Trong-Khi-Đánh-Mục lục PDF Hỏi & Đáp
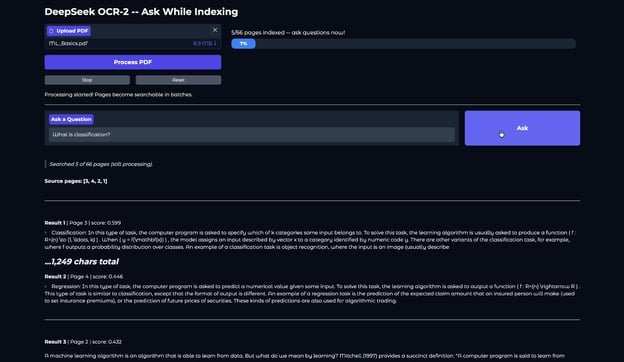
Trong phần này, chúng ta sẽ xây dựng ứng dụng thông minh tài liệu thời gian thực cho phép bạn tải lên PDF, trích xuất nội dung bằng DeepSeek OCR-2 và bắt đầu đặt câu hỏi trong khi tài liệu vẫn đang được xử lý. Thay vì đợi OCR hoàn tất, các trang trở nên có thể tìm kiếm theo từng lô, mang lại trải nghiệm nhanh và tương tác hơn nhiều.
Ở mức cao, hệ thống thực hiện bốn tác vụ cốt lõi:
- Chuyển mỗi trang PDF thành ảnh chất lượng cao
- Chạy DeepSeek OCR-2 qua vLLM để trích xuất văn bản có cấu trúc
- Đánh mục lục tăng dần nội dung trích xuất bằng FAISS và đường ống RAG dựa trên embedding
- Cho phép người dùng truy vấn tài liệu theo thời gian thực khi các trang được đánh mục lục
Ứng dụng tạo ra hai đầu ra chính:
- Nội dung tài liệu có thể tìm kiếm với truy xuất cấp độ trang
- Câu trả lời có đối chiếu nguồn, hiển thị số trang liên quan và đoạn trích văn bản
Lưu ý: Hướng dẫn này xây dựng trên mã demo vLLM OCR-2 chính thức của DeepSeek, bao gồm tiện ích kết xuất PDF, đóng gói đầu vào đa phương thức, làm sạch văn bản OCR và cấu hình động cơ/sampling của vLLM. Trên cơ sở đó, tôi bổ sung lớp RAG gọn nhẹ, xử lý OCR theo lô nhỏ để hỗ trợ đánh mục lục tăng dần, và ứng dụng Gradio.
Bước 1: Thiết lập môi trường
Trước khi chạy DeepSeek OCR-2 với vLLM, chúng ta cần đảm bảo môi trường chạy đã sẵn sàng. Trong hướng dẫn này, ta giả định môi trường có GPU như Google Colab với A100 hoặc T4, vì cả vLLM và DeepSeek OCR-2 đều cần CUDA để suy luận hiệu quả.
Ở bước này, chúng ta sẽ:
- Xác minh GPU khả dụng và kiểm tra yêu cầu bộ nhớ
- Clone repository DeepSeek OCR-2
- Xác nhận thư mục tích hợp vLLM tồn tại
Điều này đảm bảo phần còn lại của pipeline có thể tải mô hình và tiện ích hỗ trợ mà không gặp vấn đề về đường dẫn hoặc phụ thuộc.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
zip_candidates = [
'/content/DeepSeek-OCR-2-main.zip',
]
found_zip = None
for zp in zip_candidates:
if os.path.isfile(zp):
found_zip = zp
break
if found_zip:
!unzip -qo {found_zip} -d /content/
print(f'Extracted {found_zip}')
else:
!git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')Bước này xác minh có GPU và sau đó chuẩn bị mã nguồn DeepSeek OCR-2 cục bộ. Đoạn script trên trước hết kiểm tra GPU và bộ nhớ sẵn có bằng nvidia-smi để đảm bảo môi trường có đủ VRAM cho suy luận vLLM.
Tiếp theo, nó định nghĩa các đường dẫn repository và kiểm tra xem thư mục tích hợp vLLM cần thiết đã tồn tại chưa. Nếu chưa, nó sẽ giải nén repository từ ZIP cục bộ hoặc clone repository DeepSeek OCR-2 chính thức từ GitHub.
Ở bước tiếp theo, chúng ta sẽ cài đặt các phụ thuộc cần thiết và chuẩn bị runtime cho suy luận dựa trên vLLM.
Bước 2: Cài đặt phụ thuộc
DeepSeek OCR-2 và vLLM rất nhạy về phiên bản, nên ở bước này, chúng ta cố định bộ gói hoạt động tốt cho CUDA 11.8, cài đặt bánh vLLM tương ứng, và thêm flash-attn cho nhân attention nhanh hơn.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
--index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')Đoạn mã trên cài đặt runtime tương thích cho DeepSeek OCR-2 với vLLM. Nó cũng cài đặt ngăn xếp hỗ trợ cho ứng dụng, bao gồm Transformers, Gradio cho giao diện, PyMuPDF và Pillow để xử lý PDF/ảnh, và SentenceTransformers với FAISS để xây dựng chỉ mục truy xuất.
Sau khi cài đặt, biến môi trường được cấu hình cho vận hành vLLM ổn định và tương thích Triton. Tích hợp vLLM trong repository được thêm vào sys.path để có thể import mô hình DeepSeek OCR-2 tuỳ chỉnh và các mô-đun tiền xử lý, và cuối cùng, một mô hình embedding gọn nhẹ (all-MiniLM-L6-v2) được tải để hỗ trợ đánh mục lục RAG cấp trang theo từng phần.
Ở bước tiếp theo, chúng ta sẽ triển khai các tiện ích tiền xử lý để chuyển PDF thành ảnh trang, đóng gói mỗi trang vào định dạng đầu vào đa phương thức mà DeepSeek OCR-2 mong đợi, và làm sạch đầu ra OCR cho truy xuất.
Bước 3: Tiện ích tiền xử lý
Trước khi có thể chạy DeepSeek OCR-2, chúng ta cần một tập nhỏ tiện ích tiền xử lý để chuyển một PDF thành đầu vào sẵn sàng cho mô hình và làm sạch đầu ra OCR thô cho truy xuất.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
images = []
pdf_document = fitz.open(pdf_path)
zoom = dpi / 72.0
matrix = fitz.Matrix(zoom, zoom)
for page_num in range(pdf_document.page_count):
page = pdf_document[page_num]
pixmap = page.get_pixmap(matrix=matrix, alpha=False)
Image.MAX_IMAGE_PIXELS = None
if image_format.upper() == 'PNG':
img_data = pixmap.tobytes('png')
img = Image.open(io.BytesIO(img_data))
else:
img_data = pixmap.tobytes('png')
img = Image.open(io.BytesIO(img_data))
if img.mode in ('RGBA', 'LA'):
background = Image.new('RGB', img.size, (255, 255, 255))
background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
img = background
images.append(img)
pdf_document.close()
return images
def process_single_image(image, prompt_str):
return {
'prompt': prompt_str,
'multi_modal_data': {
'image': DeepseekOCR2Processor().tokenize_with_images(
images=[image], bos=True, eos=True, cropping=config.CROP_MODE
)
},
}
def clean_ocr_output(content):
if '<|end▁of▁sentence|>' in content:
content = content.replace('<|end▁of▁sentence|>', '')
else:
if config.SKIP_REPEAT:
return ''
content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
return content.strip()Các tiện ích trên định nghĩa ba thành phần chính:
Lập lô để tìm kiếm tăng dần (hành vi “hỏi trong khi đánh mục lục”)
Chúng ta đặt BATCH_SIZE = 5 để điều tiết tốc độ có kết quả đầu tiên so với mức sử dụng GPU hiệu quả. Với PDF 20 trang, tiến độ cập nhật theo bước từ 0% đến 25% đến 50% đến 75% đến 100%, thay vì nhảy thẳng từ 0% lên 100%.
Điều này cho phép người dùng bắt đầu đặt câu hỏi ngay khi 5 trang đầu tiên được đánh mục lục. Lô nhỏ giảm thời gian đến kết quả đầu tiên, trong khi lô lớn cải thiện thông lượng và sử dụng GPU.
Kết xuất PDF chất lượng cao thành ảnh
Chúng ta dùng mã gốc của hàm pdf_to_images_high_quality() từ hiện thực ban đầu sử dụng thư viện PyMuPDF để kết xuất mỗi trang thành ảnh PIL ở 144 DPI (xuất phát từ zoom = 144 / 72.0 = 2.0, tức gấp đôi độ phân giải mặc định 72 DPI).
Ma trận thu phóng dpi/72 điều khiển chất lượng raster hoá, và alpha=False tránh tạo tạo tác trong suốt. Nếu ảnh vẫn có kênh alpha, hàm sẽ làm phẳng lên nền trắng để tránh pha trộn lạ gây giảm chất lượng OCR.
Đầu vào đa phương thức
Hàm process_single_image() (từ codebase gốc) bọc mỗi ảnh trang vào đúng cấu trúc dict mà vLLM mong đợi (prompt + multi_modal_data.image), dùng DeepseekOCR2Processor().tokenize_with_images() xử lý toàn bộ pipeline tiền xử lý ảnh gồm chia ảnh lớn thành 2–6 ô bằng dynamic_preprocess() dựa trên tỉ lệ khung, tạo ảnh toàn cục có đệm 1024×1024, chuẩn hoá tensor, và tạo chuỗi token đầy đủ kèm mặt nạ ảnh mà DeepseekOCR2ForCausalLM tiêu thụ.
Làm sạch OCR
Tham số config.CROP_MODE của repo điều khiển liệu có áp dụng chia ô động này hay không, giúp cải thiện độ chính xác trên bố cục dày đặc có chữ nhỏ.
Sau khi sinh, clean_ocr_output() loại các token kết câu đặc biệt, gỡ bỏ các khối đánh dấu phát hiện (<|ref|>...<|/ref|><|det|>...<|/det|>), chuẩn hoá một số toán tử dạng LaTeX, và rút gọn dòng trống dư thừa, tạo văn bản sạch hơn, dễ chia khúc và truy xuất tin cậy hơn trong chỉ mục RAG hạ nguồn.
Tiếp theo, chúng ta sẽ dùng đầu ra đã làm sạch này để xây dựng chỉ mục RAG gọn nhẹ cấp trang, giúp các trang có thể tìm kiếm ngay sau mỗi lô hoàn tất.
Bước 4: Động cơ RAG
Giờ đây chúng ta có thể trích xuất văn bản sạch từ mỗi trang, bước tiếp theo là giúp nó có thể tìm kiếm ngay lập tức. Thay vì đợi toàn bộ tài liệu xử lý xong, ta xây dựng một động cơ RAG (Retrieval-Augmented Generation) cấp trang gọn nhẹ, đánh mục lục nội dung tăng dần.
Khi mỗi lô trang được xử lý, văn bản của chúng được nhúng và thêm vào chỉ mục FAISS, cho phép người dùng truy vấn tài liệu trong khi việc đánh mục lục vẫn đang diễn ra.
class PageRAG:
def __init__(self, chunk_size=1000):
self.chunk_size = chunk_size
self.index = faiss.IndexFlatIP(EMBED_DIM)
self.chunks = []
self.page_count = 0
self._lock = threading.Lock()
def reset(self):
with self._lock:
self.index = faiss.IndexFlatIP(EMBED_DIM)
self.chunks, self.page_count = [], 0
def add_page(self, page_num, text):
if not text or not text.strip():
with self._lock: self.page_count += 1
return
new_chunks = self._split(text, page_num)
texts = [c[1] for c in new_chunks]
embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
with self._lock:
self.index.add(np.array(embs, dtype=np.float32))
self.chunks.extend(new_chunks)
self.page_count += 1
def query(self, question, top_k=5):
with self._lock:
if self.index.ntotal == 0: return []
q = EMBED_MODEL.encode([question], normalize_embeddings=True)
k = min(top_k, self.index.ntotal)
scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
for s, i in zip(scores[0], ids[0]) if i >= 0]
def _split(self, text, pn):
if len(text) <= self.chunk_size: return [(pn, text)]
parts, cur = [], ''
for p in re.split(r'\n{2,}', text):
if len(cur) + len(p) > self.chunk_size and cur:
parts.append((pn, cur.strip())); cur = p
else: cur += ('\n\n' + p if cur else p)
if cur.strip(): parts.append((pn, cur.strip()))
return parts or [(pn, text[:self.chunk_size])]
@property
def indexed_pages(self):
with self._lock: return self.page_countLớp trên định nghĩa bốn thành phần chính:
- Đánh chỉ mục vector với FAISS: Động cơ dùng
faiss.IndexFlatIPđể tìm kiếm tương đồng nhanh trên embedding đã chuẩn hoá. Khi mỗi trang được xử lý, nội dung của nó lập tức được nhúng và thêm vào chỉ mục, cho phép truy xuất thời gian thực mà không cần dựng lại chỉ mục. - Chia khúc cấp trang: Phương thức
_split()tách văn bản trang dài thành các khúc ~1000 ký tự dựa trên ranh giới đoạn. Điều này cải thiện ghép nối ngữ nghĩa và tránh nhúng ngữ cảnh quá dài, nhiễu, đồng thời vẫn giữ số trang để đối chiếu nguồn. - Cập nhật cho xử lý nền: Vì OCR và đánh mục lục chạy trong luồng nền trong khi người dùng có thể truy vấn đồng thời, một
threading.Lock()bảo vệ cập nhật và đọc chỉ mục. - Tìm kiếm ngữ nghĩa nhanh có đối chiếu: Phương thức
query()nhúng câu hỏi người dùng, truy xuất top-k khúc tương tự và trả về văn bản khớp kèm số trang và điểm tương đồng. Thuộc tínhindexed_pagestheo dõi tiến độ để UI hiển thị số trang đã có thể tìm kiếm.
Bước 5: Động cơ vLLM
Ở bước này, ta khởi tạo động cơ suy luận DeepSeek OCR-2 dùng vLLM. Đây là thành phần cốt lõi thực hiện sinh đa phương thức bằng cách nhận các ảnh trang đã token hoá và tạo ra văn bản OCR có cấu trúc. Cấu hình theo thiết lập tham chiếu vLLM của DeepSeek OCR-2 chính thức, nhưng ta bọc trong bộ nạp lười load_ocr_engine() để chỉ tải mô hình khi bắt đầu xử lý, giảm thời gian khởi động và tránh chiếm GPU không cần thiết.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
global ocr_llm, ocr_sampling_params
if ocr_llm is not None:
return
print(f'Loading {config.MODEL_PATH} via vLLM...')
ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
ocr_llm = LLM(
model=config.MODEL_PATH,
hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
block_size=256,
enforce_eager=False,
trust_remote_code=True,
max_model_len=8192,
swap_space=0,
max_num_seqs=config.MAX_CONCURRENCY,
tensor_parallel_size=1,
gpu_memory_utilization=0.9,
disable_mm_preprocessor_cache=True,
)
ocr_sampling_params = SamplingParams(
temperature=0.0,
max_tokens=8192,
logits_processors=[
NoRepeatNGramLogitsProcessor(
ngram_size=20, window_size=50,
whitelist_token_ids={128821, 128822},
)
],
skip_special_tokens=False,
include_stop_str_in_output=True,
)
print('vLLM engine loaded')Đoạn code này định nghĩa các thành phần lõi sau:
- Đăng ký mô hình: Hàm
ModelRegistry.register_model() kết nối lớp tuỳ chỉnhDeepseekOCR2ForCausalLMtừ repository với vLLM để có thể xử lý đầu vào token-ảnh doDeepseekOCR2Processortạo ra. - Cấu hình động cơ vLLM: Các tham số
LLM()khớp với cài đặt tham chiếu của repository, gồmblock_size=256,max_model_len=8192,gpu_memory_utilization=0.9, vàdisable_mm_preprocessor_cache=True. Những cài đặt này được tinh chỉnh để suy luận OCR thông lượng cao ổn định, đồng thời giữ mức dùng bộ nhớ GPU dễ dự đoán. - Giải mã có kiểm soát:
SamplingParams giống hệt cấu hình gốc, tức giải mã quyết địnhtemperature=0.0, giới hạn đầu ra lớn, vàNoRepeatNGramLogitsProcessorđể ngăn lặp mẫu n-gram, vốn là vấn đề phổ biến trong sinh OCR văn bản dài. - Nạp lười: Thay vì khởi tạo mô hình lúc import, động cơ chỉ tải một lần khi
load_ocr_engine()được gọi lần đầu. Các lần gọi sau tái sử dụng cùng phiên bản, tránh khởi tạo GPU lặp lại và giúp UI phản hồi tốt.
Giờ hãy kết nối động cơ này với vòng xử lý theo lô chạy OCR từng trang và đưa kết quả vào chỉ mục RAG để truy vấn thời gian thực.
Bước 6: Pipeline Hỏi-Trong-Khi-Đánh-Mục lục
Đây là trái tim của ứng dụng. Chúng ta triển khai một worker nền nhận PDF tải lên và dần biến nó thành chỉ mục có thể tìm kiếm, thay vì đợi toàn bộ tài liệu hoàn tất OCR.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
global total_pages, is_processing, processing_error, stop_requested
try:
is_processing = True
processing_error = None
stop_requested = False
load_ocr_engine()
if stop_requested: return
print('PDF loading...')
images = pdf_to_images_high_quality(pdf_path)
total_pages = len(images)
print(f'Rendered {total_pages} pages.')
if stop_requested: return
print('Preprocessing all images with DeepseekOCR2Processor...')
prompt = config.PROMPT
preprocess_fn = partial(process_single_image, prompt_str=prompt)
with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
all_inputs = list(executor.map(preprocess_fn, images))
print(f'Preprocessed {len(all_inputs)} pages.')
if stop_requested: return
num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
for batch_idx in range(num_batches):
if stop_requested:
print(f'Stopped before batch {batch_idx + 1}.')
return
start = batch_idx * BATCH_SIZE
end = min(start + BATCH_SIZE, total_pages)
batch_inputs = all_inputs[start:end]
print(f' Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
outputs_list = ocr_llm.generate(
batch_inputs,
sampling_params=ocr_sampling_params,
)
for i, output in enumerate(outputs_list):
page_num = start + i + 1
cleaned = clean_ocr_output(output.outputs[0].text)
rag.add_page(page_num, cleaned)
print(f' Page {page_num}/{total_pages} ({len(cleaned)} chars)')
print(f' Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
except Exception as e:
import traceback
processing_error = f'{e}\n\n{traceback.format_exc()}'
print(f'ERROR: {processing_error}')
finally:
is_processing = False
if stop_requested:
print(f'Stopped. {rag.indexed_pages} pages indexed.')
else:
print('Processing complete.')Luồng pipeline của chúng ta gồm kết xuất trang, tiền xử lý đầu vào, chạy suy luận vLLM theo lô nhỏ, rồi làm sạch đầu ra OCR, và cuối cùng thêm từng trang vào PageRAG dựa trên FAISS. Phân tích chi tiết từng bước:
- Quản lý trạng thái: Các biến toàn cục (
total_pages,is_processing,processing_error,stop_requested) theo dõi tiến độ và chế độ lỗi để UI có thể hiển thị trạng thái trực tiếp, xử lý dừng/đặt lại và tránh chạy xung đột. - Tiền xử lý song song:
ThreadPoolExecutor(max_workers=config.NUM_WORKERS)chuyển ảnh trang thành đầu vào đa phương thức sẵn sàng cho mô hình một cách song song. Điều này giữ cho GPU bận rộn về sau bằng cách đảm bảo đầu vào đã sẵn sàng trước khi suy luận. - Suy luận theo lô nhỏ: Thay vì chạy
ocr_llm.generate()một lần trên tất cả trang (mặc định của script chính thức), mã tínhnum_batchesvà xử lý trang theo các khúcBATCH_SIZE. Điều này cho phép đánh mục lục tiến dần, để người dùng có thể bắt đầu hỏi sau khi 5 trang đầu (BATCH_SIZE = 5) được đánh mục lục, thay vì chờ toàn bộ tài liệu. - Dừng giữa các lô: Cờ
stop_requestedđược kiểm tra trước các giai đoạn tốn kém và ở đầu mỗi lô. Điều đó khiến nút Stop dự đoán được: nó dừng giữa các lô, sau khi lô hiện tại hoàn tất, nên bạn không rơi vào trạng thái viết dở hoặc đầu ra nửa vời.
Tại thời điểm này, chúng ta có pipeline đầu-cuối chuyển một PDF thành chỉ mục tìm kiếm đang lớn dần, cho phép người dùng truy vấn tài liệu trong khi xử lý tiếp diễn ở nền. Tiếp theo, ta sẽ thêm các callback UI kết nối worker này với ứng dụng Gradio.
Bước 7: Callback ứng dụng
Ở giai đoạn này, pipeline OCR và đánh mục lục đang chạy nền, nhưng ứng dụng vẫn cần một lớp điều khiển nối hành động người dùng với logic xử lý.
def start_processing(pdf_file):
global total_pages
if pdf_file is None: return 'Upload a PDF first.'
if is_processing: return 'Already processing.'
rag.reset()
total_pages = 0
threading.Thread(
target=process_pdf_background,
args=(pdf_file.name,),
daemon=True,
).start()
return 'Processing started! Pages become searchable in batches.'
def stop_processing():
global stop_requested
if not is_processing:
return 'Nothing is running.'
stop_requested = True
return 'Stop requested. Will halt after current batch.'
def reset_all():
global total_pages, processing_error, stop_requested
if is_processing:
return 'Cannot reset while processing. Stop first.'
rag.reset()
total_pages = 0
processing_error = None
stop_requested = False
return 'Reset complete. Upload a new PDF.'
def refresh_progress():
idx, tp = rag.indexed_pages, total_pages
if processing_error:
msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
elif stop_requested and is_processing:
pct = int(idx / tp * 100) if tp > 0 else 0
msg, c = 'Stopping after current batch...', '#f59e0b'
elif not is_processing and stop_requested:
pct = int(idx / tp * 100) if tp > 0 else 0
msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
elif not is_processing and idx == 0:
msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
elif is_processing and tp == 0:
msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
elif is_processing:
pct = int(idx / tp * 100)
msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
else:
msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
bar_min = '32px' if pct > 0 else '0'
pct_text = f'{pct}%' if pct > 5 else ''
return (f'<div style=">'
f'<div style="font-weight:500">{msg}</div>'
f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
f'transition:width .6s;display:flex;align-items:center;'
f'justify-content:center;color:white;font-weight:600;'
f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
if not question.strip(): return ''
idx = rag.indexed_pages
if idx == 0:
if is_processing:
return ('**Processing in progress -- first batch not done yet.**\n\n'
'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
'Try again shortly!')
return 'Upload a PDF and click **Process** first.'
results = rag.query(question, top_k=5)
if not results: return 'No relevant results found.'
lines = []
if is_processing:
lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
for i, r in enumerate(results, 1):
lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
r['text'][:600]]
if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
return '\n'.join(lines)Lớp điều khiển này xử lý năm trách nhiệm cốt lõi:
- Bắt đầu xử lý bất đồng bộ: Hàm
start_processing()xác thực đầu vào, đặt lại chỉ mục RAG và khởi chạyprocess_pdf_background()trong một luồng daemon. - Ngắt an toàn giữa các lô: Hàm
stop_processing()đặt cờstop_requestedthay vì chấm dứt ngay lập tức. Worker nền kiểm tra cờ này giữa các lô, đảm bảo hệ thống dừng gọn gàng mà không làm hỏng chỉ mục. - Đặt lại trạng thái: Hàm
reset_all()xoá sạch chỉ mục FAISS, bộ đếm tiến độ và trạng thái lỗi. Nó cũng ngăn đặt lại ngoài ý muốn khi vẫn đang xử lý, giúp tránh trạng thái ứng dụng không nhất quán. - Báo cáo tiến độ thời gian thực: Chúng ta dùng
refresh_progress()để đọc số trang đã đánh mục lục từPageRAGvà sinh thanh tiến độ HTML động. Nó cũng truyền đạt các trạng thái hệ thống như đang tải, đang xử lý, đang dừng, hoàn tất hoặc lỗi. - Hỏi đáp tăng dần có đối chiếu nguồn: Cuối cùng, hàm
answer_question() truy vấn chỉ mục FAISS và trả về các khúc khớp hàng đầu kèm số trang và điểm tương đồng. Nếu đánh mục lục vẫn đang chạy, phản hồi sẽ nêu rõ đã tìm qua bao nhiêu trang, củng cố hành vi “hỏi trong khi đánh mục lục”.
Ở bước cuối, chúng ta sẽ kết nối các callback này với giao diện Gradio để cung cấp toàn bộ quy trình qua một UI web đơn giản.
Bước 8: Giao diện Gradio
Trong bước cuối cùng, chúng ta gói mọi thứ vào một ứng dụng Gradio đơn giản. UI được thiết kế để người dùng tải lên PDF, bắt đầu xử lý và bắt đầu đặt câu hỏi trước khi đánh mục lục hoàn tất.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
with gr.Row(equal_height=True):
with gr.Column(scale=1, min_width=250):
pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
process_btn = gr.Button('Process PDF', variant='primary', size='lg')
with gr.Row():
stop_btn = gr.Button('Stop', variant='stop', size='sm')
reset_btn = gr.Button('Reset', variant='secondary', size='sm')
status_output = gr.Markdown()
with gr.Column(scale=2):
progress_bar = gr.HTML(
value='<div style=">Upload a PDF and click Process.</div>')
gr.Markdown('---')
with gr.Row(equal_height=True):
question_input = gr.Textbox(
label='Ask a Question',
placeholder='What is this document about?',
lines=1, scale=4)
ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
answer_output = gr.Markdown()
timer = gr.Timer(2)
timer.tick(fn=refresh_progress, outputs=progress_bar)
process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
stop_btn.click(fn=stop_processing, outputs=status_output)
reset_btn.click(fn=reset_all, outputs=status_output)
ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)Ứng dụng Gradio gồm hai cột. Cột trái chứa tiện ích tải PDF và các nút Process/Stop/Reset, còn cột phải hiển thị thanh tiến độ HTML trực tiếp. Điều này khiến ứng dụng phản hồi tốt ngay cả khi OCR vẫn đang chạy. Một số điểm nổi bật:
- Chỉ báo tiến độ dựa trên polling:
gr.Timer(2)gọirefresh_progress()mỗi hai giây và cập nhật HTML thanh tiến độ. Vì đánh mục lục theo lô, người dùng sẽ thấy tiến độ tăng theo bước (và thông điệp thay đổi theo các trạng thái như đang tải, dừng, lỗi hoặc hoàn tất). - Gắn sự kiện với callback: Trình xử lý
.click()của nút kết nối hành động UI trực tiếp với các hàm backend, nhưstart_processing()khởi động worker nền,stop_processing()yêu cầu dừng sạch,reset_all()xoá trạng thái, vàanswer_question()chạy truy xuất trên các trang đã đánh mục lục tới thời điểm đó. - Tương tác Hỏi & Đáp: Câu hỏi có thể gửi bằng cách bấm Ask hoặc nhấn Enter. Câu trả lời được hiển thị dạng Markdown, phù hợp với văn bản nhưng không lý tưởng cho nội dung chứa mã, phương trình hoặc ký tự đặc biệt.
Cuối cùng, demo.launch() khởi chạy ứng dụng trong Colab, cung cấp liên kết chia sẻ, hiển thị nội tuyến và bật log gỡ lỗi để hỗ trợ chẩn đoán trong quá trình phát triển.
Kết luận
Trong hướng dẫn này, chúng ta đã xây dựng pipeline thông minh tài liệu ưu tiên thị giác hoàn chỉnh bằng DeepSeek OCR-2. Bắt đầu từ PDF thô, ta kết xuất trang thành ảnh chất lượng cao, chạy OCR đa phương thức qua vLLM, làm sạch và cấu trúc văn bản trích xuất, rồi đánh mục lục tăng dần vào kho RAG dựa trên FAISS.
Bằng cách xử lý trang theo lô nhỏ, ứng dụng mang lại trải nghiệm “hỏi trong khi đánh mục lục” nơi người dùng có thể bắt đầu truy vấn tài liệu sau lô đầu tiên thay vì đợi hoàn tất.
Tuy nhiên, có hai hạn chế đáng chú ý xuất hiện trong thử nghiệm. Các vùng nhiều công thức không phải lúc nào cũng được chép lại chính xác, đây là thách thức đã biết với mô hình OCR thị giác-ngôn ngữ, ngay cả khi có prompt đối chiếu nguồn.
Ngoài ra, một số trang dài xuất hiện mẫu đầu ra lặp lại. Pipeline chính thức giảm nhẹ bằng NoRepeatNGramLogitsProcessor (ngram_size=20), nhưng bảng dày đặc và bố cục nhiều cột vẫn có thể kích hoạt vòng lặp sinh, khi đó trang sẽ bị bỏ qua âm thầm thông qua cờ SKIP_REPEAT.
Để tiến xa hơn, bạn có thể thử thêm một lớp LLM gọn nhẹ (ví dụ, gọi API Anthropic hoặc OpenAI) để tóm tắt các khúc được truy xuất thay vì trả về đoạn trích thô.
Các cải tiến thực tế khác gồm lưu bền chỉ mục FAISS xuống đĩa để tái sử dụng giữa các phiên, hỗ trợ nhiều PDF trong một chỉ mục, phơi bày các tham số có thể điều chỉnh như BATCH_SIZE và top_k trực tiếp trên UI Gradio, hoặc thêm chia khúc theo cấu trúc (tiêu đề, bảng, ranh giới phần) để cải thiện độ chính xác truy xuất.
FAQs
Ứng dụng này có dùng pipeline DeepSeek OCR-2 chính thức không?
Có. Backend phản chiếu cách tiếp cận DeepSeek-OCR2-vllm của repo, bao gồm tiền xử lý DeepseekOCR2Processor cùng với DeepseekOCR2ForCausalLM được đăng ký vào vLLM và hàm LLM.generate().
Vì sao không dùng `AutoModel.from_pretrained()`?
Đường dẫn AutoModel.from_pretrained() thường hỏng do không khớp transformers / flash-attn / CUDA ABI và thay đổi trong API nội bộ. Lộ trình vLLM của repo ổn định hơn cho quy trình làm việc này.
Làm thế nào để cải thiện chất lượng bảng?
Hãy thử dpi cao hơn (144 đến 168 hoặc 192), và giữ crop_mode nhất quán với cấu hình repo. Lưu ý bảng thường nhạy với độ phân giải.

Tôi là Chuyên gia Google Developers trong lĩnh vực ML (Gen AI), Chuyên gia Kaggle 3x và Đại sứ Women Techmakers với hơn 3 năm kinh nghiệm trong ngành công nghệ. Tôi đồng sáng lập một startup công nghệ y tế vào năm 2020 và hiện đang theo học thạc sĩ khoa học máy tính tại Georgia Tech, chuyên sâu về học máy.


DeepSeek OCR-2 được thiết kế cho hiểu tài liệu ưu tiên thị giác, đặc biệt hiệu quả với các PDF quét hoặc nhiều hình ảnh, nơi trích xuất văn bản truyền thống gặp khó khăn. Trong hướng dẫn này, chúng ta sẽ dùng DeepSeek OCR-2 phục vụ qua vLLM để xây dựng trợ lý tài liệu gọn nhẹ kiểu “Hỏi trong khi đánh mục lục” với Gradio.
Trong ứng dụng, người dùng tải lên một PDF; mỗi trang được kết xuất thành ảnh chất lượng cao và OCR chạy theo các lô nhỏ. Văn bản trích xuất được đánh mục lục tăng dần vào kho FAISS bằng SentenceTransformers, cho phép tài liệu có thể tìm kiếm dần khi xử lý. Thay vì đợi toàn bộ tệp hoàn tất, người dùng có thể bắt đầu đặt câu hỏi ngay sau khi lô đầu tiên được đánh mục lục.
Kết quả là một quy trình trò chuyện với tài liệu thực tiễn, nhấn mạnh thời gian đến câu trả lời đầu tiên nhanh, sử dụng GPU hiệu quả và trải nghiệm giống truyền phát.
Tôi cũng khuyến nghị xem qua hướng dẫn cơ bản DeepSeek OCR và hướng dẫn DeepSeek-V3.2-Speciale.