Curso
Trabalhando com DeepSeek em Python
3 h
1.3K
O DeepSeek-OCR 2 é um modelo visão–linguagem de leitura de documentos com OCR, fim a fim, projetado para lidar com layouts complexos (páginas com múltiplas colunas, formulários, tabelas, fórmulas) aprendendo uma ordem de leitura melhor, em vez de achatar blocos de imagem em uma varredura fixa do canto superior esquerdo para o inferior direito.
A ideia central é o Visual Causal Flow, ou seja, o modelo tenta imitar como humanos leem documentos — de forma progressiva e semântica — em vez de tratar a página como uma grade uniforme. Na arquitetura, o DeepSeek-OCR 2 mantém o enquadramento codificador–decodificador do DeepSeek-OCR, mas atualiza o codificador para o DeepEncoder V2, que introduz um mecanismo causal de reordenação de tokens antes do decodificador gerar o texto.
Em alto nível, o DeepSeek OCR-2 converte um documento em texto por meio de um pipeline visão–linguagem que aprende a ordem de leitura, em vez de depender de uma ordenação fixa por coordenadas. Isso inclui:
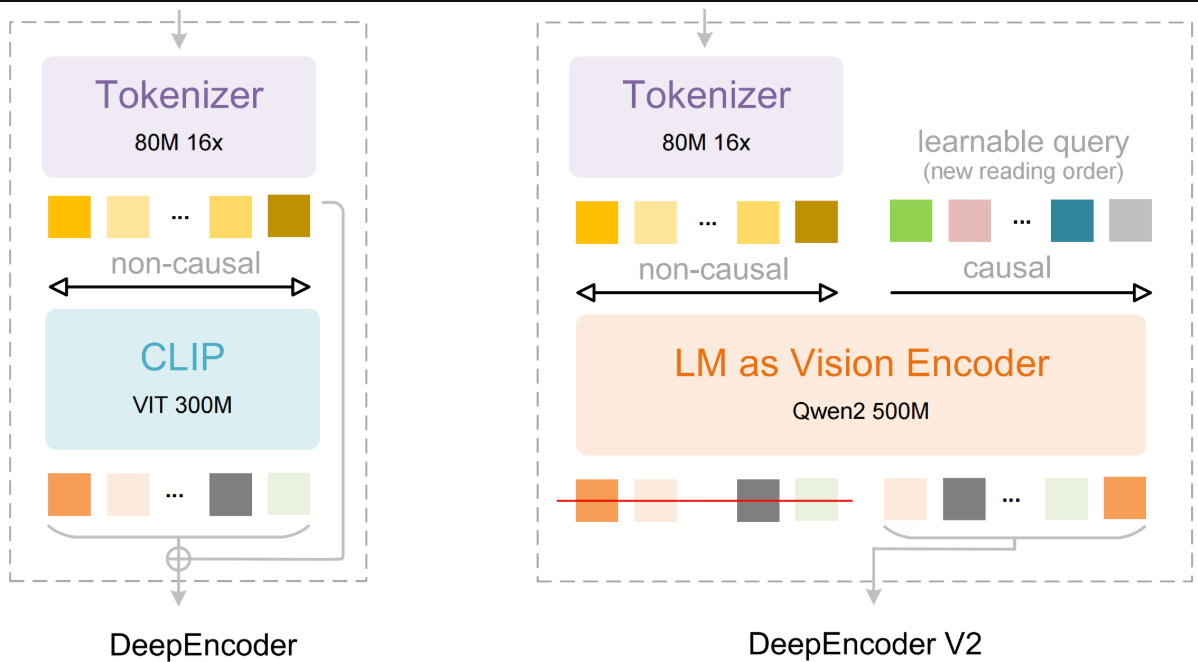
Figura: DeepSeek-OCR 2: Visual Causal Flow
Você pode consultar o repositório no GitHub do DeepSeek OCR-2 para explorar o código em detalhes.
Nesta seção, vamos construir um aplicativo de inteligência de documentos em tempo real que permite enviar um PDF, extrair seu conteúdo com o DeepSeek OCR-2 e começar a fazer perguntas enquanto o documento ainda está sendo processado. Em vez de esperar o OCR completo, as páginas se tornam pesquisáveis lote a lote, oferecendo uma experiência muito mais rápida e interativa.
Em alto nível, o sistema executa quatro tarefas principais:
O aplicativo gera duas saídas principais:
Observação: este tutorial parte do código de demo oficial do OCR-2 com vLLM do DeepSeek, incluindo o helper de renderização de PDF, empacotamento de entrada multimodal, limpeza do texto de OCR e a configuração do engine/sampling no vLLM. Em cima disso, adiciono uma camada leve de RAG, processamento de OCR em minibatches para permitir indexação incremental e um app em Gradio.
Antes de rodar o DeepSeek OCR-2 com vLLM, precisamos garantir que o ambiente de execução está pronto. Neste tutorial, assumimos um ambiente com GPU, como o Google Colab com A100 ou T4, já que tanto o vLLM quanto o DeepSeek OCR-2 requerem CUDA para inferência eficiente.
Neste passo, vamos:
Isso garante que o restante do pipeline consiga carregar o modelo e os utilitários de apoio sem problemas de caminho ou dependências.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
Este passo verifica se há uma GPU disponível e prepara localmente a base de código do DeepSeek OCR-2. O script acima primeiro checa a GPU e a memória disponíveis usando nvidia-smi para garantir VRAM suficiente para inferência com vLLM.
Depois, define os caminhos do repositório e verifica se o diretório de integração com vLLM já existe. Caso não exista, ele extrai o repositório de um ZIP local ou clona o repositório oficial do DeepSeek OCR-2 no GitHub.
No próximo passo, vamos instalar as dependências necessárias e preparar o runtime para inferência com vLLM.
DeepSeek OCR-2 e vLLM são bem sensíveis a versões. Então, neste passo, fixamos um conjunto funcional de pacotes para CUDA 11.8, instalamos um wheel do vLLM compatível e adicionamos flash-attn para kernels de atenção mais rápidos.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
O trecho acima instala um runtime compatível para rodar o DeepSeek OCR-2 com vLLM. Ele também instala a stack de suporte do aplicativo, incluindo Transformers, Gradio para a UI, PyMuPDF e Pillow para processamento de PDF/imagem, e SentenceTransformers com FAISS para construir o índice de recuperação.
Após a instalação, variáveis de ambiente são configuradas para uma execução estável do vLLM e compatibilidade com o Triton. A integração com vLLM do repositório é adicionada ao sys.path para que o modelo customizado do DeepSeek OCR-2 e os módulos de pré-processamento possam ser importados e, por fim, um modelo leve de embeddings (all-MiniLM-L6-v2) é carregado para dar suporte à indexação incremental por página no RAG.
No próximo passo, vamos implementar utilitários de pré-processamento para converter um PDF em imagens de página, empacotar cada página no formato multimodal esperado pelo DeepSeek OCR-2 e limpar as saídas de OCR para recuperação.
Antes de rodarmos o DeepSeek OCR-2, precisamos de um pequeno conjunto de utilitários de pré-processamento que convertam um PDF em entradas prontas para o modelo e limpem a saída bruta de OCR para recuperação.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
Os utilitários acima definem três componentes-chave:
Definimos BATCH_SIZE = 5 para controlar quão rápido os primeiros resultados aparecem versus a eficiência de uso da GPU. Para um PDF de 20 páginas, o progresso avança em etapas de 0% para 25%, 50%, 75% e 100%, em vez de pular direto de 0% para 100%.
Isso permite que os usuários comecem a perguntar assim que as primeiras 5 páginas forem indexadas. Lotes menores melhoram o tempo até o primeiro resultado, enquanto lotes maiores melhoram a vazão e a utilização da GPU.
Usamos o código nativo da função pdf_to_images_high_quality() da implementação original com a biblioteca PyMuPDF para renderizar cada página em uma imagem PIL a 144 DPI (deriva de zoom = 144 / 72.0 = 2.0, que dobra a resolução padrão de 72 DPI).
A matriz de zoom dpi/72 controla a qualidade da rasterização e alpha=False evita artefatos de transparência. Se uma imagem ainda contiver canal alfa, a função achata sobre um fundo branco para prevenir mesclas estranhas que podem degradar o OCR.
A função process_single_image() (do código original) empacota cada imagem de página na estrutura exata de dict que o vLLM espera (prompt + multi_modal_data.image), usando DeepseekOCR2Processor().tokenize_with_images(), que cuida de todo o pipeline de pré-processamento da imagem, incluindo dividir imagens grandes em 2–6 tiles via dynamic_preprocess() conforme a proporção, criar uma visão global 1024×1024 com padding, aplicar normalização de tensores e gerar a sequência completa de tokens com máscaras de imagem que o DeepseekOCR2ForCausalLM consome.
O config.CROP_MODE do repositório controla se esse tileamento dinâmico é aplicado, o que melhora a precisão em layouts densos com textos pequenos.
Após a geração, clean_ocr_output() remove tokens especiais de fim de sentença, elimina blocos de marcação de detecção (<|ref|>...<|/ref|><|det|>...<|/det|>), normaliza alguns operadores parecidos com LaTeX e reduz quebras de linha excessivas, produzindo texto mais limpo, que faz chunking melhor e recupera com mais confiabilidade no índice RAG a jusante.
Em seguida, vamos usar essa saída limpa para construir um índice RAG leve por página, de modo que as páginas se tornem pesquisáveis imediatamente após cada batch terminar.
Agora que conseguimos extrair texto limpo de cada página, o próximo passo é torná-lo pesquisável imediatamente. Em vez de esperar o documento inteiro terminar o processamento, construímos um engine de Retrieval-Augmented Generation (RAG) leve por página que indexa o conteúdo de forma incremental.
À medida que cada batch de páginas é processado, seu texto é convertido em embeddings e adicionado a um índice FAISS, permitindo que o usuário consulte o documento enquanto a indexação ainda está em andamento.
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
A classe acima define quatro componentes essenciais:
faiss.IndexFlatIP para busca rápida por similaridade sobre embeddings normalizados. À medida que cada página é processada, seu conteúdo é imediatamente transformado em embedding e adicionado ao índice, permitindo recuperação em tempo real sem precisar reconstruir o índice._split() quebra textos longos de página em chunks de ~1000 caracteres com base em limites de parágrafos. Isso melhora a correspondência semântica e evita embeddings de contextos muito longos/ruidosos, preservando o número da página para atribuição de fonte.threading.Lock() protege atualizações e leituras do índice. query() gera o embedding da pergunta do usuário, recupera os top-k chunks similares e retorna o texto combinado com números de página e scores de similaridade. A propriedade indexed_pages acompanha o progresso para que a UI mostre quantas páginas já estão pesquisáveis.Neste passo, inicializamos o engine de inferência do DeepSeek OCR-2 usando vLLM. Este é o componente central que realiza a geração multimodal, recebendo as imagens tokenizadas das páginas e produzindo o texto de OCR estruturado. A configuração segue o setup de referência oficial do DeepSeek OCR-2 com vLLM, mas a encapsulamos em um carregador preguiçoso load_ocr_engine() para que o modelo só carregue quando o processamento começar, reduzindo o tempo de inicialização e evitando alocação desnecessária de GPU.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
Este trecho define os seguintes componentes centrais:
DeepseekOCR2ForCausalLM do repositório ao vLLM para que ele consiga lidar com entradas de imagem-token produzidas pelo DeepseekOCR2Processor.LLM() correspondem às definições de referência do repositório, incluindo block_size=256, max_model_len=8192, gpu_memory_utilization=0.9 e disable_mm_preprocessor_cache=True. Essas configurações são ajustadas para uma inferência de OCR estável e de alta vazão, mantendo o uso da memória de GPU previsível.temperature=0.0), limites amplos de saída e um NoRepeatNGramLogitsProcessor para evitar padrões repetitivos de texto — um problema comum em geração de OCR de longo comprimento.load_ocr_engine() é chamado pela primeira vez. As chamadas seguintes reutilizam a mesma instância, evitando re-inicializações de GPU e mantendo a UI responsiva.Agora, vamos conectar esse engine a um loop de processamento em lotes que roda OCR página a página e envia os resultados ao índice RAG para consultas em tempo real.
Este passo é o coração do app. Implementamos um worker em background que recebe um PDF enviado e o transforma progressivamente em um índice pesquisável, em vez de esperar o documento inteiro terminar o OCR.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
O fluxo do nosso pipeline inclui renderização das páginas, pré-processamento das entradas, execução da inferência com vLLM em minibatches, limpeza da saída de OCR e, por fim, adição de cada página ao PageRAG com FAISS. Aqui vai uma análise detalhada de cada etapa:
total_pages, is_processing, processing_error, stop_requested) acompanham progresso e falhas para que a UI mostre status ao vivo, permita parar/resetar e evite execuções conflitantes.ThreadPoolExecutor(max_workers=config.NUM_WORKERS) converte imagens de página em entradas multimodais prontas para o modelo em paralelo. Isso mantém a GPU ocupada depois, garantindo que as entradas estejam preparadas antes da inferência.ocr_llm.generate() de uma vez em todas as páginas (padrão do script oficial), o código calcula num_batches e processa páginas em blocos de BATCH_SIZE. Isso habilita indexação progressiva, permitindo que os usuários comecem a perguntar após as primeiras 5 páginas (BATCH_SIZE = 5) serem indexadas, em vez de esperar o documento inteiro.stop_requested é checado antes de etapas custosas e no início de cada batch. Isso torna o botão Parar previsível: ele interrompe entre os lotes, após o lote atual terminar, evitando estados meio gravados ou saídas parciais.Neste ponto, temos um pipeline fim a fim que converte um PDF em um índice crescente de busca, permitindo que o usuário consulte o documento enquanto o processamento continua em background. Agora, vamos adicionar os callbacks da UI que conectam esse worker ao aplicativo Gradio.
Neste estágio, o pipeline de OCR e indexação já roda em background, mas o app ainda precisa de uma camada de controle que conecte as ações do usuário à lógica de processamento.
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
Esta camada de controle assume cinco responsabilidades principais:
start_processing() valida a entrada, reseta o índice de RAG e inicia process_pdf_background() em uma thread daemon. stop_processing() define a flag stop_requested em vez de terminar a execução imediatamente. O worker em background checa essa flag entre batches, garantindo parada limpa sem corromper o índice.reset_all() limpa o índice FAISS, os contadores de progresso e o estado de erro. Ele também evita resets acidentais enquanto o processamento está ativo, protegendo contra estados inconsistentes.refresh_progress() para ler o número de páginas indexadas do PageRAG e gerar uma barra de progresso em HTML dinâmica. Ela também comunica estados do sistema, como carregando, processamento ativo, parando, concluído ou erro.No passo final, vamos conectar esses callbacks a uma interface Gradio para expor todo o fluxo por uma UI web simples.
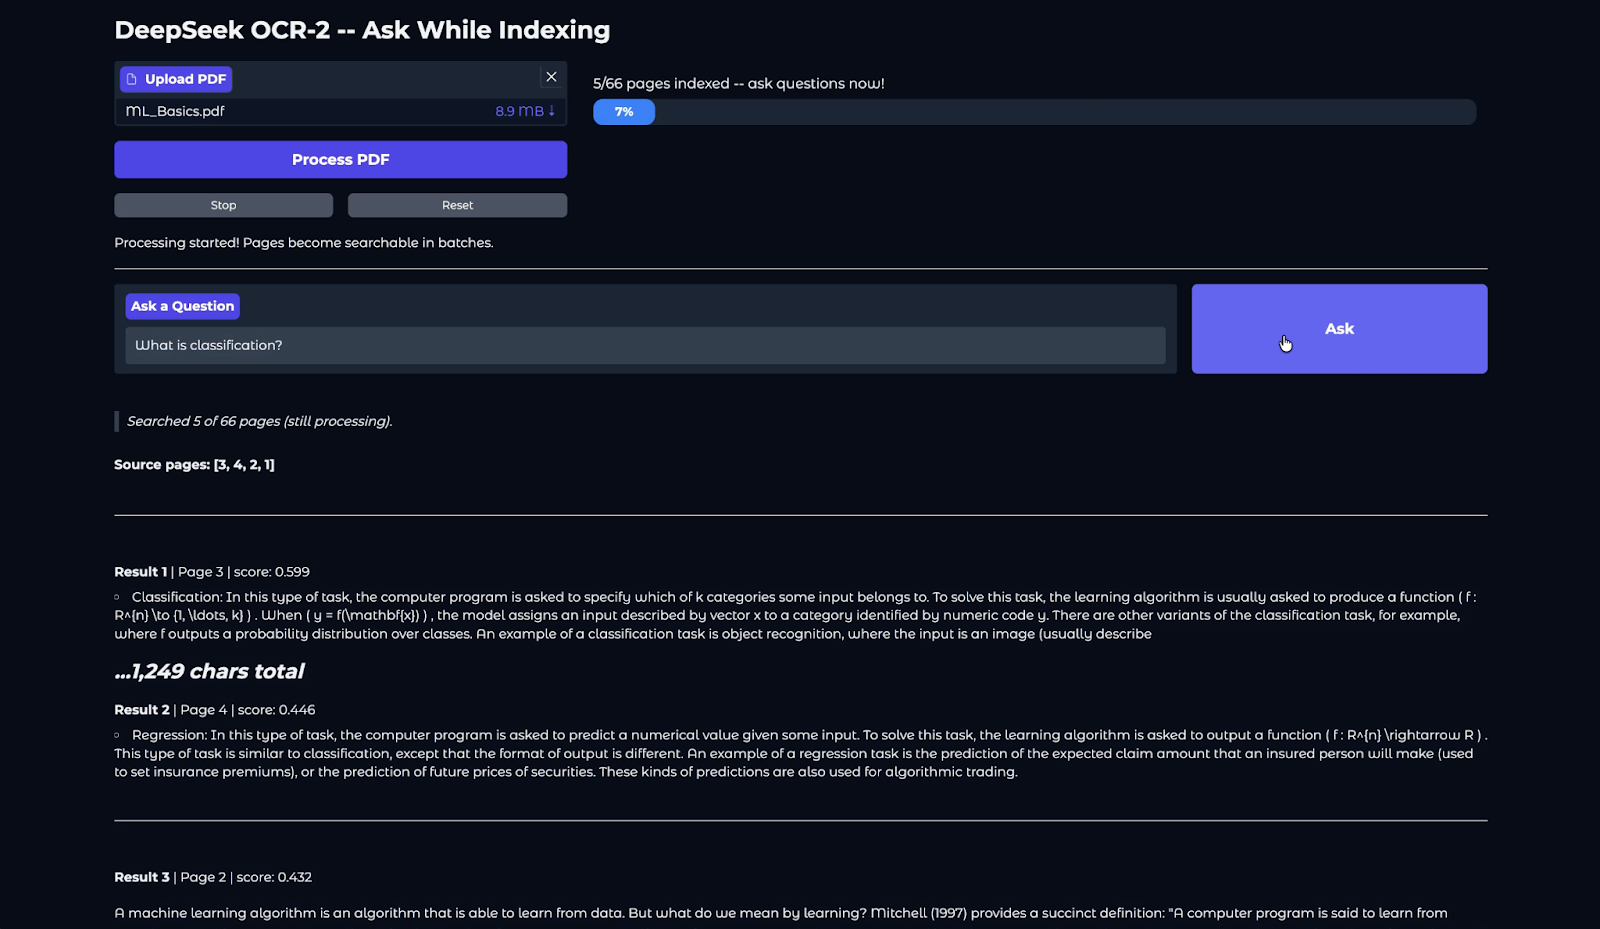
Neste passo final, empacotamos tudo em um aplicativo simples no Gradio. A UI foi pensada para permitir enviar um PDF, iniciar o processamento e já começar a fazer perguntas antes da indexação terminar.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
O aplicativo Gradio tem duas colunas. À esquerda ficam o widget de upload de PDF e os botões Processar/Parar/Resetar; à direita, uma barra de progresso em HTML ao vivo. Isso faz o app parecer responsivo mesmo com o OCR rodando. Alguns destaques do app:
gr.Timer(2) chama refresh_progress() a cada dois segundos e atualiza o HTML da barra. Como a indexação acontece em batches, o usuário vê o progresso avançar em degraus (e as mensagens mudam conforme estados como carregando, parando, erro ou conclusão)..click() dos botões conectam ações da UI diretamente às suas funções backend, como start_processing() para iniciar o worker em background, stop_processing() para pedir parada limpa, reset_all() para limpar o estado e answer_question() para rodar a recuperação sobre as páginas já indexadas.Por fim, demo.launch() inicia o app no Colab, gera um link compartilhável, renderiza inline e habilita logs de debug para ajudar na investigação de problemas durante o desenvolvimento.
Neste tutorial, construímos um pipeline completo de inteligência de documentos com foco em visão usando o DeepSeek OCR-2. Partindo de um PDF bruto, renderizamos páginas em imagens de alta qualidade, executamos OCR multimodal via vLLM, limpamos e estruturamos o texto extraído e o indexamos incrementalmente em um repositório de RAG baseado em FAISS.
Ao processar páginas em minibatches, o aplicativo viabiliza a experiência “pergunte enquanto indexa”, em que o usuário já pode consultar o documento após o primeiro lote, sem esperar a conclusão total.
Porém, dois limites chamaram atenção nos testes: regiões com muitas fórmulas nem sempre são transcritas com precisão — um desafio conhecido em modelos de OCR visão–linguagem, mesmo com prompts de grounding.
Além disso, algumas páginas longas exibem padrões de saída repetitivos. O pipeline oficial mitiga isso com um NoRepeatNGramLogitsProcessor (ngram_size=20), mas tabelas densas e layouts multicoluna ainda podem disparar loops de geração — nesses casos, a página é ignorada silenciosamente via flag SKIP_REPEAT.
Para evoluir, você pode experimentar adicionar uma camada leve de LLM (por exemplo, chamando a API da Anthropic ou da OpenAI) para resumir os trechos recuperados em vez de retornar apenas snippets brutos.
Outras melhorias práticas incluem persistir o índice FAISS em disco para reutilização entre sessões, suportar múltiplos PDFs em um único índice, expor parâmetros ajustáveis como BATCH_SIZE e top_k diretamente na UI do Gradio ou adicionar chunking sensível à estrutura (títulos, tabelas e limites de seções) para melhorar a precisão da recuperação.
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Zoumana Keita
8 min