
Kurs
Python ile DeepSeek Kullanımı
3 sa
1.3K
DeepSeek-OCR 2, karmaşık yerleşimleri (çok sütunlu sayfalar, formlar, tablolar, formüller) sabit sol-üstten sağ-alta tarama ile yassılaştırmak yerine daha iyi bir okuma sırası öğrenerek işlemek için tasarlanmış uçtan uca bir belge okuma ve OCR görsel-dil modelidir.
Temel fikir Görsel Nedensel Akıştır; yani model sayfayı tekdüze bir ızgara gibi ele almak yerine, insanların belgeleri okuma biçimini aşamalı ve anlamsal olarak taklit etmeye çalışır. Mimari olarak DeepSeek-OCR 2, DeepSeek-OCR ile aynı kodlayıcı–çözücü çerçevesini korur ancak kodlayıcıyı DeepEncoder V2’ye yükseltir; bu da çözücü metni üretmeden önce nedensel bir token yeniden sıralama mekanizması sunar.
Yüksek düzeyde, DeepSeek OCR-2, sabit koordinat sıralamasına güvenmek yerine okuma sırasını öğrenen bir görsel-dil hattı üzerinden belgeyi metne dönüştürür. Bu şunları içerir:
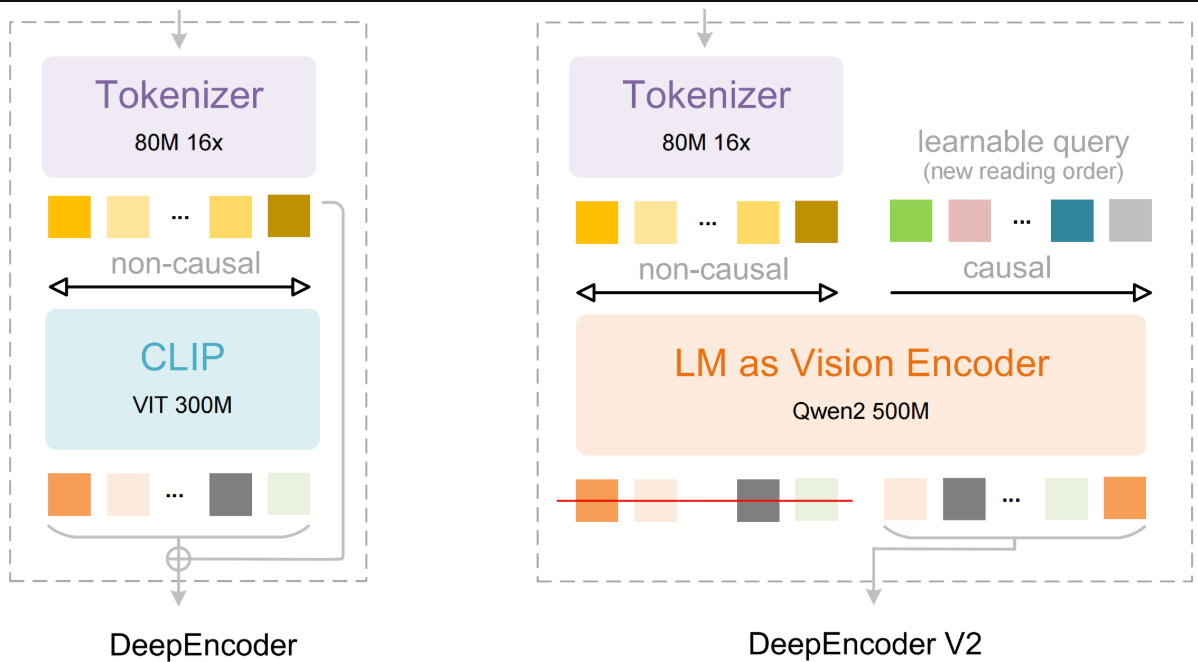
Şekil: DeepSeek-OCR 2: Görsel Nedensel Akış
Koda ayrıntılı bakmak için DeepSeek OCR-2’nin GitHub deposuna başvurabilirsiniz.
Bu bölümde, bir PDF yüklemenize, içeriğini DeepSeek OCR-2 ile çıkarmanıza ve belge hâlâ işlenirken soru sormaya başlamanıza olanak tanıyan gerçek zamanlı bir belge zekası uygulaması kuracağız. Tam OCR’nin tamamlanmasını beklemek yerine sayfalar grup grup aranabilir hale gelir; bu da çok daha hızlı ve etkileşimli bir deneyim sağlar.
Yüksek düzeyde sistem dört temel görevi yerine getirir:
Uygulama iki ana çıktı üretir:
Not: Bu eğitim, DeepSeek’in resmi OCR-2 vLLM demo kodunu temel alır; PDF işleme yardımcısı, çok modlu girdi paketleme, OCR metin temizliği ve vLLM motoru/örnekleme yapılandırması dahil. Bunun üzerine hafif bir RAG katmanı, artımlı dizinlemeyi etkinleştirmek için mini-batch OCR işleme ve bir Gradio uygulaması ekliyorum.
DeepSeek OCR-2’yi vLLM ile çalıştırmadan önce çalışma zamanının hazır olduğundan emin olmalıyız. Bu eğitimde, Google Colab gibi A100 veya T4 GPU’lu bir ortam varsayıyoruz; zira hem vLLM hem de DeepSeek OCR-2 verimli çıkarım için CUDA gerektirir.
Bu adımda şunları yapacağız:
Bu sayede hattın geri kalanının modeli ve yardımcı araçları yol ya da bağımlılık sorunları olmadan yükleyebilmesi sağlanır.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
Bu adım, bir GPU’nun mevcut olduğunu doğrular ve ardından DeepSeek OCR-2 kod tabanını yerelde hazırlar. Yukarıdaki betik, vLLM çıkarımı için ortamda yeterli VRAM olduğundan emin olmak üzere önce nvidia-smi ile mevcut GPU ve belleği kontrol eder.
Daha sonra depo yollarını tanımlar ve gerekli vLLM entegrasyon dizininin zaten mevcut olup olmadığını kontrol eder. Değilse, depoyu yerel bir ZIP’ten çıkarır veya GitHub’dan resmi DeepSeek OCR-2 deposunu klonlar.
Bir sonraki adımda, gerekli bağımlılıkları yükleyip vLLM tabanlı çıkarım için çalışma zamanını hazırlayacağız.
DeepSeek OCR-2 ve vLLM sürümlere karşı oldukça hassastır; bu nedenle bu adımda CUDA 11.8 için çalışan bir paket kümesini sabitliyor, uyumlu bir vLLM tekerleği (wheel) yüklüyor ve daha hızlı dikkat çekirdekleri için flash-attn ekliyoruz.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
Yukarıdaki kod parçacığı, DeepSeek OCR-2’yi vLLM ile çalıştırmak için uyumlu bir çalışma zamanı kurar. Ayrıca uygulamanın destekleyici yığınını da yükler: Transformers, arayüz için Gradio, PDF/görsel işleme için PyMuPDF ve Pillow, ve getirici dizin oluşturmak için SentenceTransformers ile FAISS.
Kurulumdan sonra, ortam değişkenleri istikrarlı vLLM yürütümü ve Triton uyumluluğu için yapılandırılır. Depodaki vLLM entegrasyonu sys.path’e eklenir; böylece özel DeepSeek OCR-2 modeli ve ön işleme modülleri içe aktarılabilir. Son olarak, artımlı sayfa düzeyi RAG dizinlemesini desteklemek için hafif bir gömme modeli (all-MiniLM-L6-v2) yüklenir.
Bir sonraki adımda, bir PDF’i sayfa görsellerine dönüştürmek, her sayfayı DeepSeek OCR-2’nin beklediği çok modlu girdi biçimine paketlemek ve getirici için OCR çıktısını temizlemek üzere ön işleme yardımcılarını uygulayacağız.
DeepSeek OCR-2’yi çalıştırmadan önce, bir PDF’i modele hazır girdilere dönüştüren ve ham OCR çıktısını getirici için temizleyen küçük bir ön işleme yardımcı setine ihtiyacımız var.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
Yukarıdaki yardımcılar üç ana bileşeni tanımlar:
GPU’yu ne kadar verimli kullandığımız ile ilk sonuçların ne kadar hızlı görüneceğini dengelemek için BATCH_SIZE = 5 olarak ayarladık. 20 sayfalık bir PDF için ilerleme %0’dan %25’e, %50’ye, %75’e ve %100’e adım adım güncellenir; %0’dan doğrudan %100’e sıçramaz.
Bu sayede kullanıcılar ilk 5 sayfa dizinlendiğinde soru sormaya başlayabilir. Daha küçük gruplar ilk sonuca kadar olan süreyi kısaltır; daha büyük gruplar ise verimi ve GPU kullanımını artırır.
PyMuPDF kütüphanesini kullanan özgün uygulamadaki yerel pdf_to_images_high_quality() işlev kodunu kullandık ve her sayfayı 144 DPI’de ( zoom = 144 / 72.0 = 2.0 ifadesinden gelir; varsayılan 72 DPI çözünürlüğü ikiye katlar) PIL görseline işledik.
dpi/72 yakınlaştırma matrisi rasterizasyon kalitesini kontrol eder ve alpha=False saydamlık kaynaklı artefaktları önler. Görsel yine de bir alfa kanalı içeriyorsa, işlev bunu beyaz arka plana düzleştirir; böylece OCR’ı zayıflatabilecek tuhaf karışmalar engellenir.
process_single_image() işlevi (özgün kod tabanından) her sayfa görselini vLLM’in beklediği tam sözlük yapısına (prompt + multi_modal_data.image) sarmalar ve tüm görsel ön işleme hattını yöneten DeepseekOCR2Processor().tokenize_with_images()’ı kullanır. Bu hat; en-boy oranına göre dynamic_preprocess() ile büyük görselleri 2–6 döşemeye bölmeyi, dolgulu 1024×1024 küresel görünüm oluşturmayı, tensör normalizasyonunu uygulamayı ve DeepseekOCR2ForCausalLM’in tükettiği görsel maskeleriyle tam token dizisini üretmeyi içerir.
Depodaki config.CROP_MODE, bu dinamik döşemenin uygulanıp uygulanmayacağını kontrol eder; bu da küçük metinlerle yoğun yerleşimlerde doğruluğu artırır.
Üretimden sonra clean_ocr_output(), özel cümle sonu token’larını temizler, tespit işaretleme bloklarını (<|ref|>...<|/ref|><|det|>...<|/det|>) kaldırır, bazı LaTeX benzeri operatörleri normalleştirir ve aşırı satır sonlarını sadeleştirir; böylece daha iyi parçalanan ve aşağı akıştaki RAG dizininde daha güvenilir getirilen daha temiz metin elde edilir.
Sırada, bu temizlenmiş çıktıyı hafif bir sayfa düzeyi RAG dizini oluşturmak için kullanacağız; böylece her grup bittiği anda sayfalar aranabilir hale gelir.
Artık her sayfadan temiz metin çıkarabildiğimize göre, sıradaki adım bunu anında aranabilir hale getirmektir. Tüm belgenin işlenmesini beklemek yerine, içeriği artımlı olarak dizinleyen hafif bir sayfa düzeyi Getirimle Desteklenmiş Üretim (RAG) motoru kuruyoruz.
Her bir sayfa grubu işlendiğinde, metin gömülür ve FAISS dizinine eklenir; böylece kullanıcılar dizinleme hâlâ sürerken belgeyi sorgulayabilir.
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
Yukarıdaki sınıf dört ana bileşeni tanımlar:
faiss.IndexFlatIP kullanır. Her sayfa işlendiğinde, içeriği anında gömülür ve dizine eklenir; böylece dizini yeniden oluşturmaya gerek kalmadan gerçek zamanlı getirime olanak tanır._split() yöntemi, uzun sayfa metnini paragraf sınırlarına göre yaklaşık 1000 karakterlik parçalara böler. Bu, anlamsal eşleşmeyi iyileştirir ve aşırı uzun, gürültülü bağlamları gömmekten kaçınırken kaynak atfı için sayfa numaralarını korur.threading.Lock(), dizin güncellemelerini ve okumalarını korur. query() yöntemi kullanıcı sorusunu gömer, en benzer top-k parçaları getirir ve eşleşen metni sayfa numaraları ve benzerlik puanlarıyla birlikte döndürür. indexed_pages özelliği, arayüzün kaç sayfanın aranabilir olduğunu gösterebilmesi için ilerlemeyi izler.Bu adımda, vLLM kullanarak DeepSeek OCR-2 çıkarım motorunu başlatıyoruz. Bu, token’lanmış sayfa görsellerini alıp yapılandırılmış OCR metni üreterek çok modlu üretimi gerçekleştiren çekirdek bileşendir. Yapılandırma, resmi DeepSeek OCR-2 vLLM referans kurulumunu izler; ancak modeli yalnızca işlem başladığında yükleyen tembel bir yükleyici load_ocr_engine() içine sarıyoruz. Bu, başlangıç süresini kısaltır ve gereksiz GPU ayırmalarını önler.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
Bu kod parçacığı şu çekirdek bileşenleri tanımlar:
DeepseekOCR2ForCausalLM sınıfını vLLM’e bağlar; böylece DeepseekOCR2Processor tarafından üretilen görsel-token girdilerini işleyebilir.LLM() parametreleri, block_size=256, max_model_len=8192, gpu_memory_utilization=0.9 ve disable_mm_preprocessor_cache=True dahil olmak üzere deponun referans ayarlarıyla eşleşir. Bu ayarlar, GPU bellek kullanımını öngörülebilir tutarken istikrarlı ve yüksek verimli OCR çıkarımı için ayarlanmıştır.temperature=0.0, büyük çıktı sınırları ve uzun biçimli OCR üretiminde sık görülen yinelenen metin kalıplarını önlemek için bir NoRepeatNGramLogitsProcessor.load_ocr_engine() ilk kez çağrıldığında bir kez yüklenir. Sonraki çağrılar aynı örneği yeniden kullanır; bu da yinelenen GPU başlatımlarını önler ve arayüzü duyarlı tutar.Şimdi bu motoru, sayfa sayfa OCR çalıştıran ve sonuçları gerçek zamanlı sorgulama için RAG dizinine akan bir grup işleme döngüsüne bağlayalım.
Bu adım uygulamanın kalbidir. Yüklenen bir PDF’i tüm belge için OCR’nin bitmesini beklemek yerine aşamalı olarak aranabilir bir dizine dönüştüren bir arka plan işçisi uygularız.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
Hattımızın akışı; sayfaların işlenmesi, girdilerin ön işlenmesi, vLLM çıkarımının mini-batch’lerde çalıştırılması, ardından OCR çıktısının temizlenmesi ve son olarak her sayfanın FAISS destekli PageRAG’e eklenmesini içerir. Her adımın ayrıntılı analizi:
total_pages, is_processing, processing_error, stop_requested) ilerlemeyi ve hata durumlarını izler; böylece arayüz canlı durumu gösterebilir, durdurma/sıfırlamayı ele alabilir ve çakışan çalışmalardan kaçınır.ThreadPoolExecutor(max_workers=config.NUM_WORKERS), sayfa görsellerini paralel olarak modele hazır çok modlu girdilere dönüştürür. Bu, girdilerin çıkarımdan önce hazırlanmasını sağlayarak GPU’yu daha sonra meşgul tutar.ocr_llm.generate()’i tüm sayfalar üzerinde bir kez çalıştırmak (resmi betiğin varsayılanı) yerine, kod num_batches’i hesaplar ve sayfaları BATCH_SIZE büyüklüğünde parçalarda işler. Bu, artımlı dizinlemeyi etkinleştirir; böylece kullanıcılar tüm belgeyi beklemek yerine ilk 5 sayfa (BATCH_SIZE = 5) dizinlendikten sonra soru sormaya başlayabilir.stop_requested, maliyetli aşamalardan önce ve her grubun başında kontrol edilir. Böylece Durdur düğmesi öngörülebilir davranır: Mevcut grup bittikten sonra, gruplar arasında durdurur; yarım yazılmış durumlar veya kısmi çıktılarla karşılaşmazsınız.Bu noktada, bir PDF’i büyüyen bir arama dizinine dönüştüren uçtan uca bir hattımız var; böylece kullanıcılar arka planda işlem sürerken belgeyi sorgulayabilir. Sırada, bu işçiyi Gradio uygulamasına bağlayan arayüz geri çağrılarını (callback) ekleyeceğiz.
Bu aşamada, OCR ve dizinleme hattı arka planda çalışıyor; ancak uygulamanın, kullanıcı eylemlerini işlem mantığına bağlayan bir kontrol katmanına hâlâ ihtiyacı var.
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
Bu kontrol katmanı beş temel sorumluluğu üstlenir:
start_processing() işlevi girdiyi doğrular, RAG dizinini sıfırlar ve process_pdf_background()’ı bir daemon iş parçacığında başlatır. stop_processing() işlevi yürütmeyi anında sonlandırmak yerine bir stop_requested bayrağı ayarlar. Arka plan işçisi bu bayrağı gruplar arasında kontrol eder; bu da dizini bozmadan temiz bir şekilde durmayı sağlar.reset_all() işlevi FAISS dizinini, ilerleme sayaçlarını ve hata durumunu temizler. Ayrıca, işlem devam ederken yanlışlıkla sıfırlamayı engeller; bu da tutarsız uygulama durumlarına karşı korur.refresh_progress() işlevi, PageRAG’den dizinlenen sayfa sayısını okuyup dinamik bir HTML ilerleme çubuğu oluşturur. Yükleme, etkin işleme, durdurma, tamamlama veya hata gibi sistem durumlarını da iletir.Son adımda, bu geri çağrıları Gradio arayüzüne bağlayarak tüm iş akışını basit bir web arayüzü üzerinden sunacağız.
Bu son adımda, her şeyi basit bir Gradio uygulamasına sarıyoruz. Arayüz, kullanıcıların bir PDF yüklemesine, işlemeyi başlatmasına ve dizinleme tamamlanmadan önce soru sormaya başlamasına olanak tanıyacak şekilde tasarlanmıştır.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
Gradio uygulaması iki sütundan oluşur. Sol sütunda PDF yükleme aracı ve İşle/Durdur/Sıfırla düğmeleri bulunurken, sağ sütun canlı bir HTML ilerleme çubuğu gösterir. Bu, OCR hâlâ çalışırken bile uygulamanın duyarlı hissettirmesini sağlar. Uygulamamızın bazı temel özellikleri şunlardır:
gr.Timer(2), her iki saniyede bir refresh_progress()’u çağırır ve ilerleme çubuğu HTML’ini günceller. Dizinleme gruplar halinde yapıldığından, kullanıcılar ilerlemeyi adımlı olarak görür (ve iletiler yükleme, durdurma, hata veya tamamlama gibi durumlara göre değişir)..click() işleyicileri, arayüz eylemlerini doğrudan arka uç işlevlerinize bağlar; örneğin start_processing() arka plan işçisini başlatır, stop_processing() temiz bir durdurma ister, reset_all() durumu temizler ve answer_question() şimdiye kadar dizinlenmiş sayfalar üzerinde getirimi çalıştırır.Son olarak, demo.launch() uygulamayı Colab’de başlatır, paylaşılabilir bir bağlantı sunar, arayüzü satır içi olarak gösterir ve geliştirme sırasında sorunları teşhis etmeye yardımcı olmak için hata ayıklama günlüklerini etkinleştirir.
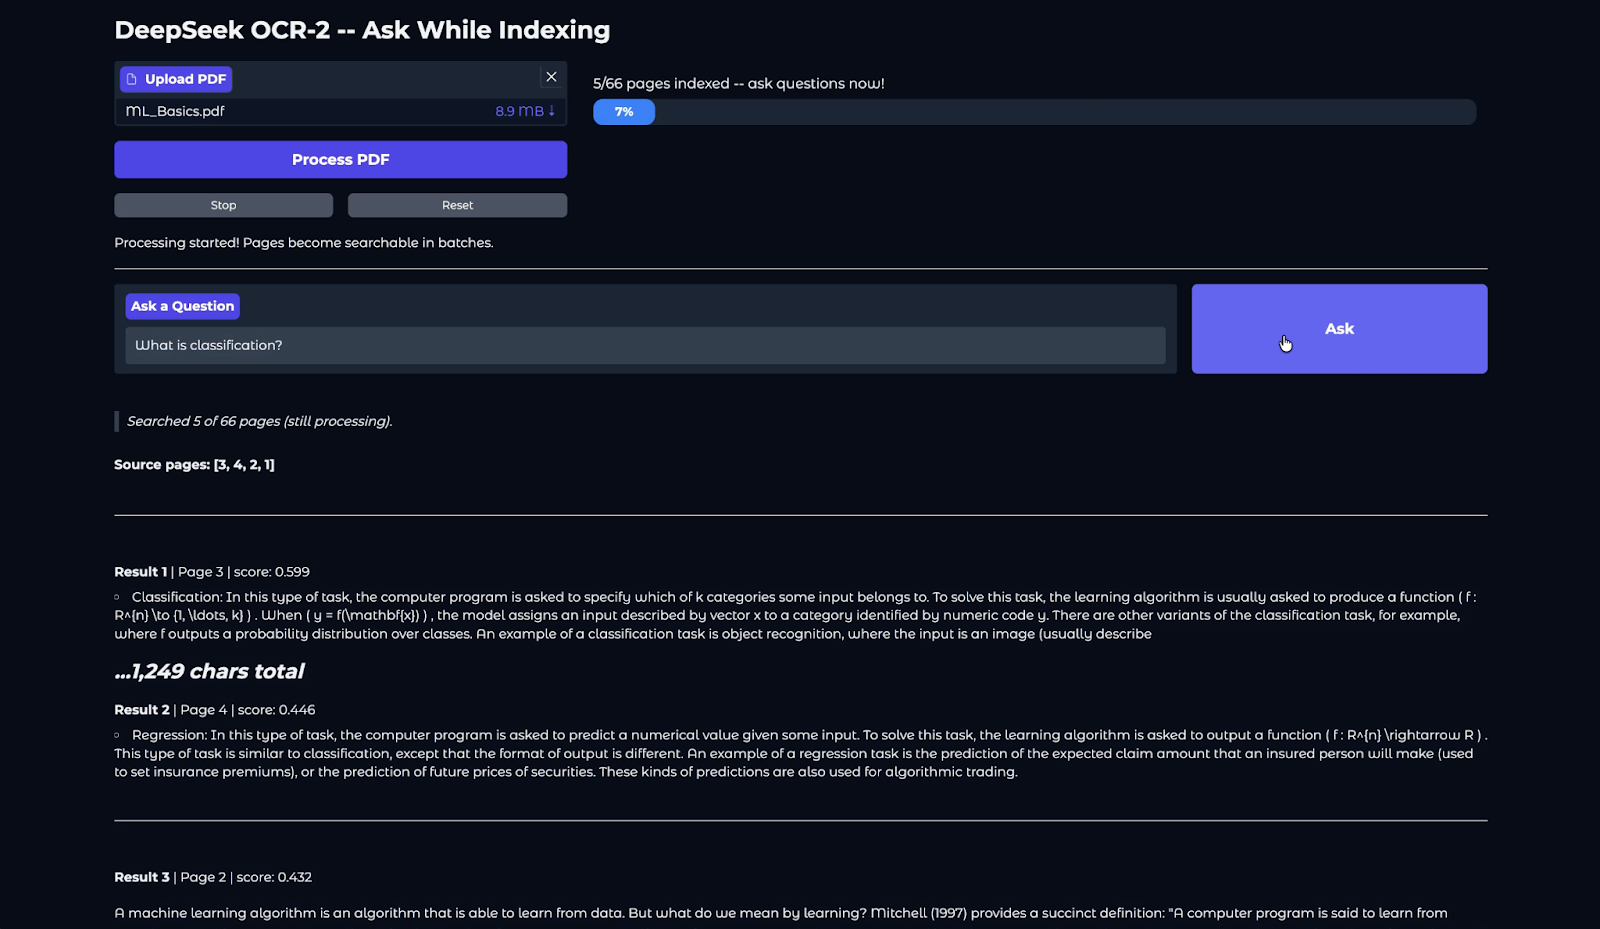
Bu eğitimde, DeepSeek OCR-2 kullanarak eksiksiz bir görsel öncelikli belge zekası hattı kurduk. Ham bir PDF’den başlayarak sayfaları yüksek kaliteli görsellere dönüştürdük, vLLM üzerinden çok modlu OCR çalıştırdık, çıkarılan metni temizleyip yapılandırdık ve onu FAISS tabanlı bir RAG deposuna artımlı olarak dizinledik.
Sayfaları mini-batch’lerde işleyerek, kullanıcıların tamamlama beklemek yerine ilk grubun ardından belgeyi sorgulamaya başlayabildiği bir “dizinlerken sor” deneyimi sağladık.
Bununla birlikte, test sırasında iki belirgin sınırlama ortaya çıktı. Formül ağırlıklı bölgeler her zaman doğru şekilde yazıya dökülmüyor; bu, dayanaklayıcı istemlere rağmen görsel-dil OCR modelleri için bilinen bir zorluktur.
Ayrıca bazı uzun sayfalarda yinelenen çıktı kalıpları görülüyor. Resmi hat, bunu NoRepeatNGramLogitsProcessor (ngram_size=20) ile hafifletiyor; ancak yoğun tablolar ve çok sütunlu yerleşimler yine de üretim döngülerini tetikleyebiliyor; bu durumda sayfa SKIP_REPEAT bayrağı aracılığıyla sessizce atlanıyor.
Bunu daha ileri taşımak için, okuyucular getirilen parçaları ham olarak döndürmek yerine özetlemek amacıyla hafif bir LLM katmanı (örneğin Anthropic veya OpenAI API çağrıları) eklemeyi deneyebilir.
Diğer pratik iyileştirmeler arasında FAISS dizinini oturumlar arasında yeniden kullanım için diske kalıcı hale getirmek, tek bir dizinde birden fazla PDF’i desteklemek, BATCH_SIZE ve top_k gibi ayarlanabilir parametreleri doğrudan Gradio arayüzünde sunmak veya getirimin hassasiyetini artırmak için yapıya duyarlı parçalama (başlıklar, tablolar ve bölüm sınırları) eklemek yer alır.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



