
Last chance! 50% off DataCamp Premium
Sale ends in
DeepSeek-OCR 2 adalah model visi-bahasa end-to-end untuk pembacaan dokumen sekaligus OCR yang dirancang untuk menangani tata letak kompleks (halaman multikolom, formulir, tabel, rumus) dengan mempelajari urutan baca yang lebih baik alih-alih meratakan potongan gambar dalam pemindaian raster tetap dari kiri-atas ke kanan-bawah.
Gagasan intinya adalah Visual Causal Flow, yaitu model berusaha meniru cara manusia membaca dokumen, secara progresif dan semantik, bukan memperlakukan halaman seperti grid yang seragam. Secara arsitektural, DeepSeek-OCR 2 mempertahankan kerangka encoder–decoder seperti DeepSeek-OCR, tetapi meningkatkan encoder menjadi DeepEncoder V2, yang memperkenalkan mekanisme penyusunan ulang token kausal sebelum decoder menghasilkan teks.
Secara garis besar, DeepSeek OCR-2 mengonversi dokumen menjadi teks melalui pipeline visi-bahasa yang mempelajari urutan baca alih-alih mengandalkan pengurutan koordinat tetap. Ini mencakup:
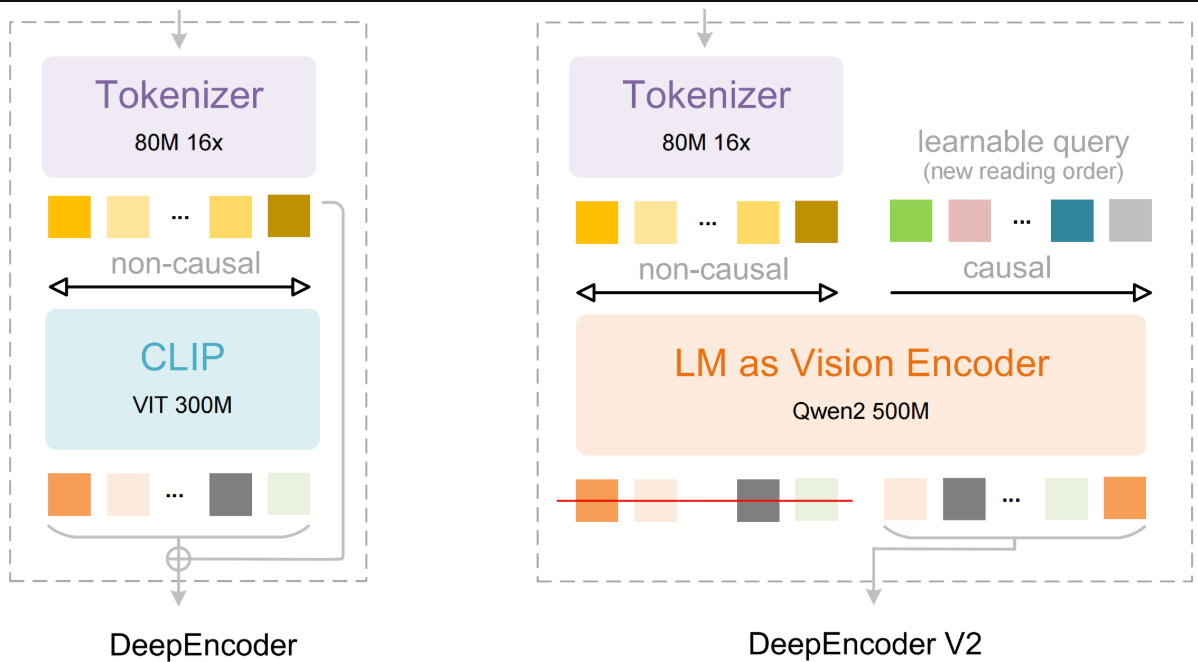
Gambar: DeepSeek-OCR 2: Visual Causal Flow
Anda dapat merujuk ke repositori GitHub DeepSeek OCR-2 untuk menelusuri kodenya secara detail.
Pada bagian ini, kita akan membangun aplikasi intelijen dokumen waktu nyata yang memungkinkan Anda mengunggah PDF, mengekstrak kontennya menggunakan DeepSeek OCR-2, dan mulai mengajukan pertanyaan saat dokumen masih diproses. Alih-alih menunggu OCR penuh selesai, halaman menjadi dapat dicari per batch, menghadirkan pengalaman yang jauh lebih cepat dan interaktif.
Secara garis besar, sistem melakukan empat tugas inti:
Aplikasi ini menghasilkan dua keluaran utama:
Catatan: Tutorial ini dibangun di atas kode demo resmi OCR-2 vLLM milik DeepSeek, termasuk pembantu perenderan PDF, pengemasan input multimodal, pembersihan teks OCR, dan konfigurasi engine/sampling vLLM. Di atas itu, saya menambahkan lapisan RAG ringan, pemrosesan OCR mini-batch untuk memungkinkan pengindeksan inkremental, dan aplikasi Gradio.
Sebelum menjalankan DeepSeek OCR-2 dengan vLLM, kita perlu memastikan lingkungan runtime siap. Dalam tutorial ini, kita mengasumsikan lingkungan berkemampuan GPU seperti Google Colab dengan A100 atau T4, karena vLLM dan DeepSeek OCR-2 sama-sama memerlukan CUDA untuk inferensi yang efisien.
Pada langkah ini, kita akan:
Ini memastikan sisa pipeline dapat memuat model dan utilitas pendukung tanpa masalah path atau dependensi.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
Langkah ini memverifikasi bahwa GPU tersedia lalu menyiapkan basis kode DeepSeek OCR-2 secara lokal. Skrip di atas terlebih dahulu memeriksa GPU dan memori yang tersedia menggunakan nvidia-smi untuk memastikan lingkungan memiliki VRAM yang cukup untuk inferensi vLLM.
Kemudian, mendefinisikan path repositori dan memeriksa apakah direktori integrasi vLLM yang diperlukan sudah ada. Jika tidak, skrip mengekstrak repositori dari ZIP lokal atau mengklon repositori resmi DeepSeek OCR-2 dari GitHub.
Pada langkah berikutnya, kita akan menginstal dependensi yang dibutuhkan dan menyiapkan runtime untuk inferensi berbasis vLLM.
DeepSeek OCR-2 dan vLLM sangat sensitif terhadap versi, jadi pada langkah ini, kita menyematkan serangkaian paket yang berfungsi untuk CUDA 11.8, memasang wheel vLLM yang sesuai, dan menambahkan flash-attn untuk kernel attention yang lebih cepat.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
Cuplikan kode di atas memasang runtime yang kompatibel untuk DeepSeek OCR-2 dengan vLLM. Kode tersebut juga memasang tumpukan pendukung aplikasi, termasuk Transformers, Gradio untuk UI, PyMuPDF dan Pillow untuk pemrosesan PDF/gambar, dan SentenceTransformers dengan FAISS untuk membangun indeks retrieval.
Setelah instalasi, variabel lingkungan dikonfigurasi untuk eksekusi vLLM yang stabil dan kompatibilitas Triton. Integrasi vLLM repositori ditambahkan ke sys.path agar model DeepSeek OCR-2 kustom dan modul prapemrosesan dapat diimpor, dan akhirnya, model embedding ringan (all-MiniLM-L6-v2) dimuat untuk mendukung pengindeksan RAG tingkat halaman secara inkremental.
Pada langkah berikutnya, kita akan menerapkan utilitas prapemrosesan untuk mengonversi PDF menjadi gambar halaman, mengemas setiap halaman ke format input multimodal yang diharapkan oleh DeepSeek OCR-2, dan membersihkan keluaran OCR untuk retrieval.
Sebelum kita dapat menjalankan DeepSeek OCR-2, kita memerlukan serangkaian kecil utilitas prapemrosesan yang mengonversi PDF menjadi input siap model dan membersihkan keluaran OCR mentah untuk retrieval.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
Utilitas di atas mendefinisikan tiga komponen kunci:
Kita menetapkan BATCH_SIZE = 5 untuk mengendalikan seberapa cepat hasil pertama muncul dibandingkan efisiensi penggunaan GPU. Untuk PDF 20 halaman, progres diperbarui bertahap dari 0% ke 25% ke 50% ke 75% ke 100%, alih-alih melompat langsung dari 0% ke 100%.
Ini memungkinkan pengguna mulai bertanya segera setelah 5 halaman pertama diindeks. Batch yang lebih kecil mempercepat waktu ke hasil pertama, sementara batch lebih besar meningkatkan throughput dan pemanfaatan GPU.
Kami menggunakan kode fungsi pdf_to_images_high_quality() asli dari implementasi awal menggunakan pustaka PyMuPDF untuk merender setiap halaman menjadi gambar PIL pada 144 DPI (berasal dari zoom = 144 / 72.0 = 2.0, yang menggandakan resolusi default 72 DPI).
Matriks zoom dpi/72 mengontrol kualitas rasterisasi, dan alpha=False menghindari artefak transparansi. Jika gambar masih memiliki saluran alfa, fungsi akan meratakannya ke latar belakang putih untuk mencegah blending aneh yang dapat menurunkan kualitas OCR.
Fungsi process_single_image() (dari basis kode asli) membungkus setiap gambar halaman ke dalam struktur dict yang persis diharapkan vLLM (prompt + multi_modal_data.image), menggunakan DeepseekOCR2Processor().tokenize_with_images() yang menangani seluruh pipeline prapemrosesan gambar termasuk pemecahan gambar besar menjadi 2–6 tile melalui dynamic_preprocess() berdasarkan rasio aspek, membuat tampilan global 1024×1024 yang dipadding, menerapkan normalisasi tensor, dan menghasilkan urutan token lengkap dengan mask gambar yang dikonsumsi DeepseekOCR2ForCausalLM.
Parameter config.CROP_MODE pada repo mengontrol apakah tiling dinamis ini diterapkan, yang meningkatkan akurasi pada tata letak padat dengan teks kecil.
Setelah generasi, clean_ocr_output() menghilangkan token akhir kalimat khusus, membuang blok markup deteksi (<|ref|>...<|/ref|><|det|>...<|/det|>), menormalkan beberapa operator mirip LaTeX, dan merapikan jeda baris berlebih, menghasilkan teks yang lebih bersih sehingga lebih baik dipotong dan lebih andal diambil kembali dalam indeks RAG hilir.
Berikutnya, kita akan menggunakan keluaran yang sudah dibersihkan ini untuk membangun indeks RAG ringan tingkat halaman, sehingga halaman menjadi dapat dicari segera setelah setiap batch selesai.
Sekarang kita dapat mengekstrak teks bersih dari setiap halaman, langkah berikutnya adalah membuatnya segera dapat dicari. Alih-alih menunggu seluruh dokumen selesai diproses, kita membangun engine Retrieval-Augmented Generation (RAG) tingkat halaman yang mengindeks konten secara inkremental.
Saat setiap batch halaman diproses, teksnya di-embed dan ditambahkan ke indeks FAISS, memungkinkan pengguna mengkueri dokumen saat pengindeksan masih berlangsung.
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
Kelas di atas mendefinisikan empat komponen kunci:
faiss.IndexFlatIP untuk pencarian kemiripan cepat atas embedding yang dinormalisasi. Saat setiap halaman diproses, kontennya langsung di-embed dan ditambahkan ke indeks, memungkinkan retrieval waktu nyata tanpa membangun ulang indeks._split() memecah teks halaman panjang menjadi chunk ~1000 karakter berdasarkan batas paragraf. Ini meningkatkan pencocokan semantik dan menghindari embedding konteks yang terlalu panjang dan berisik sambil tetap mempertahankan nomor halaman untuk atribusi sumber.threading.Lock() melindungi pembaruan dan pembacaan indeks. query() melakukan embedding pertanyaan pengguna, mengambil top-k chunk serupa, dan mengembalikan teks yang cocok beserta nomor halaman dan skor kemiripan. Properti indexed_pages melacak progres sehingga UI dapat menampilkan berapa banyak halaman yang sudah dapat dicari.Pada langkah ini, kita menginisialisasi engine inferensi DeepSeek OCR-2 menggunakan vLLM. Ini adalah komponen inti yang melakukan generasi multimodal dengan mengambil gambar halaman yang sudah ditokenisasi dan menghasilkan teks OCR terstruktur. Konfigurasi mengikuti pengaturan referensi vLLM DeepSeek OCR-2 resmi, tetapi kita membungkusnya dalam pemuat malas load_ocr_engine() sehingga model hanya dimuat saat pemrosesan dimulai, mengurangi waktu startup dan menghindari alokasi GPU yang tidak perlu.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
Cuplikan kode ini mendefinisikan komponen inti berikut:
DeepseekOCR2ForCausalLM dari repositori ke vLLM agar dapat menangani input token gambar yang dihasilkan oleh DeepseekOCR2Processor.LLM() sesuai dengan pengaturan referensi repositori, termasuk block_size=256, max_model_len=8192, gpu_memory_utilization=0.9, dan disable_mm_preprocessor_cache=True. Pengaturan ini disetel untuk inferensi OCR ber-throughput tinggi yang stabil sambil menjaga penggunaan memori GPU tetap terprediksi.temperature=0.0, batas keluaran besar, dan NoRepeatNGramLogitsProcessor untuk mencegah pola teks berulang, yang umum terjadi pada generasi OCR bentuk panjang.load_ocr_engine() pertama kali dipanggil. Pemanggilan berikutnya menggunakan instance yang sama, sehingga menghindari inisialisasi GPU berulang dan menjaga UI tetap responsif.Sekarang, mari hubungkan engine ini ke loop pemrosesan batch yang menjalankan OCR per halaman dan mengalirkan hasilnya ke indeks RAG untuk kueri waktu nyata.
Langkah ini adalah inti aplikasi. Kami menerapkan pekerja latar belakang yang mengambil PDF yang diunggah dan secara bertahap mengubahnya menjadi indeks yang dapat dicari, alih-alih menunggu seluruh dokumen selesai OCR.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
Alur pipeline kita mencakup perenderan halaman, prapemrosesan input, menjalankan inferensi vLLM dalam mini-batch, lalu membersihkan keluaran OCR, dan akhirnya menambahkan setiap halaman ke PageRAG yang didukung FAISS. Berikut analisis detail tiap langkah:
total_pages, is_processing, processing_error, stop_requested) melacak progres dan mode kegagalan sehingga UI dapat menampilkan status langsung, menangani stop/reset, dan menghindari proses yang saling bertentangan.ThreadPoolExecutor(max_workers=config.NUM_WORKERS) mengonversi gambar halaman menjadi input multimodal siap model secara paralel. Ini menjaga GPU tetap sibuk nanti dengan memastikan input siap sebelum inferensi.ocr_llm.generate() sekali untuk semua halaman (default skrip resmi), kode menghitung num_batches dan memproses halaman dalam potongan BATCH_SIZE. Ini memungkinkan pengindeksan progresif, sehingga pengguna dapat mulai bertanya setelah 5 halaman pertama (BATCH_SIZE = 5) diindeks, bukan menunggu seluruh dokumen.stop_requested diperiksa sebelum tahap mahal dan di awal setiap batch. Ini membuat tombol Stop dapat diprediksi: proses berhenti di antara batch, setelah batch saat ini selesai, sehingga Anda tidak berakhir pada keadaan setengah tulis atau keluaran parsial.Pada titik ini, kita memiliki pipeline end-to-end yang mengonversi PDF menjadi indeks pencarian yang terus bertambah, sehingga pengguna dapat mengkueri dokumen saat pemrosesan berlanjut di latar belakang. Selanjutnya, kita akan menambahkan callback UI yang menghubungkan pekerja ini ke aplikasi Gradio.
Pada tahap ini, pipeline OCR dan pengindeksan berjalan di latar belakang, tetapi aplikasi masih memerlukan lapisan kontrol yang menghubungkan aksi pengguna ke logika pemrosesan.
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
Lapisan kontrol ini menangani lima tanggung jawab inti:
start_processing() memvalidasi input, mereset indeks RAG, dan meluncurkan process_pdf_background() dalam thread daemon. stop_processing() menetapkan flag stop_requested alih-alih segera menghentikan eksekusi. Pekerja latar belakang memeriksa flag ini di antara batch, memastikan sistem berhenti dengan bersih tanpa merusak indeks.reset_all() ini membersihkan indeks FAISS, penghitung progres, dan status error. Fungsi ini juga mencegah reset tidak sengaja saat pemrosesan masih aktif, yang melindungi dari keadaan aplikasi yang tidak konsisten.refresh_progress() untuk membaca jumlah halaman yang diindeks dari PageRAG dan menghasilkan bilah progres HTML dinamis. Fungsi ini juga mengomunikasikan status sistem seperti memuat, memproses aktif, menghentikan, selesai, atau error.Pada langkah terakhir, kita akan menghubungkan callback ini ke antarmuka Gradio untuk menampilkan alur kerja lengkap melalui UI web sederhana.
Pada langkah akhir ini, kita membungkus semuanya ke dalam aplikasi Gradio sederhana. UI dirancang agar pengguna dapat mengunggah PDF, memulai pemrosesan, dan mulai bertanya sebelum pengindeksan selesai.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
Aplikasi Gradio berisi dua kolom. Kolom kiri berisi widget unggah PDF dan tombol Process/Stop/Reset, sementara kolom kanan menampilkan bilah progres HTML langsung. Ini membuat aplikasi terasa responsif bahkan saat OCR masih berjalan. Berikut beberapa fitur kunci aplikasi kita:
gr.Timer(2) memanggil refresh_progress() setiap dua detik dan memperbarui HTML bilah progres. Karena pengindeksan terjadi per batch, pengguna melihat progres bergerak bertahap (dan pesan berubah berdasarkan status seperti memuat, menghentikan, error, atau selesai)..click() menghubungkan aksi UI langsung ke fungsi backend, misalnya start_processing() meluncurkan pekerja latar belakang, stop_processing() meminta penghentian bersih, reset_all() menghapus status, dan answer_question() menjalankan retrieval atas halaman yang sudah diindeks sejauh ini.Terakhir, demo.launch() meluncurkan aplikasi di Colab, menyediakan tautan yang dapat dibagikan, merendernya secara inline, dan mengaktifkan log debug untuk membantu mendiagnosis masalah selama pengembangan.
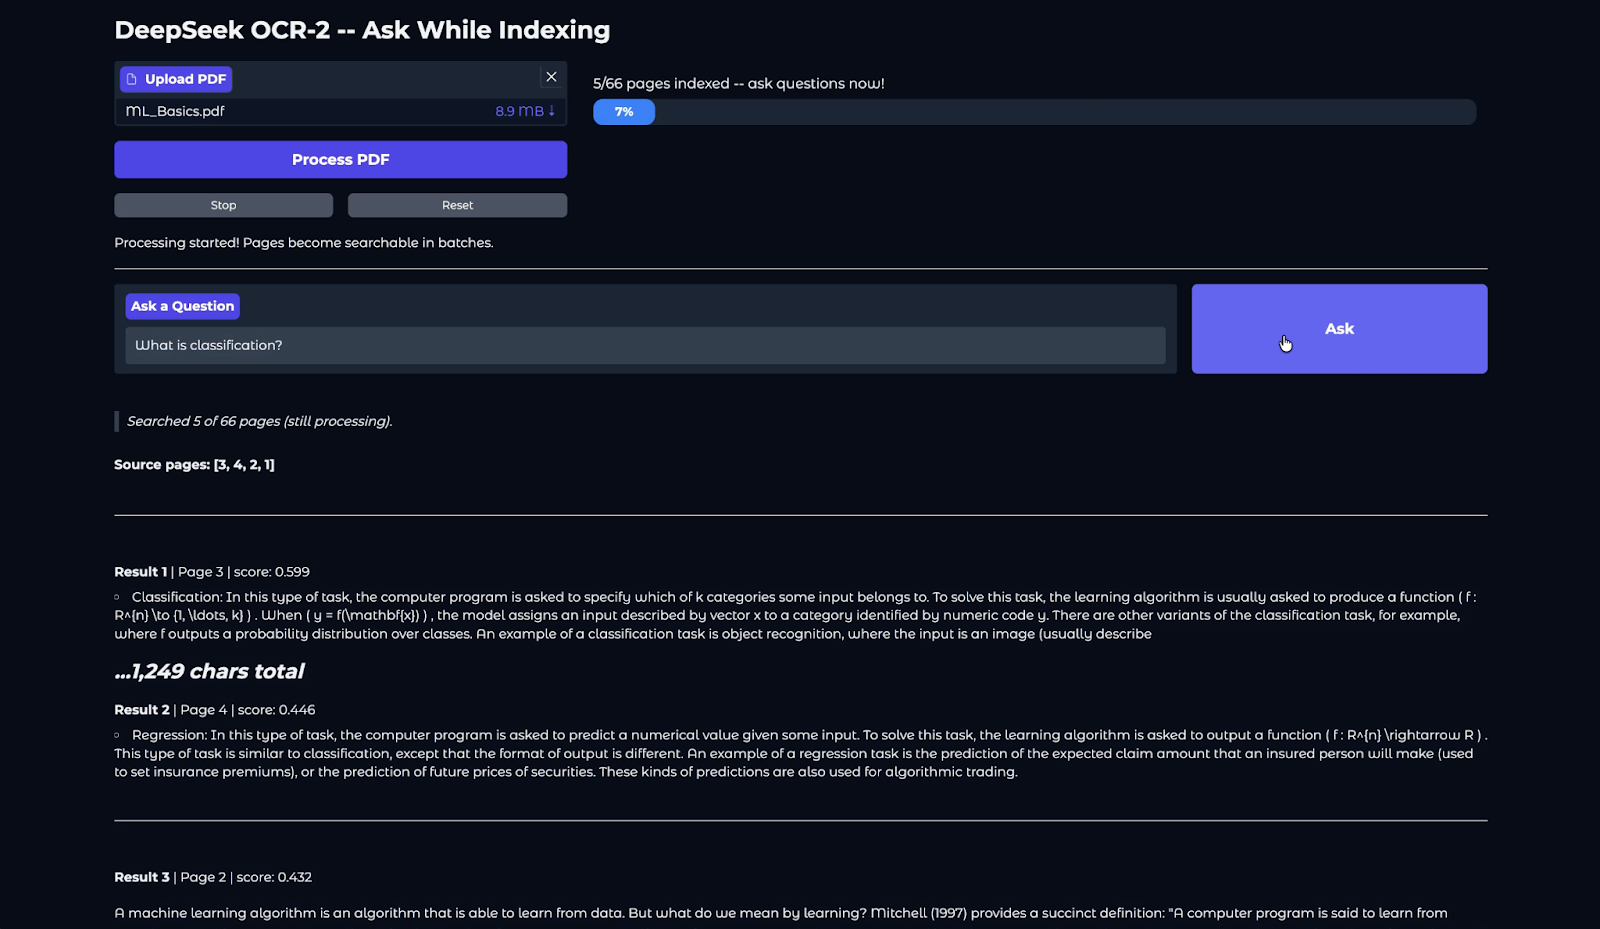
Dalam tutorial ini, kita membangun pipeline intelijen dokumen berfokus visi yang lengkap menggunakan DeepSeek OCR-2. Dimulai dari PDF mentah, kita merender halaman menjadi gambar berkualitas tinggi, menjalankan OCR multimodal melalui vLLM, membersihkan dan menstrukturkan teks yang diekstraksi, serta mengindeksnya secara inkremental ke dalam penyimpanan RAG berbasis FAISS.
Dengan memproses halaman dalam mini-batch, aplikasi menghadirkan pengalaman “tanya sambil mengindeks” di mana pengguna dapat mulai mengkueri dokumen setelah batch pertama, alih-alih menunggu hingga selesai sepenuhnya.
Namun, dua keterbatasan mencolok muncul selama pengujian. Wilayah yang banyak rumus tidak selalu ditranskripsikan dengan akurat, yang merupakan tantangan umum bagi model OCR visi-bahasa, bahkan dengan prompt berbasis grounding.
Selain itu, beberapa halaman yang lebih panjang menunjukkan pola keluaran berulang. Pipeline resmi mengurangi hal ini dengan NoRepeatNGramLogitsProcessor (ngram_size=20), tetapi tabel padat dan tata letak multikolom masih dapat memicu loop generasi; dalam kasus tersebut, halaman dilewati secara senyap melalui flag SKIP_REPEAT.
Untuk melangkah lebih jauh, pembaca dapat bereksperimen dengan menambahkan lapisan LLM ringan (misalnya, memanggil API Anthropic atau OpenAI) untuk meringkas chunk yang diambil alih-alih mengembalikan potongan mentah.
Peningkatan praktis lainnya termasuk menyimpan indeks FAISS ke disk untuk digunakan kembali lintas sesi, mendukung beberapa PDF dalam satu indeks, mengekspos parameter yang dapat diatur seperti BATCH_SIZE dan top_k langsung di UI Gradio, atau menambahkan chunking yang sadar struktur (judul, tabel, dan batas bagian) untuk meningkatkan presisi retrieval.
Kursus Terbaik di DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt





