
Cursus
Werken met DeepSeek in Python
3 uur
1.3K
DeepSeek-OCR 2 is een end-to-end documentleessysteem plus OCR vision-language-model dat is ontworpen om complexe lay-outs (meerkoloms pagina's, formulieren, tabellen, formules) aan te kunnen door een betere leesvolgorde te leren in plaats van afbeeldingspatches te flattenen in een vaste raster-scan van linksboven naar rechtsonder.
Het kernidee is Visual Causal Flow, oftewel: het model probeert na te bootsen hoe mensen documenten lezen, geleidelijk en semantisch, in plaats van de pagina te behandelen als een uniforme raster. Architectonisch behoudt DeepSeek-OCR 2 dezelfde encoder-decoder-opzet als DeepSeek-OCR, maar wordt de encoder geüpgraded naar DeepEncoder V2, die een causale herordening van tokens introduceert voordat de decoder tekst genereert.
Op hoofdlijnen zet DeepSeek OCR-2 een document om naar tekst via een vision-language-pijplijn die de leesvolgorde leert in plaats van te vertrouwen op vaste coördinatensortering. Dit omvat:
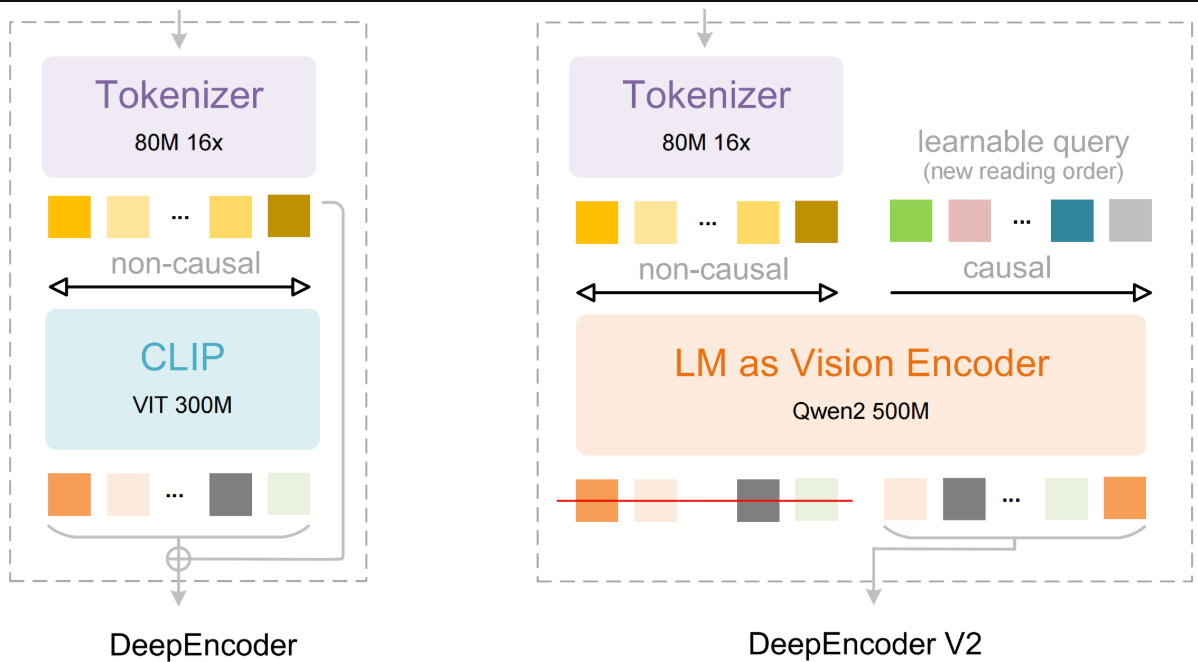
Figuur: DeepSeek-OCR 2: Visual Causal Flow
Raadpleeg de DeepSeek OCR-2-GitHub-repository om de code in detail te verkennen.
In dit gedeelte bouwen we een realtime documentintelligentie-app waarmee je een PDF kunt uploaden, de inhoud ervan kunt extraheren met DeepSeek OCR-2 en alvast vragen kunt stellen terwijl het document nog wordt verwerkt. In plaats van te wachten tot de volledige OCR klaar is, worden pagina's batch voor batch doorzoekbaar, wat zorgt voor een veel snellere en interactievere ervaring.
Op hoofdlijnen voert het systeem vier kerntaken uit:
De applicatie levert twee hoofdoutputs op:
Opmerking: Deze tutorial bouwt voort op DeepSeek's officiële OCR-2 vLLM-democode, inclusief de PDF-renderinghelper, verpakking van multimodale input, opschoning van OCR-tekst en de vLLM-engine/samplingconfiguratie. Daarbovenop voeg ik een lichtgewicht RAG-laag toe, mini-batch OCR-verwerking voor incrementele indexering en een Gradio-app.
Voordat we DeepSeek OCR-2 met vLLM uitvoeren, moeten we ervoor zorgen dat de runtime-omgeving klaar is. In deze tutorial gaan we uit van een GPU-geschakelde omgeving zoals Google Colab met een A100 of T4, omdat zowel vLLM als DeepSeek OCR-2 CUDA vereisen voor efficiënte inferentie.
In deze stap zullen we:
Dit zorgt ervoor dat de rest van de pijplijn het model en ondersteunende utilities kan laden zonder pad- of afhankelijkheidsproblemen.
import subprocess
gpu = subprocess.run(['nvidia-smi', '--query-gpu=name,memory.total', '--format=csv,noheader'],
                     capture_output=True, text=True).stdout.strip()
print(f"GPU: {gpu}")
import os, sys
REPO_ROOT = '/content/DeepSeek-OCR-2-main'
VLLM_DIR  = f'{REPO_ROOT}/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if not os.path.isdir(VLLM_DIR):
    zip_candidates = [
        '/content/DeepSeek-OCR-2-main.zip',
    ]
    found_zip = None
    for zp in zip_candidates:
        if os.path.isfile(zp):
            found_zip = zp
            break
    if found_zip:
        !unzip -qo {found_zip} -d /content/
        print(f'Extracted {found_zip}')
    else:
        !git clone https://github.com/deepseek-ai/DeepSeek-OCR-2.git {REPO_ROOT} 2>/dev/null || echo 'Already cloned'
assert os.path.isdir(VLLM_DIR), f'Repo not found at {VLLM_DIR}'
print(f'Repo OK: {VLLM_DIR}')
Deze stap controleert of er een GPU beschikbaar is en bereidt vervolgens de DeepSeek OCR-2-codebase lokaal voor. Het bovenstaande script controleert eerst de beschikbare GPU en het geheugen met nvidia-smi om te waarborgen dat de omgeving voldoende VRAM heeft voor vLLM-inferentie.
Vervolgens definieert het de repositorypaden en controleert of de vereiste vLLM-integratiemap al bestaat. Zo niet, dan extraheert het de repository uit een lokale ZIP of kloont het de officiële DeepSeek OCR-2-repository van GitHub.
In de volgende stap installeren we de vereiste afhankelijkheden en bereiden we de runtime voor op vLLM-gebaseerde inferentie.
DeepSeek OCR-2 en vLLM zijn erg versiegevoelig, dus in deze stap pinnen we een werkende set packages voor CUDA 11.8, installeren we een bijpassend vLLM-wheel en voegen we flash-attn toe voor snellere attention-kernels.
!pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
    --index-url https://download.pytorch.org/whl/cu118 2>&1 | tail -3
!pip install https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl 2>&1 | tail -3
!pip install flash-attn==2.7.3 --no-build-isolation 2>&1 | tail -3
!pip install "pydantic==2.10.6" "gradio==5.23.0" "gradio_client==1.7.2"
!pip install transformers==4.46.3 tokenizers==0.20.3 2>&1 | tail -3
!pip install addict einops tiktoken easydict pymupdf img2pdf pillow 2>&1 | tail -3
!pip install sentence-transformers faiss-cpu gradio 2>&1 | tail -3
os.environ['VLLM_USE_V1'] = '0'
os.environ['CUDA_VISIBLE_DEVICES'] = '0'
import torch
if torch.version.cuda == '11.8':
    os.environ['TRITON_PTXAS_PATH'] = '/usr/local/cuda-11.8/bin/ptxas'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import os, sys, re, io, time, threading
import numpy as np
import faiss
import fitz
import gradio as gr
from PIL import Image
from concurrent.futures import ThreadPoolExecutor
from functools import partial
from sentence_transformers import SentenceTransformer
VLLM_DIR = '/content/DeepSeek-OCR-2-main/DeepSeek-OCR2-master/DeepSeek-OCR2-vllm'
if VLLM_DIR not in sys.path:
    sys.path.insert(0, VLLM_DIR)
import config
from vllm import LLM, SamplingParams
from vllm.model_executor.models.registry import ModelRegistry
from process.ngram_norepeat import NoRepeatNGramLogitsProcessor
from process.image_process import DeepseekOCR2Processor
from deepseek_ocr2 import DeepseekOCR2ForCausalLM
print('Loading embedding model...')
EMBED_MODEL = SentenceTransformer('all-MiniLM-L6-v2')
EMBED_DIM = EMBED_MODEL.get_sentence_embedding_dimension()
print(f'Embedding model ready (dim={EMBED_DIM})')
De bovenstaande code installeert een compatibele runtime voor DeepSeek OCR-2 met vLLM. Hij installeert ook de ondersteunende stack voor de applicatie, waaronder Transformers, Gradio voor de UI, PyMuPDF en Pillow voor PDF/beeldverwerking, en SentenceTransformers met FAISS voor het bouwen van de retrieval-index.
Na installatie worden omgevingsvariabelen geconfigureerd voor stabiele vLLM-executie en Triton-compatibiliteit. De vLLM-integratie van de repository wordt aan sys.path toegevoegd zodat het aangepaste DeepSeek OCR-2-model en de preprocessormodules kunnen worden geïmporteerd, en tot slot wordt een lichtgewicht embeddingmodel (all-MiniLM-L6-v2) geladen om incrementele RAG-indexering op paginaniveau te ondersteunen.
In de volgende stap implementeren we preprocessingutilities om een PDF om te zetten naar pagina-afbeeldingen, elke pagina te verpakken in het multimodale inputformaat dat DeepSeek OCR-2 verwacht en de OCR-outputs op te schonen voor retrieval.
Voordat we DeepSeek OCR-2 kunnen draaien, hebben we een kleine set preprocessingutilities nodig die een PDF omzetten naar modelklare inputs en de ruwe OCR-output opschonen voor retrieval.
BATCH_SIZE = 5
def pdf_to_images_high_quality(pdf_path, dpi=144, image_format='PNG'):
    images = []
    pdf_document = fitz.open(pdf_path)
    zoom = dpi / 72.0
    matrix = fitz.Matrix(zoom, zoom)
    for page_num in range(pdf_document.page_count):
        page = pdf_document[page_num]
        pixmap = page.get_pixmap(matrix=matrix, alpha=False)
        Image.MAX_IMAGE_PIXELS = None
        if image_format.upper() == 'PNG':
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
        else:
            img_data = pixmap.tobytes('png')
            img = Image.open(io.BytesIO(img_data))
            if img.mode in ('RGBA', 'LA'):
                background = Image.new('RGB', img.size, (255, 255, 255))
                background.paste(img, mask=img.split()[-1] if img.mode == 'RGBA' else None)
                img = background
        images.append(img)
    pdf_document.close()
    return images
def process_single_image(image, prompt_str):
    return {
        'prompt': prompt_str,
        'multi_modal_data': {
            'image': DeepseekOCR2Processor().tokenize_with_images(
                images=[image], bos=True, eos=True, cropping=config.CROP_MODE
            )
        },
    }
def clean_ocr_output(content):
    if '<|end▁of▁sentence|>' in content:
        content = content.replace('<|end▁of▁sentence|>', '')
    else:
        if config.SKIP_REPEAT:
            return ''
    content = re.sub(r'<\|ref\|>image<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = re.sub(r'<\|ref\|>.*?<\|/ref\|><\|det\|>.*?<\|/det\|>', '', content)
    content = content.replace('\\coloneqq', ':=').replace('\\eqqcolon', '=:')
    content = content.replace('\n\n\n\n', '\n\n').replace('\n\n\n', '\n\n')
    return content.strip()
De bovenstaande utilities definiëren drie kernonderdelen:
We stellen BATCH_SIZE = 5 in om te bepalen hoe snel onze eerste resultaten verschijnen versus hoe efficiënt we de GPU gebruiken. Voor een PDF van 20 pagina's verloopt de voortgang in stappen van 0% naar 25% naar 50% naar 75% naar 100%, in plaats van direct van 0% naar 100% te springen.
Dit stelt gebruikers in staat om vragen te stellen zodra de eerste 5 pagina's zijn geïndexeerd. Kleinere batches verbeteren de time-to-first-result, terwijl grotere batches de doorvoer en GPU-benutting verbeteren.
We gebruikten de native pdf_to_images_high_quality()-functiecode uit de originele implementatie met de PyMuPDF-bibliotheek om elke pagina te renderen naar een PIL-afbeelding op 144 DPI (komt van zoom = 144 / 72.0 = 2.0, wat de standaardresolutie van 72 DPI verdubbelt).
De dpi/72-zoommatrix bepaalt de rasterisatiekwaliteit, en alpha=False voorkomt transparantie-artefacten. Als een afbeelding toch een alfakanaal bevat, wordt deze functie afgevlakt op een witte achtergrond om vreemde menging te voorkomen die de OCR kan verslechteren.
De functie process_single_image() (uit de oorspronkelijke codebase) verpakt elke pagina-afbeelding in de exacte dict-structuur die vLLM verwacht (prompt + multi_modal_data.image), met DeepseekOCR2Processor().tokenize_with_images(), die de volledige beeldpreprocessingpipeline afhandelt, inclusief het splitsen van grote afbeeldingen in 2–6 tegels via dynamic_preprocess() op basis van beeldverhouding, het creëren van een gepadde globale weergave van 1024×1024, het toepassen van tensor-normalisatie en het genereren van de volledige tokensequentie met beeldmaskers die DeepseekOCR2ForCausalLM consumeert.
De config.CROP_MODE van de repo bepaalt of deze dynamische tiling wordt toegepast, wat de nauwkeurigheid verbetert bij dichte lay-outs met kleine tekst.
Na generatie stript clean_ocr_output() speciale eindevan-zin-tokens, verwijdert detectiemarkupblokken (<|ref|>...<|/ref|><|det|>...<|/det|>), normaliseert enkele LaTeX-achtige operatoren en vouwt overtollige regeleinden samen, wat schonere tekst oplevert die beter te chunken is en betrouwbaarder wordt opgehaald in de downstream RAG-index.
Vervolgens gebruiken we deze opgeschoonde output om een lichtgewicht RAG-index op paginaniveau te bouwen, zodat pagina's direct na elke batch doorzoekbaar worden.
Nu we schone tekst uit elke pagina kunnen extraheren, is de volgende stap om die direct doorzoekbaar te maken. In plaats van te wachten tot het volledige document is verwerkt, bouwen we een lichtgewicht Retrieval-Augmented Generation (RAG)-engine op paginaniveau die de inhoud incrementeel indexeert.
Terwijl elke batch pagina's wordt verwerkt, wordt hun tekst ge-embed en toegevoegd aan een FAISS-index, zodat gebruikers het document kunnen bevragen terwijl de indexering nog bezig is.
class PageRAG:
    def __init__(self, chunk_size=1000):
        self.chunk_size = chunk_size
        self.index = faiss.IndexFlatIP(EMBED_DIM)
        self.chunks = []
        self.page_count = 0
        self._lock = threading.Lock()
    def reset(self):
        with self._lock:
            self.index = faiss.IndexFlatIP(EMBED_DIM)
            self.chunks, self.page_count = [], 0
    def add_page(self, page_num, text):
        if not text or not text.strip():
            with self._lock: self.page_count += 1
            return
        new_chunks = self._split(text, page_num)
        texts = [c[1] for c in new_chunks]
        embs = EMBED_MODEL.encode(texts, normalize_embeddings=True)
        with self._lock:
            self.index.add(np.array(embs, dtype=np.float32))
            self.chunks.extend(new_chunks)
            self.page_count += 1
    def query(self, question, top_k=5):
        with self._lock:
            if self.index.ntotal == 0: return []
            q = EMBED_MODEL.encode([question], normalize_embeddings=True)
            k = min(top_k, self.index.ntotal)
            scores, ids = self.index.search(np.array(q, dtype=np.float32), k)
        return [{'page': self.chunks[i][0], 'score': float(s), 'text': self.chunks[i][1]}
                for s, i in zip(scores[0], ids[0]) if i >= 0]
    def _split(self, text, pn):
        if len(text) <= self.chunk_size: return [(pn, text)]
        parts, cur = [], ''
        for p in re.split(r'\n{2,}', text):
            if len(cur) + len(p) > self.chunk_size and cur:
                parts.append((pn, cur.strip())); cur = p
            else: cur += ('\n\n' + p if cur else p)
        if cur.strip(): parts.append((pn, cur.strip()))
        return parts or [(pn, text[:self.chunk_size])]
    @property
    def indexed_pages(self):
        with self._lock: return self.page_count
De bovenstaande klasse definieert vier kernonderdelen:
faiss.IndexFlatIP voor snelle similariteitszoekopdrachten over genormaliseerde embeddings. Zodra elke pagina is verwerkt, wordt de inhoud direct ge-embed en toegevoegd aan de index, waardoor realtime retrieval mogelijk is zonder de index te herbouwen._split() verdeelt lange paginatekst in chunks van ~1000 tekens op basis van alineagrenzen. Dit verbetert semantische matching en voorkomt dat er te lange, ruisachtige context wordt ge-embed, terwijl paginanummers behouden blijven voor bronvermelding.threading.Lock() de indexupdates en -lezingen. query() embedt de gebruikersvraag, haalt de top-k vergelijkbare chunks op en retourneert de overeenkomende tekst samen met paginanummers en similariteitsscores. De eigenschap indexed_pages houdt de voortgang bij, zodat de UI kan tonen hoeveel pagina's al doorzoekbaar zijn.In deze stap initialiseren we de DeepSeek OCR-2-inferentie-engine met vLLM. Dit is de kerncomponent die multimodale generatie uitvoert door de getokenizeerde pagina-afbeeldingen te nemen en gestructureerde OCR-tekst te produceren. De configuratie volgt de officiële DeepSeek OCR-2 vLLM-referentie-instelling, maar we wikkelen het in een luie loader load_ocr_engine() zodat het model pas laadt wanneer de verwerking start, wat de opstarttijd verkort en onnodige GPU-allocatie voorkomt.
ocr_llm = None
ocr_sampling_params = None
def load_ocr_engine():
    global ocr_llm, ocr_sampling_params
    if ocr_llm is not None:
        return
    print(f'Loading {config.MODEL_PATH} via vLLM...')
    ModelRegistry.register_model('DeepseekOCR2ForCausalLM', DeepseekOCR2ForCausalLM)
    ocr_llm = LLM(
        model=config.MODEL_PATH,
        hf_overrides={'architectures': ['DeepseekOCR2ForCausalLM']},
        block_size=256,
        enforce_eager=False,
        trust_remote_code=True,
        max_model_len=8192,
        swap_space=0,
        max_num_seqs=config.MAX_CONCURRENCY,
        tensor_parallel_size=1,
        gpu_memory_utilization=0.9,
        disable_mm_preprocessor_cache=True,
    )
    ocr_sampling_params = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        logits_processors=[
            NoRepeatNGramLogitsProcessor(
                ngram_size=20, window_size=50,
                whitelist_token_ids={128821, 128822},
            )
        ],
        skip_special_tokens=False,
        include_stop_str_in_output=True,
    )
    print('vLLM engine loaded')
Deze code definieert de volgende kernonderdelen:
DeepseekOCR2ForCausalLM uit de repository aan vLLM zodat deze beeldtokens-inputs kan verwerken die door DeepseekOCR2Processor worden geproduceerd.LLM() komen overeen met de referentie-instellingen van de repository, waaronder block_size=256, max_model_len=8192, gpu_memory_utilization=0.9 en disable_mm_preprocessor_cache=True. Deze instellingen zijn afgestemd op stabiele, high-throughput OCR-inferentie met voorspelbaar GPU-geheugengebruik.temperature=0.0, ruime outputlimieten en een NoRepeatNGramLogitsProcessor om herhalende patronen te voorkomen, wat een veelvoorkomend probleem is bij langvormige OCR-generatie.load_ocr_engine() voor het eerst wordt aangeroepen. Latere aanroepen hergebruiken dezelfde instantie, wat herhaalde GPU-initialisatie voorkomt en de UI responsief houdt.Laten we deze engine nu koppelen aan een batchverwerkingslus die OCR pagina voor pagina draait en de resultaten in de RAG-index streamt voor realtime bevraging.
Deze stap is het hart van de app. We implementeren een achtergrondwerker die een geüploade PDF stapsgewijs omzet in een doorzoekbare index, in plaats van te wachten tot het hele document OCR heeft doorlopen.
rag = PageRAG()
total_pages = 0
is_processing = False
processing_error = None
stop_requested = False
def process_pdf_background(pdf_path):
    global total_pages, is_processing, processing_error, stop_requested
    try:
        is_processing = True
        processing_error = None
        stop_requested = False
        load_ocr_engine()
        if stop_requested: return
        print('PDF loading...')
        images = pdf_to_images_high_quality(pdf_path)
        total_pages = len(images)
        print(f'Rendered {total_pages} pages.')
        if stop_requested: return
        print('Preprocessing all images with DeepseekOCR2Processor...')
        prompt = config.PROMPT
        preprocess_fn = partial(process_single_image, prompt_str=prompt)
        with ThreadPoolExecutor(max_workers=config.NUM_WORKERS) as executor:
            all_inputs = list(executor.map(preprocess_fn, images))
        print(f'Preprocessed {len(all_inputs)} pages.')
        if stop_requested: return
        num_batches = (total_pages + BATCH_SIZE - 1) // BATCH_SIZE
        print(f'Running inference in {num_batches} batches of up to {BATCH_SIZE} pages...')
        for batch_idx in range(num_batches):
            if stop_requested:
                print(f'Stopped before batch {batch_idx + 1}.')
                return
            start = batch_idx * BATCH_SIZE
            end = min(start + BATCH_SIZE, total_pages)
            batch_inputs = all_inputs[start:end]
            print(f'  Batch {batch_idx + 1}/{num_batches}: pages {start+1}-{end}...')
            outputs_list = ocr_llm.generate(
                batch_inputs,
                sampling_params=ocr_sampling_params,
            )
            for i, output in enumerate(outputs_list):
                page_num = start + i + 1
                cleaned = clean_ocr_output(output.outputs[0].text)
                rag.add_page(page_num, cleaned)
                print(f'    Page {page_num}/{total_pages} ({len(cleaned)} chars)')
            print(f'  Batch {batch_idx + 1} done. {rag.indexed_pages} pages now searchable.')
    except Exception as e:
        import traceback
        processing_error = f'{e}\n\n{traceback.format_exc()}'
        print(f'ERROR: {processing_error}')
    finally:
        is_processing = False
        if stop_requested:
            print(f'Stopped. {rag.indexed_pages} pages indexed.')
        else:
            print('Processing complete.')
De flow voor onze pijplijn omvat het renderen van pagina's, het pre-processen van inputs, het uitvoeren van vLLM-inferentie in mini-batches, vervolgens het opschonen van de OCR-output en tot slot het toevoegen van elke pagina aan de door FAISS ondersteunde PageRAG. Hier is een gedetailleerde analyse van elke stap:
total_pages, is_processing, processing_error, stop_requested) houden voortgang en fouten bij zodat de UI live status kan tonen, stop/reset kan afhandelen en conflicterende runs kan vermijden.ThreadPoolExecutor(max_workers=config.NUM_WORKERS) zet pagina-afbeeldingen parallel om in modelklare multimodale inputs. Dit houdt de GPU later bezig door ervoor te zorgen dat inputs klaarstaan vóór de inferentie.ocr_llm.generate() één keer over alle pagina's te draaien (de standaard van het officiële script), berekent de code num_batches en verwerkt pagina's in chunks van BATCH_SIZE. Dit maakt progressieve indexering mogelijk, zodat gebruikers vragen kunnen gaan stellen na de eerste 5 pagina's (BATCH_SIZE = 5) in plaats van te wachten op het volledige document.stop_requested wordt gecontroleerd vóór dure stappen en bij de start van elke batch. Dat maakt de Stop-knop voorspelbaar: hij stopt tussen batches, na afloop van de huidige batch, zodat je geen halfgeschreven staat of gedeeltelijke outputs krijgt.Op dit punt hebben we een end-to-end pijplijn die een PDF omzet in een groeiende zoekindex, zodat gebruikers het document kunnen bevragen terwijl de verwerking op de achtergrond doorgaat. Vervolgens voegen we de UI-callbacks toe die deze werker verbinden met de Gradio-applicatie.
In deze fase draaien de OCR- en indexeringspijplijn op de achtergrond, maar de applicatie heeft nog een controllaag nodig die gebruikersacties koppelt aan de verwerkingslogica.
def start_processing(pdf_file):
    global total_pages
    if pdf_file is None: return 'Upload a PDF first.'
    if is_processing: return 'Already processing.'
    rag.reset()
    total_pages = 0
    threading.Thread(
        target=process_pdf_background,
        args=(pdf_file.name,),
        daemon=True,
    ).start()
    return 'Processing started! Pages become searchable in batches.'
def stop_processing():
    global stop_requested
    if not is_processing:
        return 'Nothing is running.'
    stop_requested = True
    return 'Stop requested. Will halt after current batch.'
def reset_all():
    global total_pages, processing_error, stop_requested
    if is_processing:
        return 'Cannot reset while processing. Stop first.'
    rag.reset()
    total_pages = 0
    processing_error = None
    stop_requested = False
    return 'Reset complete. Upload a new PDF.'
def refresh_progress():
    idx, tp = rag.indexed_pages, total_pages
    if processing_error:
        msg, pct, c = f'Error: {processing_error[:200]}', 100, '#ef4444'
    elif stop_requested and is_processing:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = 'Stopping after current batch...', '#f59e0b'
    elif not is_processing and stop_requested:
        pct = int(idx / tp * 100) if tp > 0 else 0
        msg, c = f'Stopped. {idx} pages indexed -- you can still ask questions.', '#f59e0b'
    elif not is_processing and idx == 0:
        msg, pct, c = 'Upload a PDF and click Process.', 0, '#6b7280'
    elif is_processing and tp == 0:
        msg, pct, c = 'Loading vLLM engine & rendering pages...', 0, '#3b82f6'
    elif is_processing:
        pct = int(idx / tp * 100)
        msg, c = f'{idx}/{tp} pages indexed -- ask questions now!', '#3b82f6'
    else:
        msg, pct, c = f'All {idx} pages indexed.', 100, '#10b981'
    bar_min = '32px' if pct > 0 else '0'
    pct_text = f'{pct}%' if pct > 5 else ''
    return (f'<div style=">'
            f'<div style="font-weight:500">{msg}</div>'
            f'<div style="background:#1f2937;border-radius:10px;overflow:hidden;height:28px">'
            f'<div style="width:{pct}%;background:{c};height:100%;border-radius:10px;'
            f'transition:width .6s;display:flex;align-items:center;'
            f'justify-content:center;color:white;font-weight:600;'
            f'min-width:{bar_min}">{pct_text}</div></div></div>')
def answer_question(question):
    if not question.strip(): return ''
    idx = rag.indexed_pages
    if idx == 0:
        if is_processing:
            return ('**Processing in progress -- first batch not done yet.**\n\n'
                    'Pages become searchable in batches of ' + str(BATCH_SIZE) + '.\n'
                    'Try again shortly!')
        return 'Upload a PDF and click **Process** first.'
    results = rag.query(question, top_k=5)
    if not results: return 'No relevant results found.'
    lines = []
    if is_processing:
        lines.append(f'> *Searched {idx} of {total_pages} pages (still processing).*\n')
    lines.append(f'**Source pages: {list(dict.fromkeys(r["page"] for r in results))}**\n')
    for i, r in enumerate(results, 1):
        lines += ['---', f'**Result {i}** | Page {r["page"]} | score: {r["score"]:.3f}\n',
                  r['text'][:600]]
        if len(r['text']) > 600: lines.append(f'\n*...{len(r["text"]):,} chars total*')
    return '\n'.join(lines)
Deze controllaag behandelt vijf kerntaken:
start_processing() valideert de input, reset de RAG-index en start process_pdf_background() in een daemonthread. stop_processing() zet een stop_requested-vlag in plaats van direct te beëindigen. De achtergrondwerker controleert deze vlag tussen batches, zodat het systeem netjes stopt zonder de index te beschadigen.reset_all() wist de FAISS-index, voortgangstellers en foutstatus. Hij voorkomt ook per ongeluk resetten terwijl de verwerking nog actief is, wat beschermt tegen inconsistente applicatiestaat.refresh_progress() om het aantal geïndexeerde pagina's uit PageRAG te lezen en een dynamische HTML-voortgangsbalk te genereren. Hij communiceert ook systeemstaten zoals laden, actieve verwerking, stoppen, voltooiing of fout.In de laatste stap koppelen we deze callbacks aan een Gradio-interface om de complete workflow via een eenvoudige web-UI beschikbaar te maken.
In deze laatste stap verpakken we alles in een eenvoudige Gradio-applicatie. De UI is ontworpen om gebruikers een PDF te laten uploaden, de verwerking te starten en al vragen te laten stellen voordat de indexering voltooid is.
with gr.Blocks(title='DeepSeek OCR-2', theme=gr.themes.Soft()) as demo:
    gr.Markdown('# DeepSeek OCR-2 -- Ask While Indexing\n')
    with gr.Row(equal_height=True):
        with gr.Column(scale=1, min_width=250):
            pdf_input = gr.File(label='Upload PDF', file_types=['.pdf'])
            process_btn = gr.Button('Process PDF', variant='primary', size='lg')
            with gr.Row():
                stop_btn = gr.Button('Stop', variant='stop', size='sm')
                reset_btn = gr.Button('Reset', variant='secondary', size='sm')
            status_output = gr.Markdown()
        with gr.Column(scale=2):
            progress_bar = gr.HTML(
                value='<div style=">Upload a PDF and click Process.</div>')
    gr.Markdown('---')
    with gr.Row(equal_height=True):
        question_input = gr.Textbox(
            label='Ask a Question',
            placeholder='What is this document about?',
            lines=1, scale=4)
        ask_btn = gr.Button('Ask', variant='secondary', scale=1, min_width=100)
    answer_output = gr.Markdown()
    timer = gr.Timer(2)
    timer.tick(fn=refresh_progress, outputs=progress_bar)
    process_btn.click(fn=start_processing, inputs=pdf_input, outputs=status_output)
    stop_btn.click(fn=stop_processing, outputs=status_output)
    reset_btn.click(fn=reset_all, outputs=status_output)
    ask_btn.click(fn=answer_question, inputs=question_input, outputs=answer_output)
    question_input.submit(fn=answer_question, inputs=question_input, outputs=answer_output)
print('Launching demo...')
demo.queue()
demo.launch(debug=True, share=True)
De Gradio-applicatie bevat twee kolommen. De linkerkolom bevat de PDF-uploadwidget en de knoppen Process/Stop/Reset, terwijl de rechterkolom een live HTML-voortgangsbalk toont. Dit maakt de app responsief, zelfs wanneer OCR nog draait. Enkele belangrijke kenmerken van onze app:
gr.Timer(2) roept elke twee seconden refresh_progress() aan en werkt de HTML van de voortgangsbalk bij. Omdat indexering in batches gebeurt, zien gebruikers de voortgang in stappen (en veranderen de berichten afhankelijk van staten als laden, stoppen, fout of voltooiing)..click()-handlers van de knoppen koppelen UI-acties rechtstreeks aan je backendfuncties, zoals start_processing() dat de achtergrondwerker start, stop_processing() dat een nette stop aanvraagt, reset_all() dat de staat wist, en answer_question() dat retrieval uitvoert over de tot dan toe geïndexeerde pagina's.Tot slot start demo.launch() de app in Colab, biedt een deelbare link, rendert hem inline en schakelt debuglogs in om problemen tijdens ontwikkeling te helpen diagnosticeren.
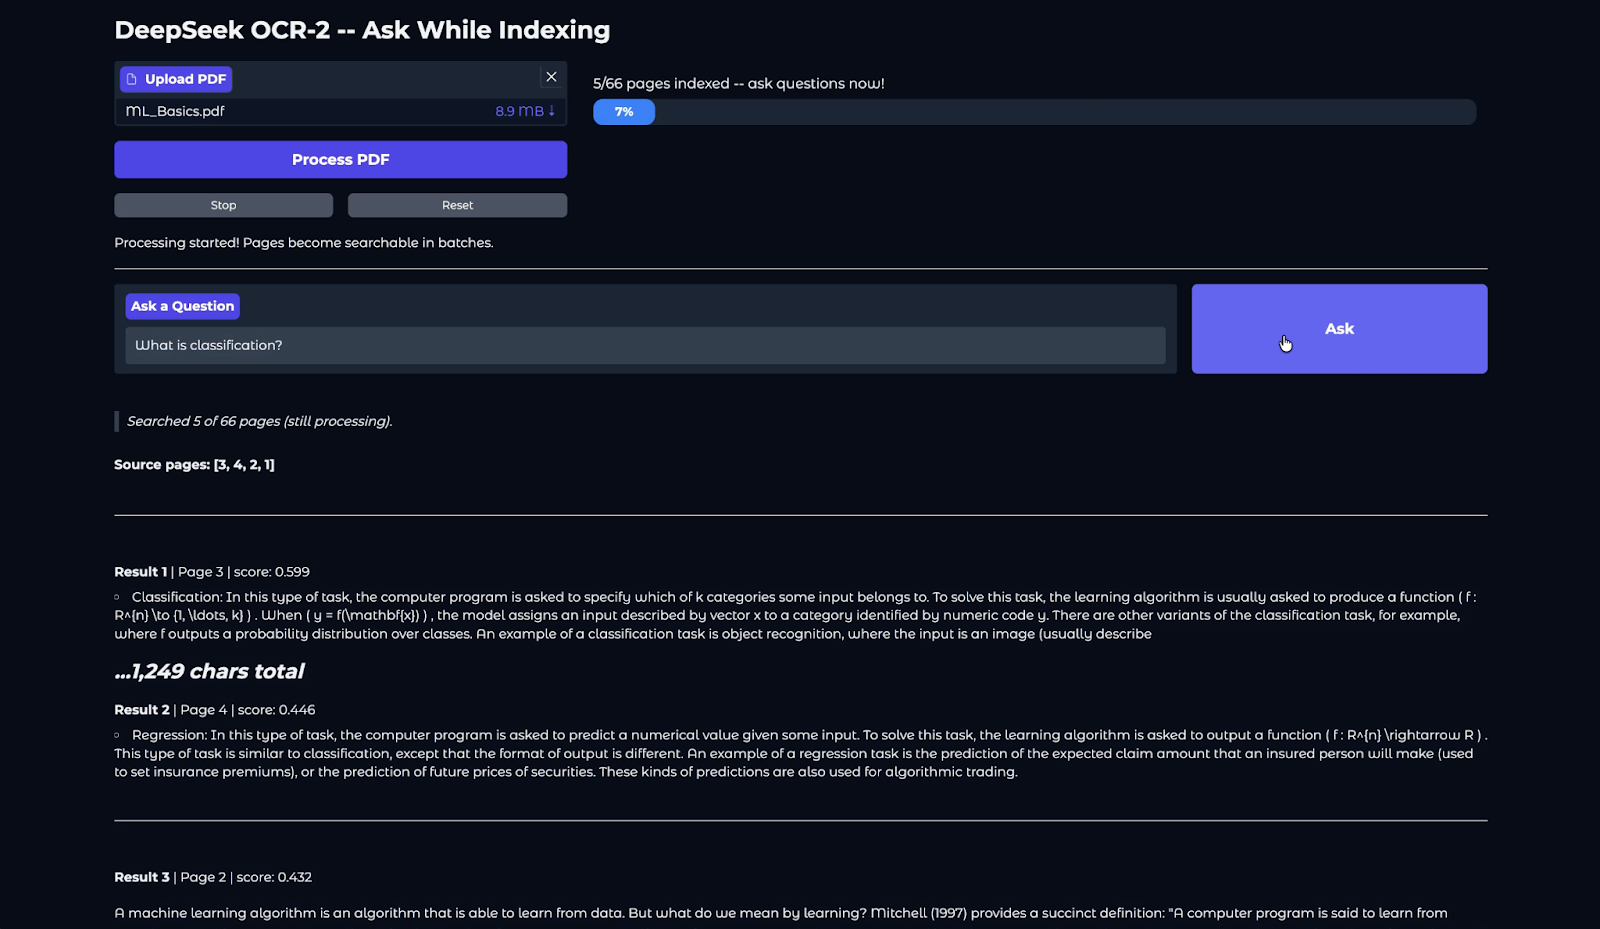
In deze tutorial hebben we een complete, visiegerichte documentintelligentiepijplijn gebouwd met DeepSeek OCR-2. Vanuit een ruwe PDF hebben we pagina's gerenderd naar hoogwaardige afbeeldingen, multimodale OCR via vLLM gedraaid, de geëxtraheerde tekst opgeschoond en gestructureerd, en deze incrementeel geïndexeerd in een op FAISS gebaseerde RAG-store.
Door pagina's in mini-batches te verwerken, maakt de applicatie een “ask while indexing”-ervaring mogelijk, waarbij gebruikers het document al kunnen bevragen na de eerste batch in plaats van te wachten op volledige voltooiing.
Toch kwamen er tijdens het testen twee merkbare beperkingen naar voren. Formule-rijke gebieden worden niet altijd nauwkeurig getranscribeerd, wat een bekende uitdaging is voor vision-language OCR-modellen, zelfs met groundingprompts.
Ook vertonen sommige langere pagina's herhalende outputpatronen. De officiële pijplijn beperkt dit met een NoRepeatNGramLogitsProcessor (ngram_size=20), maar dichte tabellen en meerkolomslay-outs kunnen nog steeds generatielussen triggeren; in dat geval wordt de pagina stilletjes overgeslagen via de SKIP_REPEAT-vlag.
Om verder te gaan kunnen lezers experimenteren met het toevoegen van een lichtgewicht LLM-laag (bijv. via de Anthropic- of OpenAI-API) om opgehaalde chunks te samenvatten in plaats van ruwe fragmenten terug te geven.
Andere praktische verbeteringen zijn het persistent opslaan van de FAISS-index op schijf voor hergebruik tussen sessies, ondersteuning voor meerdere PDF's in één index, het direct in de Gradio-UI blootstellen van instelbare parameters zoals BATCH_SIZE en top_k, of structuur-bewuste chunking (koppen, tabellen en sectiegrenzen) toevoegen om de retrievalprecisie te verbeteren.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

