特征向量与特征值是线性代数中的基础概念,在数据科学与机器学习中具有深远影响。这些数学对象能够揭示线性变换的行为,帮助我们理解数据的内在结构,简化具有大量特征的复杂数据集,从而便于处理以达成目标。
如果这让您想到降维,那就对了。许多降维技术(如主成分分析(PCA))的底层机理正是特征向量与特征值。它们也是谱聚类的核心部件,而谱聚类通常以降维作为初始步骤。
要理解“特征”世界的概念,您需要对线性代数中的一些前置概念有基本把握,主要包括向量与标量、线性变换以及行列式。若您对这些概念尚不熟悉,可以学习我们的R 语言数据科学线性代数动手课程;如果您是 Python 用户,可以参考这篇关于向量与数组的 SciPy 教程。
什么是特征向量与特征值?
先从“eigen”这个词说起:它并不是某位发明者的名字,而是德语词,在这里大致可理解为“特征的”或“固有的”。
现在,想象我们对一组向量施加一次线性变换,比如缩放、剪切或旋转。有些向量会改变方向,而有些不会。那些方向不变(或正好旋转到相反方向)的向量,就是我们所说的特征向量,因为它们成为这次变换(或所描述矩阵)的“特征”向量。它们被缩放的量(幅度)就是特征值,也即变换的缩放因子。
理解特征向量与特征值
为更好地理解这两个概念,我们先从几何情形入手,然后再转向它们在数据科学中的应用。
几何解释
设想一个二维空间中有三根向量:蓝色向量位于 x 轴上,红色向量位于 y 轴上,绿色向量则斜卧于两者之间。现在,我们沿 y 轴施加一个倍数为 2 的缩放,如下图所示。
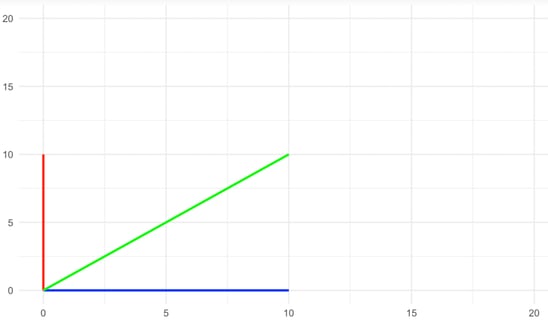
拉伸前的向量。图片由作者提供
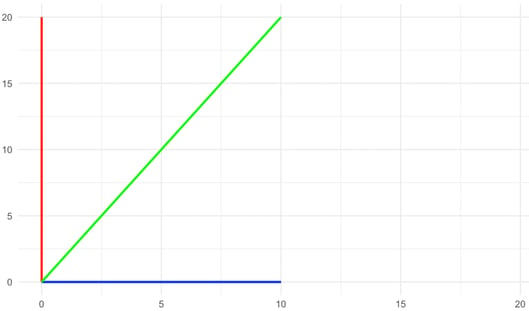
拉伸后的向量。图片由作者提供
方向向量发生了什么?红色与蓝色向量在缩放后方向未变,而绿色向量改变了方向,对吗?因此,在这种变换下,红色与蓝色向量就是我们称为特征向量的那些,因为它们成为这次变换的特征向量。
再看上面的图,观察特征向量(红与蓝)的长度发生了什么变化。蓝色特征向量的长度未变,而红色的长度翻倍,换种说法就是被缩放了 2 倍。每个特征向量在变换中被缩放的倍数就是特征值。因此,这里的蓝色特征向量的特征值为 1(可视作乘以 1),而红色特征向量的特征值为 2,因为它的长度变为原来的两倍。
特征值的性质
考虑下图所示的变换,先想想在此情形下哪些是特征向量。如果您说是红、绿、黄三根向量,那就对了,因为它们在变换后都指向完全相反的方向。我们可以看到,数值(特征值)的正负号能告诉我们关于变换的额外信息。正的特征值表明变换不包含旋转,负的特征值则表明变换包含绕原点的旋转。
旋转前的向量。图片由作者提供
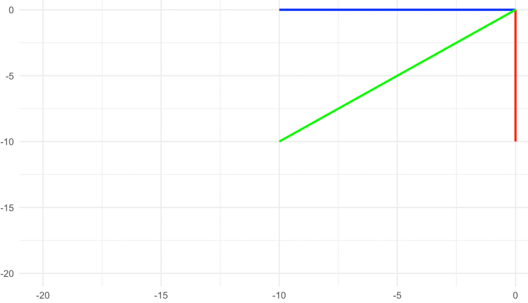
旋转后的向量。图片由作者提供
那么,这些特征向量各自的特征值是多少?由于它们的长度保持不变,特征值应为 1;但它们又发生了旋转,因此这个 1 的符号必须为负。所以,此处的特征值为 -1。
在我们的示例中,特征值很简单(都是 1),但特征值可以是任意数,既可以是整数或自然数,如 1 和 2,也可以是有理数(分数),如 1/2 和 0.75,还可以是不理性数(无理数),如 π 的值。特征值甚至可以是复数,例如 a + bi,其中“a”和“b”分别为实数,“i”为虚数单位,如 -1 的平方根。复特征值同样能够指示发生的线性变换类型,是包含旋转,还是更复杂的如振荡。
如何计算特征向量与特征值
虽然 R 的基础包以及 Python 的 SciPy、NumPy 等库可以轻松求解特征向量与特征值,但理解其背后的方程仍极有价值。本节我们将回顾所谓“特征方程”,它可以在给定一个简单矩阵时按步骤计算特征值与特征向量。随后,我们还会提及用于更大矩阵(即大型数据集)的其他数值计算方法。
特征方程
可用称为特征方程的方法求解特征值与特征向量。使用特征方程时,先求特征值,再求特征向量。一旦得到特征值,就通过求解一组线性方程来计算对应的特征向量。
步骤 1:从矩阵变换方程开始
对于矩阵𝐴与向量𝑣,特征向量与特征值的基本方程为:
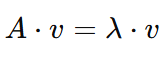
这表示当矩阵𝐴作用于向量𝑣时,结果是𝑣的某个倍数。此处:
- 𝐴为矩阵(由数字构成的方阵)。
- 𝑣为特征向量
- λ (lambda)为特征值。
请牢记,我们的目标是同时求出λ(特征值)与𝑣(特征向量)。
步骤 2:重排方程
为实现目标,我们需要解出λ。因此,先将等式右侧移到左侧并取相反号,以便处理:
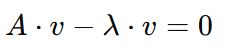
现在我们可以把𝑣提出来,但由于𝐴是矩阵而𝑣是向量,我们需要用单位矩阵(记作I)去乘𝑣。单位矩阵是一个方阵(大小为 n×n),主对角线为 1,其余元素为 0。由于矩阵乘法的性质,单位矩阵对矩阵的作用类似于数字 1。以 3×3 的单位矩阵为例:
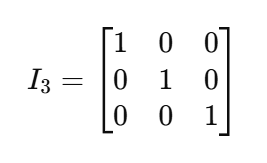
回到我们的方程,如果把𝑣提出并乘上I,就得到:
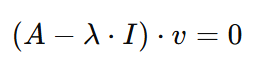
步骤 3:设定行列式
要解这个我们得到的方程,要么特征向量𝑣为零,否则特征向量将等于𝐴 −λ⋅I 的结果。此时正好可以说明一点:特征向量不能为零。因此,𝐴 −λ⋅I 必须等于零。但由于 lambda 是未知量,如果我们对𝐴 −λ⋅I 取行列式,便可使等式左右两边相等。于是得到:
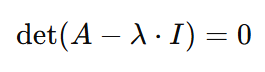
至此,我们得到了特征方程。通过求解特征方程,我们可以得到特征值λ与特征向量𝑣,后续步骤将予以展示。
步骤 4:求解特征值
设我们有如下矩阵𝐴:
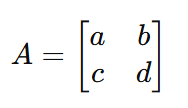
将特征方程中的𝐴替换为该矩阵,方程变为:
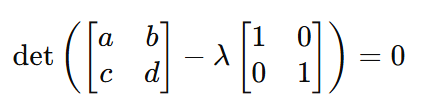
因此:
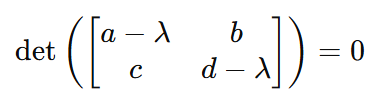
进而:
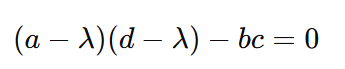
由这个更简洁的方程形式,我们只需代入矩阵的数值即可计算特征值λ。
步骤 5:求解特征向量 𝑣
得到特征值λ后,接下来就是求特征向量𝑣。我们可以回到之前的这个方程形式:
此时若将𝐴、λ与I代入其取值,便可轻松求出特征向量𝑣的值。
数值计算方法
如我们所见,计算特征向量与特征值的复杂度在很大程度上取决于矩阵规模。在示例中,我们使用的是一个简单的 2×2 的𝐴 矩阵。但当矩阵更大(如包含数百或上千行列)时,实际上无法用上述方式求解。在这种情况下,我们使用 Python 与 R 等编程语言,采用数值计算方法而非符号方法。常用技术包括:
- QR 算法:这是求解特征值的常见方法,它通过一系列矩阵分解(QR 分解)迭代收敛到特征值。
- Cholesky 或 LU 分解:对于某些类型的矩阵(如对称或正定矩阵),可使用 Cholesky 或 LU 分解等专门方法以更高效地计算。
- 平衡与缩放:为提高数值稳定性,R 与 Python 往往会在计算前对矩阵进行缩放和平衡处理。
数据科学与机器学习中的注意事项
特征向量与特征值在许多应用中至关重要,包括:
- 图像处理:用于人脸识别与图像分类。
- 自然语言处理(NLP):用于主题建模与词向量表示。
- 推荐系统:如协同过滤与基于内容的过滤,其中降维可提升推荐系统的准确性。
- 谱聚类:特征向量与特征值也是谱聚类的基石。该方法通过在图上考察数据点的连接关系来分组,利用数据结构信息而不仅仅是距离,具有多种实际应用,如图像处理。
- 主成分分析:PCA 是机器学习中常见的降维技术。通过PCA,我们求标准化协方差矩阵的特征向量,并按特征值排序。
我们提到特征值可以是任意实数或复数。这意味着特征值可以为零,也可能在所分析的矩阵中出现多个相等的特征值。这两种情形都被视为特征分析中可能出现的问题。下面分别介绍。
零特征值问题
零特征值之所以是个问题,是因为其对应的特征向量在变换后变为零向量,后者可想象为空间中的一个点,没有长度,因此无法解释数据集中的方差。该问题可以通过正则化技术(如岭回归/Tikhonov 正则化)或移除共线特征(即降维)来处理,而在 PCA 算法中这会自然发生。因此,零特征值对 PCA 并非问题,事实上 PCA 也可作为一种解决方案。不过,对于其他涉及求解线性系统的机器学习算法(如线性回归、岭回归与套索回归),应当预先处理零特征值问题。
退化特征值
当多个特征值相同,它们被称为退化。在数据科学中这会带来问题,尤其在 PCA 与谱聚类的实践中。在 PCA 中,若多个特征向量具有相同的特征值,意味着这些特征向量在数据集中捕获了相同数量的方差,因此 k 个主成分的选择会变得困难。在谱聚类中,若相似度矩阵的特征值出现退化,可能表明数据点在多个维度上同等相似,这会让选择用于分割簇的维度或特征向量变得不易。
特征向量、特征值与特征分解
关于特征向量与特征值的讨论,离不开特征分解。特征分解是将方阵A分解为其特征向量与特征值的过程。对于可分解的矩阵,它可表示为:
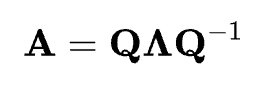
特征分解告诉我们,矩阵 A 可表示为其特征向量矩阵 Q、特征值的对角矩阵 Λ,以及特征向量矩阵的逆 Q-1 的乘积。这些矩阵按矩阵乘法相乘后可以还原原始矩阵 A。特征分解之所以重要,是因为它为理解与简化复杂的线性变换提供了途径,能够洞察系统行为,并简化许多计算。
结语
本文介绍了特征向量与特征值的概念,以及它们为何与数据科学、机器学习密切相关。我们还讲解了它们的数学求解方法,并讨论了在求解过程中可能出现的问题。
除R 语言线性代数课程与向量与数组的 SciPy 教程外,如果您希望深入掌握特征向量与特征值及其在机器学习中的应用,不妨尝试我们的Python 机器学习科学家职业路径,系统精通监督学习与无监督学习,当然也包括降维。


特征向量与特征值是线性代数中的基础概念,在数据科学与机器学习中具有深远影响。这些数学对象能够揭示线性变换的行为,帮助我们理解数据的内在结构,简化具有大量特征的复杂数据集,从而便于处理以达成目标。
如果这让您想到降维,那就对了。许多降维技术(如主成分分析(PCA))的底层机理正是特征向量与特征值。它们也是谱聚类的核心部件,而谱聚类通常以降维作为初始步骤。
要理解“特征”世界的概念,您需要对线性代数中的一些前置概念有基本把握,主要包括向量与标量、线性变换以及行列式。若您对这些概念尚不熟悉,可以学习我们的R 语言数据科学线性代数动手课程;如果您是 Python 用户,可以参考这篇关于向量与数组的 SciPy 教程。
什么是特征向量与特征值?
先从“eigen”这个词说起:它并不是某位发明者的名字,而是德语词,在这里大致可理解为“特征的”或“固有的”。
现在,想象我们对一组向量施加一次线性变换,比如缩放、剪切或旋转。有些向量会改变方向,而有些不会。那些方向不变(或正好旋转到相反方向)的向量,就是我们所说的特征向量,因为它们成为这次变换(或所描述矩阵)的“特征”向量。它们被缩放的量(幅度)就是特征值,也即变换的缩放因子。
理解特征向量与特征值
为更好地理解这两个概念,我们先从几何情形入手,然后再转向它们在数据科学中的应用。
几何解释
设想一个二维空间中有三根向量:蓝色向量位于 x 轴上,红色向量位于 y 轴上,绿色向量则斜卧于两者之间。现在,我们沿 y 轴施加一个倍数为 2 的缩放,如下图所示。
拉伸前的向量。图片由作者提供
拉伸后的向量。图片由作者提供
方向向量发生了什么?红色与蓝色向量在缩放后方向未变,而绿色向量改变了方向,对吗?因此,在这种变换下,红色与蓝色向量就是我们称为特征向量的那些,因为它们成为这次变换的特征向量。
再看上面的图,观察特征向量(红与蓝)的长度发生了什么变化。蓝色特征向量的长度未变,而红色的长度翻倍,换种说法就是被缩放了 2 倍。每个特征向量在变换中被缩放的倍数就是特征值。因此,这里的蓝色特征向量的特征值为 1(可视作乘以 1),而红色特征向量的特征值为 2,因为它的长度变为原来的两倍。
特征值的性质
考虑下图所示的变换,先想想在此情形下哪些是特征向量。如果您说是红、绿、黄三根向量,那就对了,因为它们在变换后都指向完全相反的方向。我们可以看到,数值(特征值)的正负号能告诉我们关于变换的额外信息。正的特征值表明变换不包含旋转,负的特征值则表明变换包含绕原点的旋转。
旋转前的向量。图片由作者提供
旋转后的向量。图片由作者提供
那么,这些特征向量各自的特征值是多少?由于它们的长度保持不变,特征值应为 1;但它们又发生了旋转,因此这个 1 的符号必须为负。所以,此处的特征值为 -1。
在我们的示例中,特征值很简单(都是 1),但特征值可以是任意数,既可以是整数或自然数,如 1 和 2,也可以是有理数(分数),如 1/2 和 0.75,还可以是不理性数(无理数),如 π 的值。特征值甚至可以是复数,例如 a + bi,其中“a”和“b”分别为实数,“i”为虚数单位,如 -1 的平方根。复特征值同样能够指示发生的线性变换类型,是包含旋转,还是更复杂的如振荡。
如何计算特征向量与特征值
虽然 R 的基础包以及 Python 的 SciPy、NumPy 等库可以轻松求解特征向量与特征值,但理解其背后的方程仍极有价值。本节我们将回顾所谓“特征方程”,它可以在给定一个简单矩阵时按步骤计算特征值与特征向量。随后,我们还会提及用于更大矩阵(即大型数据集)的其他数值计算方法。
特征方程
可用称为特征方程的方法求解特征值与特征向量。使用特征方程时,先求特征值,再求特征向量。一旦得到特征值,就通过求解一组线性方程来计算对应的特征向量。
步骤 1:从矩阵变换方程开始
对于矩阵𝐴与向量𝑣,特征向量与特征值的基本方程为:
这表示当矩阵𝐴作用于向量𝑣时,结果是𝑣的某个倍数。此处:
请牢记,我们的目标是同时求出λ(特征值)与𝑣(特征向量)。
步骤 2:重排方程
为实现目标,我们需要解出λ。因此,先将等式右侧移到左侧并取相反号,以便处理:
现在我们可以把𝑣提出来,但由于𝐴是矩阵而𝑣是向量,我们需要用单位矩阵(记作I)去乘𝑣。单位矩阵是一个方阵(大小为 n×n),主对角线为 1,其余元素为 0。由于矩阵乘法的性质,单位矩阵对矩阵的作用类似于数字 1。以 3×3 的单位矩阵为例:
回到我们的方程,如果把𝑣提出并乘上I,就得到:
步骤 3:设定行列式
要解这个我们得到的方程,要么特征向量𝑣为零,否则特征向量将等于𝐴 −λ⋅I 的结果。此时正好可以说明一点:特征向量不能为零。因此,𝐴 −λ⋅I 必须等于零。但由于 lambda 是未知量,如果我们对𝐴 −λ⋅I 取行列式,便可使等式左右两边相等。于是得到:
至此,我们得到了特征方程。通过求解特征方程,我们可以得到特征值λ与特征向量𝑣,后续步骤将予以展示。
步骤 4:求解特征值
设我们有如下矩阵𝐴:
将特征方程中的𝐴替换为该矩阵,方程变为:
因此:
进而:
由这个更简洁的方程形式,我们只需代入矩阵的数值即可计算特征值λ。
步骤 5:求解特征向量 𝑣
得到特征值λ后,接下来就是求特征向量𝑣。我们可以回到之前的这个方程形式:
此时若将𝐴、λ与I代入其取值,便可轻松求出特征向量𝑣的值。
数值计算方法
如我们所见,计算特征向量与特征值的复杂度在很大程度上取决于矩阵规模。在示例中,我们使用的是一个简单的 2×2 的𝐴 矩阵。但当矩阵更大(如包含数百或上千行列)时,实际上无法用上述方式求解。在这种情况下,我们使用 Python 与 R 等编程语言,采用数值计算方法而非符号方法。常用技术包括:
数据科学与机器学习中的注意事项
特征向量与特征值在许多应用中至关重要,包括:
我们提到特征值可以是任意实数或复数。这意味着特征值可以为零,也可能在所分析的矩阵中出现多个相等的特征值。这两种情形都被视为特征分析中可能出现的问题。下面分别介绍。
零特征值问题
零特征值之所以是个问题,是因为其对应的特征向量在变换后变为零向量,后者可想象为空间中的一个点,没有长度,因此无法解释数据集中的方差。该问题可以通过正则化技术(如岭回归/Tikhonov 正则化)或移除共线特征(即降维)来处理,而在 PCA 算法中这会自然发生。因此,零特征值对 PCA 并非问题,事实上 PCA 也可作为一种解决方案。不过,对于其他涉及求解线性系统的机器学习算法(如线性回归、岭回归与套索回归),应当预先处理零特征值问题。
退化特征值
当多个特征值相同,它们被称为退化。在数据科学中这会带来问题,尤其在 PCA 与谱聚类的实践中。在 PCA 中,若多个特征向量具有相同的特征值,意味着这些特征向量在数据集中捕获了相同数量的方差,因此 k 个主成分的选择会变得困难。在谱聚类中,若相似度矩阵的特征值出现退化,可能表明数据点在多个维度上同等相似,这会让选择用于分割簇的维度或特征向量变得不易。
特征向量、特征值与特征分解
关于特征向量与特征值的讨论,离不开特征分解。特征分解是将方阵A分解为其特征向量与特征值的过程。对于可分解的矩阵,它可表示为:
特征分解告诉我们,矩阵 A 可表示为其特征向量矩阵 Q、特征值的对角矩阵 Λ,以及特征向量矩阵的逆 Q-1 的乘积。这些矩阵按矩阵乘法相乘后可以还原原始矩阵 A。特征分解之所以重要,是因为它为理解与简化复杂的线性变换提供了途径,能够洞察系统行为,并简化许多计算。
结语
本文介绍了特征向量与特征值的概念,以及它们为何与数据科学、机器学习密切相关。我们还讲解了它们的数学求解方法,并讨论了在求解过程中可能出现的问题。
除R 语言线性代数课程与向量与数组的 SciPy 教程外,如果您希望深入掌握特征向量与特征值及其在机器学习中的应用,不妨尝试我们的Python 机器学习科学家职业路径,系统精通监督学习与无监督学习,当然也包括降维。