
Cours
Algèbre linéaire pour la data science en R
4 h
21.6K
Les vecteurs propres et les valeurs propres sont des notions fondamentales de l’algèbre linéaire, avec des implications majeures en data science et en apprentissage automatique. Ces objets mathématiques éclairent le comportement des transformations linéaires : ils aident à comprendre la structure intrinsèque des données, à simplifier des jeux de données riches en variables et, par conséquent, à en faciliter le traitement pour atteindre l’objectif visé.
Si cela vous évoque la réduction de dimension, vous avez raison. Les vecteurs propres et les valeurs propres sont au cœur de nombreuses techniques de réduction de dimension, comme l’analyse en composantes principales (ACP). Ils sont également le moteur du clustering spectral, qui commence lui aussi par une étape de réduction de dimension.
Pour entrer sereinement dans le « monde eigen », il est utile de maîtriser quelques notions préalables d’algèbre linéaire : vecteurs et scalaires, transformation linéaire et déterminants. Si vous découvrez ces concepts, suivez notre cours pratique Linear Algebra for Data Science in R. Côté Python, parcourez ce tutoriel SciPy sur les vecteurs et les tableaux.
Commençons par l’étymologie : la particule « eigen » de vecteurs propres (eigenvectors) et valeurs propres (eigenvalues) a un sens ; ce n’est pas le nom de leur inventeur. En allemand, eigen signifie « caractéristique », « intrinsèque ».
Imaginez que nous soumettions un ensemble de vecteurs à une transformation linéaire : homothétie, cisaillement ou rotation. Certains vecteurs changent de direction, d’autres non. Les vecteurs qui ne changent pas de direction (ou pivotent exactement vers la direction opposée) sont les vecteurs propres : ils sont « caractéristiques » de la transformation (ou de la matrice qui la représente). Le facteur d’échelle appliqué à ces vecteurs est la valeur propre, c’est-à-dire le coefficient de dilatation/compression.
Pour mieux saisir ces concepts, examinons d’abord un cas géométrique, avant d’aborder leurs applications en data science.
Dans un plan, considérez trois vecteurs : un bleu posé sur l’axe des x, un rouge sur l’axe des y, et un vert positionné en diagonale entre les deux. Appliquons une homothétie d’échelle 2 le long de l’axe des y, comme illustré ci-dessous.
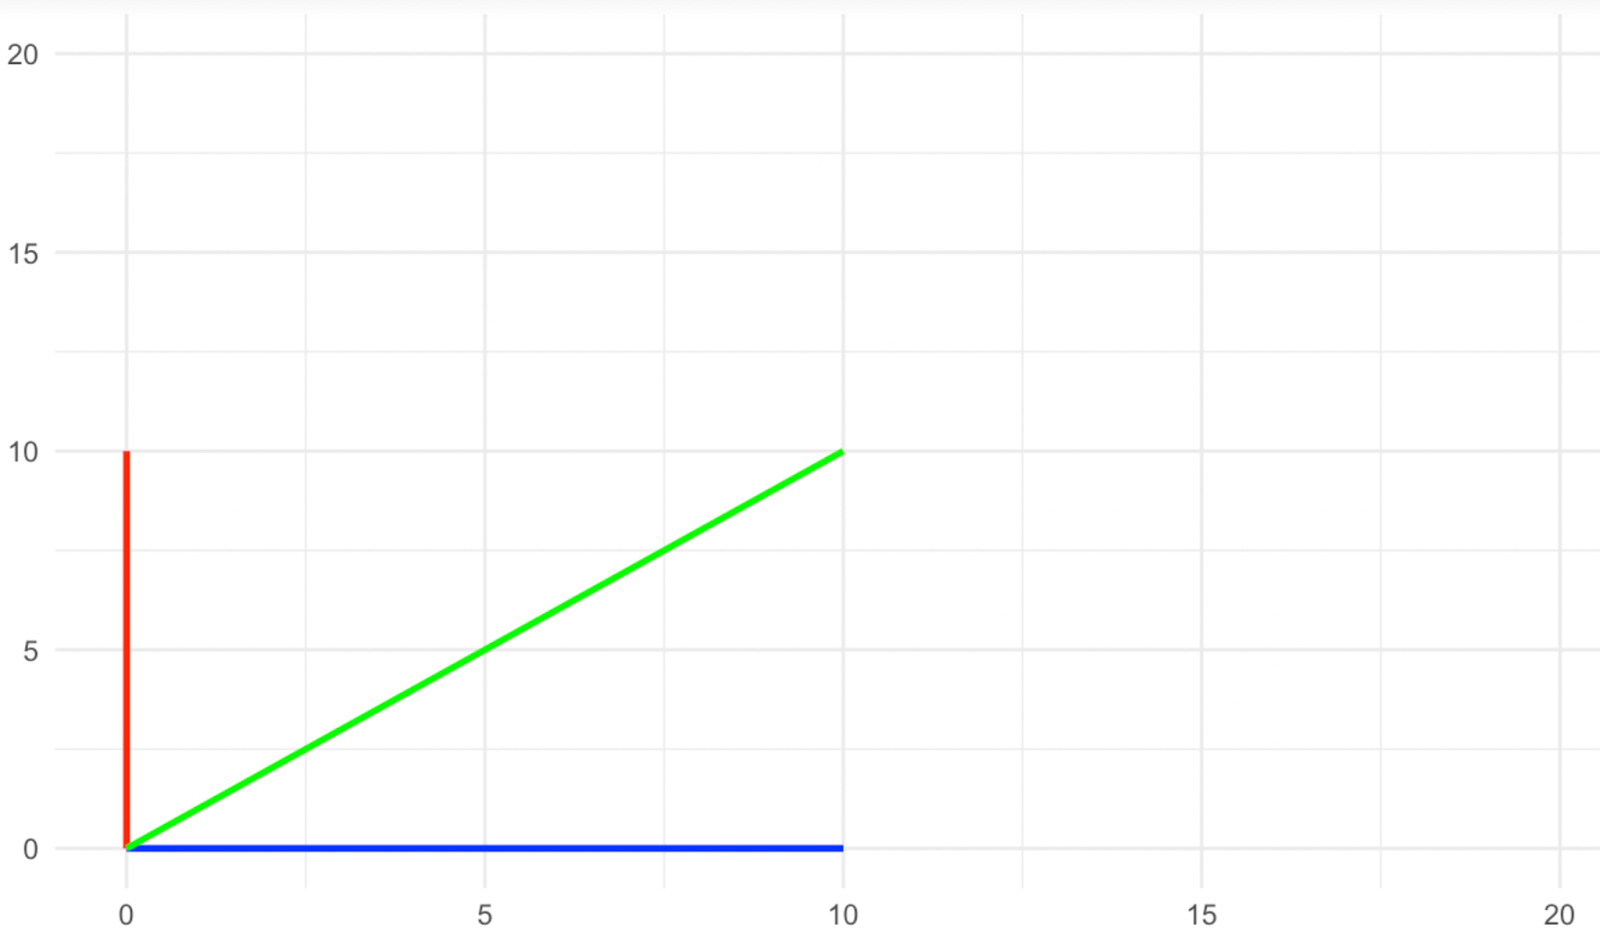
Vecteurs avant étirement. Image de l’auteur
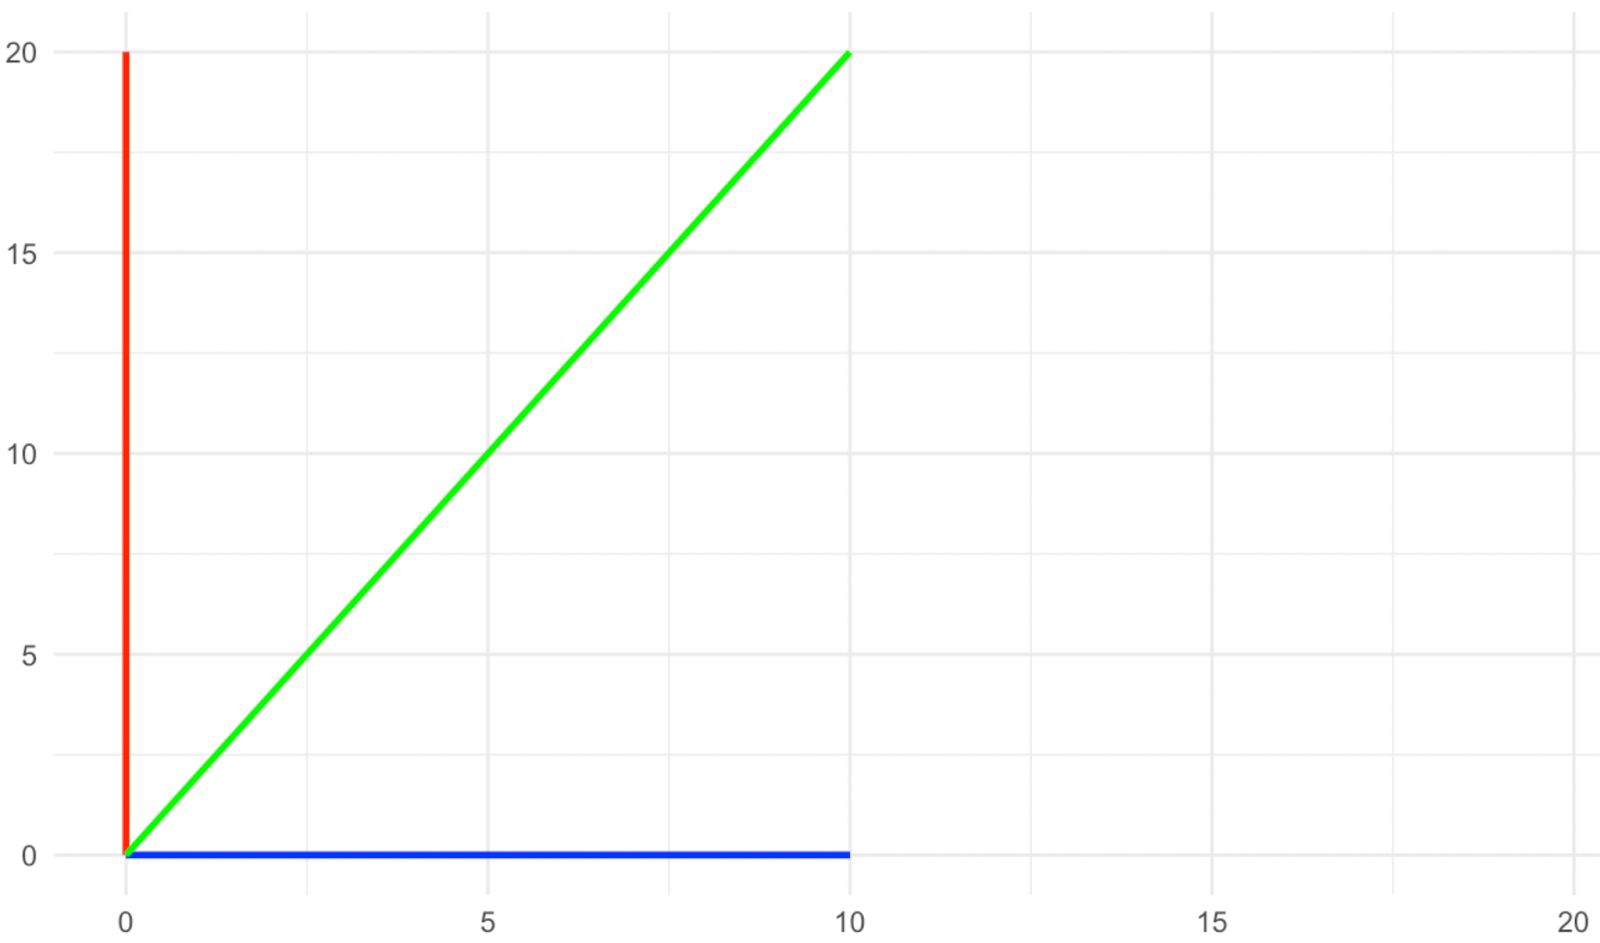
Vecteurs après étirement. Image de l’auteur
Qu’est-il arrivé aux directions ? Les vecteurs rouge et bleu n’ont pas changé de direction, tandis que le vert, si. Dans cette transformation, les vecteurs rouge et bleu sont donc des vecteurs propres : ils sont caractéristiques de la transformation.
Regardez de nouveau les images : qu’en est-il de la norme des vecteurs propres (les rouge et bleu) ? Le vecteur propre bleu n’a pas changé de norme, tandis que le rouge a doublé — autrement dit, il a été multiplié par 2. Le facteur par lequel chaque vecteur propre est mis à l’échelle est la valeur propre. Ici, la valeur propre du vecteur bleu est 1 (pensez à une multiplication), et celle du vecteur rouge est 2, puisque sa norme a doublé.
Considérez maintenant la transformation ci-dessous et identifiez les vecteurs propres. Si vous avez répondu les trois vecteurs — rouge, vert et jaune — c’est exact, car ils pointent tous exactement dans la direction opposée après transformation. On voit que le signe de la valeur propre renseigne sur la nature de la transformation : un signe positif indique l’absence de rotation ; un signe négatif indique une rotation du vecteur propre autour de son origine.
Vecteurs avant rotation. Image de l’auteur
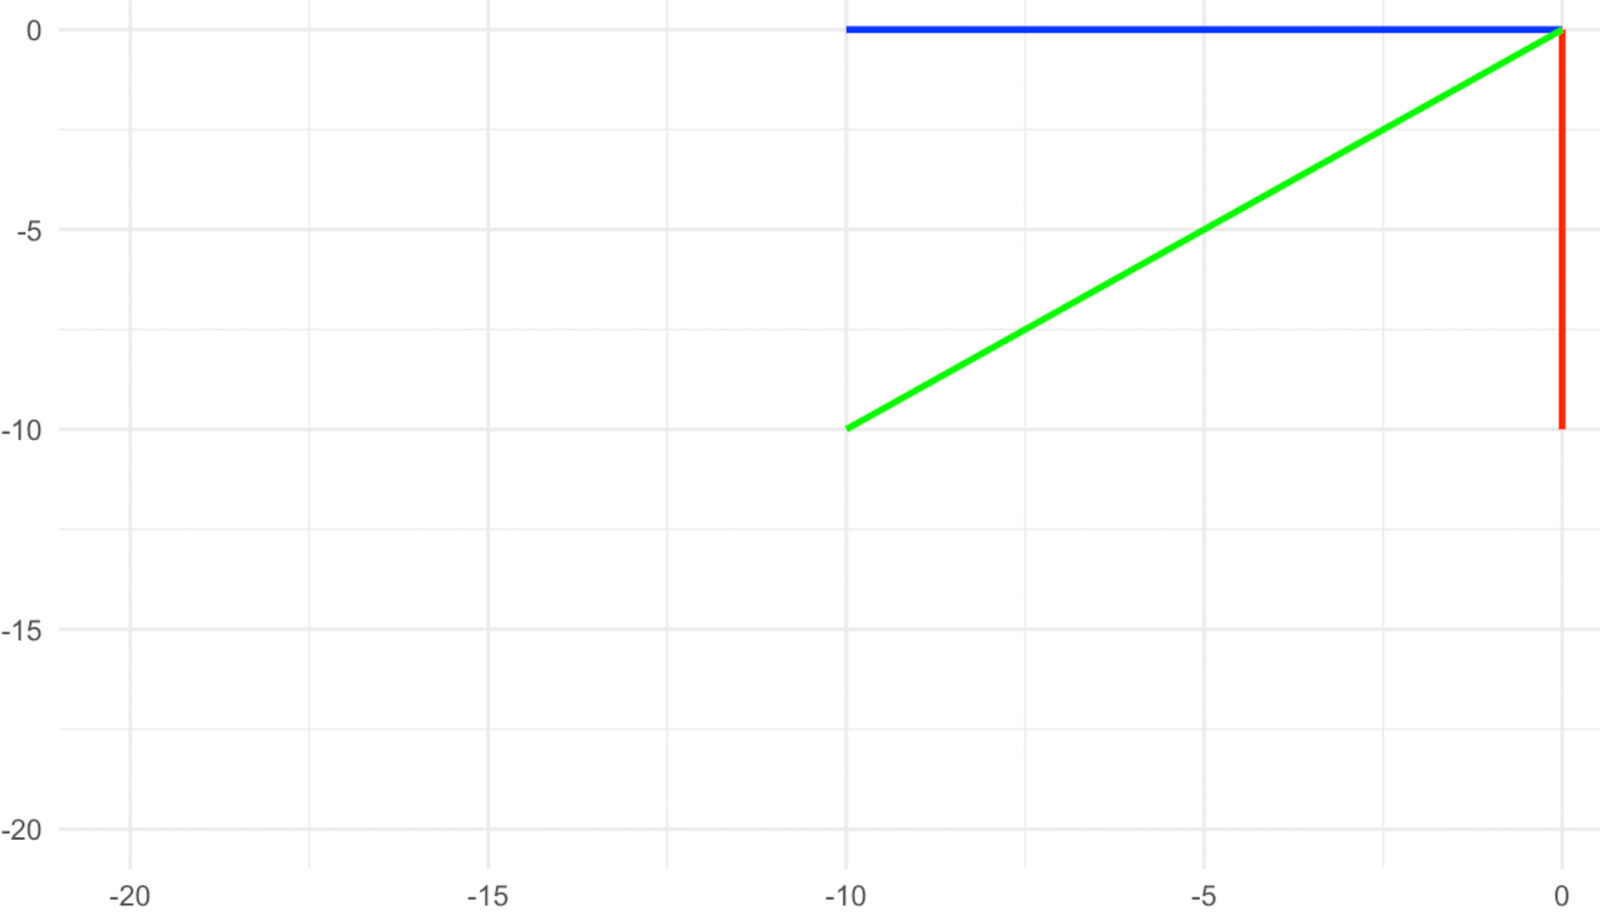
Vecteurs après rotation. Image de l’auteur
Quelle est la valeur propre de chacun de ces vecteurs propres ? Leur norme est inchangée, donc la valeur propre vaut 1, mais comme ils ont aussi pivoté, le signe doit être négatif. Ici, la valeur propre est donc −1.
Dans notre exemple, les valeurs propres sont simples (toutes égales à 1), mais en général elles peuvent être n’importe quel nombre : entiers comme 1 ou 2, rationnels (fractions) comme 1/2 ou 0,75, ou irrationnels comme la valeur de π. Elles peuvent même être complexes, de la forme a + bi, où « a » et « b » sont réels et « i » est l’unité imaginaire (racine carrée de −1). Des valeurs propres complexes renseignent aussi sur la nature de la transformation linéaire : rotation, oscillation, etc.
Même si des bibliothèques de base en R, et des librairies Python comme SciPy et NumPy, calculent aisément vecteurs et valeurs propres, comprendre les équations sous-jacentes a une vraie valeur. Dans cette section, nous revoyons l’« équation caractéristique », qui permet de calculer pas à pas valeurs et vecteurs propres d’une matrice simple, puis nous mentionnons d’autres méthodes numériques pour des matrices de grande taille (donc des jeux de données volumineux).
On détermine vecteurs et valeurs propres via l’équation caractéristique. On trouve d’abord les valeurs propres, puis, une fois l’une d’elles connue, on calcule le vecteur propre associé en résolvant un système linéaire.
Pour une matrice 𝐴 et un vecteur 𝑣, l’équation de base est :
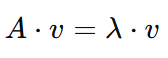
Autrement dit, quand la matrice 𝐴 agit sur le vecteur 𝑣, le résultat est une version mise à l’échelle de 𝑣. Ici :
Gardons à l’esprit que l’objectif est de déterminer à la fois λ (valeur propre) et 𝑣 (vecteur propre).
Pour avancer, nous devons isoler λ. Déplaçons donc le membre de droite à gauche en changeant le signe :
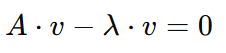
Nous pouvons factoriser 𝑣, mais comme 𝐴 est une matrice et 𝑣 un vecteur, nous devons multiplier 𝑣 par ce que l’on appelle une matrice identité, notée I. Une matrice identité est une matrice carrée (n×n) avec des 1 sur la diagonale et des 0 ailleurs. En multiplication matricielle, elle joue le rôle du nombre 1. Voici, par exemple, une identité 3×3 :
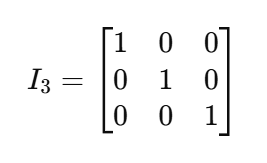
En revenant à notre équation, si nous factorisons 𝑣 et le multiplions par I, nous obtenons :
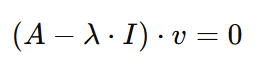
Pour résoudre l’équation obtenue, soit le vecteur propre 𝑣 est nul, soit il appartient au noyau de 𝐴 − λ⋅I. Or un vecteur propre ne peut pas être nul. Il faut donc que 𝐴 − λ⋅I soit singulière. Pour que le membre de gauche s’annule, on impose donc que le déterminant de 𝐴 − λ⋅I soit nul. On obtient alors :
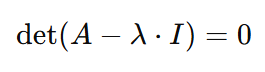
Nous voici à l’équation caractéristique. Sa résolution fournit les valeurs propres λ et les vecteurs propres 𝑣, comme montré dans les étapes suivantes.
Supposons que la matrice 𝐴 soit :
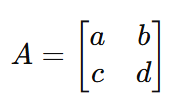
En remplaçant 𝐴 par cette matrice dans l’équation caractéristique, on obtient :
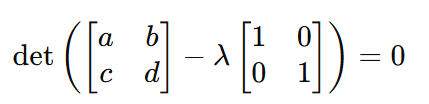
Donc :
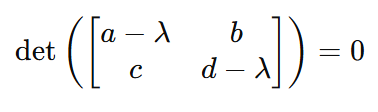
Puis :
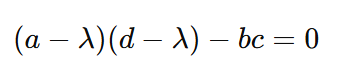
À partir de cette forme simplifiée, on calcule les valeurs propres λ en substituant simplement les valeurs de la matrice.
Une fois les valeurs propres λ obtenues, il reste à déterminer les vecteurs propres 𝑣. Pour cela, revenons à la forme suivante :
En remplaçant 𝐴, λ et I par leurs valeurs, on calcule directement le vecteur propre 𝑣.
Comme on l’a vu, la difficulté du calcul dépend fortement de la taille de la matrice. Notre exemple utilisait une matrice 𝐴 2×2. En pratique, on ne peut pas procéder ainsi pour des matrices beaucoup plus grandes (centaines ou milliers de lignes et de colonnes). On recourt alors à des langages comme Python et R, qui utilisent des méthodes numériques (et non symboliques). Parmi les techniques employées :
Les vecteurs propres et les valeurs propres sont essentiels dans de nombreux cas d’usage :
Nous avons indiqué que les valeurs propres peuvent être réelles ou complexes. Elles peuvent donc être nulles, et plusieurs valeurs propres d’une même matrice peuvent être égales. Ces deux situations constituent des écueils possibles de toute analyse propre. Voyons-les de plus près.
Une valeur propre nulle signifie que la transformation du vecteur propre associé aboutit au vecteur nul, réductible à un point sans norme ; il n’explique donc aucune variance du jeu de données. On peut traiter ce problème par des techniques de régularisation, comme la régression ridge (régularisation de Tikhonov), ou en supprimant les variables colinéaires (réduction de dimension), ce que l’ACP réalise naturellement. Ainsi, la valeur propre nulle n’est pas un problème pour l’ACP ; l’ACP peut même en être une solution. En revanche, pour d’autres algorithmes qui résolvent des systèmes linéaires (régressions linéaire, ridge, lasso), le cas d’une valeur propre nulle doit être traité en amont.
Quand plusieurs valeurs propres sont identiques, on parle de dégénérescence ; cela pose problème en pratique, notamment en ACP et en clustering spectral. En ACP, si plusieurs vecteurs propres partagent la même valeur propre, ils capturent la même part de variance ; le choix du nombre k de composantes principales devient alors délicat. En clustering spectral, où l’on exploite les valeurs propres de la matrice de similarité, des valeurs dégénérées peuvent indiquer que des points sont également similaires selon plusieurs dimensions, rendant difficile le choix des dimensions (ou vecteurs propres) pertinents pour séparer les groupes.
Impossible d’évoquer vecteurs et valeurs propres sans parler de décomposition en valeurs propres (eigendecomposition). Il s’agit de décomposer une matrice carrée A en ses vecteurs et valeurs propres. Pour une matrice décomposable, on peut écrire :
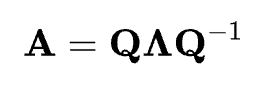
La décomposition en valeurs propres indique que la matrice A s’exprime comme le produit de la matrice de ses vecteurs propres Q, d’une matrice diagonale Λ de ses valeurs propres, et de l’inverse de Q, noté Q-1. Le produit de ces matrices reconstitue la matrice A d’origine. Cette décomposition est précieuse : elle permet d’analyser et de simplifier des transformations linéaires complexes, d’interpréter le comportement d’un système et de réduire le coût de nombreux calculs.
Dans cet article, nous avons défini vecteurs et valeurs propres et montré leur importance en data science et en machine learning. Nous avons aussi décrit leur calcul mathématique, ainsi que les écueils possibles lors de leur détermination.
En complément du cours Linear Algebra in R et du tutoriel SciPy sur les vecteurs et les tableaux, si vous souhaitez aller plus loin sur ces notions et leurs applications en machine learning, suivez notre parcours de carrière Machine Learning Scientist with Python et devenez expert de l’apprentissage supervisé et non supervisé, y compris, bien sûr, la réduction de dimension.
Learn with DataCamp
Cours
Cours
Cours