
कोर्स
R में Data Science के लिए Linear Algebra
4 घंटा
21.7K
Eigenvectors और eigenvalues रैखिक बीजगणित की बुनियादी अवधारणाएँ हैं जिनके डेटा साइंस और मशीन लर्निंग में दूरगामी निहितार्थ हैं। ये गणितीय इकाइयाँ रैखिक रूपांतरणों के व्यवहार को समझने में उपयोगी अंतर्दृष्टि देती हैं, जिससे हम डेटा की अंतर्निहित संरचना समझ सकते हैं, बहुत अधिक फीचर्स वाले जटिल डेटासेट्स को सरल बना सकते हैं, और इस प्रकार वांछित लक्ष्य पाने के लिए उनके प्रसंस्करण को संभव बना सकते हैं।
यदि यह आपको dimensionality reduction जैसा लगता है, तो आप सही हैं। Eigenvectors और eigenvalues कई dimensionality reduction तकनीकों के पीछे काम करते हैं, जैसे principal component analysis (PCA)। ये spectral clustering के लिए भी आधार हैं, जिसमें शुरुआती चरण के रूप में dimensionality reduction शामिल होता है।
Eigen की दुनिया की अवधारणा को पकड़ने के लिए, आपको रैखिक बीजगणित के पूर्व ज्ञान—मुख्यतः वेक्टर और स्केलर, रैखिक रूपांतरण, और determinants—की अच्छी समझ चाहिए। यदि आप इन अवधारणाओं में नए हैं, तो आप हमारा hands-on Linear Algebra for Data Science in R कोर्स ले सकते हैं, या अगर आप Python उपयोगकर्ता हैं, तो यह SciPy ट्यूटोरियल on vectors and arrays देख सकते हैं।
आइए इस तथ्य से शुरू करें कि eigenvectors और eigenvalues में “eigen” का हिस्सा वास्तव में एक अर्थ रखता है; यह किसी आविष्कारक का नाम नहीं है। Eigen एक जर्मन शब्द है, जिसे इस संदर्भ में मोटे तौर पर “विशेषता” या “आंतरिक” के रूप में अनुवादित किया जा सकता है।
अब कल्पना करें कि हम वेक्टरों के एक समूह पर स्केलिंग, shearing या rotation जैसे रैखिक रूपांतरण लागू करते हैं। कुछ वेक्टर अपनी दिशा बदलते हैं, और कुछ नहीं बदलते। जो वेक्टर अपनी दिशा नहीं बदलते (या ठीक विपरीत दिशा में घूम जाते हैं) उन्हें हम eigenvectors कहते हैं, क्योंकि वे हुए रूपांतरण (या जिस मैट्रिक्स का वे वर्णन करते हैं) के “विशेषता” वेक्टर बन जाते हैं। जितनी मात्रा (magnitude) से वे स्केल हुए, वही eigenvalue होती है। यानी, eigenvalue रूपांतरण का स्केलिंग फैक्टर है।
इन दोनों अवधारणाओं को बेहतर समझने के लिए, पहले एक ज्यामितीय उदाहरण देखें और फिर डेटा साइंस में इनके उपयोग की ओर बढ़ें।
एक द्वि-आयामी स्थान की कल्पना करें, जिसमें हमारे पास तीन वेक्टर हैं—नीला जो x-अक्ष पर है, लाल जो y-अक्ष पर है, और हरा जो दोनों के बीच तिरछा है। अब, हम y-अक्ष के साथ फैक्टर 2 की स्केलिंग रूपांतरण लागू करते हैं, जैसा कि नीचे की छवियों में दिखाया गया है।
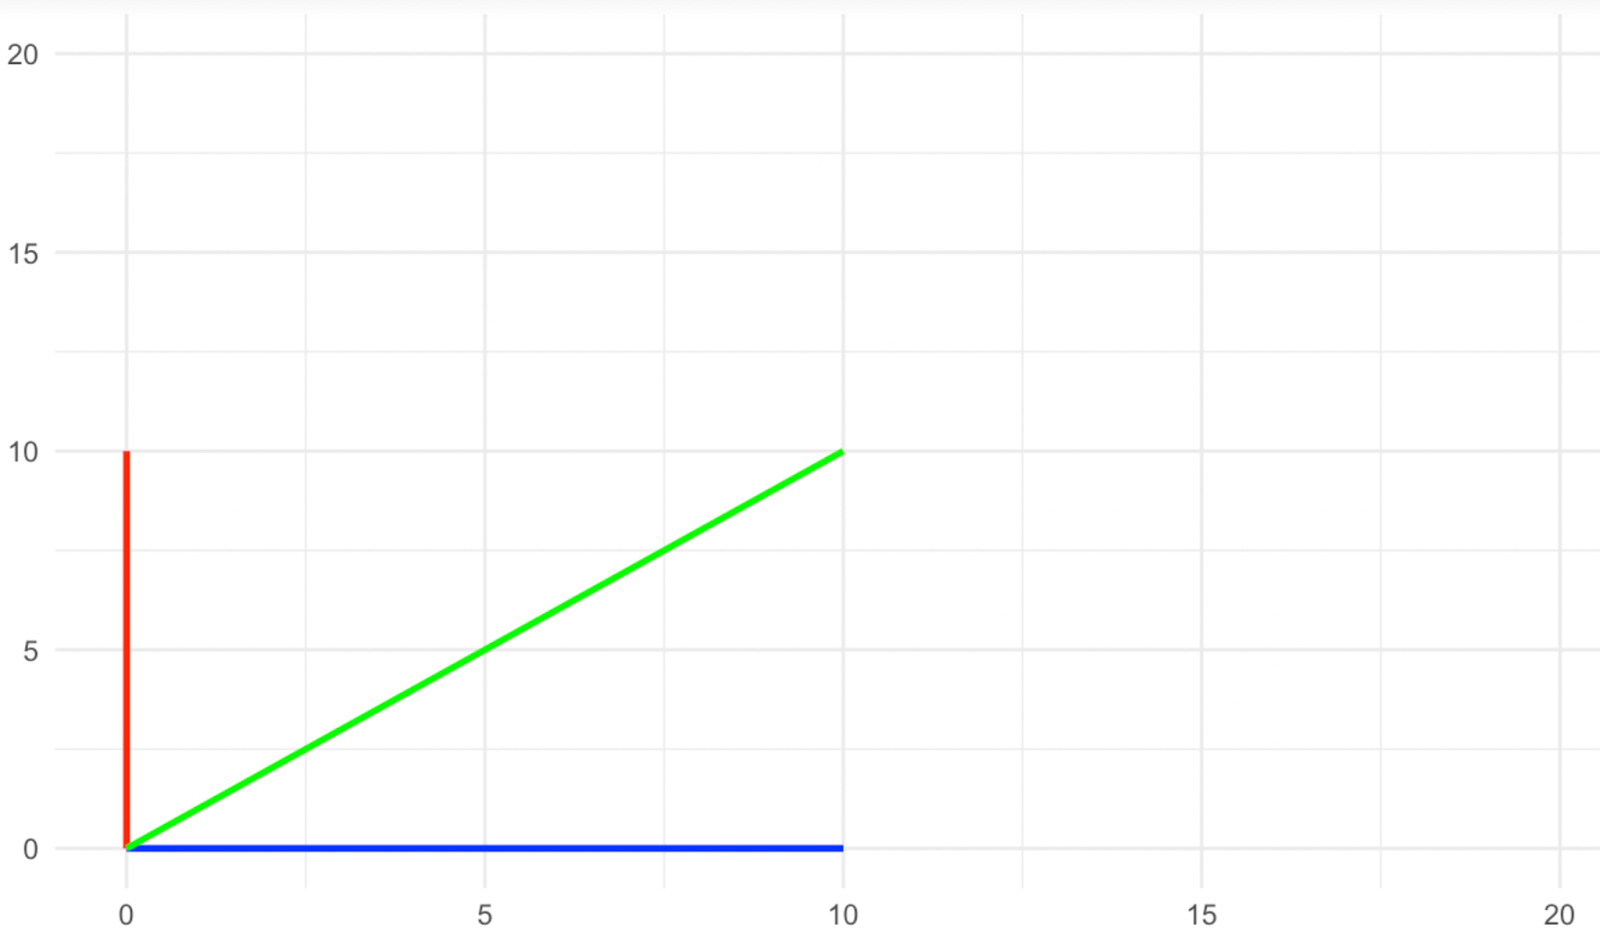
खींचाव से पहले वेक्टर। चित्र: लेखक
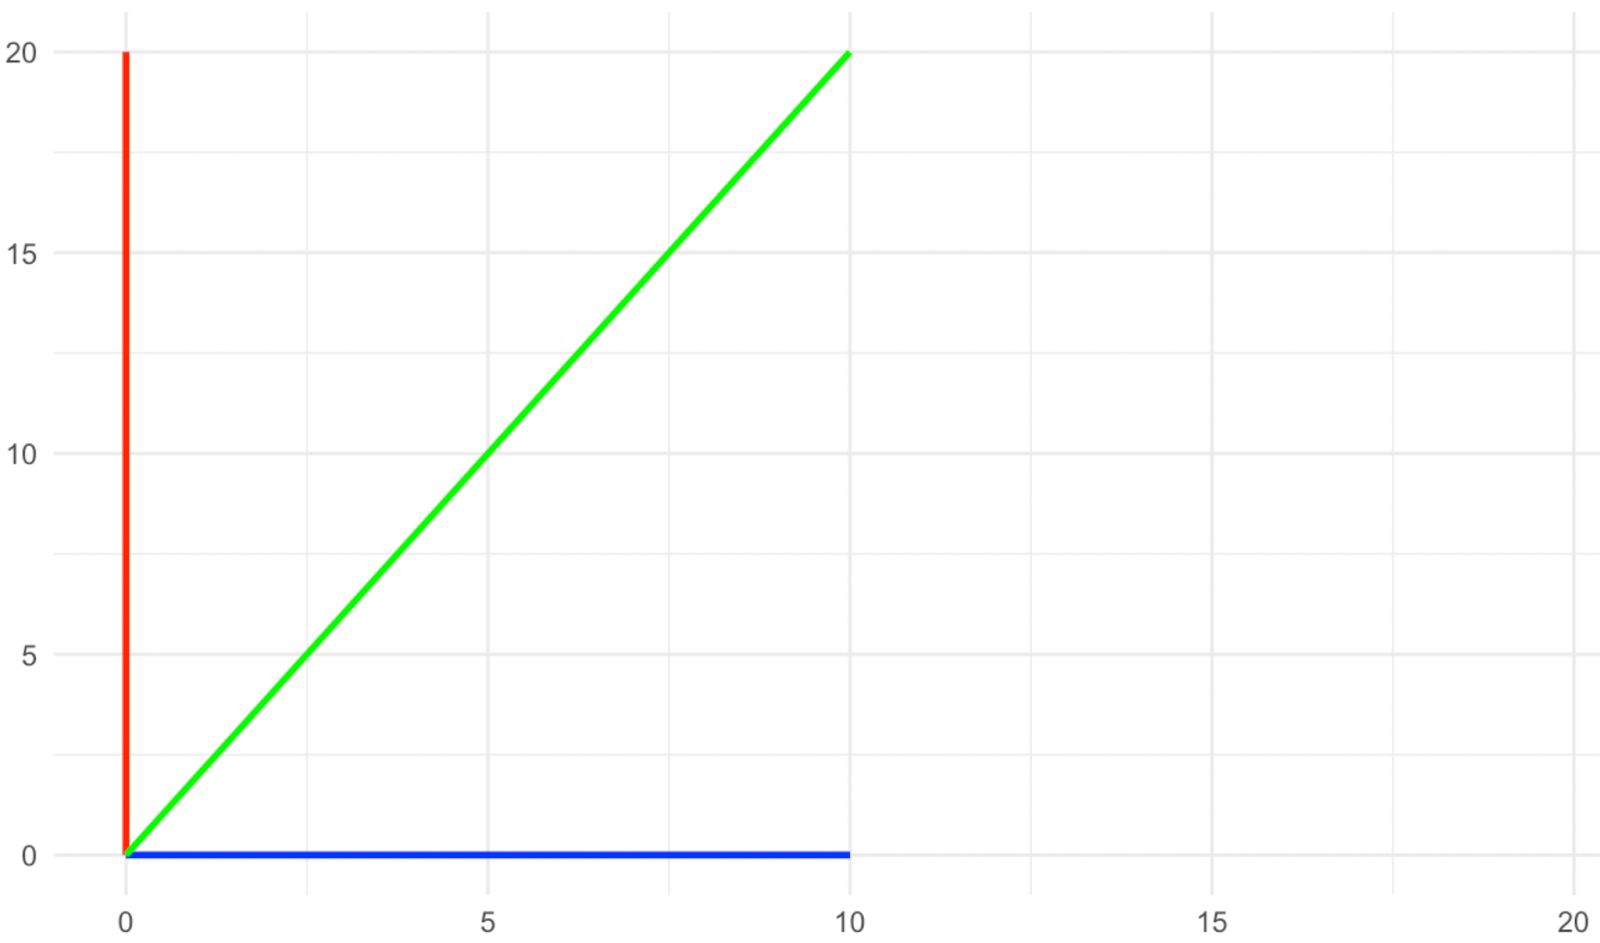
खींचाव के बाद वेक्टर। चित्र: लेखक
दिशा वेक्टरों के साथ क्या हुआ? लाल और नीले वेक्टरों की दिशा स्केलिंग के साथ नहीं बदली, जबकि हरे की बदल गई, है न? इसलिए, इस तरह के रूपांतरण में लाल और नीले वेक्टर eigenvectors कहलाते हैं, क्योंकि वे रूपांतरण के विशिष्ट वेक्टर बन जाते हैं।
ऊपर की छवियों को फिर से देखें और देखें कि eigenvectors (लाल और नीले) की magnitude के साथ क्या हुआ। नीले eigenvector की magnitude नहीं बदली, जबकि लाल की दोगुनी हो गई—या कहें कि वह फैक्टर 2 से स्केल हुआ। जिस मात्रा से प्रत्येक eigenvector स्केल हुआ, वही eigenvalue है। इसलिए, यहाँ नीले eigenvector की eigenvalue 1 है (इसे गुणा के रूप में सोचें), जबकि लाल की eigenvalue 2 है, क्योंकि उसकी magnitude दोगुनी हो गई।
नीचे दी गई छवियों में दिखाए गए रूपांतरण पर विचार करें, और सबसे पहले इस मामले में eigenvectors क्या हैं, यह सोचें। यदि आपने कहा कि ये तीनों वेक्टर—लाल, हरा और पीला—हैं, तो आप सही हैं, क्योंकि रूपांतरण के बाद ये सभी ठीक विपरीत दिशा में संकेत करते हैं। हम देखते हैं कि संख्या का चिह्न (eigenvalue) हमें हुए रूपांतरण के बारे में अतिरिक्त जानकारी दे सकता है। सकारात्मक eigenvalue इंगित करती है कि रूपांतरण में घूर्णन शामिल नहीं था, जबकि नकारात्मक eigenvalue बताती है कि रूपांतरण में eigenvector का अपने उद्गम के चारों ओर घूर्णन शामिल था।
घूर्णन से पहले वेक्टर। चित्र: लेखक
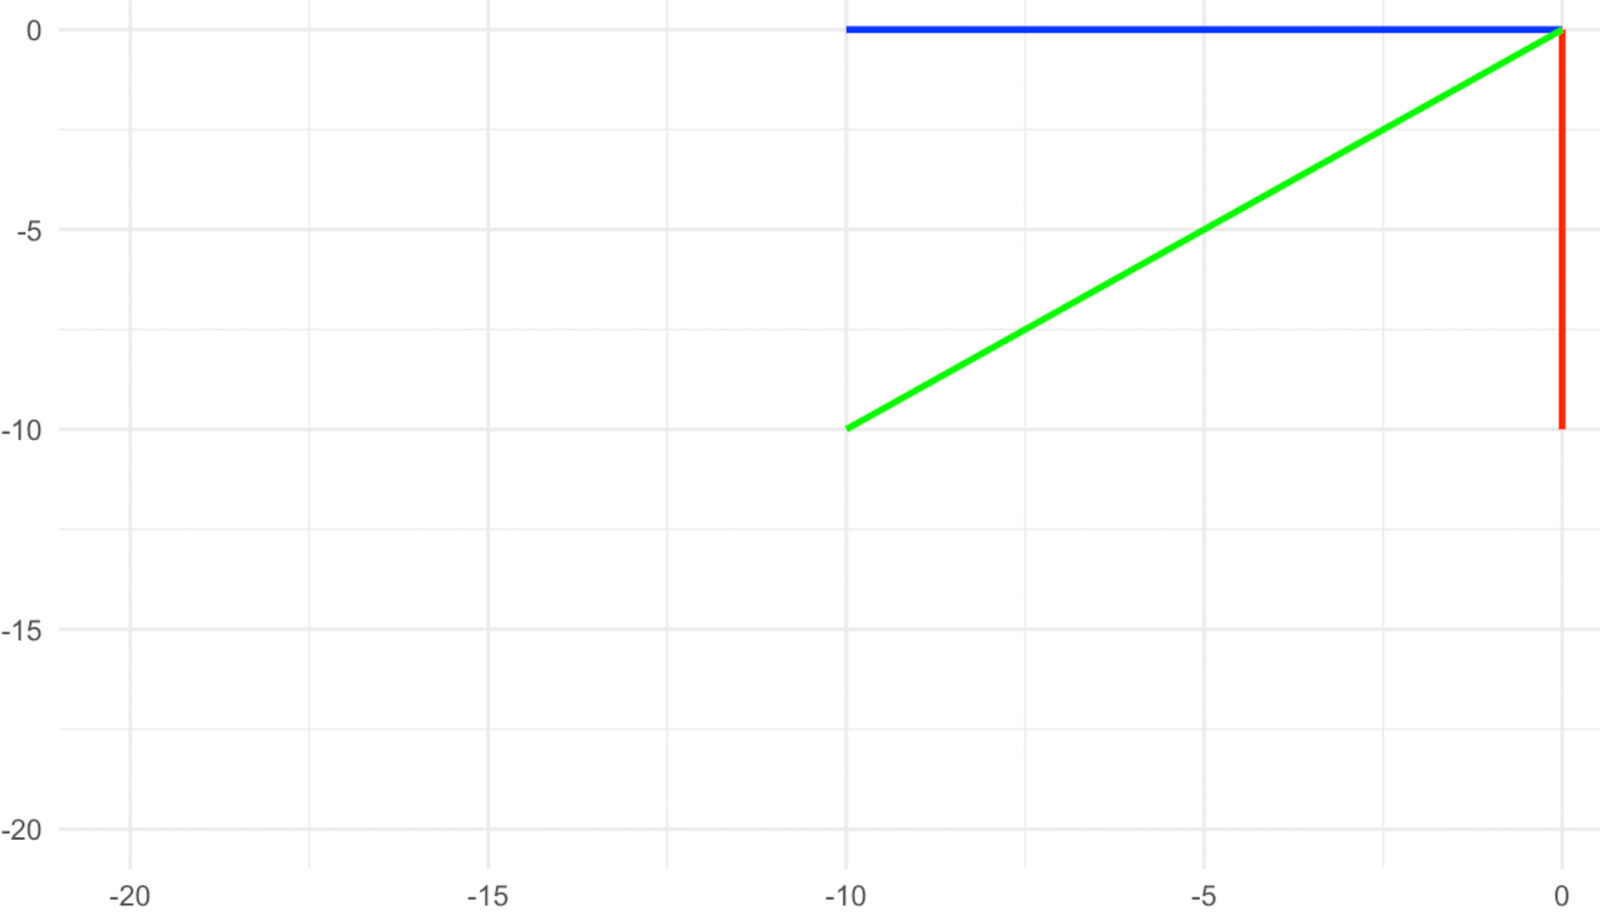
घूर्णन के बाद वेक्टर। चित्र: लेखक
अब, इन eigenvectors में से प्रत्येक की eigenvalue क्या है? चूंकि उनकी magnitude समान रही, इसका अर्थ है eigenvalue 1 है, परंतु साथ ही वे घूमे भी हैं, इसलिए 1 का चिह्न नकारात्मक होना चाहिए। अतः, इस मामले में eigenvalue -1 है।
हमारे उदाहरण में eigenvalues सरल हैं (वे सभी 1 हैं), लेकिन eigenvalues कोई भी संख्या हो सकती हैं—जैसे पूर्णांक 1 और 2, या परिमेय संख्याएँ जैसे 1⁄2 और 0.75। वे अपरिमेय भी हो सकती हैं, जैसे π का मान। Eigenvalues सम्मिश्र संख्याएँ भी हो सकती हैं, जैसे a + bi, जहाँ “a” और “b” वास्तविक संख्याएँ हैं और “i” काल्पनिक इकाई है, जैसे -1 का वर्गमूल। सम्मिश्र eigenvalues भी यह इंगित कर सकती हैं कि किस प्रकार का रैखिक रूपांतरण हुआ—क्या वह घूर्णन था या अधिक जटिल, जैसे दोलन।
हालाँकि R के base पैकेज और Python की SciPy तथा NumPy जैसी लाइब्रेरीज़ eigenvectors और eigenvalues आसानी से निकाल देती हैं, लेकिन इनके पीछे की समीकरणों को समझना अत्यंत मूल्यवान है। इस खंड में, हम characteristic equation की समीक्षा करेंगे, जो किसी सरल मैट्रिक्स के लिए चरण-दर-चरण eigenvectors और eigenvalues निकालती है। इसके बाद, हम बड़े मैट्रिक्स (अर्थात बड़े डेटासेट्स) के लिए अन्य गणनात्मक विधियों का उल्लेख करेंगे।
हम characteristic equation की मदद से eigenvectors और eigenvalues निकाल सकते हैं। इस पद्धति में पहले eigenvalues निकाली जाती हैं, फिर उसी eigenvalue का उपयोग करके संबद्ध eigenvector को रैखिक समीकरणों की प्रणाली हल करके पाया जाता है।
मैट्रिक्स 𝐴 और वेक्टर 𝑣 के लिए eigenvectors और eigenvalues की बुनियादी समीकरण है:
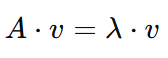
इसका अर्थ है कि जब मैट्रिक्स 𝐴 वेक्टर 𝑣 पर क्रिया करता है, तो परिणाम 𝑣 का स्केल किया हुआ रूप होता है। यहाँ:
ध्यान रखें कि लक्ष्य दोनों λ (eigenvalue) और 𝑣 (eigenvector) को खोजना है।
अपने लक्ष्य के लिए हमें λ के लिए हल करना होगा। इसलिए, हम समीकरण को पुनर्व्यवस्थित करेंगे—दाएँ पक्ष को उल्टे चिह्न के साथ बाएँ पक्ष में ले जाकर—ताकि काम करना आसान हो:
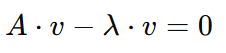
अब हम 𝑣 को factor out कर सकते हैं, पर चूंकि 𝐴 एक मैट्रिक्स है और 𝑣 एक वेक्टर, इसलिए हमें 𝑣 को identity मैट्रिक्स, जिसे I से निरूपित करते हैं, से गुणा करना होगा। Identity मैट्रिक्स एक वर्गाकार मैट्रिक्स (आकार n×n) होता है, जिसकी विकर्ण पर 1 होते हैं और अन्यत्र 0। मैट्रिक्स गुणा के गुणों के कारण, identity मैट्रिक्स मैट्रिसेज़ के लिए संख्या 1 जैसा व्यवहार करता है। उदाहरण के लिए, 3×3 आकार का यह identity मैट्रिक्स देखें:
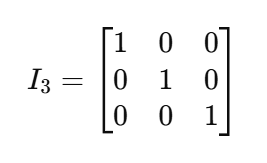
फिर अपनी समीकरण पर लौटते हुए, यदि हम 𝑣 को factor out करें और उसे I से गुणा करें, तो परिणाम होगा:
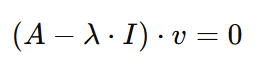
जिस समीकरण तक हम पहुँचे हैं, उसे हल करने के लिए या तो eigenvector 𝑣 शून्य होना चाहिए, या फिर eigenvector 𝐴 −λ⋅I के बराबर होगा। और अब यह बताने का उपयुक्त समय है कि eigenvectors शून्य नहीं हो सकते। इसलिए 𝐴 −λ⋅I शून्य के बराबर होना चाहिए। पर चूंकि lambda अज्ञात है, हम बाएँ पक्ष को दाएँ पक्ष के बराबर कर सकते हैं यदि हम 𝐴 −λ⋅I का determinant लें। इस प्रकार हम निम्न समीकरण पर पहुँचते हैं:
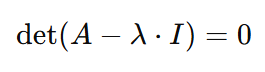
यहीं हम characteristic equation तक पहुँचते हैं। इस समीकरण को हल करने से हमें eigenvalues λ और eigenvector 𝑣 दोनों मिल सकते हैं, जैसा कि अगले चरणों में दिखाया गया है।
मान लें कि हमारे पास निम्न मैट्रिक्स 𝐴 है:
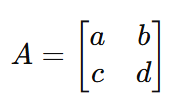
Characteristic equation में 𝐴 को वास्तविक मैट्रिक्स से प्रतिस्थापित करने पर, समीकरण बनता है:
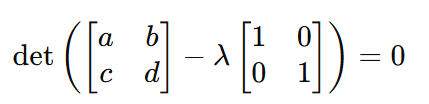
और इसलिए:
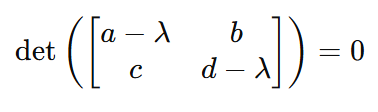
और एक बार फिर इसलिए:
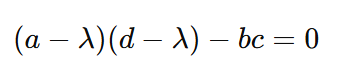
इस अधिक सरल रूप से, हम केवल मैट्रिक्स के मान प्रतिस्थापित करके eigenvalues λ के मान निकाल सकते हैं।
Eigenvalues λ मिलने के बाद अब eigenvectors 𝑣 निकालने हैं। हम इस पूर्व रूप की समीकरण पर लौटकर यह कर सकते हैं:
अब यदि हम 𝐴, λ, और I को उनके मानों से प्रतिस्थापित करें, तो eigenvector 𝑣 का मान सरलता से निकाला जा सकता है।
जैसा कि हमने देखा, eigenvectors और eigenvalues की गणना की जटिलता काफी हद तक मैट्रिक्स के आकार पर निर्भर करती है। हमारे उदाहरण में हमने सरल 2×2 𝐴 मैट्रिक्स का उपयोग किया। परंतु जब मैट्रिक्स बहुत बड़े हो जाते हैं—सैकड़ों या हजारों पंक्तियाँ और स्तंभ—तो इस तरीके से eigenvectors और eigenvalues व्यावहारिक रूप से नहीं निकाले जा सकते। ऐसे मामलों में हम Python और R जैसी प्रोग्रामिंग भाषाएँ उपयोग करते हैं, जो सांकेतिक (symbolic) के बजाय संख्यात्मक (numerical) गणना विधियाँ अपनाती हैं। कुछ तकनीकें शामिल हैं:
Eigenvectors और eigenvalues अनेक अनुप्रयोगों में आवश्यक हैं, जिनमें शामिल हैं:
हमने कहा कि eigenvalues कोई भी वास्तविक या सम्मिश्र संख्या हो सकती हैं। इसका अर्थ है eigenvalue शून्य भी हो सकती है, और यह भी कि विश्लेषित मैट्रिक्स में एकाधिक eigenvalues समान हो सकती हैं। इन दोनों परिस्थितियों को eigen विश्लेषण में उत्पन्न होने वाली दो समस्याएँ माना जाता है। आइए प्रत्येक पर नज़र डालें।
शून्य eigenvalue समस्या इसलिए है क्योंकि इसका अर्थ है कि उसके संबद्ध eigenvector का रूपांतरण शून्य वेक्टर में परिणत हुआ, जिसे स्थान में बिना magnitude वाले एक बिंदु के रूप में समझा जा सकता है, और इसलिए वह डेटासेट में कोई variance नहीं समझाता। इस समस्या से regularization तकनीकों, जैसे ridge regression (Tikhonov regularization), या collinear फीचर्स हटाने (अर्थात dimensionality reduction) से निपटा जा सकता है, जो स्वाभाविक रूप से PCA एल्गोरिद्म में होता है। इसलिए, PCA के लिए शून्य eigenvalue समस्या नहीं है; बल्कि, PCA एक समाधान भी हो सकता है। हालाँकि, अन्य मशीन लर्निंग एल्गोरिद्म जिनमें रैखिक प्रणालियाँ हल करनी पड़ती हैं—जैसे linear, ridge और lasso regression—में शून्य eigenvalue समस्या का पहले से समाधान किया जाना चाहिए।
जब एकाधिक eigenvalues का मान समान होता है, तो वे degenerate कहलाती हैं, और डेटा साइंस में—खासतौर पर व्यावहारिक रूप से PCA और spectral clustering में—यह समस्या पैदा करती हैं। PCA में, यदि एकाधिक eigenvectors की eigenvalues समान हों, तो इसका अर्थ है कि ये eigenvectors डेटासेट में समान मात्रा का variance कैप्चर करते हैं, और इसीलिए k principal components का चयन समस्याग्रस्त हो जाता है। Spectral clustering में, जहाँ similarity मैट्रिक्स की eigenvalues का उपयोग डेटा बिंदुओं को समूहित करने में होता है, degenerate eigenvalues इंगित कर सकती हैं कि डेटा बिंदु कई आयामों में समान रूप से समान हैं, जिससे यह तय करना कठिन हो जाता है कि किन आयामों या eigenvectors को क्लस्टर्स अलग करने के लिए उपयोग करना चाहिए।
Eigenvectors और eigenvalues पर कोई भी चर्चा eigendecomposition के बिना पूर्ण नहीं होगी। Eigendecomposition एक वर्गाकार मैट्रिक्स A को उसके eigenvectors और eigenvalues में विघटित करने की प्रक्रिया है। जिसे विघटित किया जा सकता है, ऐसे मैट्रिक्स को इस प्रकार व्यक्त किया जा सकता है:
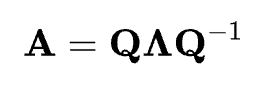
Eigendecomposition बताता है कि मैट्रिक्स A को उसके eigenvectors मैट्रिक्स Q, eigenvalues के एक विकर्ण मैट्रिक्स Λ, और eigenvectors मैट्रिक्स के व्युत्क्रम Q-1 के गुणनफल के रूप में व्यक्त किया जा सकता है। इन मैट्रिसेज़ को मैट्रिक्स गुणा में एक साथ गुणा करने पर मूल मैट्रिक्स A पुनर्निर्मित हो जाता है। Eigendecomposition महत्वपूर्ण है क्योंकि यह जटिल रैखिक रूपांतरणों को समझने और सरल बनाने का तरीका देता है, प्रणाली के व्यवहार पर अंतर्दृष्टि प्रदान करता है, और कई गणनाओं को सरल बनाता है।
इस लेख में, हमने देखा कि eigenvectors और eigenvalues क्या होते हैं और वे डेटा साइंस तथा मशीन लर्निंग में कितने प्रासंगिक हैं। हमने यह भी देखा कि उन्हें गणितीय रूप से कैसे निकाला जाता है, साथ ही उन त्रुटियों पर भी चर्चा की जो eigenvectors और eigenvalues खोजते समय आ सकती हैं।
उपर्युक्त Linear Algebra in R कोर्स और SciPy ट्यूटोरियल on vectors and arrays के अलावा, यदि आप eigenvectors और eigenvalues तथा उनके मशीन लर्निंग अनुप्रयोगों के प्रति गंभीर हैं, तो हमारा Machine Learning Scientist with Python करियर ट्रैक आज़माएँ और supervised तथा unsupervised learning में विशेषज्ञ बनें, जिनमें, स्वाभाविक रूप से, dimensionality reduction भी शामिल है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स