
{count, plural, one {Cursus} other {Cursussen}}
Lineaire algebra voor data science in R
{hours} uur
21.8K
Eigenvectoren en eigenwaarden zijn fundamentele concepten uit de lineaire algebra met grote invloed op data science en machine learning. Deze wiskundige objecten geven waardevolle inzichten in het gedrag van lineaire transformaties. Zo helpen ze ons de onderliggende structuur van data te begrijpen, complexe datasets met veel features te vereenvoudigen en ze daardoor beter te verwerken om het beoogde doel te bereiken.
Als dit klinkt als dimensionaliteitsreductie, heb je gelijk. Eigenvectoren en eigenwaarden draaien onder de motorkap van veel technieken voor dimensionaliteitsreductie, zoals principal component analysis (PCA). Ze vormen ook het mechaniek achter spectral clustering, waarbij dimensionaliteitsreductie een eerste stap is.
Om grip te krijgen op de wereld van eigenvectoren heb je een redelijke basis in lineaire algebra nodig: met name vectoren en scalairen, lineaire transformaties en determinanten. Ben je nieuw met deze concepten, volg dan onze praktische cursus Linear Algebra for Data Science in R, of als je Python gebruikt, bekijk dan deze SciPy‑tutorial over vectoren en arrays.
Laten we beginnen met het feit dat het deel “eigen” in eigenvectoren en eigenwaarden daadwerkelijk iets betekent en niet de naam is van iemand die ze heeft uitgevonden. Eigen is een Duits woord dat in deze context ruwweg kan worden vertaald als het “karakteristieke” of “intrinsieke” van iets.
Stel nu dat we een groep vectoren onderwerpen aan een lineaire transformatie, zoals schalen, afschuiven of roteren. Sommige vectoren veranderen van richting, en sommige niet. De vectoren die hun richting niet veranderen (of precies naar de tegenovergestelde richting draaien) noemen we de eigenvectoren, omdat ze de “karakteristieke” vectoren van de uitgevoerde transformatie (of van de matrix die die beschrijft) worden. De hoeveelheid (magnitude) waarmee ze geschaald zijn, is de eigenwaarde. Met andere woorden: de eigenwaarde is de schaalfactor van de transformatie.
Om de twee concepten beter te begrijpen, werken we eerst een geometrisch geval uit en gaan we daarna in op hun toepassing in data science.
Stel je een tweedimensionale ruimte voor met drie vectoren: een blauwe op de x‑as, een rode op de y‑as en een groene diagonaal ertussenin. We passen nu een schaaltransformatie toe langs de y‑as met factor twee, zoals je hieronder ziet.
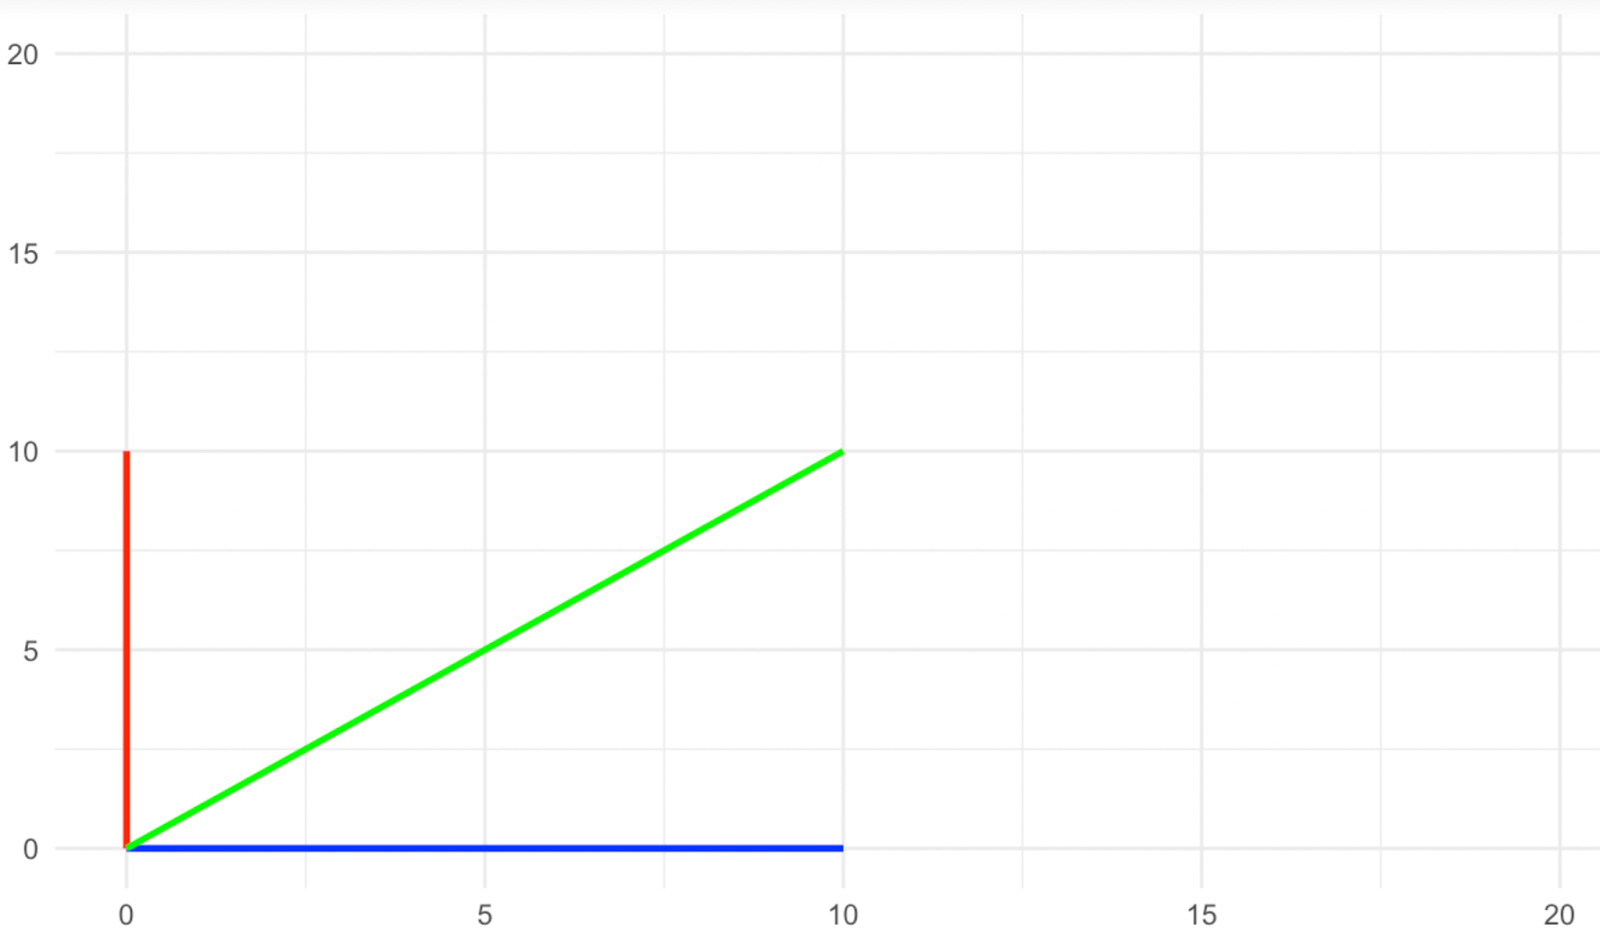
Vectoren vóór het uitrekken. Afbeelding door de auteur
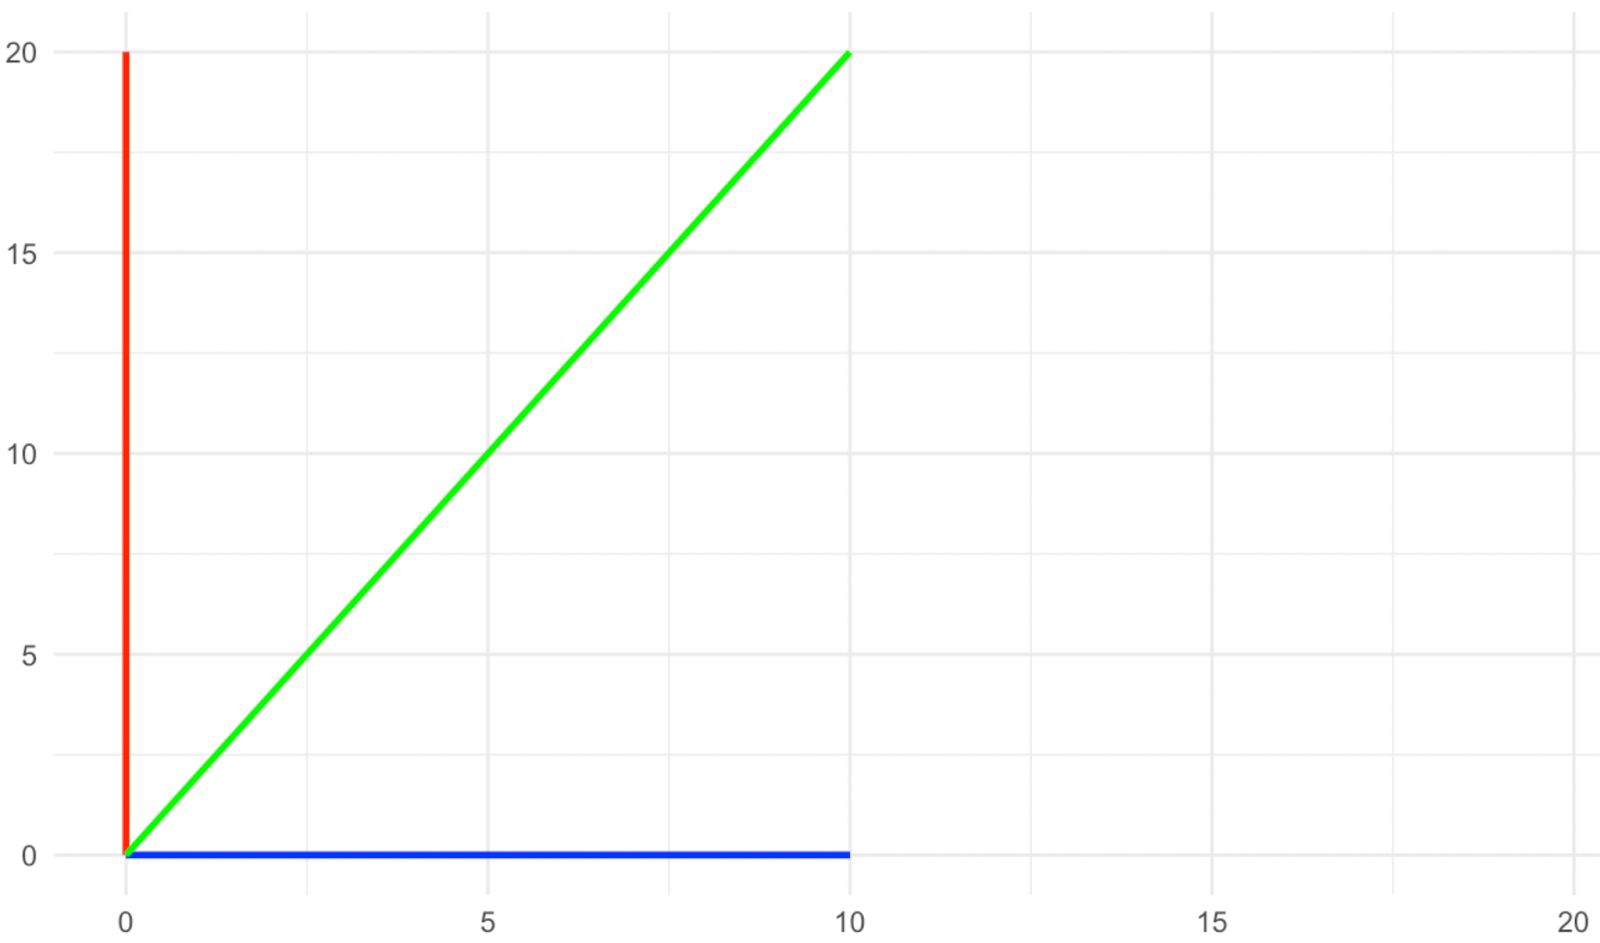
Vectoren na het uitrekken. Afbeelding door de auteur
Wat gebeurde er met de richtingsvectoren? De rode en blauwe veranderden niet van richting door het schalen, terwijl de groene dat wel deed, toch? Bij dit soort transformatie zijn de rode en blauwe vectoren dus de eigenvectoren, omdat ze de karakteristieke vectoren van de transformatie worden.
Kijk nog eens naar de afbeeldingen en zie wat er gebeurde met de magnitude van de eigenvectoren (de rode en blauwe). De blauwe eigenvector veranderde niet van magnitude, terwijl de rode verdubbelde of, chiquer gezegd, werd geschaald met factor twee. De hoeveelheid waarmee elke eigenvector is geschaald door de transformatie noemen we de eigenwaarden. De eigenwaarde van de blauwe eigenvector is hier dus 1 (denk aan vermenigvuldiging), terwijl de eigenwaarde van de rode 2 is, omdat zijn magnitude is verdubbeld.
Bekijk de transformatie in de onderstaande afbeeldingen en bedenk eerst wat hier de eigenvectoren zijn. Als je zegt dat het de drie vectoren zijn — rood, groen en geel — dan klopt dat, want ze wijzen na de transformatie allemaal precies in de tegenovergestelde richting. We zien dat het teken van het getal (de eigenwaarde) extra informatie kan geven over de uitgevoerde transformatie. Een positieve eigenwaarde geeft aan dat de transformatie geen rotatie bevatte, terwijl een negatieve eigenwaarde aangeeft dat de transformatie een rotatie van de eigenvector rond zijn oorsprong inhield.
Vectoren vóór de rotatie. Afbeelding door de auteur
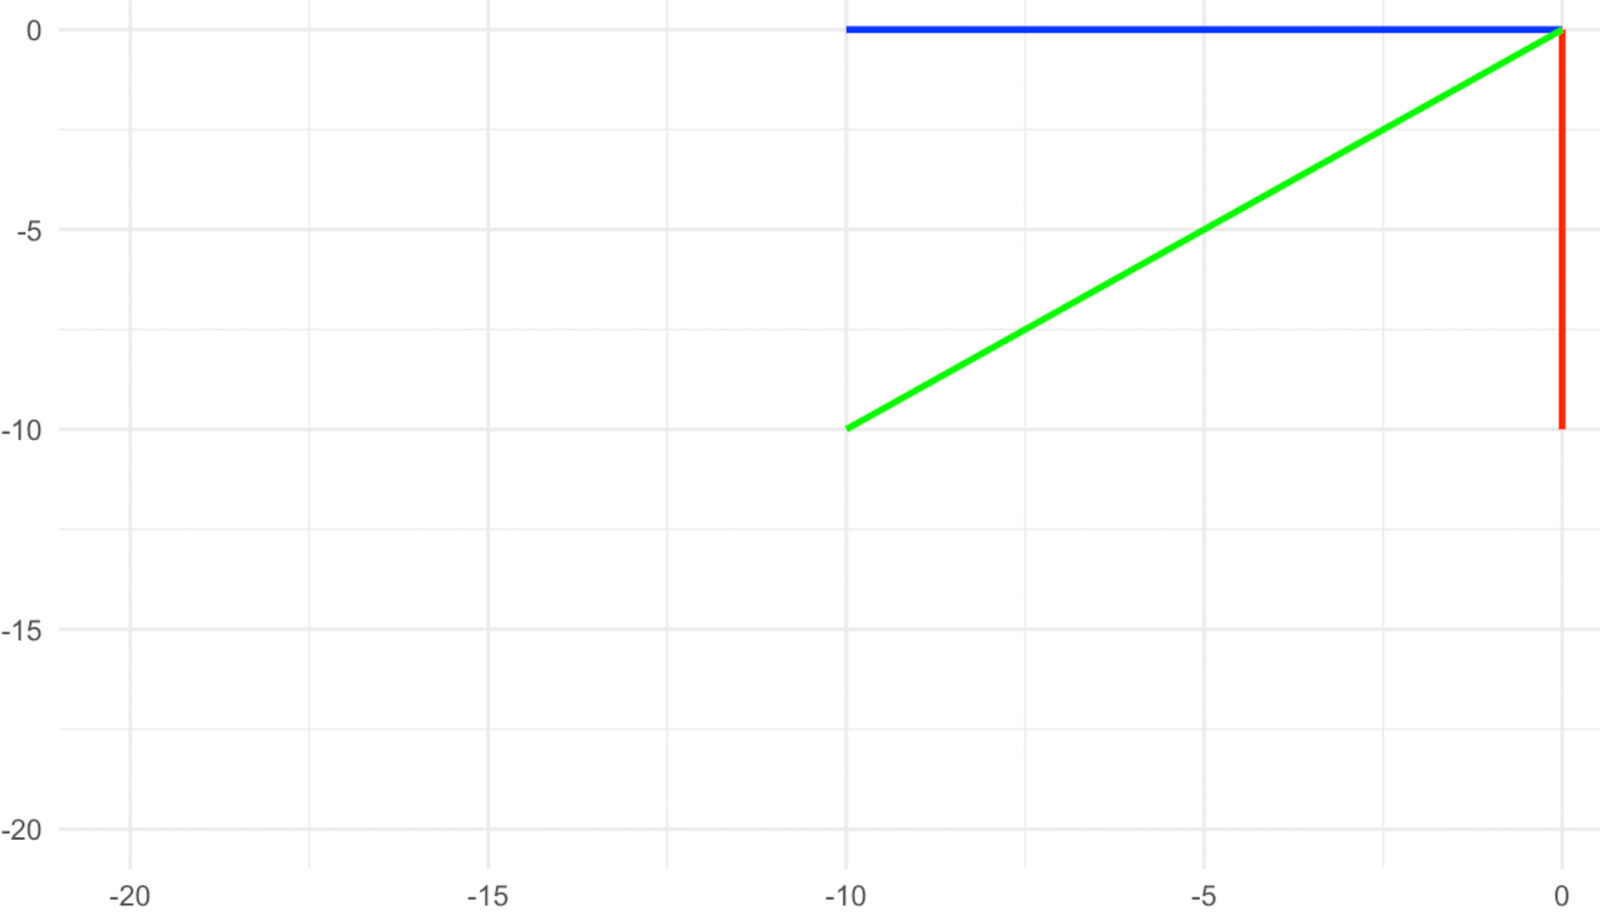
Vectoren na de rotatie. Afbeelding door de auteur
Wat is nu de eigenwaarde van elk van deze eigenvectoren? Het feit dat hun magnitude gelijk blijft, betekent dat de eigenwaarde 1 is, maar omdat ze ook roteerden, moet het teken van die 1 negatief zijn. De eigenwaarde is hier dus −1.
In ons voorbeeld zijn de eigenwaarden eenvoudig (ze zijn allemaal 1), maar eigenwaarden kunnen elk getal zijn: gehele getallen zoals 1 en 2, rationale getallen (breuken) zoals ½ en 0,75, of irrationale getallen zoals de waarde van π. Eigenwaarden kunnen zelfs complexe getallen zijn, zoals a + bi, waarbij “a” en “b” afzonderlijk reële getallen zijn en “i” een imaginaire eenheid is, zoals de wortel uit −1. Complexe eigenwaarden kunnen ook aangeven welk type lineaire transformatie heeft plaatsgevonden, of het bijvoorbeeld om een rotatie gaat of een complexere zoals een oscillatie.
Hoewel bibliotheken in de base‑package van R en Python‑bibliotheken zoals SciPy en NumPy eenvoudig eigenvectoren en eigenwaarden kunnen vinden, is het begrijpen van de achterliggende vergelijkingen enorm waardevol. In deze sectie bespreken we de zogeheten karakteristieke vergelijking, die stap voor stap de eigenvectoren en eigenwaarden van een eenvoudige matrix berekent. Daarna noemen we andere rekenmethoden voor grotere matrices (dus grote datasets).
We kunnen de eigenvectoren en eigenwaarden vinden met wat bekendstaat als de karakteristieke vergelijking. Met die vergelijking vind je eerst de eigenwaarden en daarna de eigenvectoren. Zodra de eigenwaarde bekend is, gebruik je die om de bijbehorende eigenvector te berekenen door een stelsel van lineaire vergelijkingen op te lossen.
Voor een matrix 𝐴 en een vector 𝑣 is de basisvergelijking voor eigenvectoren en eigenwaarden:
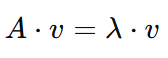
Dit betekent dat wanneer matrix 𝐴 werkt op vector 𝑣, het resultaat een geschaalde versie van 𝑣 is. Hierbij geldt:
Onthoud dat het doel is om zowel λ (de eigenwaarde) als 𝑣 (de eigenvector) te vinden.
Om ons doel te bereiken moeten we oplossen naar λ. We herschikken daarom eerst de vergelijking zodat die makkelijker te hanteren is door de rechterkant naar links te verplaatsen met een omgekeerd teken:
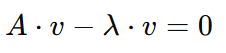
Nu kunnen we de 𝑣 buiten haakjes halen, maar omdat 𝐴 een matrix is en 𝑣 een vector, moeten we 𝑣 vermenigvuldigen met wat een identiteitsmatrix heet, genoteerd als I. Een identiteitsmatrix is een vierkante matrix (van formaat n×n) met 1’en op de diagonaal en 0’en elders. Door de eigenschap van matrixvermenigvuldiging gedraagt een identiteitsmatrix zich voor matrices als het getal 1. Neem bijvoorbeeld deze identiteitsmatrix van formaat 3×3:
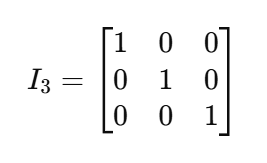
Terug naar onze vergelijking: als we de 𝑣 buiten haakjes halen en vermenigvuldigen met I, krijgen we het volgende:
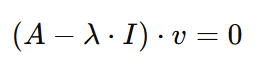
Om de vergelijking waartoe we kwamen op te lossen, moet óf de eigenvector 𝑣 nul zijn, óf de eigenvector zou gelijk zijn aan wat 𝐴 −λ⋅I is. En nu is het een goed moment om nog iets te zeggen over eigenvectoren: ze kunnen niet gelijk zijn aan nul. Dus moet 𝐴 −λ⋅I gelijk zijn aan nul. Maar omdat lambda de onbekende is, kunnen we de linkerkant van de vergelijking gelijk krijgen aan de rechterkant door de determinant te nemen van 𝐴 −λ⋅I. Zo komen we uit op de volgende vergelijking:
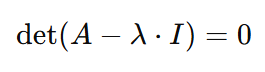
Hiermee zijn we bij de karakteristieke vergelijking aangekomen. Het oplossen daarvan levert zowel de eigenwaarden λ als de eigenvector 𝑣 op, zoals in de resterende stappen wordt getoond.
Stel dat we de volgende matrix 𝐴 hebben:
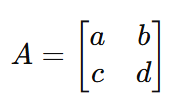
Door in de karakteristieke vergelijking 𝐴 te vervangen door de daadwerkelijke matrix, wordt de vergelijking:
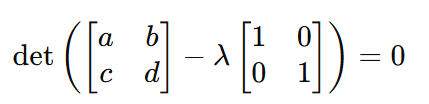
En dus:
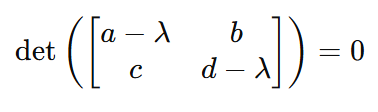
En nogmaals:
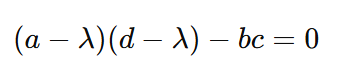
Uit deze veel eenvoudigere vorm kunnen we de waarden van de eigenwaarden λ berekenen door alleen de waarden van de matrix in te vullen.
Nadat we de eigenwaarden λ hebben, rest het vinden van de eigenvectoren 𝑣. Dat doen we door terug te gaan naar deze eerdere vorm van de vergelijking:
Als we nu 𝐴, λ en I vervangen door hun waarden, kunnen we de waarde van de eigenvector 𝑣 eenvoudig berekenen.
Zoals we hebben gezien, hangt de complexiteit van het berekenen van eigenvectoren en eigenwaarden sterk af van de grootte van de matrix. In ons voorbeeld gebruikten we een eenvoudige 2×2‑𝐴‑matrix. Maar in de praktijk kunnen we dit niet zo doen bij veel grotere matrices, met honderden of duizenden rijen en kolommen. Dan gebruiken we programmeertalen zoals Python en R, die numerieke rekenmethoden toepassen in plaats van symbolische methoden. Sommige gebruikte technieken zijn:
Eigenvectoren en eigenwaarden zijn essentieel in veel toepassingen, waaronder:
We zeiden dat eigenwaarden reëel of complex kunnen zijn. Dat betekent dat de eigenwaarde nul kan zijn, en ook dat er in de geanalyseerde matrix meerdere gelijke eigenwaarden kunnen voorkomen. Deze twee gevallen worden gezien als problemen die kunnen ontstaan bij elke eigenanalyse. Laten we ze bekijken.
Een eigenwaarde nul is problematisch omdat dit betekent dat de transformatie van de bijbehorende eigenvector resulteerde in een nulvector, wat je kunt voorstellen als één punt in de ruimte zonder magnitude en dat daarom geen variantie in de dataset verklaart. Het probleem kan worden aangepakt met regularisatietechnieken, zoals ridge‑regressie (Tikhonov‑regularisatie), of door collineaire features te verwijderen (oftewel dimensionaliteitsreductie), wat van nature gebeurt in een PCA‑algoritme. Daarom is een eigenwaarde nul geen probleem voor PCA; sterker nog, PCA kan juist een oplossing zijn. Voor andere machine‑learningalgoritmen die lineaire systemen oplossen, zoals lineaire, ridge‑ en lasso‑regressie, moet het probleem van een eigenwaarde nul echter vooraf worden aangepakt.
Wanneer meerdere eigenwaarden dezelfde waarde hebben, heten ze gedegenereerd, en dat is een probleem in data science, vooral praktisch gezien bij PCA en spectral clustering. Bij PCA betekent het, als meerdere eigenvectoren identieke eigenwaarden hebben, dat deze eigenvectoren dezelfde hoeveelheid variantie in de dataset vastleggen, en daardoor wordt de keuze van k hoofcomponenten problematisch. Bij spectral clustering, waar eigenwaarden van de similariteitsmatrix worden gebruikt om datapunten te groeperen, kunnen gedegenereerde eigenwaarden aangeven dat datapunten in meerdere dimensies even vergelijkbaar zijn, wat het lastig maakt om te bepalen welke dimensies of eigenvectoren moeten worden gebruikt om clusters te scheiden.
Een bespreking van eigenvectoren en eigenwaarden is niet compleet zonder eigendecompositie. Eigendecompositie is het ontbinden van een vierkante matrix A in zijn eigenvectoren en eigenwaarden. Voor een matrix die te decomponeren is, geldt:
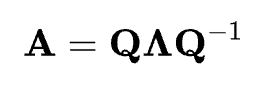
Eigendecompositie zegt dat matrix A kan worden weergegeven als het product van zijn eigenvectorenmatrix Q, een diagonale matrix Λ met de eigenwaarden en de inverse van de eigenvectorenmatrix Q-1. Deze matrices reconstrueren via matrixvermenigvuldiging samen de oorspronkelijke matrix A. Eigendecompositie is belangrijk omdat het een manier biedt om complexe lineaire transformaties te begrijpen en te vereenvoudigen, inzicht geeft in systeengedrag en veel berekeningen vereenvoudigt.
In dit artikel zagen we wat eigenvectoren en eigenwaarden zijn en waarom ze uiterst relevant zijn voor data science en machine learning. We hebben ook behandeld hoe je ze wiskundig berekent en welke problemen kunnen optreden bij het bepalen van eigenvectoren en eigenwaarden.
Naast de cursus Linear Algebra in R en de SciPy‑tutorial over vectoren en arrays, als je serieus aan de slag wilt met eigenvectoren en eigenwaarden en hun toepassingen in machine learning, probeer dan onze Machine Learning Scientist with Python career track en word expert in supervised en unsupervised learning, inclusief natuurlijk dimensionaliteitsreductie.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

