理解概率分布是数据科学的基础,在众多分布中,指数分布以其独特特性值得深入探究。虽然它在数学上与泊松分布有关联,但指数分布的独特之处在于它刻画的是事件之间的时间间隔,而非事件的计数。
若您刚接触概率概念,我们的课程Foundations of Probability in Python可提供必要的背景知识。指数分布在诸多领域都有实践应用,从可靠性工程到排队论,尤其在生存分析等方向大有用武之地——相关内容可在Survival Analysis in Python中深入学习。本指南将带您掌握指数分布的基本概念、数学基础与真实世界的应用,帮助您在数据科学项目中有效运用它。
什么是指数分布?
指数分布是一种连续型概率分布,用于刻画在事件以恒定平均速率、连续且相互独立地发生的过程中,事件之间的时间间隔。它特别适用于分析等待时间、寿命以及事件间隔等情形。
想象您在繁忙的客服中心工作,来电之间的时间往往符合指数分布。类似地,在制造业中,机器发生故障或需要维护之前的时间也常呈现指数分布的特征。
指数分布的关键特征
指数分布具有多项独特性质,使其在实际应用中尤为有用:
无记忆性
这或许是指数分布最具辨识度的特征。它意味着系统的未来行为与其过去历史无关。例如,若一个灯泡已经使用了1000小时,那么它再持续100小时的概率与一个全新灯泡相同。在连续分布中,这一性质是指数分布所独有的。
恒定风险率
指数分布在时间上保持恒定的失效率。这意味着在接下来一个很短的时间间隔内发生事件的概率保持不变,而不取决于已经过去了多长时间。
指数分布与泊松分布之间的关系是概率论中的基础。泊松分布用来建模在固定时间区间内发生的事件数量,而指数分布则用来建模这些事件之间的时间间隔。二者是一体两面:若事件按照参数为 λ 的泊松过程发生,那么事件之间的等待时间服从参数为 λ 的指数分布。
数学表述
指数分布由一个参数 λ(lambda)定义,该参数表示速率参数。其关键数学组成如下:
概率密度函数(PDF)
PDF 帮助我们计算事件在特定区间内发生的概率。指数分布的 PDF 如下:
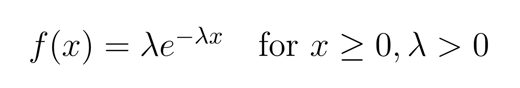
其中:
- x 为随机变量(通常表示时间)
- λ 为速率参数(λ > 0)
- e 为欧拉常数(约等于 2.71828)
累积分布函数(CDF)
当我们想要找到事件在某个时间之前发生的概率时,CDF 尤为有用。它给出等待时间小于或等于某一特定值的概率。指数分布的 CDF 如下:
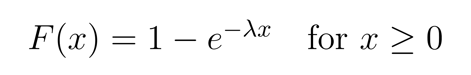
指数分布的应用
指数分布在多个领域发挥着重要作用,帮助我们建模和理解与时间相关的过程。下面探索几个关键应用。
可靠性工程
可靠性工程大量依赖指数分布来建模部件和系统的寿命,这尤其受益于其“无记忆”特性——部件的未来寿命只与当前状态有关,而与其已运行多长时间无关。
例如,电子元件的失效时间通常呈指数分布,体现了这一独特的无记忆性。这意味着在不考虑磨损效应的前提下,一块新的微处理器在下一小时内失效的概率,与已运行一个月的微处理器相同。服务器硬件制造商在可靠性分析中广泛使用该分布,以计算平均故障间隔时间(MTBF)、制定最优维护计划,并预测保修成本和更换需求。这些信息对产品开发和业务规划都极具价值。
排队论
在排队论中,指数分布是建模到达间隔时间或服务时间的基础工具,特别适用于以下场景:
1. 客服中心:
- 建模来电之间的时间
- 预测高峰负载时段
- 优化人员排班
2. 电信网络:
- 分析网络流量模式
- 建模数据网络中的分组到达时间
- 规划网络容量
3. 医疗系统:
- 建模急诊科患者的到达时间
- 估计服务等待时间
- 规划资源配置
指数分布在这些情境中表现良好,因为许多到达过程可近似视为以恒定平均速率发生、且无记忆的事件。
用指数分布计算概率
处理指数分布时,计算概率主要有两种方法:当需要求事件在特定区间或范围内发生的概率时,使用 PDF;而当要判断事件在某一时刻之前发生的概率时,使用 CDF。下面用一个服务台的实际场景来说明这两种方法。
使用概率密度函数
前文提到,PDF 用于计算事件在区间内发生的概率。对于指数这类连续分布,我们需要对感兴趣的区间对 PDF 进行积分。
来看一个实用示例:设客服服务台的来电到达服从指数分布,平均速率为每小时 3 个来电(λ = 3)。
要计算下一通电话需要等待 10 到 20 分钟的概率,我们将:
- 将时间换算为小时:(10 分钟 = 1/6 小时,20 分钟 = 1/3 小时)
- 使用公式:P(1/6 < X < 1/3) = ∫[1/6 to 1/3] 3e(-3x)dx
- 求值:= -e(-3x)|[1/6 to 1/3]
- 计算:= [e(-0.5) - e(-1)] ≈ 0.2325,约为 23.25%
使用累积分布函数
我们说过,当想要计算事件在某时刻之前发生的概率时,CDF 很有用。继续我们的服务台示例:在前 15 分钟内接到来电的概率是多少?
继续我们的服务台示例:在前 15 分钟内接到来电的概率是多少?
- 将 15 分钟换算为小时:(15 分钟 = 1/4 小时)
- 使用 CDF 公式:F(1/4) = 1 - e(-3*1/4)
- 计算:= 1 - e(-0.75) ≈ 0.5276,约为 52.76%
这意味着在前 15 分钟内接到电话的概率大约为 53%。可以看到,与使用 PDF 相比,CDF 使这类“至多多少时间内”的概率计算更为直观。
可视化指数分布
我们先单独看看指数分布,然后再与其他分布进行比较。
图形展示
以下是一组我用 Python 绘制的图:
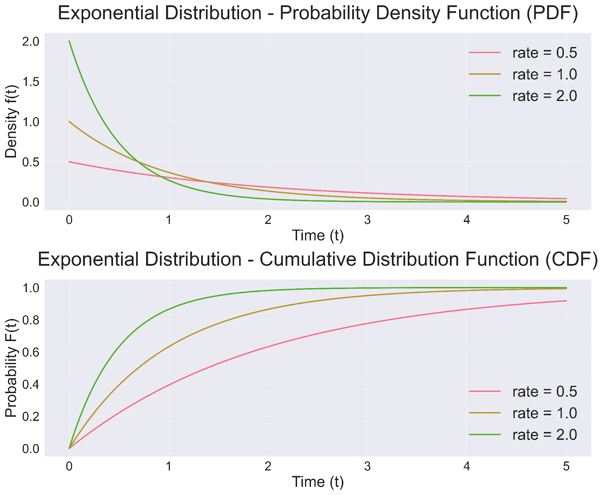
让我们看看数学公式如何转化为可视化模式。图中展示了三种不同的速率参数(0.5、1.0 和 2.0),以说明 λ 如何影响分布形状:
观察 PDF(上图):
- λ = 2.0(绿色线)时,初始下降最陡,且从 f(0) = 2.0 起步,表明早期发生事件的概率更高
- λ = 1.0(橙色线)时,得到更“标准”的指数分布,衰减更为温和
- λ = 0.5(红色线)时,曲线下降更缓慢,说明较长等待时间更常见
CDF(下图)则呈现互补的视角:
- 较高的速率(λ = 2.0)带来最陡的上升,表明累积概率增长更快
- 较低的速率(λ = 0.5)表现为更为渐进的概率累积
- 所有曲线最终都趋近于 1,说明随着时间增长,事件发生的概率趋近于必然
这种行为使指数分布特别适合建模等待时间、设备寿命以及泊松过程中的事件间隔等现实现象。
与其他分布的比较
将指数分布与其他常见概率分布进行比较,其独特性会更为清晰。我们通过如下可视化来考察:
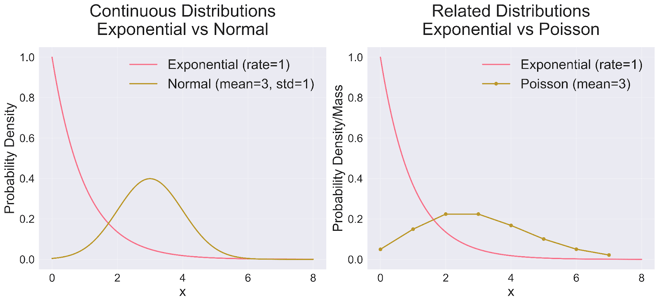
观察与正态分布的比较(左图),可以发现若干关键差异。指数分布具有明显的右偏,其峰值在起点即达到,随后持续下降;这与正态分布围绕均值对称的钟形曲线形成鲜明对比。二者虽同为连续分布,但建模目的不同:指数分布擅长刻画等待时间与间隔,正态分布则多用于测量值与平均值的波动。
与泊松分布的关系(右图)揭示了概率论的另一有趣层面。指数分布衡量事件之间的时间,而泊松分布关注在固定区间内的事件计数。二者是一体两面:在泊松过程中,等待时间自然服从指数分布。另一个显著区别在于连续性——指数分布可取任意正实数,而泊松分布仅处理离散的非负整数。
这些比较有助于理解指数分布为何在特定建模场景中表现出色。它在分析随机事件之间的时间间隔时极具价值,能力超越了泊松分布对事件计数的关注;在需要评估“立即发生”概率的场景中也尤为突出,这与正态分布强调集中趋势的特点形成对照。或许最与众不同的是,其独有的无记忆性使之区别于正态与泊松分布,成为那些“过去不影响未来概率”的过程的最优选择。
常见误解与陷阱
在使用指数分布时,一些常见误解可能导致错误分析。了解这些潜在陷阱有助于在真实场景中更准确地应用该分布。
对无记忆性的误读
无记忆性常引发混淆,因为它似乎与我们的日常经验相悖。以下是一些常见误解及其纠正:
一个常见误解是认为无记忆性意味着过去的事件对预测没有任何价值。实际上,它的含义是:无论您已经等待了多久,再多等一个时间段的概率保持不变。例如:
- 错误理解:“如果灯泡寿命服从指数分布,且 5 年没坏,那它很快就要坏了。”
- 正确理解:“如果灯泡寿命服从指数分布,且 5 年没坏,那么它再用一年不坏的概率与一只新灯泡用一年不坏的概率相同。”
另一种误解是以为所有可靠性场景都具有无记忆性。事实上,许多系统会表现出老化或磨损模式,不符合指数行为。比如,机械部件的失效率通常会随时间增加。
参数使用不当
在选择和应用速率参数时,常见错误包括:
-
混淆速率与均值:
-
单位不一致:
-
过度应用:
-
核实事件是否相互独立
-
核实速率是否在时间上保持恒定
-
核实过程是否不存在记忆效应
为避免上述错误,请始终明确定义并统一时间单位,验证指数分布假设是否适用于您的场景,在应用分布前检验数据是否呈现指数行为,并记录您的参数选择及其依据。
结论
指数分布以其简洁而有力的特性,成为数据科学家工具箱中不可或缺的一员。其独有的无记忆性,以及与其他分布(特别是高斯分布)之间的关系,凸显了它在概率论中的特殊地位。
尽管本指南已覆盖核心要点,但在专项应用中仍有更多可探索之处。若您对实践实现感兴趣,我们的课程Statistical Simulation in Python提供相关概念的动手体验。此外,理解指数分布与其他概率分布之间的联系(详见Multivariate Probability Distributions in R),有助于从更广阔的视角认识其在统计建模中的作用。无论您是在分析生存数据、建模系统可靠性,还是研究排队行为,掌握指数分布都将为数据分析与统计建模打开新的可能。


理解概率分布是数据科学的基础,在众多分布中,指数分布以其独特特性值得深入探究。虽然它在数学上与泊松分布有关联,但指数分布的独特之处在于它刻画的是事件之间的时间间隔,而非事件的计数。
若您刚接触概率概念,我们的课程Foundations of Probability in Python可提供必要的背景知识。指数分布在诸多领域都有实践应用,从可靠性工程到排队论,尤其在生存分析等方向大有用武之地——相关内容可在Survival Analysis in Python中深入学习。本指南将带您掌握指数分布的基本概念、数学基础与真实世界的应用,帮助您在数据科学项目中有效运用它。
什么是指数分布?
指数分布是一种连续型概率分布,用于刻画在事件以恒定平均速率、连续且相互独立地发生的过程中,事件之间的时间间隔。它特别适用于分析等待时间、寿命以及事件间隔等情形。
想象您在繁忙的客服中心工作,来电之间的时间往往符合指数分布。类似地,在制造业中,机器发生故障或需要维护之前的时间也常呈现指数分布的特征。
指数分布的关键特征
指数分布具有多项独特性质,使其在实际应用中尤为有用:
无记忆性
这或许是指数分布最具辨识度的特征。它意味着系统的未来行为与其过去历史无关。例如,若一个灯泡已经使用了1000小时,那么它再持续100小时的概率与一个全新灯泡相同。在连续分布中,这一性质是指数分布所独有的。
恒定风险率
指数分布在时间上保持恒定的失效率。这意味着在接下来一个很短的时间间隔内发生事件的概率保持不变,而不取决于已经过去了多长时间。
指数分布与泊松分布之间的关系是概率论中的基础。泊松分布用来建模在固定时间区间内发生的事件数量,而指数分布则用来建模这些事件之间的时间间隔。二者是一体两面:若事件按照参数为 λ 的泊松过程发生,那么事件之间的等待时间服从参数为 λ 的指数分布。
数学表述
指数分布由一个参数 λ(lambda)定义,该参数表示速率参数。其关键数学组成如下:
概率密度函数(PDF)
PDF 帮助我们计算事件在特定区间内发生的概率。指数分布的 PDF 如下:
其中:
累积分布函数(CDF)
当我们想要找到事件在某个时间之前发生的概率时,CDF 尤为有用。它给出等待时间小于或等于某一特定值的概率。指数分布的 CDF 如下:
指数分布的应用
指数分布在多个领域发挥着重要作用,帮助我们建模和理解与时间相关的过程。下面探索几个关键应用。
可靠性工程
可靠性工程大量依赖指数分布来建模部件和系统的寿命,这尤其受益于其“无记忆”特性——部件的未来寿命只与当前状态有关,而与其已运行多长时间无关。
例如,电子元件的失效时间通常呈指数分布,体现了这一独特的无记忆性。这意味着在不考虑磨损效应的前提下,一块新的微处理器在下一小时内失效的概率,与已运行一个月的微处理器相同。服务器硬件制造商在可靠性分析中广泛使用该分布,以计算平均故障间隔时间(MTBF)、制定最优维护计划,并预测保修成本和更换需求。这些信息对产品开发和业务规划都极具价值。
排队论
在排队论中,指数分布是建模到达间隔时间或服务时间的基础工具,特别适用于以下场景:
1. 客服中心:
2. 电信网络:
3. 医疗系统:
指数分布在这些情境中表现良好,因为许多到达过程可近似视为以恒定平均速率发生、且无记忆的事件。
用指数分布计算概率
处理指数分布时,计算概率主要有两种方法:当需要求事件在特定区间或范围内发生的概率时,使用 PDF;而当要判断事件在某一时刻之前发生的概率时,使用 CDF。下面用一个服务台的实际场景来说明这两种方法。
使用概率密度函数
前文提到,PDF 用于计算事件在区间内发生的概率。对于指数这类连续分布,我们需要对感兴趣的区间对 PDF 进行积分。
来看一个实用示例:设客服服务台的来电到达服从指数分布,平均速率为每小时 3 个来电(λ = 3)。
要计算下一通电话需要等待 10 到 20 分钟的概率,我们将:
使用累积分布函数
我们说过,当想要计算事件在某时刻之前发生的概率时,CDF 很有用。继续我们的服务台示例:在前 15 分钟内接到来电的概率是多少?
继续我们的服务台示例:在前 15 分钟内接到来电的概率是多少?
这意味着在前 15 分钟内接到电话的概率大约为 53%。可以看到,与使用 PDF 相比,CDF 使这类“至多多少时间内”的概率计算更为直观。
可视化指数分布
我们先单独看看指数分布,然后再与其他分布进行比较。
图形展示
以下是一组我用 Python 绘制的图:
让我们看看数学公式如何转化为可视化模式。图中展示了三种不同的速率参数(0.5、1.0 和 2.0),以说明 λ 如何影响分布形状:
观察 PDF(上图):
CDF(下图)则呈现互补的视角:
这种行为使指数分布特别适合建模等待时间、设备寿命以及泊松过程中的事件间隔等现实现象。
与其他分布的比较
将指数分布与其他常见概率分布进行比较,其独特性会更为清晰。我们通过如下可视化来考察:
观察与正态分布的比较(左图),可以发现若干关键差异。指数分布具有明显的右偏,其峰值在起点即达到,随后持续下降;这与正态分布围绕均值对称的钟形曲线形成鲜明对比。二者虽同为连续分布,但建模目的不同:指数分布擅长刻画等待时间与间隔,正态分布则多用于测量值与平均值的波动。
与泊松分布的关系(右图)揭示了概率论的另一有趣层面。指数分布衡量事件之间的时间,而泊松分布关注在固定区间内的事件计数。二者是一体两面:在泊松过程中,等待时间自然服从指数分布。另一个显著区别在于连续性——指数分布可取任意正实数,而泊松分布仅处理离散的非负整数。
这些比较有助于理解指数分布为何在特定建模场景中表现出色。它在分析随机事件之间的时间间隔时极具价值,能力超越了泊松分布对事件计数的关注;在需要评估“立即发生”概率的场景中也尤为突出,这与正态分布强调集中趋势的特点形成对照。或许最与众不同的是,其独有的无记忆性使之区别于正态与泊松分布,成为那些“过去不影响未来概率”的过程的最优选择。
常见误解与陷阱
在使用指数分布时,一些常见误解可能导致错误分析。了解这些潜在陷阱有助于在真实场景中更准确地应用该分布。
对无记忆性的误读
无记忆性常引发混淆,因为它似乎与我们的日常经验相悖。以下是一些常见误解及其纠正:
一个常见误解是认为无记忆性意味着过去的事件对预测没有任何价值。实际上,它的含义是:无论您已经等待了多久,再多等一个时间段的概率保持不变。例如:
另一种误解是以为所有可靠性场景都具有无记忆性。事实上,许多系统会表现出老化或磨损模式,不符合指数行为。比如,机械部件的失效率通常会随时间增加。
参数使用不当
在选择和应用速率参数时,常见错误包括:
混淆速率与均值:
常见错误是把均值当作速率参数(λ)来用
请记住:期望值(均值)为 1/λ
例如,若平均每 2 小时发生一次事件,则 λ = 1/2,而非 2
单位不一致:
速率参数必须与数据的时间单位保持一致
如果以小时计时,却用以天(-1)为单位的 λ,计算得到的概率将是错误的
在应用分布前务必统一单位
过度应用:
核实事件是否相互独立
核实速率是否在时间上保持恒定
核实过程是否不存在记忆效应
为避免上述错误,请始终明确定义并统一时间单位,验证指数分布假设是否适用于您的场景,在应用分布前检验数据是否呈现指数行为,并记录您的参数选择及其依据。
结论
指数分布以其简洁而有力的特性,成为数据科学家工具箱中不可或缺的一员。其独有的无记忆性,以及与其他分布(特别是高斯分布)之间的关系,凸显了它在概率论中的特殊地位。
尽管本指南已覆盖核心要点,但在专项应用中仍有更多可探索之处。若您对实践实现感兴趣,我们的课程Statistical Simulation in Python提供相关概念的动手体验。此外,理解指数分布与其他概率分布之间的联系(详见Multivariate Probability Distributions in R),有助于从更广阔的视角认识其在统计建模中的作用。无论您是在分析生存数据、建模系统可靠性,还是研究排队行为,掌握指数分布都将为数据分析与统计建模打开新的可能。