Inzicht in kansverdelingen is essentieel voor data science, en binnen dat onderwerp springt de exponentiële verdeling eruit door een paar unieke eigenschappen die het verkennen waard zijn. Hoewel er wiskundige verbanden zijn met de Poisson-verdeling, modelleert de exponentiële verdeling op unieke wijze de tijdsintervallen tussen gebeurtenissen in plaats van het aantal gebeurtenissen.
Voor wie nieuw is met kansbegrippen biedt onze cursus Foundations of Probability in Python de essentiële basiskennis. De praktische toepassingen van de exponentiële verdeling strekken zich uit over verschillende domeinen, van betrouwbaarheidstechniek tot wachtrijtheorie, en zijn bijzonder waardevol in vakgebieden zoals survivalanalyse, die uitgebreid aan bod komt in Survival Analysis in Python. Deze gids verkent de basisconcepten, wiskundige fundamenten en realistische toepassingen van de exponentiële verdeling, zodat je deze effectief kunt inzetten in je datascienceprojecten.
Wat is de exponentiële verdeling?
De exponentiële verdeling is een continue kansverdeling die de tijd tussen gebeurtenissen modelleert in een proces waarin gebeurtenissen continu en onafhankelijk plaatsvinden met een constante gemiddelde snelheid. Ze is vooral nuttig voor het analyseren van situaties met wachttijden, levensduren en intervallen tussen gebeurtenissen.
Stel je voor dat je werkt op een drukke klantenservice. De tijd tussen binnenkomende telefoontjes volgt vaak een exponentiële verdeling. In de productie vertoont de tijd tot een machine uitvalt of onderhoud nodig heeft vaak ook exponentieel gedrag.
Belangrijkste kenmerken van de exponentiële verdeling
De exponentiële verdeling heeft een aantal unieke eigenschappen die haar bijzonder nuttig maken in praktijksituaties:
De geheugenloze eigenschap
Dit is wellicht het meest onderscheidende kenmerk van de exponentiële verdeling. Het betekent dat het toekomstige gedrag van het systeem niet afhangt van zijn verleden. Bijvoorbeeld: als een gloeilamp al 1000 uur meegaat, is de kans dat hij nog 100 uur meegaat dezelfde als bij een gloednieuwe lamp. Deze eigenschap is uniek voor de exponentiële verdeling onder de continue verdelingen.
Constante hazard rate
De exponentiële verdeling behoudt een constant faalrisico in de tijd. Dat betekent dat de kans dat een gebeurtenis in het volgende kleine tijdsinterval plaatsvindt hetzelfde blijft, ongeacht hoeveel tijd al verstreken is.
De relatie tussen de exponentiële en Poisson-verdelingen is fundamenteel in de kansrekening. Terwijl de Poisson-verdeling het aantal gebeurtenissen in een vast tijdsinterval modelleert, modelleert de exponentiële verdeling de tijd tussen deze gebeurtenissen. Het zijn twee kanten van dezelfde medaille: als gebeurtenissen volgens een Poisson-proces met parameter λ plaatsvinden, volgt de wachttijd tussen gebeurtenissen een exponentiële verdeling met parameter λ.
De exponentiële verdeling wordt gedefinieerd door één parameter λ (lambda), die de snelheidsparameter weergeeft. Laten we de belangrijkste wiskundige componenten bekijken:
Probability density function (PDF)
De PDF helpt ons de kans te berekenen dat een gebeurtenis binnen een specifiek interval plaatsvindt. De PDF voor de exponentiële verdeling is als volgt:
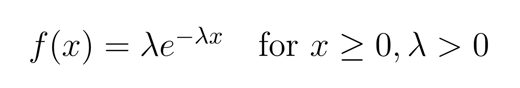
waarbij:
- x de toevalsvariabele is (meestal tijd)
- λ de snelheidsparameter is (λ > 0)
- e het getal van Euler is (ongeveer 2,71828)
Cumulatieve verdelingsfunctie (CDF)
De CDF is vooral handig wanneer we de kans willen vinden dat een gebeurtenis vóór een bepaalde tijd plaatsvindt. Ze geeft de kans dat de wachttijd kleiner dan of gelijk aan een specifieke waarde is. Hier is de CDF voor de exponentiële verdeling:
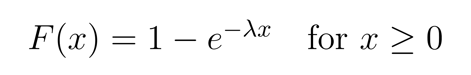
Toepassingen van de exponentiële verdeling
De exponentiële verdeling speelt een cruciale rol in diverse vakgebieden en helpt ons tijdsafhankelijke processen te modelleren en begrijpen. Laten we enkele belangrijke toepassingen bekijken.
Betrouwbaarheidstechniek
Betrouwbaarheidstechniek leunt sterk op de exponentiële verdeling om de levensduur van componenten en systemen te modelleren. Dit is vooral nuttig vanwege de "geheugenloze" eigenschap van de verdeling: de toekomstige levensduur van een component hangt alleen af van het heden, niet van hoe lang hij al draait.
Zo vertonen elektronische componenten doorgaans exponentieel verdeelde faaltijden, wat de unieke geheugenloze eigenschap van deze verdeling illustreert. Dit betekent dat een nieuwe microprocessor dezelfde kans heeft om in het komende uur te falen als een exemplaar dat al een maand draait (uitgaande van geen slijtage-effecten). Fabrikanten van serverhardware gebruiken deze verdeling uitgebreid in hun betrouwbaarheidsanalyses om de Mean Time Between Failures (MTBF) te berekenen, optimale onderhoudsschema's te bepalen en garantiekosten en vervangingsbehoeften te voorspellen. Deze informatie is waardevol voor zowel productontwikkeling als bedrijfsplanning.
Wachtrijtheorie
In de wachtrijtheorie is de exponentiële verdeling fundamenteel voor het modelleren van de tijd tussen aankomsten of servicetijden in veel systemen. Deze toepassing is vooral nuttig in:
1. Klantenservicecentra:
- Het modelleren van de tijd tussen inkomende oproepen
- Piekbelasting voorspellen
- Personeelsroosters optimaliseren
2. Telecommunicatie:
- Netwerkverkeerspatronen analyseren
- Aankomsttijden van pakketten in datanetwerken modelleren
- Netwerkkapaciteit plannen
3. Zorgsystemen:
- Aankomsttijden van patiënten op de spoedeisende hulp modelleren
- Wachttijden voor diensten schatten
- Resource-allocatie plannen
De exponentiële verdeling werkt goed in deze contexten omdat veel aankomstprocessen benaderd kunnen worden als geheugenloze gebeurtenissen die met een constante gemiddelde snelheid plaatsvinden.
Kansen berekenen met de exponentiële verdeling
Bij de exponentiële verdeling hebben we twee hoofdbenaderingen om kansen te berekenen: de PDF is vooral nuttig wanneer we de kans willen vinden dat een gebeurtenis binnen een specifiek interval of bereik plaatsvindt, terwijl de CDF helpt bepalen wat de kans is dat iets vóór een bepaald tijdstip gebeurt. Laten we beide benaderingen verkennen met een praktisch helpdeskscenario.
De probability density function gebruiken
We noemden dat de PDF helpt om de kans te berekenen dat een gebeurtenis binnen een interval plaatsvindt. Voor continue verdelingen zoals de exponentiële moeten we de PDF integreren over het relevante interval.
Laten we een praktisch voorbeeld uitwerken: Stel dat we klantenservicegesprekken analyseren bij een helpdesk waar oproepen binnenkomen volgens een exponentiële verdeling met een gemiddelde snelheid van 3 oproepen per uur (λ = 3).
Om de kans te vinden op een wachttijd tussen 10 en 20 minuten voor de volgende oproep, doen we het volgende:
- Zet tijd om naar uren: (10 minuten = 1/6 uur, 20 minuten = 1/3 uur)
- Gebruik de formule: P(1/6 < X < 1/3) = ∫[1/6 tot 1/3] 3e(-3x)dx
- Evalueer: = -e(-3x)|[1/6 tot 1/3]
- Bereken: = [e(-0,5) - e(-1)] ≈ 0,2325 of ongeveer 23,25%
De cumulatieve verdelingsfunctie gebruiken
We zeiden dat de CDF handig is wanneer we de kans willen vinden vóór een bepaalde tijd. Nu, in ons helpdeskvoorbeeld: wat is de kans dat we binnen de eerste 15 minuten een oproep ontvangen?
In ons helpdeskvoorbeeld: wat is de kans dat we binnen de eerste 15 minuten een oproep ontvangen?
- Zet 15 minuten om naar uren: (15 minuten = 1/4 uur)
- Gebruik de CDF-formule: F(1/4) = 1 - e(-3*1/4)
- Bereken: = 1 - e(-0,75) ≈ 0,5276 of ongeveer 52,76%
Dit betekent dat er grofweg 53% kans is op een oproep binnen de eerste 15 minuten. Merk op hoe de CDF dit soort "tot en met"-kansberekeningen eenvoudiger maakt dan via de PDF.
De exponentiële verdeling visualiseren
Laten we eerst naar de exponentiële verdeling zelf kijken en die daarna vergelijken met andere verdelingen.
Grafische weergave
Hier is een set grafieken die ik in Python heb gemaakt:
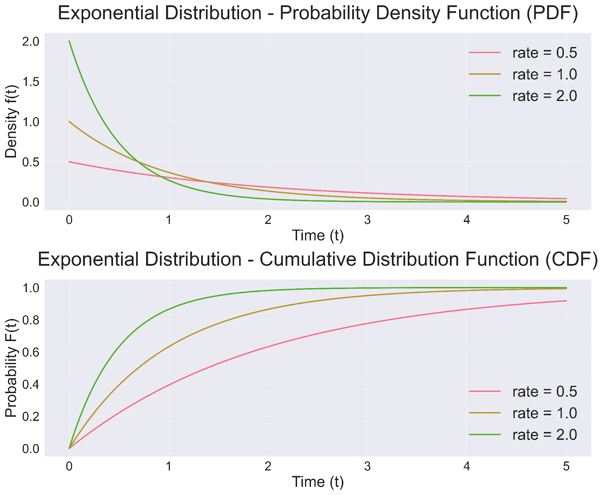
Laten we bekijken hoe de wiskundige formules zich vertalen naar visuele patronen. De visualisatie toont drie verschillende snelheidsparameters (0,5, 1,0 en 2,0) om te laten zien hoe λ de verdeling vormt:
Kijkend naar de PDF (bovenste grafiek):
- Wanneer λ = 2,0 (groene lijn), zien we de steilste initiële daling, beginnend bij f(0) = 2,0. Dit geeft aan dat vroege gebeurtenissen veel waarschijnlijker zijn
- Wanneer λ = 1,0 (oranje lijn), krijgen we de standaard exponentiële verdeling met een gematigder afname
- Wanneer λ = 0,5 (rode lijn), daalt de curve geleidelijker, wat laat zien dat langere wachttijden vaker voorkomen
De CDF (onderste grafiek) vertelt een aanvullend verhaal:
- De hogere snelheid (λ = 2,0) resulteert in de steilste stijging, wat aangeeft dat de cumulatieve kans snel toeneemt
- De lagere snelheid (λ = 0,5) toont een geleidelijkere toename van de kans
- Alle curves naderen uiteindelijk 1, wat illustreert dat de kans op het optreden van de gebeurtenis de zekerheid benadert naarmate de tijd toeneemt
Dit gedrag maakt de exponentiële verdeling bijzonder geschikt voor het modelleren van verschijnselen zoals wachttijden, levensduur van apparatuur en de tijd tussen gebeurtenissen in een Poisson-proces.
Vergelijken met andere verdelingen
De unieke kenmerken van de exponentiële verdeling worden duidelijker wanneer je ze vergelijkt met andere veelvoorkomende kansverdelingen. Laten we deze vergelijkingen bekijken aan de hand van onze visualisatie:
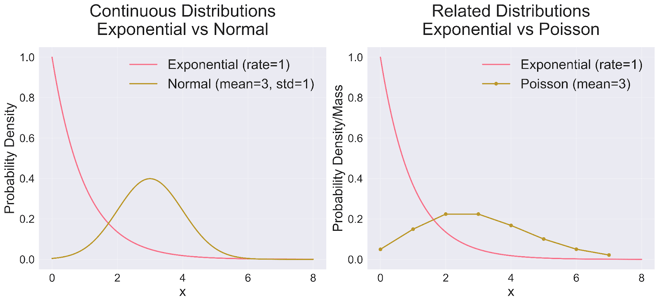
Bij de vergelijking met de normale verdeling (linkerpaneel) vallen een paar belangrijke verschillen op. De exponentiële verdeling is duidelijk rechts-scheef, bereikt meteen haar piek en daalt daarna continu. Dat steekt scherp af tegen de bekende symmetrische, klokvormige curve van de normale verdeling, gecentreerd rond het gemiddelde. Hoewel beide continue verdelingen zijn, dienen ze verschillende modelleringsdoelen: de exponentiële verdeling blinkt uit in het modelleren van wachttijden en intervallen, terwijl de normale verdeling doorgaans metingen en gemiddelden beschrijft.
De relatie met de Poisson-verdeling (rechterpaneel) onthult een andere fascinerende dimensie van de kansrekening. Waar de exponentiële verdeling de tijd tussen gebeurtenissen meet, richt de Poisson-verdeling zich op het tellen van het aantal gebeurtenissen binnen een vast interval. Deze verdelingen vormen twee kanten van dezelfde medaille: in een Poisson-proces volgen de wachttijden vanzelf een exponentiële verdeling. Een ander opvallend verschil zit in hun continuïteit: de exponentiële verdeling kan elke positieve reële waarde aannemen, terwijl de Poisson-verdeling uitsluitend met discrete, niet-negatieve gehele getallen werkt.
Deze vergelijkende inzichten laten zien waarom de exponentiële verdeling uitblinkt in specifieke modelleringsscenario's. Ze is van onschatbare waarde bij het analyseren van tijdsintervallen tussen willekeurige gebeurtenissen en biedt mogelijkheden voorbij de gebeurtenis-telling van de Poisson-verdeling. De verdeling komt vooral tot zijn recht in scenario's waarin je de kans op een onmiddellijke gebeurtenis wilt inschatten, in contrast met de focus van de normale verdeling op centrale tendens. Misschien wel het meest onderscheidend: de unieke geheugenloze eigenschap zet haar af tegen zowel de normale als de Poisson-verdeling, waardoor ze de optimale keuze is voor processen waarin gebeurtenissen uit het verleden de toekomstige kansen niet beïnvloeden.
Veelvoorkomende misvattingen en valkuilen
Bij het werken met de exponentiële verdeling kunnen verschillende veelvoorkomende misvattingen tot onjuiste analyses leiden. Door deze potentiële valkuilen te begrijpen, pas je de verdeling nauwkeuriger toe in realistische situaties.
De geheugenloze eigenschap verkeerd interpreteren
De geheugenloze eigenschap zorgt vaak voor verwarring omdat ze in tegenspraak lijkt met onze alledaagse ervaring. Hier zijn veelvoorkomende misverstanden en de correcties daarop:
Een veelvoorkomende misvatting is denken dat de geheugenloze eigenschap betekent dat gebeurtenissen uit het verleden geen waarde hebben voor voorspellingen. In werkelijkheid betekent het dat de kans op nog een extra tijdsperiode wachten hetzelfde blijft, ongeacht hoe lang je al gewacht hebt. Bijvoorbeeld:
- Onjuiste interpretatie: "Als een gloeilamp een exponentiële verdeling volgt en 5 jaar niet is uitgevallen, dan zal hij binnenkort wel uitvallen."
- Juiste interpretatie: "Als een gloeilamp een exponentiële verdeling volgt en 5 jaar niet is uitgevallen, is de kans dat hij nog een jaar meegaat hetzelfde als voor een nieuwe lamp die een jaar meegaat."
Een andere misvatting is aannemen dat alle betrouwbaarheidsscenario's de geheugenloze eigenschap vertonen. In werkelijkheid vertonen veel systemen verouderings- of slijtagepatronen die niet exponentieel zijn. Mechanische componenten hebben bijvoorbeeld vaak stijgende faalpercentages in de tijd.
Onjuist gebruik van parameters
Bij het kiezen en toepassen van de snelheidsparameter treden regelmatig fouten op:
-
Verwarring tussen snelheid en gemiddelde:
-
Een veelgemaakte fout is het gemiddelde gebruiken als snelheidsparameter (λ)
-
Onthoud: het gemiddelde (verwachtingswaarde) is juist 1/λ
-
Als gebeurtenissen bijvoorbeeld gemiddeld elke 2 uur optreden, is λ = 1/2, niet 2
-
Eenheden die niet overeenkomen:
-
De snelheidsparameter moet consistent zijn met de tijdseenheden in je data
-
Als je tijd in uren meet maar λ specificeert in dagen(-1), kloppen je kansen niet
-
Zorg altijd eerst voor consistente eenheden voordat je de verdeling toepast
-
Overtoepassing:
-
Verifieer dat gebeurtenissen onafhankelijk optreden
-
Dat de snelheid in de tijd constant blijft
-
En dat het proces geen geheugeneffecten heeft
Om deze fouten te vermijden: definieer je eenheden duidelijk en zet ze consistent om, verifieer dat de aannames van de exponentiële verdeling op je scenario van toepassing zijn, test je data op exponentieel gedrag voordat je de verdeling toepast, en documenteer je parameterkeuzes en de onderbouwing daarvan.
Conclusie
De elegante eenvoud en krachtige toepassingen van de exponentiële verdeling maken haar onmisbaar in de toolkit van een data scientist. De unieke geheugenloze eigenschap en de relatie met andere verdelingen, met name de Gaussische verdeling, onderstrepen haar bijzondere plek binnen de kansrekening.
Hoewel deze gids de essentiële aspecten heeft behandeld, valt er altijd meer te ontdekken in gespecialiseerde toepassingen. Voor wie geïnteresseerd is in praktische implementaties biedt onze cursus Statistical Simulation in Python hands-on ervaring met deze concepten. Daarnaast geeft inzicht in hoe de exponentiële verdeling zich verhoudt tot andere kansverdelingen, zoals behandeld in Multivariate Probability Distributions in R, een breder perspectief op haar rol in statistische modellering. Of je nu survivaldata analyseert, systeembetrouwbaarheid modelleert of wachtrijgedrag bestudeert: het beheersen van de exponentiële verdeling opent nieuwe mogelijkheden in data-analyse en statistische modellering.




Inzicht in kansverdelingen is essentieel voor data science, en binnen dat onderwerp springt de exponentiële verdeling eruit door een paar unieke eigenschappen die het verkennen waard zijn. Hoewel er wiskundige verbanden zijn met de Poisson-verdeling, modelleert de exponentiële verdeling op unieke wijze de tijdsintervallen tussen gebeurtenissen in plaats van het aantal gebeurtenissen.
Voor wie nieuw is met kansbegrippen biedt onze cursus Foundations of Probability in Python de essentiële basiskennis. De praktische toepassingen van de exponentiële verdeling strekken zich uit over verschillende domeinen, van betrouwbaarheidstechniek tot wachtrijtheorie, en zijn bijzonder waardevol in vakgebieden zoals survivalanalyse, die uitgebreid aan bod komt in Survival Analysis in Python. Deze gids verkent de basisconcepten, wiskundige fundamenten en realistische toepassingen van de exponentiële verdeling, zodat je deze effectief kunt inzetten in je datascienceprojecten.
Wat is de exponentiële verdeling?
De exponentiële verdeling is een continue kansverdeling die de tijd tussen gebeurtenissen modelleert in een proces waarin gebeurtenissen continu en onafhankelijk plaatsvinden met een constante gemiddelde snelheid. Ze is vooral nuttig voor het analyseren van situaties met wachttijden, levensduren en intervallen tussen gebeurtenissen.
Stel je voor dat je werkt op een drukke klantenservice. De tijd tussen binnenkomende telefoontjes volgt vaak een exponentiële verdeling. In de productie vertoont de tijd tot een machine uitvalt of onderhoud nodig heeft vaak ook exponentieel gedrag.
Belangrijkste kenmerken van de exponentiële verdeling
De exponentiële verdeling heeft een aantal unieke eigenschappen die haar bijzonder nuttig maken in praktijksituaties:
De geheugenloze eigenschap
Dit is wellicht het meest onderscheidende kenmerk van de exponentiële verdeling. Het betekent dat het toekomstige gedrag van het systeem niet afhangt van zijn verleden. Bijvoorbeeld: als een gloeilamp al 1000 uur meegaat, is de kans dat hij nog 100 uur meegaat dezelfde als bij een gloednieuwe lamp. Deze eigenschap is uniek voor de exponentiële verdeling onder de continue verdelingen.
Constante hazard rate
De exponentiële verdeling behoudt een constant faalrisico in de tijd. Dat betekent dat de kans dat een gebeurtenis in het volgende kleine tijdsinterval plaatsvindt hetzelfde blijft, ongeacht hoeveel tijd al verstreken is.
De relatie tussen de exponentiële en Poisson-verdelingen is fundamenteel in de kansrekening. Terwijl de Poisson-verdeling het aantal gebeurtenissen in een vast tijdsinterval modelleert, modelleert de exponentiële verdeling de tijd tussen deze gebeurtenissen. Het zijn twee kanten van dezelfde medaille: als gebeurtenissen volgens een Poisson-proces met parameter λ plaatsvinden, volgt de wachttijd tussen gebeurtenissen een exponentiële verdeling met parameter λ.
Wiskundige formulering
De exponentiële verdeling wordt gedefinieerd door één parameter λ (lambda), die de snelheidsparameter weergeeft. Laten we de belangrijkste wiskundige componenten bekijken:
Probability density function (PDF)
De PDF helpt ons de kans te berekenen dat een gebeurtenis binnen een specifiek interval plaatsvindt. De PDF voor de exponentiële verdeling is als volgt:
waarbij:
Cumulatieve verdelingsfunctie (CDF)
De CDF is vooral handig wanneer we de kans willen vinden dat een gebeurtenis vóór een bepaalde tijd plaatsvindt. Ze geeft de kans dat de wachttijd kleiner dan of gelijk aan een specifieke waarde is. Hier is de CDF voor de exponentiële verdeling:
Toepassingen van de exponentiële verdeling
De exponentiële verdeling speelt een cruciale rol in diverse vakgebieden en helpt ons tijdsafhankelijke processen te modelleren en begrijpen. Laten we enkele belangrijke toepassingen bekijken.
Betrouwbaarheidstechniek
Betrouwbaarheidstechniek leunt sterk op de exponentiële verdeling om de levensduur van componenten en systemen te modelleren. Dit is vooral nuttig vanwege de "geheugenloze" eigenschap van de verdeling: de toekomstige levensduur van een component hangt alleen af van het heden, niet van hoe lang hij al draait.
Zo vertonen elektronische componenten doorgaans exponentieel verdeelde faaltijden, wat de unieke geheugenloze eigenschap van deze verdeling illustreert. Dit betekent dat een nieuwe microprocessor dezelfde kans heeft om in het komende uur te falen als een exemplaar dat al een maand draait (uitgaande van geen slijtage-effecten). Fabrikanten van serverhardware gebruiken deze verdeling uitgebreid in hun betrouwbaarheidsanalyses om de Mean Time Between Failures (MTBF) te berekenen, optimale onderhoudsschema's te bepalen en garantiekosten en vervangingsbehoeften te voorspellen. Deze informatie is waardevol voor zowel productontwikkeling als bedrijfsplanning.
Wachtrijtheorie
In de wachtrijtheorie is de exponentiële verdeling fundamenteel voor het modelleren van de tijd tussen aankomsten of servicetijden in veel systemen. Deze toepassing is vooral nuttig in:
1. Klantenservicecentra:
2. Telecommunicatie:
3. Zorgsystemen:
De exponentiële verdeling werkt goed in deze contexten omdat veel aankomstprocessen benaderd kunnen worden als geheugenloze gebeurtenissen die met een constante gemiddelde snelheid plaatsvinden.
Kansen berekenen met de exponentiële verdeling
Bij de exponentiële verdeling hebben we twee hoofdbenaderingen om kansen te berekenen: de PDF is vooral nuttig wanneer we de kans willen vinden dat een gebeurtenis binnen een specifiek interval of bereik plaatsvindt, terwijl de CDF helpt bepalen wat de kans is dat iets vóór een bepaald tijdstip gebeurt. Laten we beide benaderingen verkennen met een praktisch helpdeskscenario.
De probability density function gebruiken
We noemden dat de PDF helpt om de kans te berekenen dat een gebeurtenis binnen een interval plaatsvindt. Voor continue verdelingen zoals de exponentiële moeten we de PDF integreren over het relevante interval.
Laten we een praktisch voorbeeld uitwerken: Stel dat we klantenservicegesprekken analyseren bij een helpdesk waar oproepen binnenkomen volgens een exponentiële verdeling met een gemiddelde snelheid van 3 oproepen per uur (λ = 3).
Om de kans te vinden op een wachttijd tussen 10 en 20 minuten voor de volgende oproep, doen we het volgende:
De cumulatieve verdelingsfunctie gebruiken
We zeiden dat de CDF handig is wanneer we de kans willen vinden vóór een bepaalde tijd. Nu, in ons helpdeskvoorbeeld: wat is de kans dat we binnen de eerste 15 minuten een oproep ontvangen?
In ons helpdeskvoorbeeld: wat is de kans dat we binnen de eerste 15 minuten een oproep ontvangen?
Dit betekent dat er grofweg 53% kans is op een oproep binnen de eerste 15 minuten. Merk op hoe de CDF dit soort "tot en met"-kansberekeningen eenvoudiger maakt dan via de PDF.
De exponentiële verdeling visualiseren
Laten we eerst naar de exponentiële verdeling zelf kijken en die daarna vergelijken met andere verdelingen.
Grafische weergave
Hier is een set grafieken die ik in Python heb gemaakt:
Laten we bekijken hoe de wiskundige formules zich vertalen naar visuele patronen. De visualisatie toont drie verschillende snelheidsparameters (0,5, 1,0 en 2,0) om te laten zien hoe λ de verdeling vormt:
Kijkend naar de PDF (bovenste grafiek):
De CDF (onderste grafiek) vertelt een aanvullend verhaal:
Dit gedrag maakt de exponentiële verdeling bijzonder geschikt voor het modelleren van verschijnselen zoals wachttijden, levensduur van apparatuur en de tijd tussen gebeurtenissen in een Poisson-proces.
Vergelijken met andere verdelingen
De unieke kenmerken van de exponentiële verdeling worden duidelijker wanneer je ze vergelijkt met andere veelvoorkomende kansverdelingen. Laten we deze vergelijkingen bekijken aan de hand van onze visualisatie:
Bij de vergelijking met de normale verdeling (linkerpaneel) vallen een paar belangrijke verschillen op. De exponentiële verdeling is duidelijk rechts-scheef, bereikt meteen haar piek en daalt daarna continu. Dat steekt scherp af tegen de bekende symmetrische, klokvormige curve van de normale verdeling, gecentreerd rond het gemiddelde. Hoewel beide continue verdelingen zijn, dienen ze verschillende modelleringsdoelen: de exponentiële verdeling blinkt uit in het modelleren van wachttijden en intervallen, terwijl de normale verdeling doorgaans metingen en gemiddelden beschrijft.
De relatie met de Poisson-verdeling (rechterpaneel) onthult een andere fascinerende dimensie van de kansrekening. Waar de exponentiële verdeling de tijd tussen gebeurtenissen meet, richt de Poisson-verdeling zich op het tellen van het aantal gebeurtenissen binnen een vast interval. Deze verdelingen vormen twee kanten van dezelfde medaille: in een Poisson-proces volgen de wachttijden vanzelf een exponentiële verdeling. Een ander opvallend verschil zit in hun continuïteit: de exponentiële verdeling kan elke positieve reële waarde aannemen, terwijl de Poisson-verdeling uitsluitend met discrete, niet-negatieve gehele getallen werkt.
Deze vergelijkende inzichten laten zien waarom de exponentiële verdeling uitblinkt in specifieke modelleringsscenario's. Ze is van onschatbare waarde bij het analyseren van tijdsintervallen tussen willekeurige gebeurtenissen en biedt mogelijkheden voorbij de gebeurtenis-telling van de Poisson-verdeling. De verdeling komt vooral tot zijn recht in scenario's waarin je de kans op een onmiddellijke gebeurtenis wilt inschatten, in contrast met de focus van de normale verdeling op centrale tendens. Misschien wel het meest onderscheidend: de unieke geheugenloze eigenschap zet haar af tegen zowel de normale als de Poisson-verdeling, waardoor ze de optimale keuze is voor processen waarin gebeurtenissen uit het verleden de toekomstige kansen niet beïnvloeden.
Veelvoorkomende misvattingen en valkuilen
Bij het werken met de exponentiële verdeling kunnen verschillende veelvoorkomende misvattingen tot onjuiste analyses leiden. Door deze potentiële valkuilen te begrijpen, pas je de verdeling nauwkeuriger toe in realistische situaties.
De geheugenloze eigenschap verkeerd interpreteren
De geheugenloze eigenschap zorgt vaak voor verwarring omdat ze in tegenspraak lijkt met onze alledaagse ervaring. Hier zijn veelvoorkomende misverstanden en de correcties daarop:
Een veelvoorkomende misvatting is denken dat de geheugenloze eigenschap betekent dat gebeurtenissen uit het verleden geen waarde hebben voor voorspellingen. In werkelijkheid betekent het dat de kans op nog een extra tijdsperiode wachten hetzelfde blijft, ongeacht hoe lang je al gewacht hebt. Bijvoorbeeld:
Een andere misvatting is aannemen dat alle betrouwbaarheidsscenario's de geheugenloze eigenschap vertonen. In werkelijkheid vertonen veel systemen verouderings- of slijtagepatronen die niet exponentieel zijn. Mechanische componenten hebben bijvoorbeeld vaak stijgende faalpercentages in de tijd.
Onjuist gebruik van parameters
Bij het kiezen en toepassen van de snelheidsparameter treden regelmatig fouten op:
Verwarring tussen snelheid en gemiddelde:
Een veelgemaakte fout is het gemiddelde gebruiken als snelheidsparameter (λ)
Onthoud: het gemiddelde (verwachtingswaarde) is juist 1/λ
Als gebeurtenissen bijvoorbeeld gemiddeld elke 2 uur optreden, is λ = 1/2, niet 2
Eenheden die niet overeenkomen:
De snelheidsparameter moet consistent zijn met de tijdseenheden in je data
Als je tijd in uren meet maar λ specificeert in dagen(-1), kloppen je kansen niet
Zorg altijd eerst voor consistente eenheden voordat je de verdeling toepast
Overtoepassing:
Verifieer dat gebeurtenissen onafhankelijk optreden
Dat de snelheid in de tijd constant blijft
En dat het proces geen geheugeneffecten heeft
Om deze fouten te vermijden: definieer je eenheden duidelijk en zet ze consistent om, verifieer dat de aannames van de exponentiële verdeling op je scenario van toepassing zijn, test je data op exponentieel gedrag voordat je de verdeling toepast, en documenteer je parameterkeuzes en de onderbouwing daarvan.
Conclusie
De elegante eenvoud en krachtige toepassingen van de exponentiële verdeling maken haar onmisbaar in de toolkit van een data scientist. De unieke geheugenloze eigenschap en de relatie met andere verdelingen, met name de Gaussische verdeling, onderstrepen haar bijzondere plek binnen de kansrekening.
Hoewel deze gids de essentiële aspecten heeft behandeld, valt er altijd meer te ontdekken in gespecialiseerde toepassingen. Voor wie geïnteresseerd is in praktische implementaties biedt onze cursus Statistical Simulation in Python hands-on ervaring met deze concepten. Daarnaast geeft inzicht in hoe de exponentiële verdeling zich verhoudt tot andere kansverdelingen, zoals behandeld in Multivariate Probability Distributions in R, een breder perspectief op haar rol in statistische modellering. Of je nu survivaldata analyseert, systeembetrouwbaarheid modelleert of wachtrijgedrag bestudeert: het beheersen van de exponentiële verdeling opent nieuwe mogelijkheden in data-analyse en statistische modellering.