Hiểu các phân phối xác suất là nền tảng của khoa học dữ liệu, và trong số đó, tôi thấy phân phối mũ nổi bật với những đặc điểm độc đáo đáng để khám phá. Mặc dù có liên hệ toán học với phân phối Poisson, phân phối mũ lại mô hình hóa khoảng thời gian giữa các sự kiện thay vì số lượng sự kiện.
Với những ai mới làm quen khái niệm xác suất, khóa học Foundations of Probability in Python của chúng tôi cung cấp kiến thức nền thiết yếu. Ứng dụng thực tiễn của phân phối mũ trải rộng nhiều lĩnh vực, từ kỹ thuật độ tin cậy đến lý thuyết hàng đợi, đặc biệt hữu ích trong phân tích sống sót (survival analysis), được tìm hiểu chuyên sâu trong khóa Survival Analysis in Python. Hướng dẫn này sẽ trình bày các khái niệm cơ bản, nền tảng toán học và ứng dụng thực tế của phân phối mũ, giúp bạn trang bị kiến thức để áp dụng hiệu quả trong các dự án khoa học dữ liệu.
Phân phối Mũ là gì?
Phân phối mũ là một phân phối xác suất liên tục dùng để mô hình hóa thời gian giữa các sự kiện trong một quá trình mà các sự kiện xảy ra liên tục và độc lập với tốc độ trung bình không đổi. Nó đặc biệt hữu ích để phân tích các tình huống liên quan đến thời gian chờ đợi, tuổi thọ và khoảng cách giữa các sự kiện.
Hãy tưởng tượng bạn làm việc tại một trung tâm chăm sóc khách hàng bận rộn. Thời gian giữa các cuộc gọi đến thường tuân theo phân phối mũ. Tương tự, trong sản xuất, thời gian cho đến khi máy móc hỏng hoặc cần bảo dưỡng cũng thường có hành vi theo phân phối mũ.
Đặc điểm chính của phân phối mũ
Phân phối mũ có một số tính chất độc đáo khiến nó đặc biệt hữu dụng trong các ứng dụng thực tiễn:
Tính không nhớ (memoryless)
Đây có lẽ là đặc điểm nổi bật nhất của phân phối mũ. Nó có nghĩa là hành vi trong tương lai của hệ thống không phụ thuộc vào lịch sử quá khứ. Ví dụ, nếu một bóng đèn đã hoạt động được 1000 giờ, xác suất để nó hoạt động thêm 100 giờ nữa giống hệt như khi nó còn mới. Trong số các phân phối liên tục, chỉ có phân phối mũ có tính chất này.
Tốc độ nguy cơ (hazard rate) không đổi
Phân phối mũ duy trì tốc độ hỏng hóc không đổi theo thời gian. Điều này có nghĩa là xác suất xảy ra một sự kiện trong một khoảng thời gian nhỏ tiếp theo vẫn như cũ, bất kể đã trôi qua bao lâu.
Mối quan hệ giữa phân phối mũ và phân phối Poisson là nền tảng trong lý thuyết xác suất. Trong khi phân phối Poisson mô hình hóa số lượng sự kiện xảy ra trong một khoảng thời gian cố định, phân phối mũ mô hình hóa thời gian giữa các sự kiện đó. Chúng như hai mặt của cùng một đồng xu: nếu các sự kiện xảy ra theo một quá trình Poisson với tốc độ λ, thì thời gian chờ giữa các sự kiện tuân theo phân phối mũ với tham số λ.
Công thức toán học
Phân phối mũ được xác định bởi một tham số duy nhất λ (lambda), đại diện cho tham số tốc độ. Hãy xem các thành phần toán học chính của nó:
Hàm mật độ xác suất (PDF)
PDF giúp chúng ta tính xác suất một sự kiện xảy ra trong một khoảng cụ thể. PDF cho phân phối mũ như sau:
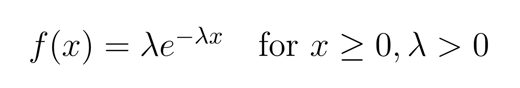
trong đó:
- x là biến ngẫu nhiên (thường biểu diễn thời gian)
- λ là tham số tốc độ (λ > 0)
- e là số Euler (xấp xỉ 2.71828)
Hàm phân phối tích lũy (CDF)
CDF đặc biệt hữu ích khi chúng ta muốn tìm xác suất một sự kiện xảy ra trước một thời điểm nhất định. Nó cho ta xác suất rằng thời gian chờ nhỏ hơn hoặc bằng một giá trị cụ thể. Dưới đây là CDF cho phân phối mũ:
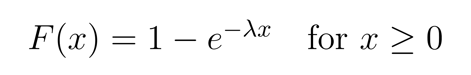
Ứng dụng của Phân phối Mũ
Phân phối mũ đóng vai trò quan trọng trong nhiều lĩnh vực, giúp chúng ta mô hình hóa và hiểu các quá trình phụ thuộc thời gian. Hãy cùng khám phá một số ứng dụng chính.
Kỹ thuật độ tin cậy
Kỹ thuật độ tin cậy dựa nhiều vào phân phối mũ để mô hình hóa tuổi thọ của linh kiện và hệ thống. Điều này đặc biệt hữu ích nhờ tính chất "không nhớ" của phân phối—tuổi thọ tương lai của một linh kiện chỉ phụ thuộc vào hiện tại, không phụ thuộc vào thời gian đã vận hành.
Ví dụ, các linh kiện điện tử thường có thời gian hỏng theo phân phối mũ, thể hiện tính không nhớ độc đáo của phân phối này. Điều đó có nghĩa là một vi xử lý mới có cùng xác suất hỏng trong giờ tiếp theo như một vi xử lý đã chạy một tháng (giả sử không có hiệu ứng hao mòn). Các nhà sản xuất phần cứng máy chủ sử dụng rộng rãi phân phối này trong phân tích độ tin cậy để tính Thời gian Trung bình Giữa Các Lần Hỏng (MTBF), xác định lịch bảo trì tối ưu, và dự đoán chi phí bảo hành cùng nhu cầu thay thế. Những thông tin này có giá trị cho cả phát triển sản phẩm và hoạch định kinh doanh.
Lý thuyết hàng đợi
Trong lý thuyết hàng đợi, phân phối mũ là nền tảng để mô hình hóa thời gian giữa các lượt đến hoặc thời gian phục vụ trong nhiều hệ thống. Ứng dụng này đặc biệt hữu ích trong:
1. Trung tâm Chăm sóc Khách hàng:
- Mô hình hóa thời gian giữa các cuộc gọi đến
- Dự đoán thời điểm tải cao điểm
- Tối ưu hóa lịch xếp ca nhân sự
2. Viễn thông:
- Phân tích mô hình lưu lượng mạng
- Mô hình hóa thời gian đến của gói tin trong mạng dữ liệu
- Lập kế hoạch dung lượng mạng
3. Hệ thống y tế:
- Mô hình hóa thời gian bệnh nhân đến khoa cấp cứu
- Ước tính thời gian chờ dịch vụ
- Lập kế hoạch phân bổ nguồn lực
Phân phối mũ hoạt động tốt trong các bối cảnh này vì nhiều quá trình đến có thể được xấp xỉ như các sự kiện không nhớ xảy ra với tốc độ trung bình không đổi.
Tính toán xác suất với Phân phối Mũ
Khi làm việc với phân phối mũ, chúng ta có hai cách chính để tính xác suất: PDF đặc biệt hữu ích khi cần tìm xác suất một sự kiện xảy ra trong một khoảng hoặc dải cụ thể, trong khi CDF giúp xác định xác suất sự kiện xảy ra trước một thời điểm nhất định. Hãy khám phá cả hai cách tiếp cận bằng một kịch bản bàn hỗ trợ (help desk) thực tế.
Sử dụng hàm mật độ xác suất
Chúng ta đã đề cập rằng PDF giúp tính xác suất sự kiện xảy ra trong một khoảng. Với các phân phối liên tục như phân phối mũ, ta cần tích phân PDF trên khoảng quan tâm.
Hãy cùng làm một ví dụ thực tế: Giả sử chúng ta phân tích các cuộc gọi dịch vụ khách hàng tại một bàn hỗ trợ, nơi các cuộc gọi đến theo phân phối mũ với tốc độ trung bình 3 cuộc mỗi giờ (λ = 3).
Để tìm xác suất phải chờ từ 10 đến 20 phút cho cuộc gọi tiếp theo, ta sẽ:
- Đổi thời gian sang giờ: (10 phút = 1/6 giờ, 20 phút = 1/3 giờ)
- Dùng công thức: P(1/6 < X < 1/3) = ∫[1/6 đến 1/3] 3e(-3x)dx
- Tính: = -e(-3x)|[1/6 đến 1/3]
- Kết quả: = [e(-0.5) - e(-1)] ≈ 0.2325, khoảng 23.25%
Sử dụng hàm phân phối tích lũy
Chúng ta đã nói rằng CDF hữu ích khi muốn tìm xác suất sự kiện xảy ra trước một thời điểm. Quay lại ví dụ bàn hỗ trợ: Xác suất nhận được cuộc gọi trong 15 phút đầu là bao nhiêu?
Quay lại ví dụ bàn hỗ trợ: Xác suất nhận được cuộc gọi trong 15 phút đầu là bao nhiêu?
- Đổi 15 phút sang giờ: (15 phút = 1/4 giờ)
- Dùng công thức CDF: F(1/4) = 1 - e(-3*1/4)
- Kết quả: = 1 - e(-0.75) ≈ 0.5276, khoảng 52.76%
Điều này có nghĩa là có khoảng 53% khả năng nhận được cuộc gọi trong 15 phút đầu. Hãy lưu ý cách CDF giúp các phép tính xác suất kiểu "đến thời điểm" này trở nên trực quan hơn so với dùng PDF.
Trực quan hóa Phân phối Mũ
Trước hết, hãy xem bản thân phân phối mũ rồi so sánh nó với các phân phối khác.
Biểu diễn đồ thị
Dưới đây là một tập đồ thị tôi tạo bằng Python:
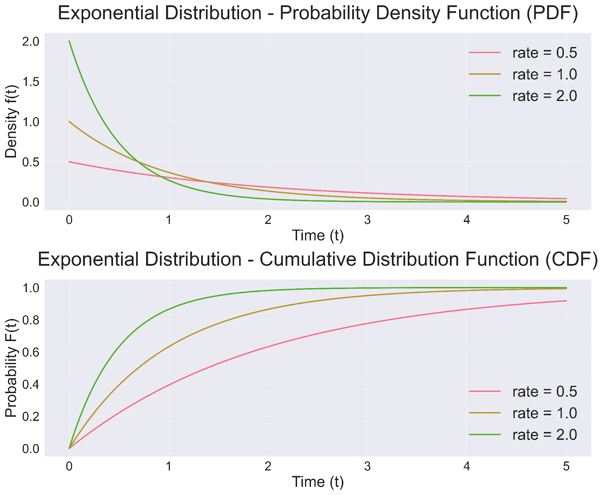
Hãy khám phá cách các công thức toán học chuyển thành các mẫu hình trực quan. Hình trực quan hiển thị ba tham số tốc độ khác nhau (0.5, 1.0 và 2.0) để minh họa cách λ định hình phân phối:
Quan sát PDF (đồ thị trên):
- Khi λ = 2.0 (đường màu xanh lá), ta thấy mức giảm ban đầu dốc nhất, bắt đầu tại f(0) = 2.0. Điều này cho thấy các sự kiện sớm có khả năng xảy ra cao hơn nhiều
- Khi λ = 1.0 (đường màu cam), ta có phân phối mũ tiêu chuẩn với mức suy giảm vừa phải hơn
- Khi λ = 0.5 (đường màu đỏ), đường cong giảm dần chậm hơn, cho thấy thời gian chờ lâu phổ biến hơn
CDF (đồ thị dưới) kể một câu chuyện bổ sung:
- Tốc độ cao hơn (λ = 2.0) dẫn đến độ dốc tăng nhanh nhất, cho thấy xác suất tích lũy tăng nhanh
- Tốc độ thấp hơn (λ = 0.5) cho thấy mức tích lũy xác suất từ tốn hơn
- Mọi đường cong cuối cùng tiến gần đến 1, minh họa rằng xác suất sự kiện xảy ra tiến đến chắc chắn khi thời gian tăng
Hành vi này khiến phân phối mũ đặc biệt hữu ích để mô hình hóa các hiện tượng thực tế như thời gian chờ đợi, tuổi thọ thiết bị và thời gian giữa các sự kiện trong một quá trình Poisson.
So sánh với các phân phối khác
Những đặc điểm độc đáo của phân phối mũ trở nên rõ ràng hơn khi so sánh với các phân phối xác suất phổ biến khác. Hãy xem các so sánh này qua hình trực quan của chúng ta:
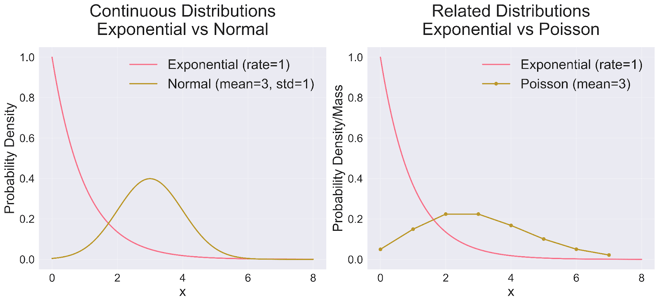
Khi quan sát so sánh với phân phối chuẩn (bảng bên trái), nổi bật một số khác biệt chính. Phân phối mũ có độ lệch phải rõ rệt, đạt giá trị cực đại ngay lập tức rồi giảm liên tục. Điều này tương phản mạnh với đường cong hình chuông đối xứng quen thuộc của phân phối chuẩn quanh giá trị trung bình. Dù cả hai đều là phân phối liên tục, chúng phục vụ mục đích mô hình khác nhau: phân phối mũ vượt trội trong mô hình hóa thời gian chờ và khoảng cách, trong khi phân phối chuẩn thường xử lý các phép đo và giá trị trung bình.
Mối quan hệ với phân phối Poisson (bảng bên phải) hé lộ một khía cạnh thú vị khác của lý thuyết xác suất. Nếu phân phối mũ đo thời gian giữa các sự kiện, thì phân phối Poisson tập trung vào đếm số sự kiện trong một khoảng thời gian cố định. Hai phân phối này là hai mặt của cùng một vấn đề: trong một quá trình Poisson, thời gian chờ tự nhiên tuân theo phân phối mũ. Một khác biệt đáng chú ý khác là tính liên tục—phân phối mũ có thể nhận mọi giá trị thực dương, còn phân phối Poisson chỉ xử lý các số nguyên rời rạc không âm.
Những hiểu biết so sánh này cho thấy vì sao phân phối mũ vượt trội trong các kịch bản mô hình cụ thể. Nó vô cùng hữu ích khi phân tích khoảng thời gian giữa các sự kiện ngẫu nhiên, cung cấp năng lực vượt ra ngoài trọng tâm đếm sự kiện của phân phối Poisson. Phân phối này đặc biệt nổi bật trong các tình huống đòi hỏi đánh giá xác suất xảy ra ngay lập tức, trái ngược với cách tiếp cận xu hướng trung tâm của phân phối chuẩn. Có lẽ khác biệt nhất là tính không nhớ độc đáo của nó, tách biệt khỏi cả phân phối Chuẩn và Poisson, khiến nó trở thành lựa chọn tối ưu cho các quá trình mà sự kiện trong quá khứ không ảnh hưởng đến xác suất tương lai.
Hiểu sai thường gặp và cạm bẫy
Khi làm việc với phân phối mũ, một số hiểu lầm phổ biến có thể dẫn đến phân tích sai. Hiểu các cạm bẫy tiềm ẩn này giúp đảm bảo áp dụng chính xác phân phối trong các tình huống thực tế.
Diễn giải sai tính không nhớ
Tính không nhớ thường gây nhầm lẫn vì dường như mâu thuẫn với kinh nghiệm hàng ngày của chúng ta. Dưới đây là những hiểu sai thường gặp và cách hiệu chỉnh:
Một hiểu lầm phổ biến là nghĩ rằng tính không nhớ có nghĩa các sự kiện trong quá khứ không có giá trị dự đoán. Trên thực tế, điều đó có nghĩa là xác suất phải chờ thêm một khoảng thời gian nữa vẫn như cũ, bất kể bạn đã chờ bao lâu. Ví dụ:
- Diễn giải sai: "Nếu bóng đèn tuân theo phân phối mũ và chưa hỏng trong 5 năm, chắc hẳn nó sắp hỏng."
- Diễn giải đúng: "Nếu bóng đèn tuân theo phân phối mũ và chưa hỏng trong 5 năm, xác suất để nó bền thêm một năm giống như một bóng đèn mới bền được một năm."
Một hiểu lầm khác là cho rằng mọi kịch bản độ tin cậy đều có tính không nhớ. Thực tế, nhiều hệ thống thể hiện hiệu ứng lão hóa hoặc hao mòn không tuân theo hành vi mũ. Chẳng hạn, các bộ phận cơ khí thường có tỷ lệ hỏng tăng theo thời gian.
Sử dụng tham số không chính xác
Một số lỗi phổ biến xảy ra khi chọn và áp dụng tham số tốc độ:
-
Nhầm lẫn giữa tốc độ và trung bình:
-
Lỗi thường gặp là dùng giá trị trung bình làm tham số tốc độ (λ)
-
Hãy nhớ: Giá trị trung bình (kỳ vọng) thực ra là 1/λ
-
Ví dụ, nếu các sự kiện xảy ra trung bình mỗi 2 giờ, λ = 1/2, không phải 2
-
Lệch đơn vị:
-
Tham số tốc độ phải nhất quán với đơn vị thời gian trong dữ liệu của bạn
-
Nếu bạn đo thời gian theo giờ nhưng lại chỉ định λ theo ngày(-1), các xác suất sẽ sai
-
Luôn quy đổi về đơn vị nhất quán trước khi áp dụng phân phối
-
Lạm dụng áp dụng:
-
Hãy xác minh rằng các sự kiện xảy ra độc lập
-
Rằng tốc độ vẫn không đổi theo thời gian
-
Và quá trình không có hiệu ứng nhớ
Để tránh các lỗi này, hãy luôn xác định rõ đơn vị và quy đổi nhất quán, xác minh rằng các giả định của phân phối mũ phù hợp với kịch bản của bạn, kiểm tra dữ liệu xem có hành vi mũ trước khi áp dụng phân phối, và ghi lại lựa chọn tham số cùng lý do của bạn.
Kết luận
Sự giản dị thanh thoát và khả năng ứng dụng mạnh mẽ khiến phân phối mũ trở thành công cụ không thể thiếu trong bộ dụng cụ của nhà khoa học dữ liệu. Tính không nhớ độc đáo và mối quan hệ với các phân phối khác, đặc biệt là phân phối Gaussian, nhấn mạnh vị trí đặc biệt của nó trong lý thuyết xác suất.
Mặc dù hướng dẫn này đã bao quát những khía cạnh thiết yếu, vẫn còn nhiều điều để khám phá trong các ứng dụng chuyên sâu. Với những ai quan tâm đến triển khai thực hành, khóa học Statistical Simulation in Python của chúng tôi mang đến trải nghiệm thực hành với các khái niệm này. Ngoài ra, hiểu cách phân phối mũ liên hệ với các phân phối xác suất khác, như được trình bày trong Multivariate Probability Distributions in R, cung cấp góc nhìn rộng hơn về vai trò của nó trong mô hình thống kê. Dù bạn đang phân tích dữ liệu sống sót, mô hình hóa độ tin cậy hệ thống hay nghiên cứu hành vi hàng đợi, thành thạo phân phối mũ sẽ mở ra những khả năng mới trong phân tích dữ liệu và mô hình hóa thống kê.


Hiểu các phân phối xác suất là nền tảng của khoa học dữ liệu, và trong số đó, tôi thấy phân phối mũ nổi bật với những đặc điểm độc đáo đáng để khám phá. Mặc dù có liên hệ toán học với phân phối Poisson, phân phối mũ lại mô hình hóa khoảng thời gian giữa các sự kiện thay vì số lượng sự kiện.
Với những ai mới làm quen khái niệm xác suất, khóa học Foundations of Probability in Python của chúng tôi cung cấp kiến thức nền thiết yếu. Ứng dụng thực tiễn của phân phối mũ trải rộng nhiều lĩnh vực, từ kỹ thuật độ tin cậy đến lý thuyết hàng đợi, đặc biệt hữu ích trong phân tích sống sót (survival analysis), được tìm hiểu chuyên sâu trong khóa Survival Analysis in Python. Hướng dẫn này sẽ trình bày các khái niệm cơ bản, nền tảng toán học và ứng dụng thực tế của phân phối mũ, giúp bạn trang bị kiến thức để áp dụng hiệu quả trong các dự án khoa học dữ liệu.
Phân phối Mũ là gì?
Phân phối mũ là một phân phối xác suất liên tục dùng để mô hình hóa thời gian giữa các sự kiện trong một quá trình mà các sự kiện xảy ra liên tục và độc lập với tốc độ trung bình không đổi. Nó đặc biệt hữu ích để phân tích các tình huống liên quan đến thời gian chờ đợi, tuổi thọ và khoảng cách giữa các sự kiện.
Hãy tưởng tượng bạn làm việc tại một trung tâm chăm sóc khách hàng bận rộn. Thời gian giữa các cuộc gọi đến thường tuân theo phân phối mũ. Tương tự, trong sản xuất, thời gian cho đến khi máy móc hỏng hoặc cần bảo dưỡng cũng thường có hành vi theo phân phối mũ.
Đặc điểm chính của phân phối mũ
Phân phối mũ có một số tính chất độc đáo khiến nó đặc biệt hữu dụng trong các ứng dụng thực tiễn:
Tính không nhớ (memoryless)
Đây có lẽ là đặc điểm nổi bật nhất của phân phối mũ. Nó có nghĩa là hành vi trong tương lai của hệ thống không phụ thuộc vào lịch sử quá khứ. Ví dụ, nếu một bóng đèn đã hoạt động được 1000 giờ, xác suất để nó hoạt động thêm 100 giờ nữa giống hệt như khi nó còn mới. Trong số các phân phối liên tục, chỉ có phân phối mũ có tính chất này.
Tốc độ nguy cơ (hazard rate) không đổi
Phân phối mũ duy trì tốc độ hỏng hóc không đổi theo thời gian. Điều này có nghĩa là xác suất xảy ra một sự kiện trong một khoảng thời gian nhỏ tiếp theo vẫn như cũ, bất kể đã trôi qua bao lâu.
Mối quan hệ giữa phân phối mũ và phân phối Poisson là nền tảng trong lý thuyết xác suất. Trong khi phân phối Poisson mô hình hóa số lượng sự kiện xảy ra trong một khoảng thời gian cố định, phân phối mũ mô hình hóa thời gian giữa các sự kiện đó. Chúng như hai mặt của cùng một đồng xu: nếu các sự kiện xảy ra theo một quá trình Poisson với tốc độ λ, thì thời gian chờ giữa các sự kiện tuân theo phân phối mũ với tham số λ.
Công thức toán học
Phân phối mũ được xác định bởi một tham số duy nhất λ (lambda), đại diện cho tham số tốc độ. Hãy xem các thành phần toán học chính của nó:
Hàm mật độ xác suất (PDF)
PDF giúp chúng ta tính xác suất một sự kiện xảy ra trong một khoảng cụ thể. PDF cho phân phối mũ như sau:
trong đó:
Hàm phân phối tích lũy (CDF)
CDF đặc biệt hữu ích khi chúng ta muốn tìm xác suất một sự kiện xảy ra trước một thời điểm nhất định. Nó cho ta xác suất rằng thời gian chờ nhỏ hơn hoặc bằng một giá trị cụ thể. Dưới đây là CDF cho phân phối mũ:
Ứng dụng của Phân phối Mũ
Phân phối mũ đóng vai trò quan trọng trong nhiều lĩnh vực, giúp chúng ta mô hình hóa và hiểu các quá trình phụ thuộc thời gian. Hãy cùng khám phá một số ứng dụng chính.
Kỹ thuật độ tin cậy
Kỹ thuật độ tin cậy dựa nhiều vào phân phối mũ để mô hình hóa tuổi thọ của linh kiện và hệ thống. Điều này đặc biệt hữu ích nhờ tính chất "không nhớ" của phân phối—tuổi thọ tương lai của một linh kiện chỉ phụ thuộc vào hiện tại, không phụ thuộc vào thời gian đã vận hành.
Ví dụ, các linh kiện điện tử thường có thời gian hỏng theo phân phối mũ, thể hiện tính không nhớ độc đáo của phân phối này. Điều đó có nghĩa là một vi xử lý mới có cùng xác suất hỏng trong giờ tiếp theo như một vi xử lý đã chạy một tháng (giả sử không có hiệu ứng hao mòn). Các nhà sản xuất phần cứng máy chủ sử dụng rộng rãi phân phối này trong phân tích độ tin cậy để tính Thời gian Trung bình Giữa Các Lần Hỏng (MTBF), xác định lịch bảo trì tối ưu, và dự đoán chi phí bảo hành cùng nhu cầu thay thế. Những thông tin này có giá trị cho cả phát triển sản phẩm và hoạch định kinh doanh.
Lý thuyết hàng đợi
Trong lý thuyết hàng đợi, phân phối mũ là nền tảng để mô hình hóa thời gian giữa các lượt đến hoặc thời gian phục vụ trong nhiều hệ thống. Ứng dụng này đặc biệt hữu ích trong:
1. Trung tâm Chăm sóc Khách hàng:
2. Viễn thông:
3. Hệ thống y tế:
Phân phối mũ hoạt động tốt trong các bối cảnh này vì nhiều quá trình đến có thể được xấp xỉ như các sự kiện không nhớ xảy ra với tốc độ trung bình không đổi.
Tính toán xác suất với Phân phối Mũ
Khi làm việc với phân phối mũ, chúng ta có hai cách chính để tính xác suất: PDF đặc biệt hữu ích khi cần tìm xác suất một sự kiện xảy ra trong một khoảng hoặc dải cụ thể, trong khi CDF giúp xác định xác suất sự kiện xảy ra trước một thời điểm nhất định. Hãy khám phá cả hai cách tiếp cận bằng một kịch bản bàn hỗ trợ (help desk) thực tế.
Sử dụng hàm mật độ xác suất
Chúng ta đã đề cập rằng PDF giúp tính xác suất sự kiện xảy ra trong một khoảng. Với các phân phối liên tục như phân phối mũ, ta cần tích phân PDF trên khoảng quan tâm.
Hãy cùng làm một ví dụ thực tế: Giả sử chúng ta phân tích các cuộc gọi dịch vụ khách hàng tại một bàn hỗ trợ, nơi các cuộc gọi đến theo phân phối mũ với tốc độ trung bình 3 cuộc mỗi giờ (λ = 3).
Để tìm xác suất phải chờ từ 10 đến 20 phút cho cuộc gọi tiếp theo, ta sẽ:
Sử dụng hàm phân phối tích lũy
Chúng ta đã nói rằng CDF hữu ích khi muốn tìm xác suất sự kiện xảy ra trước một thời điểm. Quay lại ví dụ bàn hỗ trợ: Xác suất nhận được cuộc gọi trong 15 phút đầu là bao nhiêu?
Quay lại ví dụ bàn hỗ trợ: Xác suất nhận được cuộc gọi trong 15 phút đầu là bao nhiêu?
Điều này có nghĩa là có khoảng 53% khả năng nhận được cuộc gọi trong 15 phút đầu. Hãy lưu ý cách CDF giúp các phép tính xác suất kiểu "đến thời điểm" này trở nên trực quan hơn so với dùng PDF.
Trực quan hóa Phân phối Mũ
Trước hết, hãy xem bản thân phân phối mũ rồi so sánh nó với các phân phối khác.
Biểu diễn đồ thị
Dưới đây là một tập đồ thị tôi tạo bằng Python:
Hãy khám phá cách các công thức toán học chuyển thành các mẫu hình trực quan. Hình trực quan hiển thị ba tham số tốc độ khác nhau (0.5, 1.0 và 2.0) để minh họa cách λ định hình phân phối:
Quan sát PDF (đồ thị trên):
CDF (đồ thị dưới) kể một câu chuyện bổ sung:
Hành vi này khiến phân phối mũ đặc biệt hữu ích để mô hình hóa các hiện tượng thực tế như thời gian chờ đợi, tuổi thọ thiết bị và thời gian giữa các sự kiện trong một quá trình Poisson.
So sánh với các phân phối khác
Những đặc điểm độc đáo của phân phối mũ trở nên rõ ràng hơn khi so sánh với các phân phối xác suất phổ biến khác. Hãy xem các so sánh này qua hình trực quan của chúng ta:
Khi quan sát so sánh với phân phối chuẩn (bảng bên trái), nổi bật một số khác biệt chính. Phân phối mũ có độ lệch phải rõ rệt, đạt giá trị cực đại ngay lập tức rồi giảm liên tục. Điều này tương phản mạnh với đường cong hình chuông đối xứng quen thuộc của phân phối chuẩn quanh giá trị trung bình. Dù cả hai đều là phân phối liên tục, chúng phục vụ mục đích mô hình khác nhau: phân phối mũ vượt trội trong mô hình hóa thời gian chờ và khoảng cách, trong khi phân phối chuẩn thường xử lý các phép đo và giá trị trung bình.
Mối quan hệ với phân phối Poisson (bảng bên phải) hé lộ một khía cạnh thú vị khác của lý thuyết xác suất. Nếu phân phối mũ đo thời gian giữa các sự kiện, thì phân phối Poisson tập trung vào đếm số sự kiện trong một khoảng thời gian cố định. Hai phân phối này là hai mặt của cùng một vấn đề: trong một quá trình Poisson, thời gian chờ tự nhiên tuân theo phân phối mũ. Một khác biệt đáng chú ý khác là tính liên tục—phân phối mũ có thể nhận mọi giá trị thực dương, còn phân phối Poisson chỉ xử lý các số nguyên rời rạc không âm.
Những hiểu biết so sánh này cho thấy vì sao phân phối mũ vượt trội trong các kịch bản mô hình cụ thể. Nó vô cùng hữu ích khi phân tích khoảng thời gian giữa các sự kiện ngẫu nhiên, cung cấp năng lực vượt ra ngoài trọng tâm đếm sự kiện của phân phối Poisson. Phân phối này đặc biệt nổi bật trong các tình huống đòi hỏi đánh giá xác suất xảy ra ngay lập tức, trái ngược với cách tiếp cận xu hướng trung tâm của phân phối chuẩn. Có lẽ khác biệt nhất là tính không nhớ độc đáo của nó, tách biệt khỏi cả phân phối Chuẩn và Poisson, khiến nó trở thành lựa chọn tối ưu cho các quá trình mà sự kiện trong quá khứ không ảnh hưởng đến xác suất tương lai.
Hiểu sai thường gặp và cạm bẫy
Khi làm việc với phân phối mũ, một số hiểu lầm phổ biến có thể dẫn đến phân tích sai. Hiểu các cạm bẫy tiềm ẩn này giúp đảm bảo áp dụng chính xác phân phối trong các tình huống thực tế.
Diễn giải sai tính không nhớ
Tính không nhớ thường gây nhầm lẫn vì dường như mâu thuẫn với kinh nghiệm hàng ngày của chúng ta. Dưới đây là những hiểu sai thường gặp và cách hiệu chỉnh:
Một hiểu lầm phổ biến là nghĩ rằng tính không nhớ có nghĩa các sự kiện trong quá khứ không có giá trị dự đoán. Trên thực tế, điều đó có nghĩa là xác suất phải chờ thêm một khoảng thời gian nữa vẫn như cũ, bất kể bạn đã chờ bao lâu. Ví dụ:
Một hiểu lầm khác là cho rằng mọi kịch bản độ tin cậy đều có tính không nhớ. Thực tế, nhiều hệ thống thể hiện hiệu ứng lão hóa hoặc hao mòn không tuân theo hành vi mũ. Chẳng hạn, các bộ phận cơ khí thường có tỷ lệ hỏng tăng theo thời gian.
Sử dụng tham số không chính xác
Một số lỗi phổ biến xảy ra khi chọn và áp dụng tham số tốc độ:
Nhầm lẫn giữa tốc độ và trung bình:
Lỗi thường gặp là dùng giá trị trung bình làm tham số tốc độ (λ)
Hãy nhớ: Giá trị trung bình (kỳ vọng) thực ra là 1/λ
Ví dụ, nếu các sự kiện xảy ra trung bình mỗi 2 giờ, λ = 1/2, không phải 2
Lệch đơn vị:
Tham số tốc độ phải nhất quán với đơn vị thời gian trong dữ liệu của bạn
Nếu bạn đo thời gian theo giờ nhưng lại chỉ định λ theo ngày(-1), các xác suất sẽ sai
Luôn quy đổi về đơn vị nhất quán trước khi áp dụng phân phối
Lạm dụng áp dụng:
Hãy xác minh rằng các sự kiện xảy ra độc lập
Rằng tốc độ vẫn không đổi theo thời gian
Và quá trình không có hiệu ứng nhớ
Để tránh các lỗi này, hãy luôn xác định rõ đơn vị và quy đổi nhất quán, xác minh rằng các giả định của phân phối mũ phù hợp với kịch bản của bạn, kiểm tra dữ liệu xem có hành vi mũ trước khi áp dụng phân phối, và ghi lại lựa chọn tham số cùng lý do của bạn.
Kết luận
Sự giản dị thanh thoát và khả năng ứng dụng mạnh mẽ khiến phân phối mũ trở thành công cụ không thể thiếu trong bộ dụng cụ của nhà khoa học dữ liệu. Tính không nhớ độc đáo và mối quan hệ với các phân phối khác, đặc biệt là phân phối Gaussian, nhấn mạnh vị trí đặc biệt của nó trong lý thuyết xác suất.
Mặc dù hướng dẫn này đã bao quát những khía cạnh thiết yếu, vẫn còn nhiều điều để khám phá trong các ứng dụng chuyên sâu. Với những ai quan tâm đến triển khai thực hành, khóa học Statistical Simulation in Python của chúng tôi mang đến trải nghiệm thực hành với các khái niệm này. Ngoài ra, hiểu cách phân phối mũ liên hệ với các phân phối xác suất khác, như được trình bày trong Multivariate Probability Distributions in R, cung cấp góc nhìn rộng hơn về vai trò của nó trong mô hình thống kê. Dù bạn đang phân tích dữ liệu sống sót, mô hình hóa độ tin cậy hệ thống hay nghiên cứu hành vi hàng đợi, thành thạo phân phối mũ sẽ mở ra những khả năng mới trong phân tích dữ liệu và mô hình hóa thống kê.