
Last chance! 50% off DataCamp Premium
Sale ends in
लैंग्वेज मॉडल मशीन लर्निंग एल्गोरिद्म का एक प्रकार है, जिसे वाक्य के पूर्ववर्ती हिस्सों से संकेत लेते हुए अगले शब्द का पूर्वानुमान लगाने के लिए डिज़ाइन किया गया है। यह Transformers आर्किटेक्चर पर आधारित है, जिसकी हमारे लेख Transformers कैसे काम करते हैं में विस्तार से व्याख्या की गई है।
प्री-ट्रेन्ड भाषा मॉडल्स, जैसे GPT (Generative Pre-trained Transformer), विशाल मात्रा के टेक्स्ट डेटा पर प्रशिक्षित होते हैं। यह LLMs को शब्दों के प्रयोग और उनकी प्राकृतिक भाषा में व्यवस्था के मूलभूत सिद्धांतों को समझने में सक्षम बनाता है।
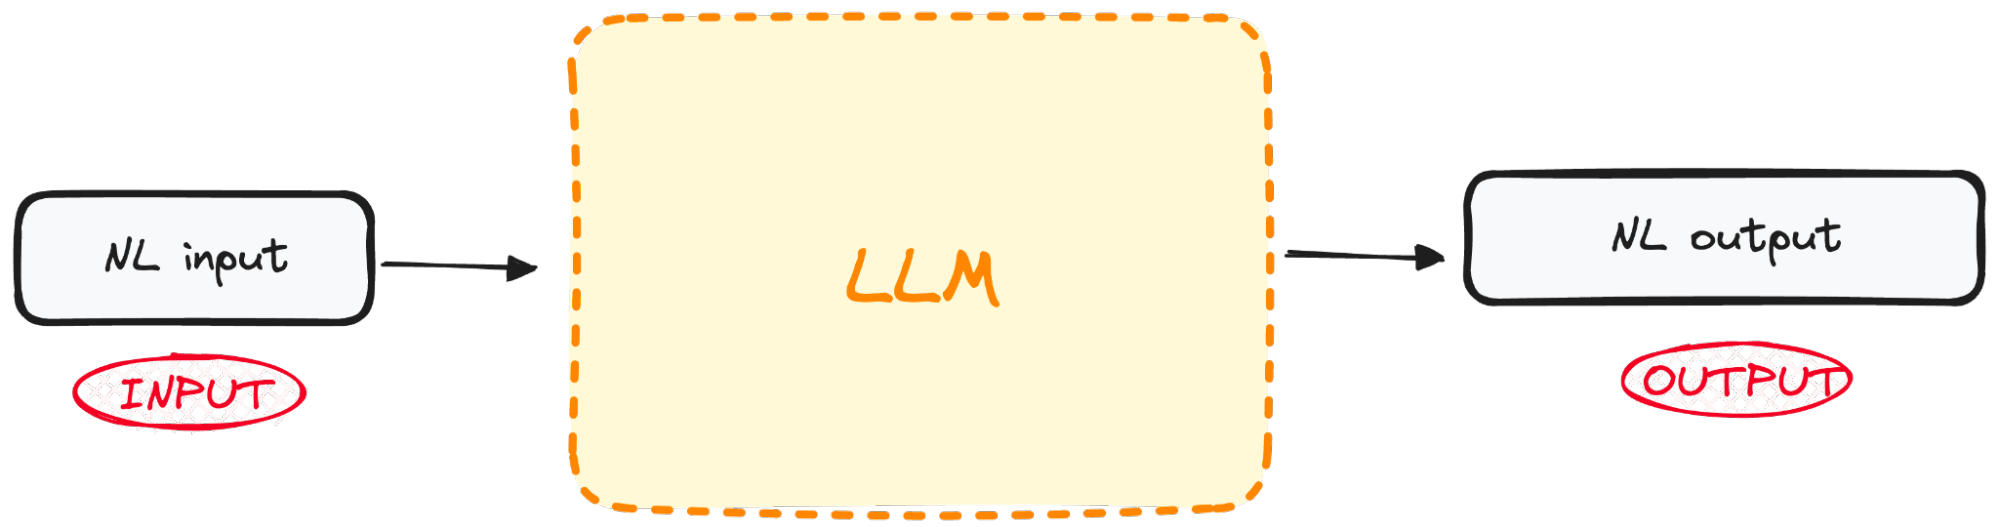
लेखक द्वारा बनाई गई छवि। LLM इनपुट और आउटपुट।
सबसे महत्वपूर्ण बात यह है कि ये मॉडल न केवल प्राकृतिक भाषा को समझने में अच्छे हैं, बल्कि उन्हें प्राप्त इनपुट के आधार पर मानवीय शैली का टेक्स्ट उत्पन्न करने में भी माहिर हैं।
और सबसे अच्छी बात?
ये मॉडल अब APIs के माध्यम से सभी के लिए उपलब्ध हैं। यदि आप OpenAI के सबसे शक्तिशाली LLMs का लाभ उठाना सीखना चाहते हैं, तो इस OpenAI API चीट शीट का अनुसरण करके ऐसा करना सीख सकते हैं।
फाइन-ट्यूनिंग वह प्रक्रिया है जिसमें किसी प्री-ट्रेन्ड मॉडल को लेकर उसे डोमेन-विशिष्ट डेटासेट पर आगे प्रशिक्षित किया जाता है।
आज के अधिकांश LLM मॉडल समग्र रूप से अच्छा प्रदर्शन करते हैं, लेकिन विशिष्ट कार्य-उन्मुख समस्याओं में चूक जाते हैं। फाइन-ट्यूनिंग प्रक्रिया उल्लेखनीय लाभ देती है, जैसे गणनात्मक खर्च में कमी और बिना शून्य से मॉडल बनाने के अत्याधुनिक मॉडल्स का उपयोग करना।
Transformers विभिन्न कार्यों के लिए उपयुक्त प्री-ट्रेन्ड मॉडल्स का विस्तृत संग्रह उपलब्ध कराते हैं। इन मॉडल्स का फाइन-ट्यूनिंग, सेंटिमेंट एनालिसिस, प्रश्नोत्तर, या दस्तावेज़ संक्षेपण जैसे विशिष्ट कार्यों को अधिक सटीकता से पूरा करने की क्षमता बढ़ाने के लिए एक अहम कदम है।
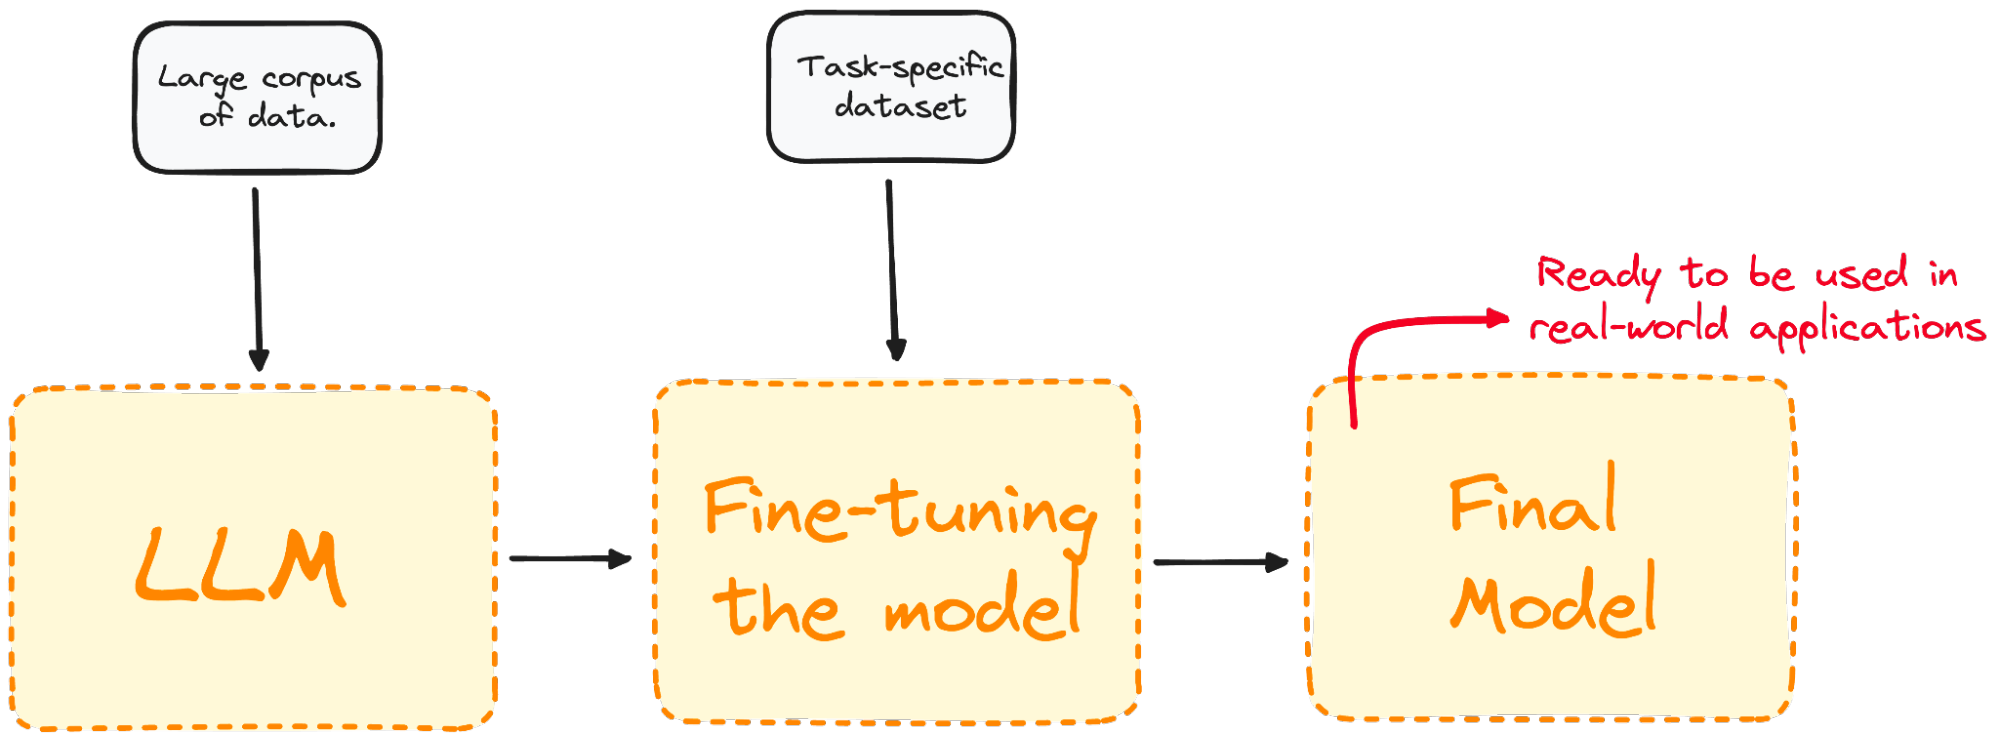
लेखक द्वारा बनाई गई छवि। फाइन-ट्यूनिंग प्रक्रिया का दृश्य।
फाइन-ट्यूनिंग मॉडल को विशिष्ट कार्यों के लिए बेहतर प्रदर्शन करने हेतु अनुकूलित करता है, जिससे वह वास्तविक दुनिया के अनुप्रयोगों में अधिक प्रभावी और बहुमुखी बन जाता है। किसी मौजूदा मॉडल को किसी विशेष कार्य या डोमेन के अनुरूप ढालने के लिए यह प्रक्रिया अनिवार्य है।
फाइन-ट्यूनिंग करना है या नहीं, यह आपके लक्ष्यों पर निर्भर करता है, जो आमतौर पर संबंधित डोमेन या कार्य के अनुसार अलग-अलग हो सकते हैं।
फाइन-ट्यूनिंग को कई तरीकों से अपनाया जा सकता है, जो मुख्यतः उसके फोकस और विशिष्ट लक्ष्यों पर निर्भर करते हैं।
सबसे सरल और आम दृष्टिकोण। मॉडल को लक्ष्य कार्य के अनुरूप लेबलयुक्त डेटासेट पर और प्रशिक्षित किया जाता है, जैसे टेक्स्ट वर्गीकरण या नेम्ड एंटिटी रिकग्निशन।
उदाहरण के लिए, सेंटिमेंट एनालिसिस के लिए हम अपने मॉडल को ऐसे डेटासेट पर प्रशिक्षित करेंगे जिसमें टेक्स्ट सैंपल्स को उनके संबंधित सेंटिमेंट के साथ लेबल किया गया हो।
कई बार बड़े लेबलयुक्त डेटासेट एकत्र करना व्यावहारिक नहीं होता। फ्यू-शॉट लर्निंग, इनपुट प्रॉम्प्ट्स की शुरुआत में आवश्यक कार्य के कुछ उदाहरण (या शॉट्स) देकर इसे संबोधित करने की कोशिश करता है। इससे मॉडल को बिना विस्तृत फाइन-ट्यूनिंग के कार्य का बेहतर संदर्भ मिलता है।
हालांकि सभी फाइन-ट्यूनिंग तकनीकें ट्रांसफर लर्निंग का ही रूप हैं, यह श्रेणी खास तौर पर किसी मॉडल को उसके मूल प्रशिक्षण कार्य से भिन्न कार्य कराने पर केंद्रित है। मुख्य विचार यह है कि मॉडल ने बड़े, सामान्य डेटासेट से जो ज्ञान प्राप्त किया है, उसे अधिक विशिष्ट या संबंधित कार्य पर लागू किया जाए।
इस प्रकार की फाइन-ट्यूनिंग का उद्देश्य मॉडल को किसी विशेष डोमेन या उद्योग के अनुरूप टेक्स्ट समझने और उत्पन्न करने के लिए ढालना है। मॉडल को लक्ष्य डोमेन के टेक्स्ट से बने डेटासेट पर फाइन-ट्यून किया जाता है ताकि उसके संदर्भ और डोमेन-विशिष्ट कार्यों के ज्ञान में सुधार हो।
उदाहरण के लिए, किसी मेडिकल ऐप के लिए चैटबॉट बनाने हेतु, मॉडल को मेडिकल रिकॉर्ड्स से प्रशिक्षित किया जाएगा, ताकि उसकी भाषा-समझ क्षमता स्वास्थ्य क्षेत्र के अनुरूप ढल सके।
इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएंहम जानते हैं कि फाइन-ट्यूनिंग किसी प्री-ट्रेन्ड मॉडल को लेकर उसके पैरामीटर्स को आपके कार्य-विशिष्ट डेटासेट पर प्रशिक्षण देकर अपडेट करने की प्रक्रिया है। तो आइए किसी वास्तविक मॉडल को फाइन-ट्यून करके इस अवधारणा को स्पष्ट करें।
मान लीजिए हम GPT-2 के साथ काम कर रहे हैं, लेकिन हमें पता चलता है कि यह ट्वीट्स के सेंटिमेंट को समझने में काफी कमजोर है।
मन में एक स्वाभाविक सवाल आता है: क्या हम इसके प्रदर्शन में सुधार के लिए कुछ कर सकते हैं?
हम फाइन-ट्यूनिंग का लाभ उठा सकते हैं: Hugging Face वाले प्री-ट्रेन्ड GPT-2 मॉडल को ऐसे डेटासेट से प्रशिक्षित करें जिसमें ट्वीट्स और उनके संबंधित सेंटिमेंट हों, ताकि प्रदर्शन बेहतर हो। यहाँ सीक्वेंस क्लासिफिकेशन के लिए मॉडल फाइन-ट्यूनिंग का एक बुनियादी उदाहरण है:
किसी मॉडल को फाइन-ट्यून करने के लिए, हमें हमेशा एक प्री-ट्रेन्ड मॉडल दिमाग में रखना होता है। हमारे मामले में, हम GPT-2 का उपयोग करके कुछ सरल फाइन-ट्यूनिंग करेंगे।
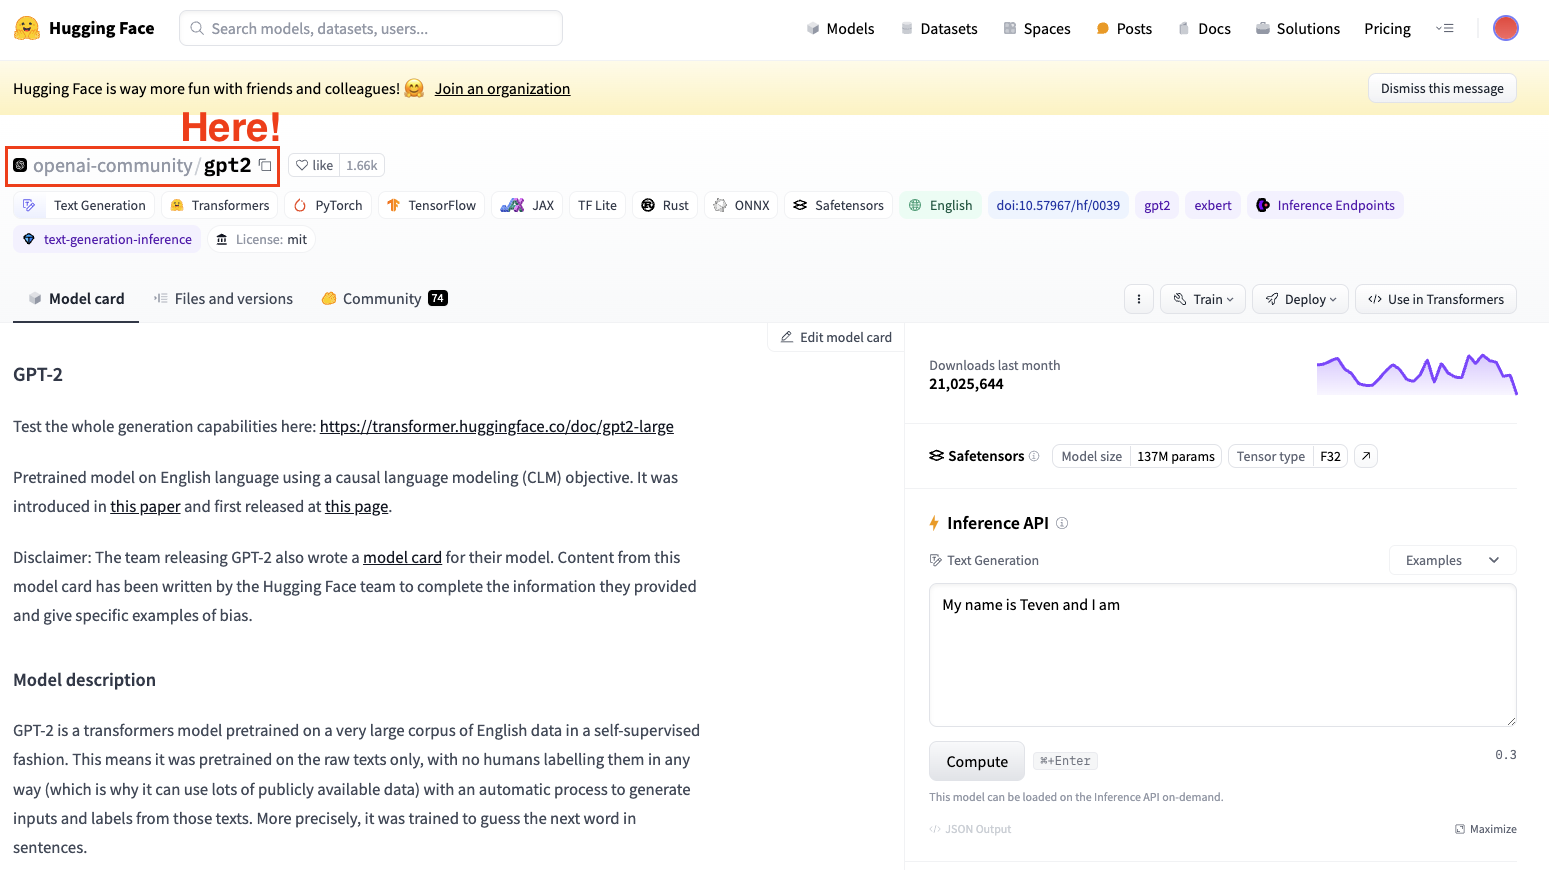
Hugging Face Datasets Hub का स्क्रीनशॉट। OpenAI के GPT2 मॉडल का चयन।
हमेशा ध्यान रखें कि अपने कार्य के अनुरूप मॉडल आर्किटेक्चर का चयन करें।
अब जबकि हमारे पास मॉडल है, हमें काम के लिए अच्छी गुणवत्ता वाला डेटा चाहिए, और यहीं पर datasets लाइब्रेरी काम आती है।
मेरे मामले में, मैं Hugging Face datasets लाइब्रेरी का उपयोग करके ऐसा डेटासेट आयात करूंगा जिसमें ट्वीट्स को उनके सेंटिमेंट (Positive, Neutral या Negative) के अनुसार वर्गीकृत किया गया है।
from datasets import load_dataset

dataset = load_dataset("mteb/tweet_sentiment_extraction")
df = pd.DataFrame(dataset['train'])
यदि हम अभी डाउनलोड किए गए डेटासेट की जाँच करें, तो इसमें प्रशिक्षण के लिए एक सबसेट और परीक्षण के लिए एक सबसेट है। यदि हम प्रशिक्षण सबसेट को डेटाफ़्रेम में बदलते हैं, तो यह कुछ इस प्रकार दिखता है।
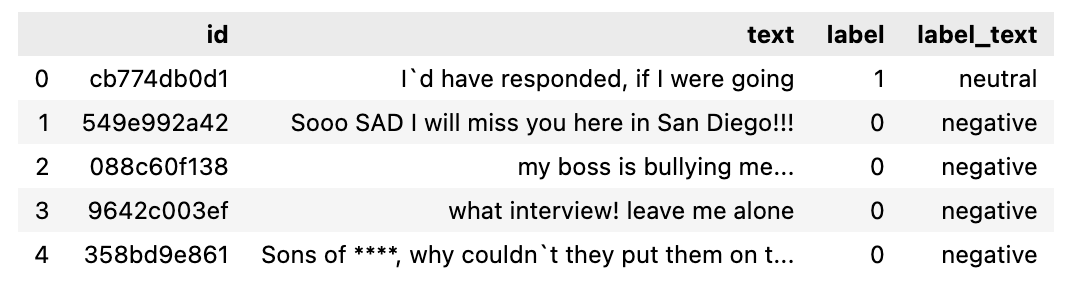
उपयोग होने वाला डेटा सेट।
अब जब हमारे पास डेटासेट है, तो हमें उसे हमारे मॉडल द्वारा पार्स किए जाने के लिए एक टोकनाइज़र से तैयार करना होगा।
चूँकि LLMs टोकन्स के साथ काम करते हैं, इसलिए हमें डेटासेट को प्रोसेस करने के लिए टोकनाइज़र चाहिए। अपने डेटासेट को एक ही चरण में प्रोसेस करने के लिए, Datasets की map विधि का उपयोग करके पूरे डेटासेट पर एक प्रीप्रोसेसिंग फ़ंक्शन लागू करें।
इसीलिए दूसरा चरण है एक प्री-ट्रेन्ड टोकनाइज़र लोड करना और अपने डेटासेट को टोकनाइज़ करना ताकि उसे फाइन-ट्यूनिंग के लिए इस्तेमाल किया जा सके।
from transformers import GPT2Tokenizer

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

tokenizer = GPT2Tokenizer.from_pretrained("gpt2")
tokenizer.pad_token = tokenizer.eos_token
def tokenize_function(examples):
   return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
बोनस: हम अपनी प्रोसेसिंग आवश्यकताओं को बेहतर बनाने के लिए, फाइन-ट्यूनिंग हेतु पूर्ण डेटासेट का छोटा सबसेट बना सकते हैं। ट्रेनिंग सेट का उपयोग मॉडल को फाइन-ट्यून करने के लिए किया जाएगा, जबकि टेस्टिंग सेट का उपयोग उसके मूल्यांकन के लिए होगा।
small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))अपने मॉडल को लोड करके शुरू करें और अपेक्षित लेबल्स की संख्या निर्दिष्ट करें। ट्वीट सेंटिमेंट डेटासेट कार्ड से आपको पता है कि तीन लेबल हैं:
from transformers import GPT2ForSequenceClassification

model = GPT2ForSequenceClassification.from_pretrained("gpt2", num_labels=3)Transformers प्रशिक्षण के लिए अनुकूलित Trainer क्लास प्रदान करता है। हालांकि, यह विधि मॉडल का मूल्यांकन कैसे करना है, शामिल नहीं करती। इसलिए, प्रशिक्षण शुरू करने से पहले, हमें Trainer को एक फ़ंक्शन पास करना होगा जो हमारे मॉडल के प्रदर्शन का मूल्यांकन करे।
import evaluate

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
   logits, labels = eval_pred
   predictions = np.argmax(logits, axis=-1)
return metric.compute(predictions=predictions, references=labels)अंतिम चरण है ट्रेनिंग आर्गुमेंट्स सेट करना और प्रशिक्षण प्रक्रिया शुरू करना। Transformers लाइब्रेरी में Trainer क्लास है, जो लॉगिंग, ग्रेडिएंट एक्यूम्युलेशन और मिक्स्ड प्रिसिजन जैसी कई ट्रेनिंग विकल्पों और सुविधाओं का समर्थन करती है। हम पहले ट्रेनिंग आर्गुमेंट्स और इवैल्यूएशन स्ट्रैटेजी परिभाषित करते हैं। सब कुछ परिभाषित हो जाने के बाद, हम train() कमांड का उपयोग करके आसानी से मॉडल को प्रशिक्षित कर सकते हैं।
from transformers import TrainingArguments, Trainer

training_args = TrainingArguments(
   output_dir="test_trainer",
   #evaluation_strategy="epoch",
   per_device_train_batch_size=1,  # Reduce batch size here
   per_device_eval_batch_size=1,    # Optionally, reduce for evaluation as well
   gradient_accumulation_steps=4
   )


trainer = Trainer(
   model=model,
   args=training_args,
   train_dataset=small_train_dataset,
   eval_dataset=small_eval_dataset,
   compute_metrics=compute_metrics,

)

trainer.train()
प्रशिक्षण के बाद, वैलिडेशन या टेस्ट सेट पर मॉडल के प्रदर्शन का मूल्यांकन करें। फिर से, Trainer क्लास में evaluate मेथड पहले से मौजूद है जो इसका ध्यान रखता है।
import evaluate

trainer.evaluate()
किसी भी LLM का फाइन-ट्यूनिंग करने के ये सबसे बुनियादी चरण हैं। याद रखें, LLM का फाइन-ट्यूनिंग अत्यधिक गणनात्मक रूप से मांग वाला होता है, और आपके लोकल कंप्यूटर में इसके लिए पर्याप्त क्षमता न हो।
आप OpenAI के इंटरफ़ेस पर सीधे अधिक शक्तिशाली LLMs को फाइन-ट्यून करना इस ट्यूटोरियल के माध्यम से सीख सकते हैं: GPT 3.5 को कैसे फाइन-ट्यून करें।
सफल फाइन-ट्यूनिंग सुनिश्चित करने के लिए, निम्नलिखित सर्वोत्तम प्रथाओं पर विचार करें:
आपके फाइन-ट्यूनिंग डेटासेट की गुणवत्ता मॉडल के प्रदर्शन को काफी प्रभावित करती है। हम सब इस उक्ति को जानते हैं:
“Garbage In, Garbage Out”
इसलिए, हमेशा सुनिश्चित करें कि डेटा साफ़, प्रासंगिक, और पर्याप्त बड़ा हो।
फाइन-ट्यूनिंग आमतौर पर एक लंबी और पुनरावृत्त प्रक्रिया है। अपने प्रोजेक्ट के लिए सर्वोत्तम सेटअप पहचानने हेतु learning rate, batch size, और training epochs की विभिन्न सेटिंग्स का अन्वेषण करें।
सटीक समायोजन सुनिश्चित करते हैं कि मॉडल कुशलतापूर्वक सीखे और अनदेखे डेटा के साथ अच्छी तरह अनुकूलित हो, तथा overfitting की समस्या से बचे।
प्रशिक्षण के दौरान मॉडल की प्रगति का नियमित रूप से आकलन करें ताकि उसकी प्रभावशीलता पर नज़र रखी जा सके और आवश्यक संशोधन लागू किए जा सकें। इसमें प्रशिक्षण अवधि के दौरान अलग वैलिडेशन डेटासेट का उपयोग करके प्रदर्शन का मूल्यांकन शामिल है।
ऐसा मूल्यांकन संबंधित कार्य पर मॉडल के प्रदर्शन और ट्रेनिंग डेटासेट पर संभावित overfitting का निर्धारण करने के लिए महत्वपूर्ण है। वैलिडेशन परिणामों के आधार पर, प्रदर्शन को अनुकूलित करने के लिए समायोजन किए जा सकते हैं।
कभी-कभी फाइन-ट्यूनिंग कमतर परिणाम दे सकती है। इन कमियों से सावधान रहें:
छोटे डेटासेट पर प्रशिक्षण करना या epochs की संख्या अत्यधिक बढ़ा देना overfitting पैदा कर सकता है। इसका संकेत आमतौर पर यह होता है कि मॉडल ट्रेनिंग डेटासेट पर उच्च सटीकता दिखाता है, लेकिन नए डेटा पर सामान्यीकरण करने में विफल रहता है।
इसके विपरीत, अपर्याप्त प्रशिक्षण या कम learning rate से underfitting हो सकता है, जहाँ मॉडल कार्य को पर्याप्त रूप से सीख नहीं पाता।
किसी विशेष कार्य के लिए फाइन-ट्यूनिंग के दौरान, यह जोखिम रहता है कि मॉडल अपना प्रारंभिक अधिग्रहित व्यापक ज्ञान खो दे। इस समस्या को catastrophic forgetting कहा जाता है, जो प्राकृतिक भाषा प्रोसेसिंग के विविध कार्यों पर मॉडल की क्षमता को कम कर सकता है।
हमेशा सुनिश्चित करें कि प्रशिक्षण और वैलिडेशन डेटासेट अलग-अलग हों और उनमें कोई ओवरलैप न हो, क्योंकि इससे भ्रामक रूप से उच्च प्रदर्शन मेट्रिक्स मिल सकते हैं।
RAG रिट्रीवल-आधारित मॉडल्स और जेनरेटिव मॉडल्स की खूबियों को जोड़ता है। RAG में, एक retriever घटक इनपुट क्वेरी के आधार पर किसी बड़े डेटाबेस या नॉलेज बेस से प्रासंगिक जानकारी खोजता है। फिर यह प्राप्त जानकारी जेनरेटिव मॉडल द्वारा अधिक सटीक और प्रसंगानुकूल उत्तर उत्पन्न करने के लिए उपयोग की जाती है। RAG के प्रमुख लाभों में शामिल हैं:
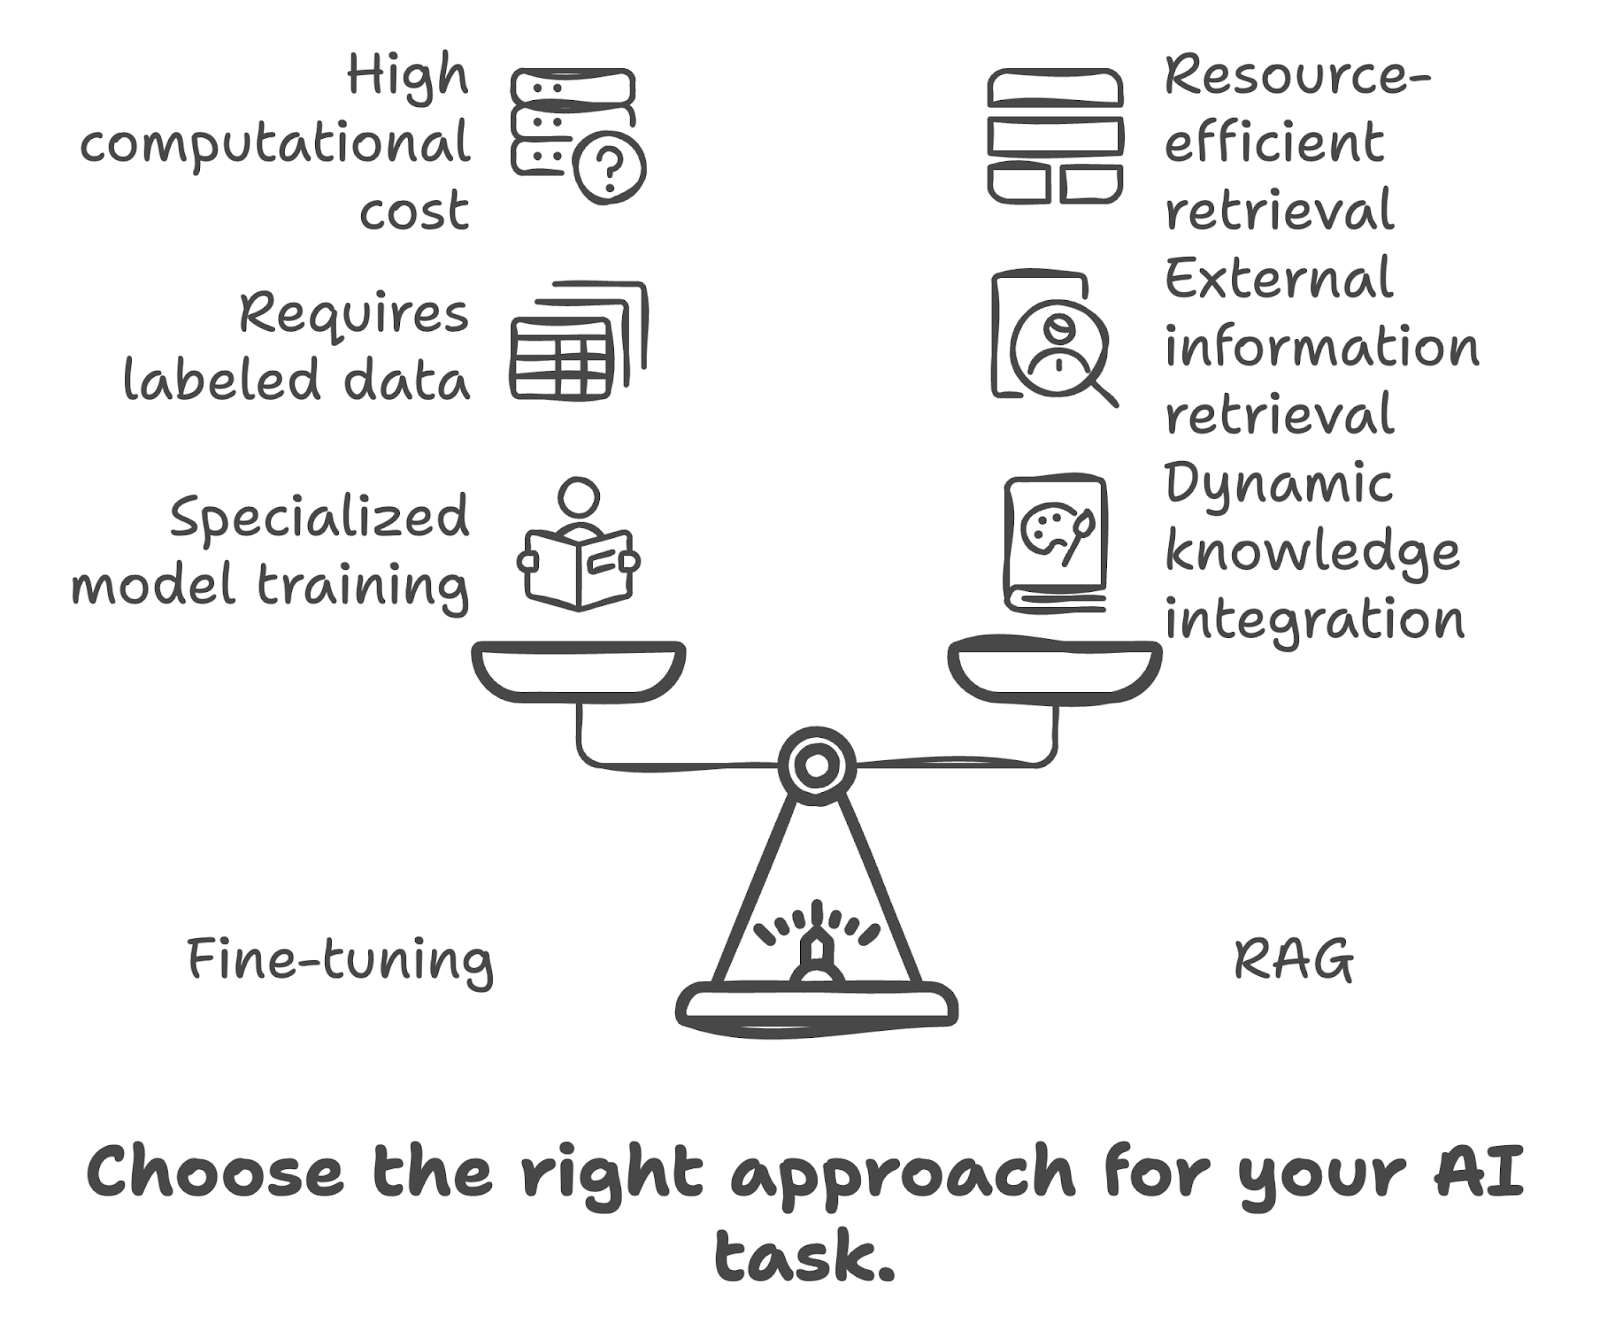
जब यह तय करें कि फाइन-ट्यूनिंग या RAG में से क्या उपयोग करना है, तो निम्नलिखित कारकों पर विचार करें:
बड़े भाषा मॉडल्स का फाइन-ट्यूनिंग शुरू करना AI अनुप्रयोगों के लिए संभावनाओं की एक दुनिया खोल देता है।
यहाँ बताई गई अवधारणाओं, प्रथाओं और सावधानियों को समझकर और लागू करके, आप इन शक्तिशाली मॉडल्स को विशिष्ट आवश्यकताओं के अनुरूप प्रभावी ढंग से ढाल सकते हैं और उनकी पूरी क्षमता का लाभ उठा सकते हैं।
फाइन-ट्यूनिंग के बारे में सीखते रहने के लिए, मैं आपको कुछ और उन्नत फाइन-ट्यूनिंग करने के लिए प्रोत्साहित करता हूँ। आप DataCamp के LLM Concepts कोर्स से शुरू कर सकते हैं, जिसमें कई प्रमुख प्रशिक्षण पद्धतियाँ और नवीनतम शोध शामिल हैं। अनुसरण करने के लिए कुछ अन्य अच्छे संसाधन:
आज ही अपनी AI यात्रा शुरू करें!
कोर्स
कोर्स
कोर्स
