

Airflow 的关键特性
Airflow 的框架及其架构具有多项独特的关键特性。首先,让我们更深入地了解 Airflow 框架中最重要的一些功能。
Airflow 框架的特性
Airflow 框架中最简单的单元是任务(task)。可以将任务视为操作;对大多数数据团队而言,即数据管道中的各类操作。
传统的ETL 工作流包含三个任务:抽取、转换和加载数据。依赖关系定义了任务之间的关联。回到我们的 ETL 示例,“load(加载)”任务依赖于“transform(转换)”任务,而“transform(转换)”又依赖于“extract(抽取)”任务。任务与依赖的组合会形成 DAG(有向无环图)。DAG 表示 Airflow 中的数据管道,定义起来略显繁琐。我们先看一张基础 ETL 管道的示意图:
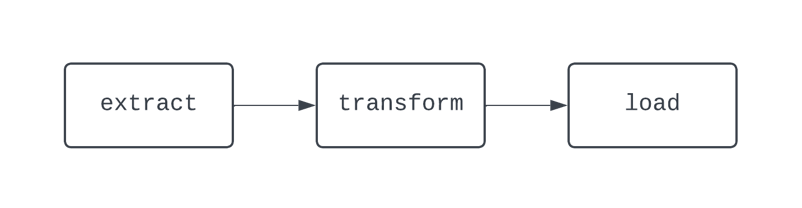
上面的 DAG 包含三个任务和两个依赖。之所以称为 DAG,是因为任务之间没有循环(或环)。这里的箭头显示了流程的有向性:首先运行 extract 任务,然后依次是 transform 和 load。借助 DAG,即使逻辑较复杂(如下图所示的 DAG),也能清楚地看到流程的明确起点与终点:
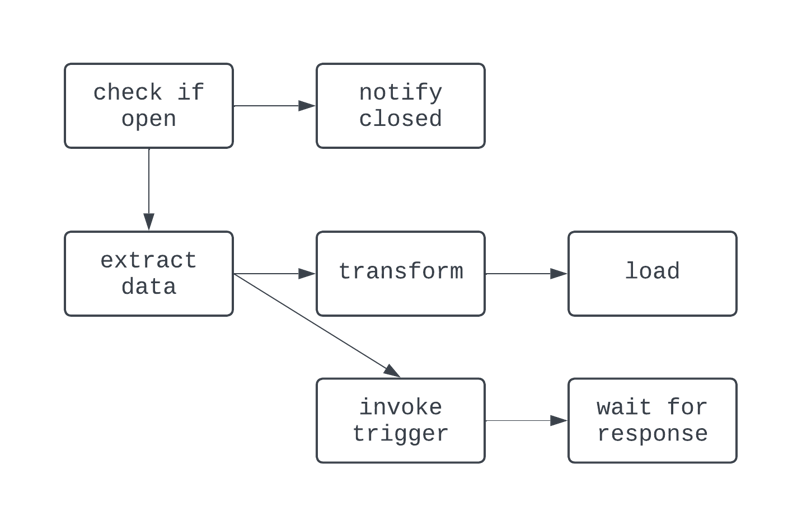
在这个 DAG 中,逻辑更为复杂。存在基于条件的分支,还有一些任务并行运行。不过,这个图仍然是有向的,任务之间不存在环形依赖。接下来,我们看看一个并非 DAG 的流程:
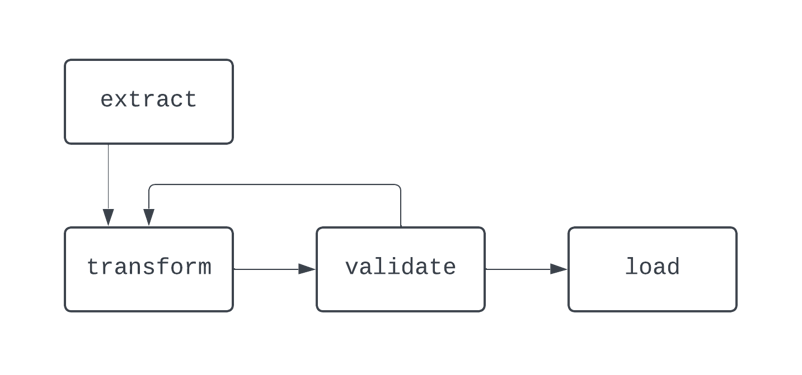
在该图中,transform 与 validate 任务之间存在明显的循环。在某些情况下,如果没有跳出循环的机制,这个 DAG 可能会一直运行下去。
在构建数据管道时,即便不使用 Airflow,也最好避免创建无法用 DAG 表示的工作流,否则可能会失去一些关键特性,例如确定性或幂等性。
Airflow 架构的特性
为了对 DAG 进行调度、执行任务并提供数据管道执行细节的可观测性,Airflow 采用了基于 Python 的架构,由以下组件构成:
- 调度器(Scheduler)
- 执行器(Executor)
- 元数据数据库(Metadata database)
- Web 服务器(UI)
无论是在本地运行 Airflow,还是在生产环境中运行,以上各组件都必须正常启动并运行,Airflow 才能正常工作。
调度器负责(您大概已经猜到)对 DAG 进行调度。要调度一个 DAG,需要在将 DAG 写为 Python 代码时为其提供开始日期和调度间隔。
一旦 DAG 被调度,DAG 中的任务就需要被执行,这就是执行器的职责。执行器并不会实际运行每个任务中的业务逻辑;它只负责将任务分配给配置好的计算资源来运行。元数据数据库则存储有关 DAG 运行的信息,例如 DAG 及其关联任务是否成功执行等。
元数据数据库还会存储用户自定义的变量和连接等信息,这些都有助于构建生产级数据管道。最后,Web 服务器为 Airflow 提供用户界面。
这个用户界面(UI)为数据团队提供了集中管理管道执行的工具。在 Airflow UI 中,数据团队可以查看其 DAG 的状态、手动重跑 DAG、存储变量和连接等。Airflow UI 为数据采集与交付流程提供了集中可见性,帮助数据团队随时了解其数据管道的运行表现。
安装 Apache Airflow
安装 Apache Airflow 的方式有多种。我们将介绍其中两种最常见的方法。
使用 pip 安装 Airflow
前置条件:
- 已安装
python3
要使用 pip(Python 的包管理器)安装 Airflow,您可以运行以下命令:
pip install apache-airflow包安装完成后,您需要创建 Airflow 项目的全部组件,例如设置 Airflow 主目录、创建 airflow.cfg 文件、启动元数据数据库等。这可能工作量较大,并需要具备一定的 Airflow 经验。幸运的是,使用 Astro CLI 有一种更简单的方法。
使用 Astro CLI 安装 Airflow
前置条件:
- 已安装
python3 - 已安装 Docker
Astronomer 是一家托管版 Airflow 提供商,提供多种免费工具,帮助更轻松地使用 Airflow。其中之一便是 Astro CLI。
Astro CLI 能够轻松创建和管理运行 Airflow 所需的一切。首先,您需要安装该 CLI。请访问Astronomer 文档,根据您的操作系统按步骤在本机进行安装。
安装 Astro CLI 后,只需一条命令即可配置完整的 Airflow 项目:
astro dev init这将在您当前的工作目录中配置 Airflow 项目所需的全部资源。此时,您的当前工作目录应类似如下结构:
.
├── dags/
├── include/
├── plugins/
├── tests/
├── airflow_settings.yaml
├── Dockerfile
├── packages.txt
└── requirements.txt
项目创建完成后,运行 astro dev start 即可启动项目。大约一分钟后,您可以在浏览器中打开 Airflow UI,地址为 https://localhost:8080/。现在,您已经准备好编写第一个 DAG!
编写您的第一个 Airflow DAG
我们已介绍了 Airflow 框架与架构的基础与进阶特性。现在,Airflow 已安装完毕,您可以开始编写第一个 DAG。首先,在刚创建的 Airflow 项目的 dags/ 目录中创建一个名为 sample_dag.py 的文件。使用您偏好的文本编辑器或 IDE 打开 sample_dag.py。我们先来实例化一个 DAG。
from airflow import DAG
from datetime import datetime
with DAG(
dag_id="weather_etl",
start_date=datetime(year=2024, month=1, day=1, hour=9, minute=0),
schedule="@daily",
catchup=True,
max_active_runs=1,
render_template_as_native_obj=True
) as dag:
...
上述代码中,我们通过 airflow 模块的 DAG 函数,结合 with 上下文管理器来定义一个 DAG。
我们提供了 start_date、schedule 间隔以及 catchup 的取值。该 DAG 将在每天世界标准时间上午 9:00 运行。由于 catchup 设为 True,该 DAG 会对首次触发至 2024 年 1 月 1 日之间的每一天进行补跑;max_active_runs=1 则确保同一时间只能有一个 DAG 运行。
现在,让我们添加几个任务!首先,我们将创建一个任务,用于模拟从 API 抽取数据。请参考以下代码:
...
# Import the PythonOperator
from airflow.operators.python import PythonOperator
...
def extract_data_callable():
# Print message, return a response
print("Extracting data from an weather API")
return {
"date": "2023-01-01",
"location": "NYC",
"weather": {
"temp": 33,
"conditions": "Light snow and wind"
}
}
extract_data = PythonOperator(
dag=dag,
task_id="extract_data",
python_callable=extract_data_callable
)
接下来,我们将创建一个任务,对 extract_data 任务返回的数据进行转换。可以使用以下代码实现。在此我们使用了名为 XCom 的 Airflow 功能,从前一个任务中获取数据。
由于 render_templat_as_native_obj 设置为 True,这些值将以 Python 对象而非字符串的形式共享。来自 extract_data 任务的原始数据将作为关键字参数传递给 transform_data_callable。随后,这些数据会被转换并返回,并以类似方式供 load_data 任务使用。
...
# Import pandas
import pandas as pd
...
def transform_data_callable(raw_data):
# Transform response to a list
transformed_data = [
[
raw_data.get("date"),
raw_data.get("location"),
raw_data.get("weather").get("temp"),
raw_data.get("weather").get("conditions")
]
]
return transformed_data
transform_data = PythonOperator(
dag=dag,
task_id="transform_data",
python_callable=transform_data_callable,
op_kwargs={"raw_data": "{{ ti.xcom_pull(task_ids='extract_data') }}"}
)
def load_data_callable(transformed_data):
# Load the data to a DataFrame, set the columns
loaded_data = pd.DataFrame(transformed_data)
loaded_data.columns = [
"date",
"location",
"weather_temp",
"weather_conditions"
]
print(loaded_data)
load_data = PythonOperator(
dag=dag,
task_id="load_data",
python_callable=load_data_callable,
op_kwargs={"transformed_data": "{{ ti.xcom_pull(task_ids='transform_data') }}"}
)
...
最后,在任务之间设置依赖关系。下面的代码将 extract_data、transform_data 与 load_data 任务串联起来,构建一个基础的 ETL DAG。
...
extract_data >> transform_data >> load_data
最终成品如下所示!
from airflow import DAG
from datetime import datetime
from airflow.operators.python import PythonOperator
import pandas as pd
with DAG(
dag_id="weather_etl",
start_date=datetime(year=2024, month=1, day=1, hour=9, minute=0),
schedule="@daily",
catchup=True,
max_active_runs=1,
render_template_as_native_obj=True
) as dag:
def extract_data_callable():
# Print message, return a response
print("Extracting data from an weather API")
return {
"date": "2023-01-01",
"location": "NYC",
"weather": {
"temp": 33,
"conditions": "Light snow and wind"
}
}
extract_data = PythonOperator(
dag=dag,
task_id="extract_data",
python_callable=extract_data_callable
)
def transform_data_callable(raw_data):
# Transform response to a list
transformed_data = [
[
raw_data.get("date"),
raw_data.get("location"),
raw_data.get("weather").get("temp"),
raw_data.get("weather").get("conditions")
]
]
return transformed_data
transform_data = PythonOperator(
dag=dag,
task_id="transform_data",
python_callable=transform_data_callable,
op_kwargs={"raw_data": "{{ ti.xcom_pull(task_ids='extract_data') }}"}
)
def load_data_callable(transformed_data):
# Load the data to a DataFrame, set the columns
loaded_data = pd.DataFrame(transformed_data)
loaded_data.columns = [
"date",
"location",
"weather_temp",
"weather_conditions"
]
print(loaded_data)
load_data = PythonOperator(
dag=dag,
task_id="load_data",
python_callable=load_data_callable,
op_kwargs={"transformed_data": "{{ ti.xcom_pull(task_ids='transform_data') }}"}
)
# Set dependencies between tasks
extract_data >> transform_data >> load_data
将管道定义为 Python 代码后,您可以使用 Airflow UI 启用该 DAG。点击 weather_etl DAG,并切换左上角的开关。观察您的任务与 DAG 成功完成运行。
恭喜,您已经编写并运行了自己的第一个 Airflow DAG!
除了使用传统的算子之外,Airflow 还引入了 TaskFlow API,使您能够通过装饰器和原生 Python 代码更轻松地定义 DAG 和任务。
与显式使用 XCom 在任务间共享数据不同,TaskFlow API 将这部分逻辑进行了抽象,改为在幕后使用 XCom。下面的代码展示了与上文完全相同的逻辑和功能,但使用 TaskFlow API 实现,对于习惯编写脚本式 ETL 逻辑的数据分析师和科学家而言更为直观。
from airflow.decorators import dag, task
from datetime import datetime
import pandas as pd
@dag(
start_date=datetime(year=2023, month=1, day=1, hour=9, minute=0),
schedule="@daily",
catchup=True,
max_active_runs=1
)
def weather_etl():
@task()
def extract_data():
# Print message, return a response
print("Extracting data from an weather API")
return {
"date": "2023-01-01",
"location": "NYC",
"weather": {
"temp": 33,
"conditions": "Light snow and wind"
}
}
@task()
def transform_data(raw_data):
# Transform response to a list
transformed_data = [
[
raw_data.get("date"),
raw_data.get("location"),
raw_data.get("weather").get("temp"),
raw_data.get("weather").get("conditions")
]
]
return transformed_data
@task()
def load_data(transformed_data):
# Load the data to a DataFrame, set the columns
loaded_data = pd.DataFrame(transformed_data)
loaded_data.columns = [
"date",
"location",
"weather_temp",
"weather_conditions"
]
print(loaded_data)
# Set dependencies using function calls
raw_dataset = extract_data()
transformed_dataset = transform_data(raw_dataset)
load_data(transformed_dataset)
# Allow the DAG to be run
weather_etl()
Airflow 最佳实践
构建 Airflow DAG 可能颇具挑战。在使用 Airflow 或其他工具构建数据管道和工作流时,有一些最佳实践需要牢记。
模块化
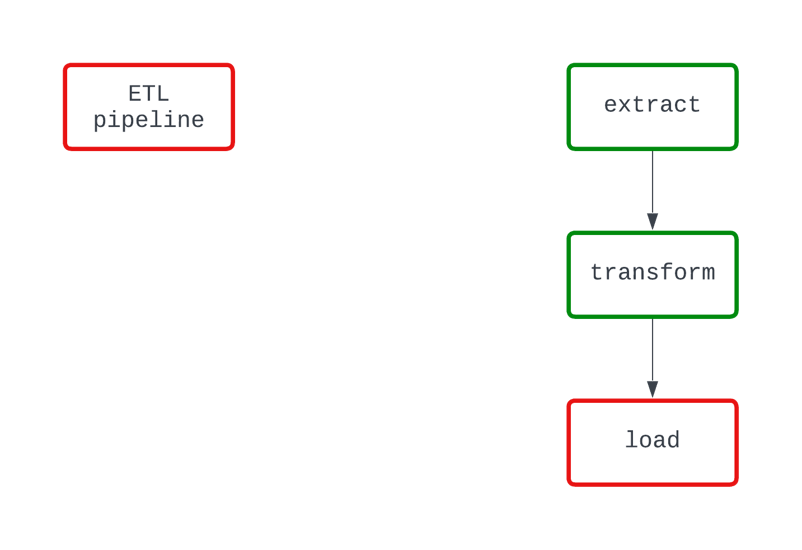
借助任务,Airflow 使模块化更易于可视化。不要试图在单个任务中做太多事情。尽管可以在一个任务中构建整个 ETL 管道,但这会使故障排查变得困难,也会让可视化 DAG 的性能变得不直观。
创建任务时,务必确保该任务只做一件事,就像在 Python 中编写函数一样。
请看下面的示例。这两个 DAG 完成相同的工作,并在代码的同一点失败。然而,在左侧的 DAG 中,很清楚是 load 逻辑导致失败,而右侧的 DAG 则不那么直观。
确定性
确定性过程是指在给定相同输入的情况下,每次都产生相同结果的过程。对于在特定时间区间运行的 DAG,它每次都应生成相同的结果。尽管这是数据管道更复杂的特性,但确保一致结果至关重要。
在 Airflow 中,尽量使用 Jinja 模板将模板化字段传递给算子,而不是用 datetime.now() 函数来生成时间相关数据。
幂等性
如果您针对同一个时间区间将 DAG 运行两次会怎样?运行 10 次呢?目标存储介质中是否会产生重复数据?幂等性保证即便数据管道被多次执行,其效果也如同仅执行了一次。
为使数据管道具备幂等性,请考虑在 DAG 中加入以下逻辑:
- 在重跑 DAG 时覆盖文件,而不是在同一区间再次运行时创建不同文件名的新文件
- 对数据库和数据仓库使用“删除-写入”模式来写入数据,而非使用可能导致重复的
INSERT。
编排不是转换
Airflow 并非用于处理海量数据。如果要对超过数 GB 的数据进行转换,Airflow 依然是合适的工具;不过此时应由 Airflow 调用其他工具(如 dbt 或 Databricks)来执行转换。
通常,任务要么在本地机器上执行,要么在生产环境中由工作节点执行。无论哪种方式,可用于计算的内存通常只有数 GB。
在处理更大规模数据时,请将 Airflow 主要用于轻量级数据转换以及编排任务。
Airflow 在行业中的应用
凭借将数据管道以代码形式定义的能力以及丰富的连接器与算子,全球各地的公司都依赖 Airflow 来驱动其数据平台。
在业界,数据团队可能会使用种类繁多的工具,从 SFTP 站点到云文件存储系统,再到数据湖仓。要构建数据平台,关键在于将这些异构系统进行集成。
得益于活跃的开源社区,有成千上万的预构建连接器可帮助您集成数据工具。想把 S3 上的文件导入 Snowflake?幸运的是,S3ToSnowflakeOperator 能轻松实现!想用 Great Expectations 做数据质量检查?也已经有人实现了。
如果找不到完全合适的预构建工具,也没关系。Airflow 具有良好的可扩展性,便于您根据自身需求构建自定义工具。
在生产环境运行 Airflow 时,您还需要考虑用于管理基础设施的相关工具。可选方案很多,比如 Astronomer 这类高级托管服务、MWAA 等云原生选项,或是自行搭建的方案。
通常,这涉及成本与基础设施管理之间的权衡:更昂贵的方案意味着需要管理的内容更少;而将一切都跑在单个 EC2 实例上可能成本较低,但维护起来更棘手。
结语
Apache Airflow 是在生产环境中运行数据管道的业界领先工具。它提供了调度、可扩展性与可观测性等功能,同时允许数据分析师、科学家和工程师以代码形式定义数据管道,帮助数据专业人士专注于创造业务价值。
借助 Astro CLI,入门 Airflow 十分容易;传统算子与 TaskFlow API 也让您能轻松编写首批 DAG。使用 Airflow 构建数据管道时,请在设计决策中始终优先考虑模块化、确定性与幂等性;这些最佳实践将帮助您在 DAG 出现错误时避免后续的麻烦。
使用 Airflow,有很多值得学习的内容。在您的下一个数据分析或数据科学项目中,不妨尝试使用 Airflow。试用预构建算子,或自行构建。尝试用传统算子与 TaskFlow API 在任务间共享数据。大胆探索其边界。如果您准备好开始,请查看 DataCamp 的 Introduction to Airflow in Python 课程,涵盖 Airflow 基础,并探讨如何在生产环境中实现复杂的数据工程管道。
您也可以学习我们的 Introduction to Data Pipelines 课程,帮助您练就构建高效、性能优良且可靠的数据管道的技能。最后,您还可以查看我们对比 Airflow 与 Prefect 的文章,以确定哪款工具更适合您。
如果您想了解更多,请查看以下资源。祝您一切顺利,编码愉快!
资源
https://airflow.apache.org/docs/apache-airflow/stable/project.html
https://airflow.apache.org/blog/airflow-survey-2022/
https://airflow.apache.org/docs/apache-airflow/1.10.9/installation.html
https://docs.astronomer.io/astro/cli/get-started-cli
https://airflow.apache.org/docs/apache-airflow/stable/tutorial/taskflow.html
https://airflow.apache.org/docs/apache-airflow/stable/templates-ref.html
什么是 Apache Airflow?
Apache Airflow(简称 Airflow)是一款用于在生产环境中运行数据管道的开源工具和框架。作为业界领先的数据工作流管理工具,Apache Airflow 以 Python 为基础,使数据从业者能够将数据管道以代码的形式进行定义。Airflow 还提供了调度管道执行和观测性能的能力,成为您所有数据工作流的集中枢纽。无论您是在为模型准备训练数据,还是将数据持久化到数据湖,Airflow 都能提供让您的数据管道达到生产级所需的功能。
Airflow 由 Maxime Beauchemin 于 2014 年在 Airbnb 首次创建,并于 2016 年 3 月加入 Apache 软件基金会孵化器项目,2019 年成为顶级项目。根据 Airflow 的2022 年调研,Airflow 每月被下载数百万次,成千上万家大小企业都在使用这款工具。