

课程
使用 LangChain 开发 LLM 应用
3 小时
51.8K
实践并学习路径你的进步。
使用 Google 继续想象您两次运行完全相同的大语言模型(LLM),但分别配上两种完全不同的挂架(harness)。第一次顺利完成了一项复杂的重构任务。第二次则中途停滞并彻底失败。模型从未改变,改变的是围绕模型的脚手架。
简而言之,代理挂架工程,就是构建围绕 LLM 的逻辑、文件系统访问、记忆与规则,使其能够可靠行动的实践。
在本教程中,我会教您如何用 Python 构建一个最小可用的 Reason and Act(ReAct)循环、工具与钩子(hooks)。您需要安装了 Python 3 与 pip,并对发起LLM API 调用有基本了解。
代理挂架工程,是指构建包裹在大语言模型外部的基础设施、配置与执行逻辑,将其从一个静态LLM 文本生成器升级为一个自主 AI 代理。
代理挂架工程是一种结构化配置,它将一个静态文本生成器变成一名自主“工作者”。
核心公式很简单:agent = model + harness。所谓挂架(harness),包含系统提示词、工具定义、文件系统工作区、编排逻辑,以及可观测性的钩子。
Addy Osmani 在 2026 年 4 月 O'Reilly 的一篇 AI 工作流文章中系统化提出了这一概念。他将挂架定义为除模型本身外的所有代码、配置与执行逻辑:也就是作为开发者您的“表面积”,区别于提供商的 API。
刚开始构建机器学习工作流时,只要代理“幻觉”出一个不存在的 Python 依赖,我就怪模型。后来我才痛苦领悟:大多数失败都是配置问题。
同一个版本的模型,配上更好的挂架,性能会显著优于配上糟糕挂架时的自己。
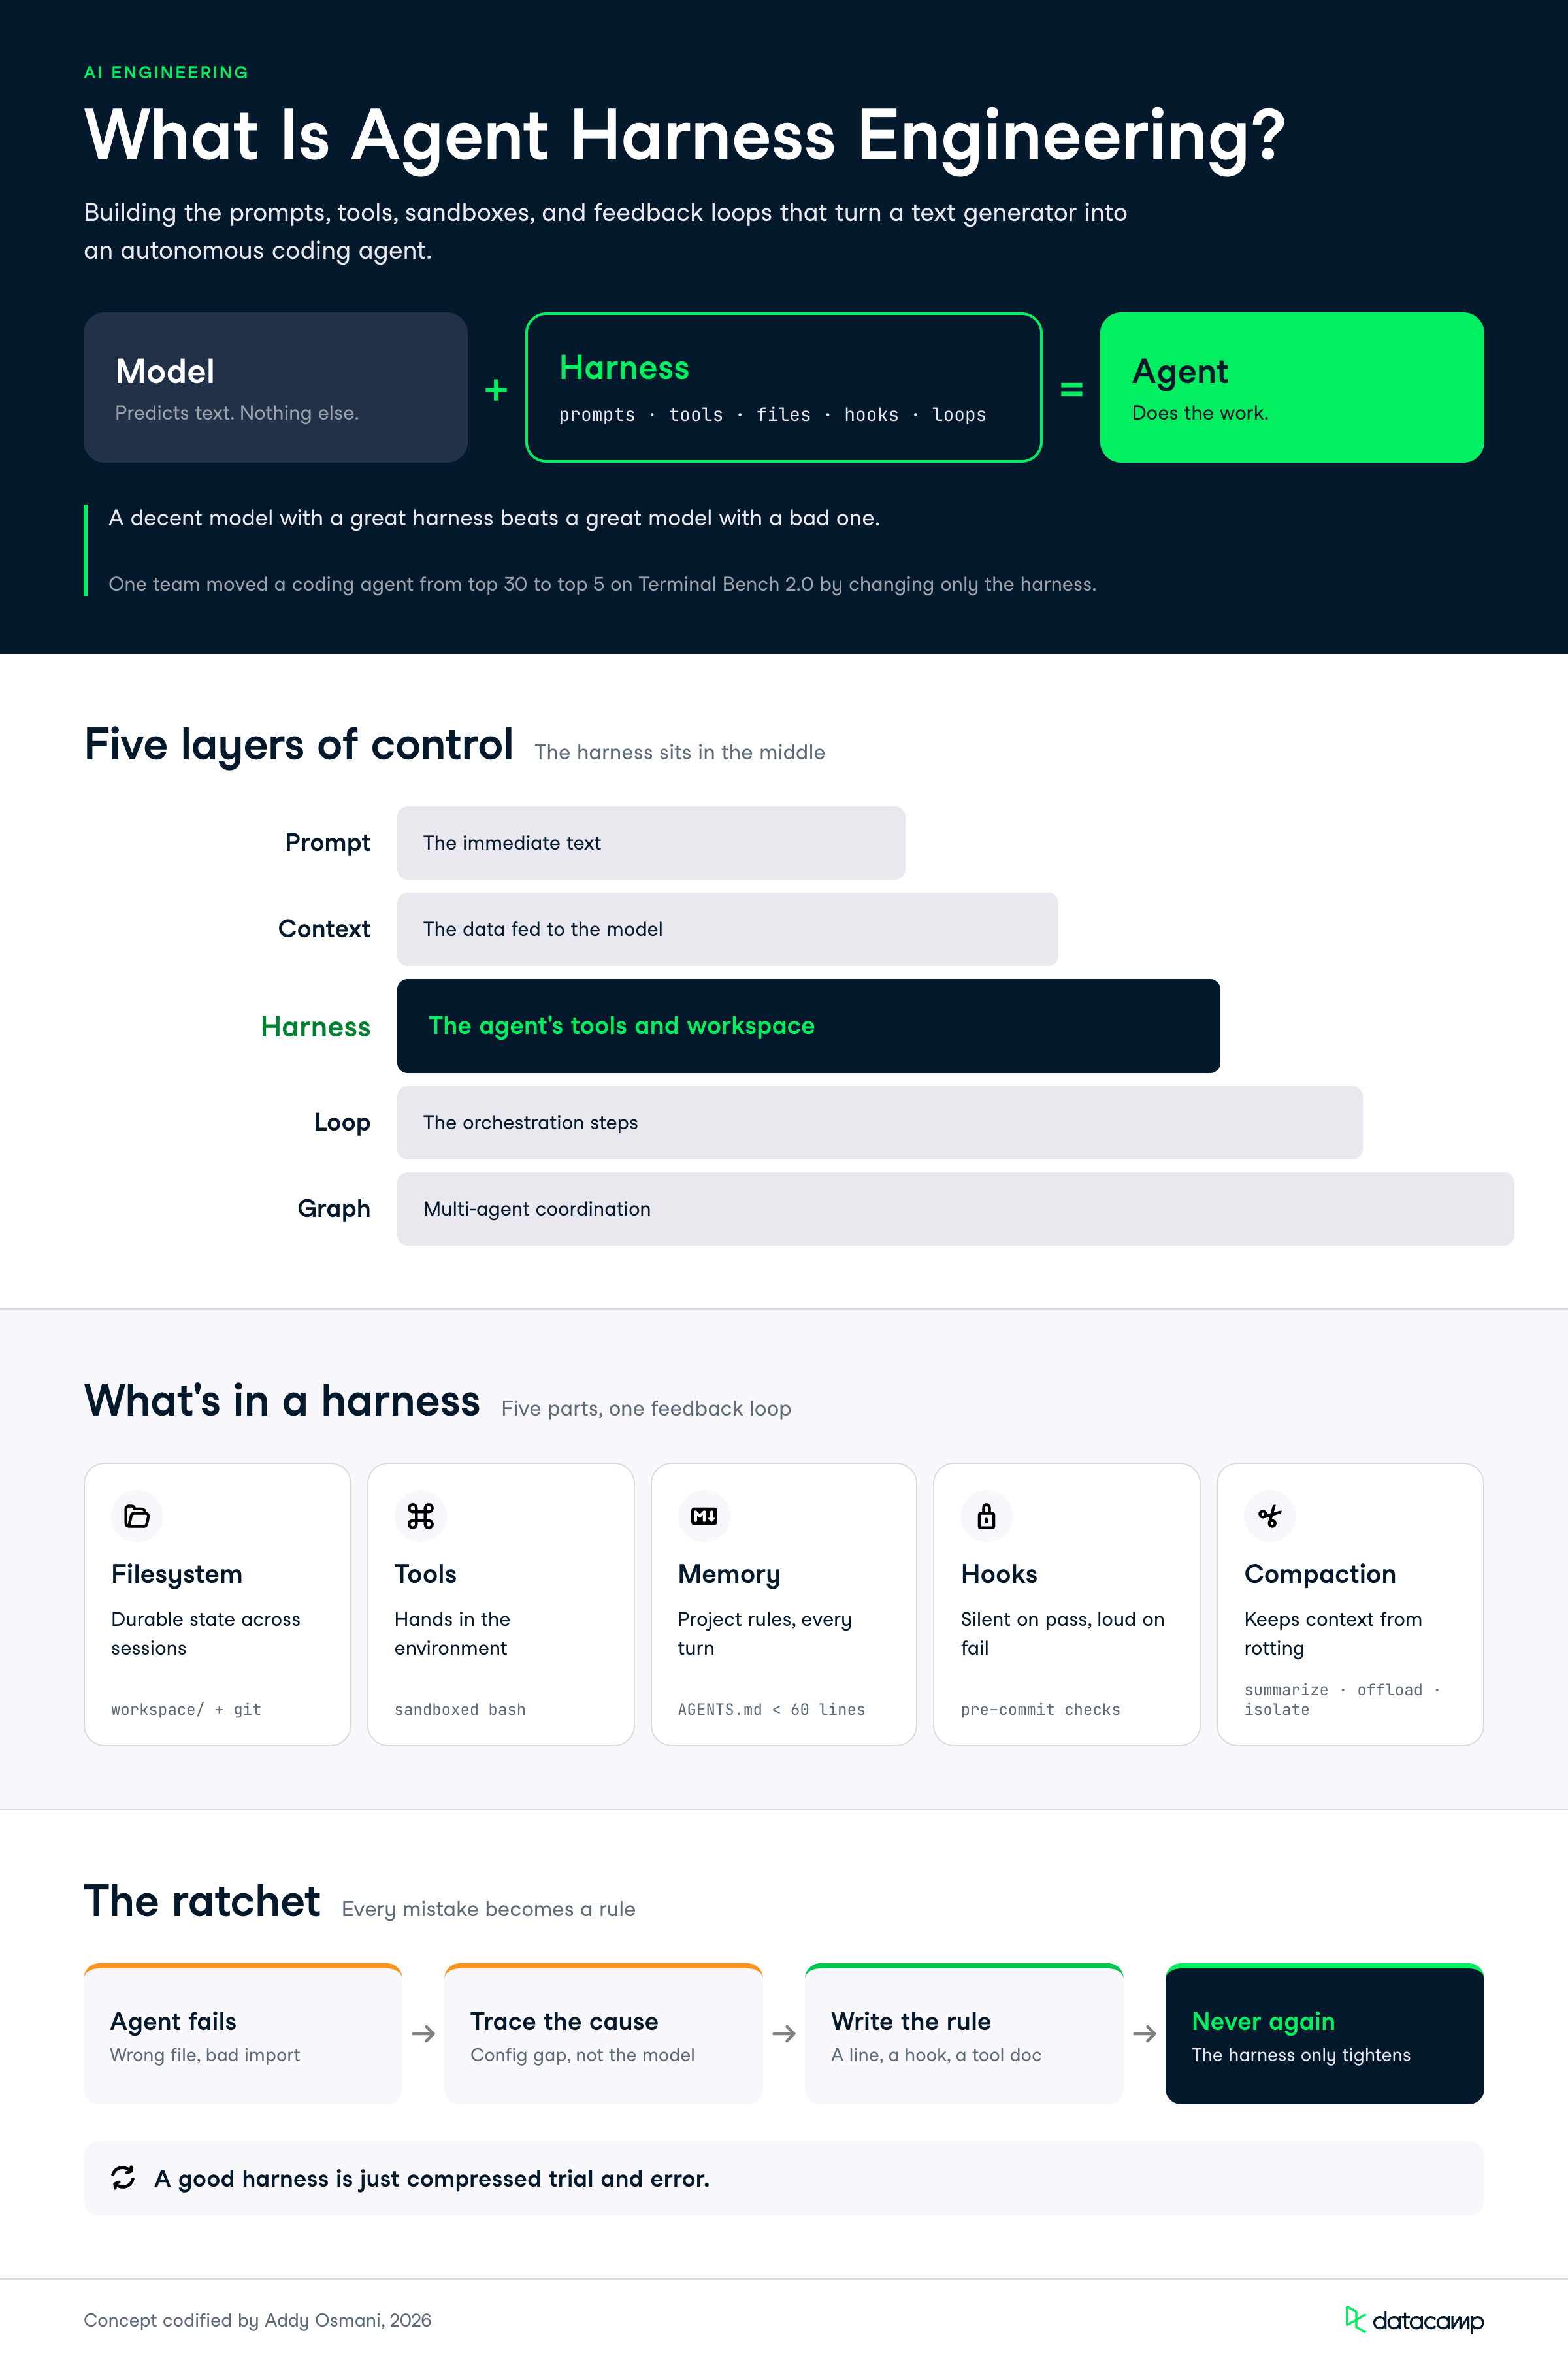
我们可以将 AI 开发拆分为不同的控制层级。
挂架工程恰好位于这套层级结构的中间。
|
层级 |
它控制什么 |
示例操作 |
|
提示词工程 |
即时文本 |
微调指令 |
|
上下文工程 |
馈送给模型的数据 |
调优 RAG 流水线 |
|
挂架工程 |
代理的“实体工具” |
添加一个 Bash 工具 |
|
循环工程 |
编排步骤 |
调整 ReAct 流程 |
|
图工程 |
多代理协同 |
构建路由节点 |
代理挂架工程的核心思维是“棘轮效应”。
当代理犯错时,您要工程化一个修复,让它永不重犯。一个好的挂架,本质上是将试错过程压缩进来。
与其放任代理反复出错,不如在您的 AGENTS.md 里加一行、写一个新钩子、或收紧某个工具描述。
您不再本能地去换新模型;而是不断累积语料,以便追踪具体失败,以及您如何对其加固。
AI 代理挂架的核心组件包括:文件系统、工具、记忆、钩子,以及让模型得以运作的上下文管理系统。
这些部分协同工作,将孤立的 API 调用转化为持续的反馈循环。在写代码之前,我想给您一张清晰的路线图。
|
组件 |
职责 |
Python 实现 |
|
文件系统 |
持久状态 |
本地 workspace/ 目录 |
|
工具 |
在环境中行动 |
Bash 的 Python 封装函数 |
|
记忆 |
项目上下文 |
一个 AGENTS.md 文件 |
|
钩子 |
约束与执行 |
Pre-commit 校验脚本 |
|
压缩 |
上下文管理 |
摘要逻辑 |
模型只能处理其有限上下文窗口内的信息。文件系统提供了一个稳定的工作区,用于读取数据、写入中间结果,并跨会话协同。
加入 Git 版本控制则提供必要的安全网。代理可以跟踪进度、为不同超参数的实验创建分支,并自动回滚损坏的代码。
ReAct 循环的运作是:先推理,再通过调用工具行动,然后观察结果。工具描述构成了模型与环境之间的直接接口。含糊的描述会带来含糊的行为。
Bash 是一个很好的通用工具。与其为每个可能的动作预先写一个特定 Python 函数,不如让 Bash 允许代理按需构造所需的精确命令。您必须仔细做沙箱隔离,以防止对系统造成损害。
AGENTS.md 与知识注入您的代理需要与项目相关的记忆来理解本地约定。AGENTS.md 文件是仓库根目录下的一个扁平 markdown 文档,每一轮都会进入系统提示。它定义了您的技术栈、格式规则与禁行操作。
将该文件控制在 60 行以内。把它当作飞行员清单,而不是全面的风格指南。您可以阅读完整的 AGENTS.md 教程了解更多示例。您也应考虑使用 Model Context Protocol(MCP)工具来提供截断日期(cutoff)之后的知识。
钩子是在特定生命周期节点运行的小脚本。
您可以在调用工具之前、文件编辑之后,或 Git 提交之前运行钩子。参阅这篇关于 Claude Code Hooks 的指南,了解更高级的钩子模式。
钩子的主要设计原则是:成功时保持安静,失败时尽量详尽。一次通过的类型检查不应输出任何内容。
失败则将精确的报错文本注入回代理循环中,以便其自我纠正。
所谓“上下文腐蚀”,是指当上下文窗口被冗长对话历史填满后,模型的指令遵循能力下降。稳健的 AI 代理脚手架必须主动管理这一点。阅读更多关于上下文窗口的内容以理解这些限制。
您可以通过总结旧消息来减少上下文。也可以将工具的大量输出落盘,只在提示中保留一个简短引用。
最后,您可以将耗费大量 token 的子任务隔离给一个拥有全新上下文的子代理。
构建 AI 代理挂架,涉及编写将 ReAct 循环、工具与钩子串联起来的 Python 编排代码。
在动手写代码前先理清关系:harness.py 就是代理,您像运行任何脚本一样,用 python harness.py 启动它。
模型是一个远程 API,它从不会看到这个文件;它只接收您的脚本发给它的系统提示、消息历史与工具模式。
本节中的每段代码都是同一个文件 harness.py 的一部分,前四节自上而下构建它。最后两节(钩子与压缩)是升级项;由于循环会在 Python 执行到它时立即运行,相关函数定义必须位于循环之上;每节会明确指出其代码应放置的位置。
为此,您需要在所选提供商处开通开发者账号。标准的消费型订阅(如 ChatGPT Plus 或 Claude Pro)并不提供 API 访问权限。
ANTHROPIC_API_KEY(或 OPENAI_API_KEY)。在本示例中,我们将使用 Anthropic,请通过 pip install anthropic 安装其 Python 包。
接着创建项目骨架。提前命名每个文件很重要:我们的循环会在启动时读取 AGENTS.md,因此该文件必须在循环运行前就已存在。
agent-harness/
├── AGENTS.md        # Project memory (we write this first)
├── harness.py       # The ReAct loop, tools, and hooks
└── workspace/       # The only directory the agent may touch
workspace/ 目录是代理的沙箱。代理的所有读写与执行都发生在其中,绝不会触及您的项目根目录。
我们先于循环编写 AGENTS.md,因为循环依赖它。
在项目根目录创建该文件,包含您的特定技术栈细节与架构边界:
# Project Context
Stack: Python 3.11, Pytest
Workspace: All commands run inside the workspace/ directory.

# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
我们的循环将“模型未请求工具而直接作答”视为任务完成信号,因此我们要明确让模型知晓如何发送完成信号。
这些引用您自身循环机制的规则,是挂架工程的关键。记忆文件与编排代码需协同设计。
现在开始编写 harness.py,先把该文件作为系统提示读入,并准备工作区:
import subprocess
from pathlib import Path

import anthropic

client = anthropic.Anthropic()

WORKSPACE = Path("workspace")
WORKSPACE.mkdir(exist_ok=True)

# Project memory: AGENTS.md lands in the system prompt on every turn
system_prompt = Path("AGENTS.md").read_text()
由于 SDK 每次 API 调用都会发送 system_prompt,AGENTS.md 中的规则将在每一轮被重新注入。模型不会像在对话中途那样“遗忘”它们。
我们定义两个工具:用于通用执行的 run_bash,以及用于创建文件的 write_file。
第二个工具看起来或许多余,因为 Bash 也能用 heredoc 写文件,但专用的 write_file 能提供一个干净的“编辑完成”事件,便于稍后我们的后置编辑钩子绑定。
这类挂架设计决策,总是围绕您希望观察和强制执行什么而展开。
工具描述是接口,其质量将直接决定代理行为:
继续在我们的 harness.py 文件中,在下一行定义工具模式:
TOOLS = [
    {
        "name": "run_bash",
        "description": (
            "Run a bash command inside the workspace/ directory and return "
            "its stdout, stderr, and exit code. Use it to list files, run "
            "scripts, and run tests. Do not use it to create Python files; "
            "use write_file instead."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "The bash command to run."}
            },
            "required": ["command"],
        },
    },
    {
        "name": "write_file",
        "description": (
            "Create or overwrite a file inside the workspace/ directory. "
            "Provide a path relative to workspace/ and the full file content."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "Path relative to workspace/."},
                "content": {"type": "string", "description": "Full file content."},
            },
            "required": ["path", "content"],
        },
    },
]
接下来这一块定义了实际执行这些命令的 Python 函数。
注意已内置的安全特性:硬性超时,避免卡死命令阻塞挂架;在每个结果中包含退出码,方便代理区分成功与失败;以及路径检查,防止 write_file() 逃离沙箱。
def run_bash(command: str) -> str:
    result = subprocess.run(
        command,
        shell=True,
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=60,
    )
    output = (result.stdout + result.stderr).strip()
    return f"exit code: {result.returncode}\n{output or '(no output)'}"


def write_file(path: str, content: str) -> str:
    target = (WORKSPACE / path).resolve()
    if WORKSPACE.resolve() not in target.parents:
        return "Error: path escapes the workspace/ directory."
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_text(content)
    return f"Wrote {len(content)} characters to {path}."


TOOL_EXECUTORS = {"run_bash": run_bash, "write_file": write_file}
or '(no output)' 这一兜底并非装饰性。
像 touch data.csv 这样的命令会静默成功,若返回空字符串,模型将无从观察。
即便是“沉默”,也要给代理一个明确信号。
我们挂架的核心,是一个带迭代上限的标准 Python for 循环。
每一轮都会调用 API,检查模型是否请求了工具,执行该轮内所有工具调用,并将结果作为单条消息反馈回去。
这一块位于 harness.py 的底部,因为 Python 执行到此处时循环就会启动。
	messages = [
	    {
	        "role": "user",
	        "content": "Create a fizzbuzz.py script in the workspace, "
	                   "then run it to verify the output.",
	    }
	]

	MAX_STEPS = 15

	for step in range(MAX_STEPS):
	    print(f"--- Iteration {step + 1} ---")

	    response = client.messages.create(
	        model="claude-sonnet-5",
	        max_tokens=2000,
	        system=system_prompt,
	        messages=messages,
	        tools=TOOLS,
	    )

	    # Append the model's turn to the history
	    messages.append({"role": "assistant", "content": response.content})

	    # Stop condition: the model answered without requesting a tool
	    if response.stop_reason != "tool_use":
	        final_text = "".join(b.text for b in response.content if b.type == "text")
	        print(f"Task complete: {final_text}")
	        break

	    # Execute EVERY tool call in this turn, collecting the results
	    tool_results = []
	    for block in response.content:
	        if block.type != "tool_use":
	            continue
	        print(f"Agent calling {block.name}: {block.input}")
	        output = TOOL_EXECUTORS[block.name](**block.input)
	        tool_results.append(
	            {"type": "tool_result", "tool_use_id": block.id, "content": output}
	        )

	    # All tool results for one assistant turn go back in ONE user message
	    messages.append({"role": "user", "content": tool_results})
	else:
	    print("Stopped: hit the maximum iteration cap without finishing.")
该循环中的两个细节,可避免真实崩溃。
第一,单次模型回复可能包含多个工具调用,且 Anthropic API 要求这些调用的所有结果需打包成一条 user 消息返回。
第二,for/else 结构会在代理触发迭代上限时报告,使停滞的运行能高声失败,而不是静默终止。
这种明确的结构,让您能清楚看到模型停止思考的位置、Python 何时接手执行命令,以及输出如何反馈回循环。
钩子能在错误演变为更大结构性问题之前将其拦下。
在我们的挂架中,钩子是一个函数,用于检查一次完成的工具调用,并返回要追加到该工具结果后的额外文本。
成功返回空字符串;失败返回详细报告。
将此函数添加到 harness.py 中 ReAct 循环之上,紧邻工具执行器。循环会在 Python 执行到它时立即启动,因此它调用的一切都必须已定义好。
def post_edit_hook(tool_name: str, tool_input: dict) -> str:
    """Run pytest after any edit to a Python file. Silent on success."""
    edited_python = (
        tool_name == "write_file" and tool_input.get("path", "").endswith(".py")
    )
    if not edited_python:
        return ""

    tests = subprocess.run(
        ["pytest", "--tb=short", "-q"],
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=120,
    )
    # Exit code 5 means "no tests collected", which is fine for our purposes
    if tests.returncode in (0, 5):
        return ""
    return f"\n\n[HOOK] pytest failed after this edit:\n{tests.stdout}"
在循环的工具执行块内,仅需一行即可连线:
output = TOOL_EXECUTORS[block.name](**block.input)
output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
没有钩子时,代理写入了一个有问题的文件,只会看到 Wrote 412 characters to fizzbuzz.py,然后自信地继续前行。
有了钩子,同一工具结果会携带精确的 pytest 回溯。下一轮时,代理读到错误,便会自行修复,无需额外提示。
为对抗上下文腐蚀,请监控 messages 列表的长度,并在其过长时对最早的几轮做摘要。
有一个陷阱:您不能在任意位置切断历史,因为 assistant 的 tool_use 块与其配对的 tool_result 消息必须成对保留。拆散二者会立即引发 API 错误。
我们的压缩函数会向前移动切分点,直到落在一个安全边界。将其构建在 harness.py 的循环之上:
COMPACTION_THRESHOLD = 20
KEEP_RECENT = 6


def is_tool_result(message: dict) -> bool:
    return (
        message["role"] == "user"
        and isinstance(message["content"], list)
        and any(
            isinstance(b, dict) and b.get("type") == "tool_result"
            for b in message["content"]
        )
    )


def compact(messages: list) -> list:
    if len(messages) <= COMPACTION_THRESHOLD:
        return messages

    # Never orphan a tool_result from its tool_use: slide the cut forward
    cut = len(messages) - KEEP_RECENT
    while cut < len(messages) and is_tool_result(messages[cut]):
        cut += 1

    old, recent = messages[1:cut], messages[cut:]
    transcript = "\n".join(f"{m['role']}: {str(m['content'])[:500]}" for m in old)

    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=500,
        messages=[{
            "role": "user",
            "content": "Summarize this agent transcript. Preserve the task, "
                       "decisions made, files created, and any unresolved "
                       f"errors:\n\n{transcript}",
        }],
    )

    return [
        messages[0],  # always keep the original task verbatim
        {
            "role": "user",
            "content": f"[Earlier progress, summarized by the harness]\n"
                       f"{summary.content[0].text}",
        },
        *recent,
    ]
在 ReAct 循环顶部、API 调用之前添加一行:
messages = compact(messages)我们使用更小、更便宜的模型来做摘要,因为压缩经常运行,需要更快的速度。
我们也会逐字保留最初的任务消息,而不是依赖摘要去完整保留它。
至此,挂架已经完成。
继续之前,请检查您的 harness.py 自上而下的顺序是否如下:
client、WORKSPACE 与 system_promptTOOLS 模式列表run_bash()、write_file() 与 TOOL_EXECUTORSpost_edit_hook()COMPACTION_THRESHOLD、KEEP_RECENT、is_tool_result() 与 compact()为便于您了解在加入钩子与压缩部分后最终的 API 循环应是什么样子,下面给出完整版本:
messages = [
    {
        "role": "user",
        "content": "Create a fizzbuzz.py script in the workspace, "
                   "then run it to verify the output.",
    }
]

MAX_STEPS = 15

for step in range(MAX_STEPS):
    print(f"--- Iteration {step + 1} ---")

    # Compaction: summarize old turns before they rot the context
    messages = compact(messages)

    # The API call: model, memory, history, and tools travel together
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=2000,
        system=system_prompt,   # AGENTS.md text, re-injected every turn
        messages=messages,      # the full (possibly compacted) history
        tools=TOOLS,            # the schemas from the tools section
    )

    # Append the model's turn to the history
    messages.append({"role": "assistant", "content": response.content})

    # Stop condition: the model answered without requesting a tool
    if response.stop_reason != "tool_use":
        final_text = "".join(b.text for b in response.content if b.type == "text")
        print(f"Task complete: {final_text}")
        break

    # Execute EVERY tool call in this turn, collecting the results
    tool_results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        print(f"Agent calling {block.name}: {block.input}")
        output = TOOL_EXECUTORS[block.name](**block.input)
        output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
        tool_results.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": output}
        )

    # All tool results for one assistant turn go back in ONE user message
    messages.append({"role": "user", "content": tool_results})
else:
print("Stopped: hit the maximum iteration cap without finishing.")现在在项目根目录运行代理:python harness.py。
脚本会将 messages 列表中的任务发送给 API。
挂架会完成工作,您应能在终端看到每次迭代的打印:
--- Iteration 1 ---
Agent calling write_file: {'path': 'fizzbuzz.py', 'content': 'def fizz(n):...'}
--- Iteration 2 ---
Agent calling run_bash: {'command': 'python fizzbuzz.py'}
--- Iteration 3 ---
Task complete: fizzbuzz.py is written and prints the correct sequence.
当模型在未请求工具的情况下作答,或当 15 次迭代上限被触发时,程序会退出。
要给代理换个任务,请修改初始 messages 列表中的 content 字符串;生产级挂架则会通过 input() 或命令行参数读取它。
所谓“棘轮”,就是不断诊断代理失败,并更新挂架以防再犯的过程。
挂架只能通过真实世界的边缘案例来稳步精进。
让我们基于一个真实的路径优化项目,完整走一遍失败与修复的周期。
设想您的代理总是导入已弃用的内部路由库 legacy_route_math,而不是新版。
代理写好脚本后,测试失败,但它陷入循环,试图修语法错误而不是更换库。
诊断其实很直白。
代理只是“不知道”这个库已被弃用。这是缺少规则,而不是底层神经网络的失败。
修复 1 更新记忆层,在 AGENTS.md 中添加这条规则:
# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
4. Do not import legacy_route_math; it is deprecated. Use routes_v2 instead.
修复 2 增加一个永久性的执行钩子。
规则是给代理的建议,钩子则是命令。此修复仅需几行,放在 post_edit_hook() 附近即可,但必须位于 ReAct 循环之前。
def deprecated_import_hook(tool_name: str, tool_input: dict) -> str:
    if tool_name != "write_file":
        return ""
    if "import legacy_route_math" in tool_input.get("content", ""):
        return (
            "\n\n[HOOK] Blocked pattern: legacy_route_math is deprecated. "
            "Rewrite this file using routes_v2 instead."
        )
    return ""
在工具执行块中,与 pytest 钩子并列注册它:
output += post_edit_hook(block.name, block.input)
output += deprecated_import_hook(block.name, block.input)
以下是两项修复落地后,转录日志中“自我纠正”的样子。
代理写入文件,钩子触发,紧接着的下一轮就会在无人干预的情况下修正导入:
--- Iteration 3 ---
Agent calling write_file: {'path': 'optimizer.py', ...}
  [HOOK] Blocked pattern: legacy_route_math is deprecated...
--- Iteration 4 ---
Agent calling write_file: {'path': 'optimizer.py', ...}   # now imports routes_v2
--- Iteration 5 ---
Task complete: Rewrote optimizer.py using routes_v2 and verified the tests pass.
这很重要,因为它与上下文腐蚀相呼应。超长会话下,上下文退化最终会忽视记忆规则。
AGENTS.md 规则能在大多数情况下防止错误;而钩子则保证当规则失效时,错误也不会造成损害。
每次您诊断失败,都应自问两件事:缺了哪条规则?又有什么检查本该能把它拦下?
代理挂架工程的最佳实践,聚焦于保持配置精简,并为未来的模型升级而设计。
目标是构建能支撑模型、而不至于让它不堪重负的脚手架。
在构建各种 代理技能与架构时,我也踩过不少坑。
将上下文文件控制在最多 60 行。
每一条规则都必须可追溯到您经历过的一次真实且有记录的失败。如果您想不起对应的事故,这条规则也许就该删掉。
这份“自律”很重要,因为 AGENTS.md 每一轮都要“付费”。
一份 300 行的风格指南不仅让每次 API 调用都花费更多 token,还会稀释真正重要的规则;模型对 10 条锋利的规则的执行力,远胜于 80 条含混不清的规则。
添加日期戳也有助于我接下来推荐的实践。
随着基础模型的原生能力不断提升,挂架需要持续重构。
以便于随时“拆卸”为目标来构建组件。
本教程的钩子模式刻意保持模块化,正是出于这个原因。
每个钩子都是一个独立函数,只需在循环里加一行就能启用。若将其弃用,只需在循环处删掉这一行。
循环中的其他内容无需改动。
与之相对的是,将校验逻辑直接编织进 ReAct 循环;一旦要移除一个陈旧检查,就意味着要重测整条编排路径。
今天看似必要的拐杖,下个季度可能就成了不必要的负担。
每当新模型发布,请在逐个禁用钩子的前提下,重跑过去的失败案例;对那些已不再捕获问题的钩子,将其视为删除候选。
更多架构建议,参阅Claude Code 最佳实践。
一个带文件系统与单个 Bash 工具的“裸” ReAct 循环,已经非常实用。
克制住用重量级框架预先构建复杂图系统的冲动。棘轮只按一个方向运转:从观察到的失败,走向有针对性的修复。臆测式修复则本末倒置。
只有当您确实见过相应失败后,才添加自定义钩子。关于如何组织基础系统,可参阅此指南:LLM 代理。
看不见,就无法“棘轮”。
我们的循环已经打印了每个工具调用,这是最低可行的可观测性:当一次运行失败时,打印的转录就是您的诊断材料。
随着挂架走向成熟,请在运行结束时,将本次会话的完整消息历史写入一个带时间戳的 JSON 文件。
失败的转录会成为您的回归测试集;每次挂架改动后,重放旧的失败任务,确认修复依然有效。
这相当于挂架工程师的测试套件,它将“不断改进”的挂架与“只是改变”的挂架区分开来。
代理挂架工程,是让 AI 模型产出有用工作的现实途径。
当今模型“理论上能做到的”和您在生产中“实际看到它做到的”之间的差距,很大程度上就是挂架的差距。
这一学科并不是去学某个特定框架。
适合您代码库的 AI 代理挂架,完全由您独特的失败史塑造,并通过“棘轮法”渐进构建。
准备好把这些概念付诸实践了吗?
请查看 DataCamp 的AI Agent Fundamentals 技能路径,继续构建面向生产的系统。您也可以参考Claude Agent SDK 教程,获取更多上手代码示例。
您可能也想看看AI for Software Engineering 技能路径。
热门 DataCamp 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续