

t-SNE 与 PCA
t-SNE 和 PCA 都是降维技术,但机制不同,适用于不同类型的数据。
PCA(主成分分析)是一种线性技术,最适用于具有线性结构的数据。它通过将数据投影到低维空间来识别潜在的主成分,目标是最小化信息损失、保留大的成对距离与总体方差。阅读我们的 主成分分析(PCA) 教程,结合 R 示例理解算法的内部机制。
而 t-SNE 是一种非线性技术,侧重在低维空间中保留数据点之间的成对相似性。t-SNE 更关注保留较小的成对距离;相对地,PCA 着重保持较大的成对距离以最大化方差。
总之,PCA 保留的是数据的方差;而 t-SNE 保留的是数据点之间在低维空间中的关系,因此非常适合可视化复杂的高维数据。
下表可帮助您将 t-SNE 与 PCA 进行对照比较:
| 特性 | t-SNE | PCA |
|---|---|---|
| 类型 | 非线性降维 | 线性降维 |
| 目标 | 保留局部成对相似性 | 保留全局方差 |
| 最佳用途 | 可视化复杂、高维数据 | 具有线性结构的数据 |
| 输出 | 低维表示 | 主成分 |
| 应用场景 | 聚类、异常检测、NLP | 降噪、特征提取 |
| 计算强度 | 高 | 低 |
| 可解释性 | 较难解释 | 较易解释 |
t-SNE 的工作原理
t-SNE 在高维与低维空间中分别度量样本对之间的相似性,随后优化这两种相似性度量。整个过程分三步完成。
- t-SNE 在高维与低维空间中,建模某个点被选为另一点邻居的概率。首先在高维空间中使用高斯核计算所有数据点的成对相似性。相距较远的点被选中的概率更低,靠得近的点被选中的概率更高。
- 算法接着尝试将高维数据点映射到低维空间,同时尽量保留成对相似性。
- 通过最小化高维与低维概率分布之间的散度来实现这一点。算法使用梯度下降来最小化散度,并将低维嵌入优化到稳定状态。
优化过程会在低维空间中形成相似数据点的簇与子簇,并据此可视化,以帮助理解高维数据中的结构与关系。
t-SNE 的 Python 示例
在该 Python 示例中,我们将生成分类数据,执行 PCA 与 t-SNE,并可视化结果。我们将使用 scikit-learn 进行降维,并使用 Plotly Express 进行可视化。
生成分类数据集
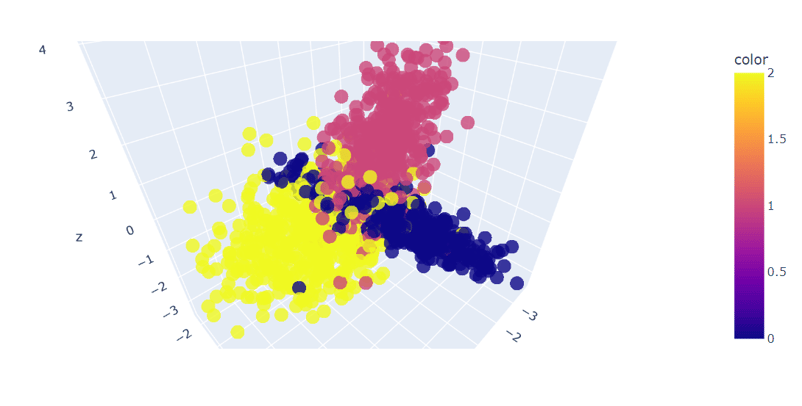
我们将使用 scikit-learn 的 make_classification() 函数生成包含 6 个特征、1500 条样本、3 个类别的合成数据。
随后,我们将使用 Plotly Express 的 scatter_3d() 函数对前三个特征进行 3D 绘图。
import plotly.express as px
from sklearn.datasets import make_classification
X, y = make_classification(
n_features=6,
n_classes=3,
n_samples=1500,
n_informative=2,
random_state=5,
n_clusters_per_class=1,
)
fig = px.scatter_3d(x=X[:, 0], y=X[:, 1], z=X[:, 2], color=y, opacity=0.8)
fig.show()我们已经得到数据的 3D 图;您也可以使用 Plotly Express 的 scatter() 函数在 2D 图中进行可视化。
PCA 的拟合与变换
现在我们将在数据集上应用 PCA 算法,返回两个主成分。fit_transform() 会同时学习并变换数据集。
from sklearn.decomposition import PCA
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)Python 中的 t-SNE 可视化
现在我们通过散点图显示两个 PCA 分量来可视化结果。
- x:第一主成分
- y:第二主成分
- color:目标变量
我们还使用了 update_layout() 函数来添加标题并重命名 x 轴与 y 轴。
fig = px.scatter(x=X_pca[:, 0], y=X_pca[:, 1], color=y)
fig.update_layout(
title="PCA visualization of Custom Classification dataset",
xaxis_title="First Principal Component",
yaxis_title="Second Principal Component",
)
fig.show()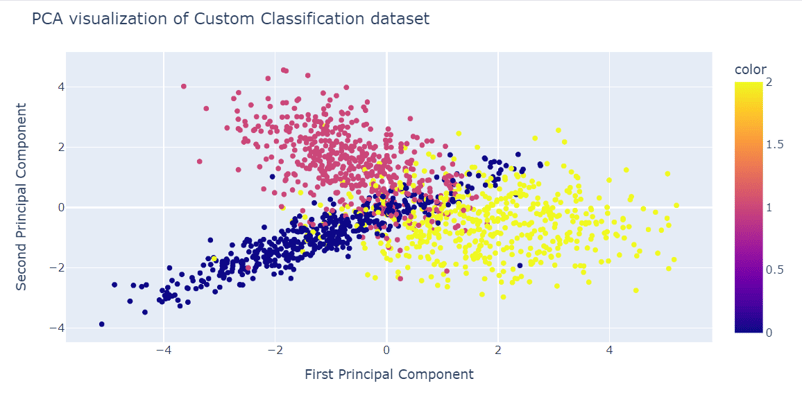
t-SNE 的拟合与变换
现在,我们将在数据集上应用 t-SNE 算法并比较结果。
在拟合并变换数据后,我们将输出高维与低维概率分布之间的 Kullback-Leibler(KL)散度。较低的 KL 散度通常意味着更好的结果。
from sklearn.manifold import TSNE
tsne = TSNE(n_components=2, random_state=42)
X_tsne = tsne.fit_transform(X)
tsne.kl_divergence_1.1169137954711914Python 中的 t-SNE 可视化
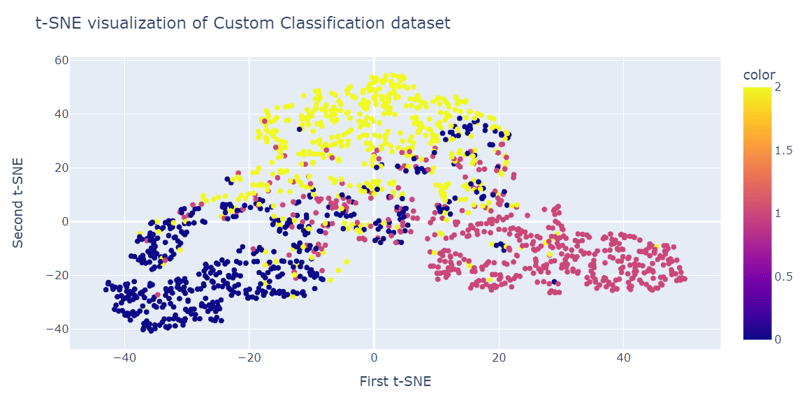
与 PCA 类似,我们将通过散点图可视化两个 t-SNE 分量。
fig = px.scatter(x=X_tsne[:, 0], y=X_tsne[:, 1], color=y)
fig.update_layout(
title="t-SNE visualization of Custom Classification dataset",
xaxis_title="First t-SNE",
yaxis_title="Second t-SNE",
)
fig.show()结果明显优于 PCA。我们可以清晰地看到三个大的簇。
在客户流失数据集上应用 t-SNE
本节中,我们将使用一家伊朗电信公司的 客户流失 数据集。该数据集包含客户活动的信息,如通话失败次数与订阅时长,以及是否流失的标签。
流失指在特定时间段内停止使用某项服务的客户比例。
注意:两部分示例的代码与数据集均可在 此 DataLab 工作簿中获取;如果您想调整并运行代码,只需复制一份,即可上手!
导入客户流失数据集
我们将使用 pandas 加载数据集,并显示前三行。
import pandas as pd
df = pd.read_csv("data/customer_churn.csv")
df.head(3)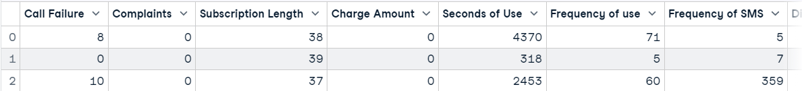
PCA 降维
之后我们将:
- 使用 Churn 列创建特征(X)与目标(y)。
- 使用标准化器对特征进行归一化。
- 将数据集划分为训练集与测试集。
- 对训练数据集应用 PCA。
- 使用测试数据集获取分数。该分数表示所有样本的平均对数似然。
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
X = df.drop('Churn', axis=1)
y = df['Churn']
scaler = StandardScaler()
X_norm = scaler.fit_transform(X)
X_train, X_test, y_train, y_test = train_test_split(
X_norm, y, random_state=13, test_size=0.25, shuffle=True
)
pca = PCA(n_components=2)
X_train_pca = pca.fit_transform(X_train)
pca.score(X_test)-17.04482851288105可视化 PCA 结果
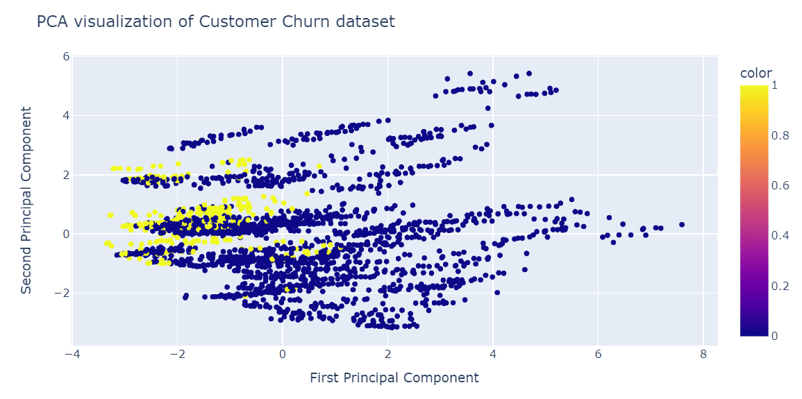
现在我们将使用 Plotly Express 的散点图来可视化 PCA 结果。
fig = px.scatter(x=X_train_pca[:, 0], y=X_train_pca[:, 1], color=y_train)
fig.update_layout(
title="PCA visualization of Customer Churn dataset",
xaxis_title="First Principal Component",
yaxis_title="Second Principal Component",
)
fig.show()PCA 在形成聚类方面表现一般。低维数据看起来较为随机。这也可能意味着数据集中的特征高度偏态,或缺乏强相关结构。
检验困惑度与散度
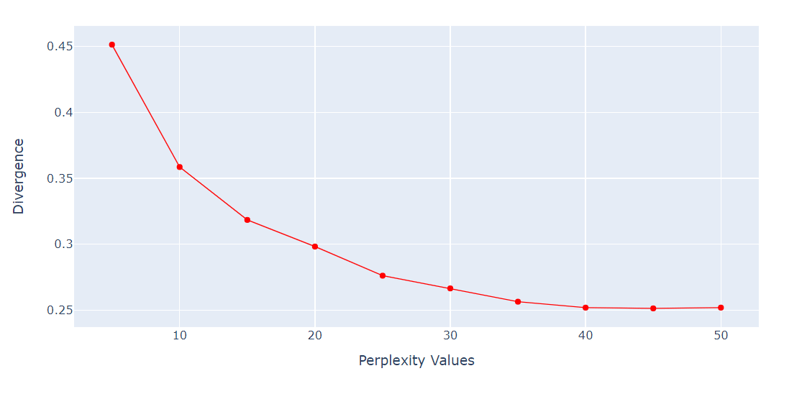
困惑度(perplexity)是 t-SNE 的一个重要超参数。它控制在降维过程中每个点所考虑的有效邻居数量。
我们将运行一个循环,在困惑度从 5 到 55(步长为 5)的范围内获取 KL 散度指标。然后使用 Plotly Express 折线图展示结果。
import numpy as np
perplexity = np.arange(5, 55, 5)
divergence = []
for i in perplexity:
model = TSNE(n_components=2, init="pca", perplexity=i)
reduced = model.fit_transform(X_train)
divergence.append(model.kl_divergence_)
fig = px.line(x=perplexity, y=divergence, markers=True)
fig.update_layout(xaxis_title="Perplexity Values", yaxis_title="Divergence")
fig.update_traces(line_color="red", line_width=1)
fig.show()在困惑度为 40 之后,KL 散度趋于稳定。因此,我们将在 t-SNE 算法中使用 40 的困惑度。
t-SNE 降维
现在我们将拟合 t-SNE,并使用困惑度 40 将数据映射到低维,以获得更低的 KL 散度。
from sklearn.manifold import TSNE
tsne = TSNE(n_components=2,perplexity=40, random_state=42)
X_train_tsne = tsne.fit_transform(X_train)
tsne.kl_divergence_0.258713960647583可视化 t-SNE
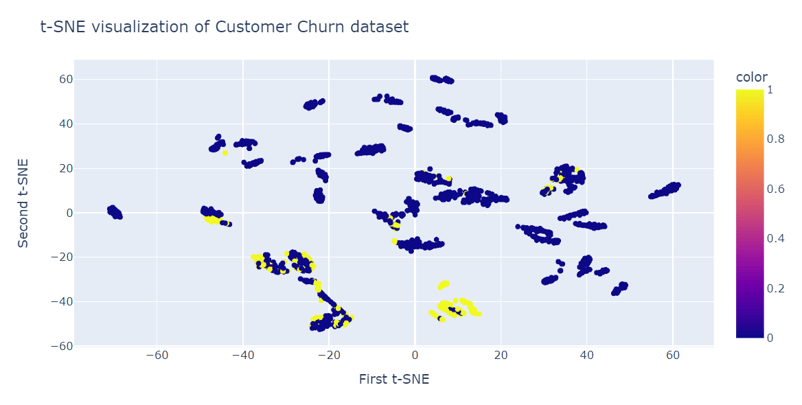
我们将使用 Plotly 的散点图展示分量与目标类别。
fig = px.scatter(x=X_train_tsne[:, 0], y=X_train_tsne[:, 1], color=y_train)
fig.update_layout(
title="t-SNE visualization of Customer Churn dataset",
xaxis_title="First t-SNE",
yaxis_title="Second t-SNE",
)
fig.show()如您所见,图中存在多个簇与子簇。我们可以利用这些信息理解模式,并制定留存现有客户的策略。
t-SNE 的局限与挑战
尽管 t-SNE 是强大的高维数据可视化工具,但也存在一些局限:
- 计算成本:t-SNE 的计算开销较大,尤其在处理大型数据集时。其成对相似性计算会随着数据规模增长而迅速膨胀,不太适合拥有数百万点的数据集。
- 对超参数敏感:t-SNE 的性能高度依赖困惑度与学习率等超参数。寻找最优取值通常需要反复试验,较为耗时。
- 可解释性不足:t-SNE 的嵌入结果通常具有非确定性(由于随机初始化与梯度下降),且与原始高维数据之间缺乏直接、可解释的关系。
- 不适合样本外数据:t-SNE 无法在不重新计算嵌入的情况下泛化到新的未见数据,这对于动态数据集来说效率不高。
t-SNE vs. UMAP:对比
近年来,UMAP(统一流形近似与投影)成为 t-SNE 的热门替代方案。二者同为用于可视化的非线性降维技术,但 UMAP 在一定程度上解决了 t-SNE 的一些限制:
- UMAP 比 t-SNE 更快、更省内存,更适合大型数据集。
- UMAP 更擅长同时保留数据的局部与全局结构,而 t-SNE 主要关注保留局部成对相似性。
- UMAP 需要调参的超参数更少,且结果在不同运行间通常更为稳定。
- 与 t-SNE 不同,UMAP 支持对新数据点进行变换,更适用于动态数据集。
计算复杂度:t-SNE vs. UMAP vs. PCA
下表总结了 t-SNE 与 UMAP、PCA 的计算复杂度:
| 技术 | 计算复杂度 | 特性 | 对大型数据集的适用性 |
|---|---|---|---|
| t-SNE | O(N2) | 保留局部结构,高度可定制 | 中等(大数据集较慢) |
| UMAP | O(N log N) | 兼顾局部与全局结构,更快 | 高(高效处理大数据集) |
| PCA | O(Nd2) | 线性降维,可解释的分量 | 高(非常高效) |
- N:数据点数量
- d:数据中的特征数
总之,t-SNE 能细致刻画局部关系,但在现代数据集上,UMAP 往往更高效、更可扩展。对于线性数据,PCA 仍是快速且可解释的选择。根据数据集与目标的不同,选择合适技术需要在可解释性、计算成本与数据特性之间权衡。
t-SNE 的应用
除了用于复杂多维数据的可视化外,t-SNE 还有其他用途:
- 聚类与分类:在低维空间中将相似数据点聚在一起。它也可用于分类与发现数据中的模式。
- 异常检测:识别数据中的离群点与异常。
- 自然语言处理:可视化由大型语料生成的词向量,更易识别词语之间的相似性与关系。
- 计算机安全:可视化网络流量模式并检测异常。
- 癌症研究:可视化肿瘤样本的分子谱,识别癌症亚型。
- 地质领域解释:可视化地震属性并识别地质异常。
- 生物医学信号处理:可视化脑电图(EEG)并检测脑活动模式。
结语
t-SNE 是一种强大的可视化工具,能够揭示复杂数据集中隐藏的模式与结构。您可以将其用于图像、音频、生物及单值数据的异常与模式识别。
在本文中,我们学习了 t-SNE 这一常用的降维技术,它可以将高维的非线性数据可视化到低维空间。我们解释了 t-SNE 的核心思想、工作原理与应用,并展示了如何将 t-SNE 应用于合成与真实数据集以及如何解读结果。
t-SNE 属于无监督学习。接下来合乎逻辑的学习方向包括层次聚类、PCA、去相关以及发掘可解释特征。通过参加我们的 Python 无监督学习 课程学习以上全部主题。
FAQs
t-SNE 能用于大型数据集吗?有哪些限制?
由于计算复杂度与内存占用较高,t-SNE 在处理超大型数据集时可能表现不佳。通常建议在数据子集上使用 t-SNE,或在大数据集场景下考虑 UMAP 等替代方案。
困惑度的选择如何影响 t-SNE 的结果?
困惑度是 t-SNE 的关键超参数,影响保留局部与全局结构的平衡。较低的困惑度强调局部关系,较高的困惑度则更能捕捉整体结构。通常需要通过试验不同取值来为您的数据找到最优设置。
除困惑度外,t-SNE 还有哪些超参数需要调优?
除了困惑度,您还应考虑学习率与迭代次数。学习率影响算法收敛速度,迭代次数决定优化过程的持续时间。
t-SNE 如何处理数据中的噪声?
t-SNE 在尝试保留成对相似性时会对噪声较为敏感,噪声特征可能会扭曲该相似性。进行特征选择或去噪等预处理可帮助改进 t-SNE 的结果。
t-SNE 的结果能用于定量分析(如聚类)吗?
t-SNE 主要用于可视化,不适合进行定量分析或聚类,因为它并不能保留真实距离或密度。对于聚类,建议在原始高维数据上使用 K-means 或 DBSCAN 等技术。
如何提升 t-SNE 图的可解释性?
为增强可解释性,您可以用已知类别为数据点添加标签、使用交互式图表,或叠加簇边界与质心等附加信息。
t-SNE 在性能与结果方面与 UMAP 相比如何?
UMAP 通常比 t-SNE 更快,且能在更大数据集上获得相近或更优的嵌入效果。与 t-SNE 相比,UMAP 往往能够更好地保留数据的全局结构。
t-SNE 能集成到实时数据可视化流水线中吗?
由于计算密集型特征,t-SNE 通常不适用于实时可视化。不过,如果数据集规模可控且更新不频繁,结合优化与采样仍有一定可行性。
应如何解读 t-SNE 图中形成的簇?
t-SNE 图中的簇表示在原始高维空间中具有高度相似性的数据点群。然而,不应过度解读 t-SNE 图中的具体距离与形状,它们与原始空间中的含义并不等同。
是否有 t-SNE 尤其受益的特定应用?
t-SNE 在探索性数据分析中尤为有用,例如可视化基因表达谱、图像数据或词向量,在这些场景中理解局部结构与关系至关重要。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
在本教程中,我们将深入了解 t-SNE 的工作原理,这是一种用于降维和数据可视化的强大技术。我们会将其与另一种常用技术 PCA 进行比较,并演示如何在合成与真实数据集上,使用 scikit-learn 和 plotly express 分别执行 t-SNE 与 PCA。
什么是 t-SNE?
t-SNE(t-distributed Stochastic Neighbor Embedding,t 分布随机邻域嵌入)是一种无监督的非线性降维技术,用于数据探索与高维数据可视化。非线性降维意味着该算法可以分离无法用直线分开的数据。
t-SNE 能帮助您直观把握数据在高维空间中的分布方式。它常用于将复杂数据集可视化到二维或三维,从而帮助我们理解数据中的潜在模式与关系。
参加我们的 Python 降维 课程,学习如何探索高维数据、进行特征选择与特征提取。