
कोर्स
Python में Unsupervised Learning
4 घंटा
184.5K
इस ट्यूटोरियल में, हम t-SNE के काम करने के तरीके को समझेंगे—यह डायमेंशनलिटी रिडक्शन और डेटा विज़ुअलाइज़ेशन की एक शक्तिशाली तकनीक है। हम इसे एक अन्य लोकप्रिय तकनीक PCA से तुलना करेंगे और दिखाएंगे कि सिंथेटिक और वास्तविक दुनिया के डेटासेट पर scikit-learn और plotly express का उपयोग करके t-SNE और PCA कैसे करें।
t-SNE (t-distributed Stochastic Neighbor Embedding) एक अनसुपरवाइज़्ड, नॉन-लाइनर डायमेंशनलिटी रिडक्शन तकनीक है, जो डेटा एक्सप्लोरेशन और हाई-डायमेंशनल डेटा को विज़ुअलाइज़ करने के लिए इस्तेमाल होती है। नॉन-लाइनर डायमेंशनलिटी रिडक्शन का अर्थ है कि एल्गोरिद्म ऐसा डेटा अलग कर सकता है जिसे सीधी रेखा से अलग नहीं किया जा सकता।
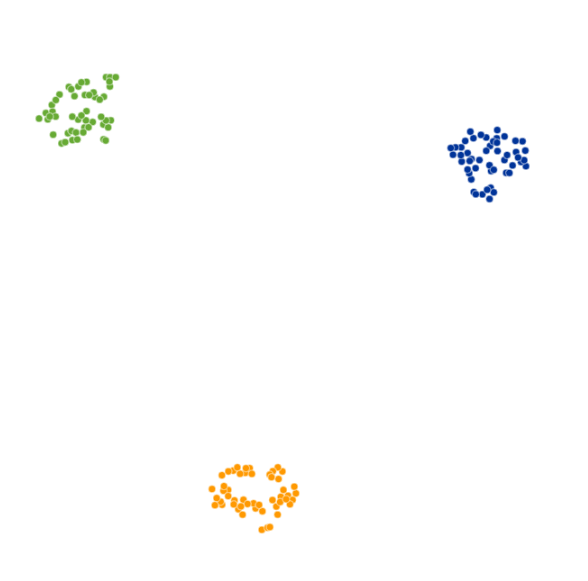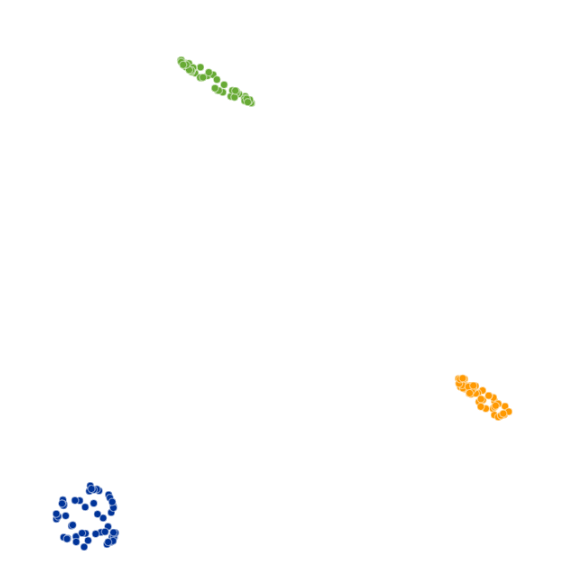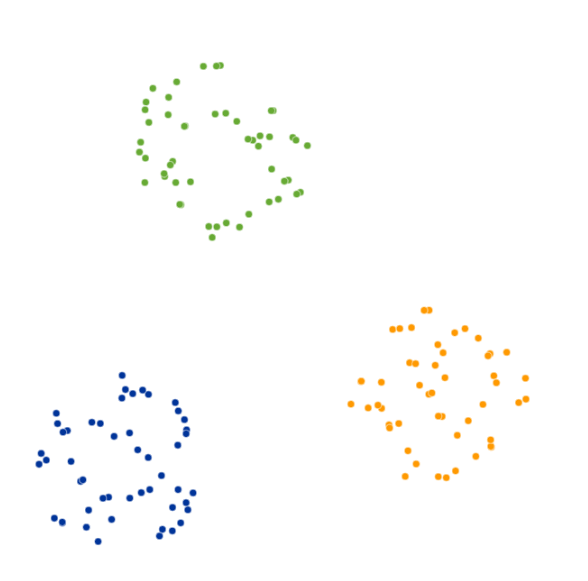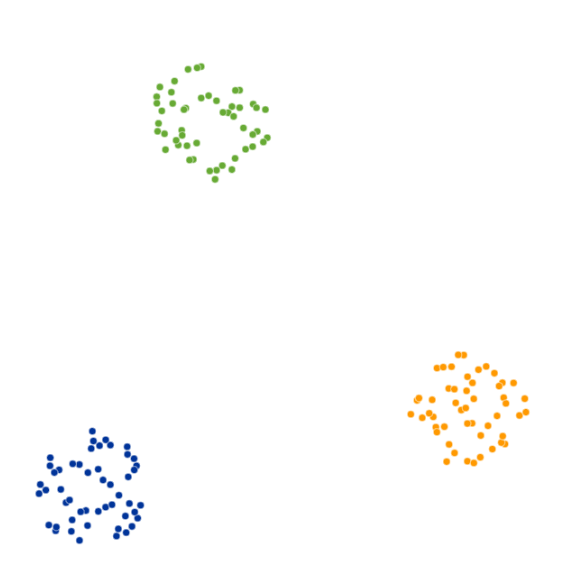
t-SNE आपको यह समझने का अनुभव और सहज ज्ञान कराता है कि उच्च आयामों में डेटा कैसे व्यवस्थित है। इसे अक्सर जटिल डेटासेट को दो या तीन आयामों में विज़ुअलाइज़ करने के लिए उपयोग किया जाता है, जिससे हम डेटा में छिपे पैटर्न और संबंधों को बेहतर समझ पाते हैं।
हमारा Dimensionality Reduction in Python कोर्स लें और हाई-डायमेंशनल डेटा की खोज, फीचर चयन, और फीचर एक्सट्रैक्शन के बारे में सीखें।
t-SNE और PCA दोनों ही डायमेंशनलिटी रिडक्शन तकनीकें हैं, लेकिन इनके तंत्र अलग हैं और ये विभिन्न प्रकार के डेटा पर बेहतर काम करती हैं।
PCA (Principal Component Analysis) एक लाइनर तकनीक है जो लाइनर संरचना वाले डेटा पर सबसे अच्छा काम करती है। यह डेटा को निचले आयामों पर प्रोजेक्ट करके अंतर्निहित प्रिंसिपल कंपोनेंट्स की पहचान करती है, वेरिएंस को न्यूनतम करती है, और बड़े पेयरवाइज़ डिस्टेंस को संरक्षित रखती है। एल्गोरिद्म के भीतर के कार्य को समझने के लिए हमारा Principal Component Analysis (PCA) ट्यूटोरियल पढ़ें, जिसमें R के उदाहरण हैं।
इसके विपरीत, t-SNE एक नॉनलाइनर तकनीक है जो लोअर-डायमेंशनल स्पेस में डेटा प्वाइंट्स के बीच पेयरवाइज़ समानताओं को संरक्षित रखने पर केंद्रित होती है। t-SNE छोटे पेयरवाइज़ डिस्टेंस को संरक्षित रखने की कोशिश करता है, जबकि PCA वेरिएंस को अधिकतम करने के लिए बड़े पेयरवाइज़ डिस्टेंस को बनाए रखने पर ध्यान देता है।
संक्षेप में, PCA डेटा में वेरिएंस को संरक्षित रखता है। जबकि t-SNE लोअर-डायमेंशनल स्पेस में डेटा प्वाइंट्स के संबंधों को बनाए रखता है, जिससे यह जटिल हाई-डायमेंशनल डेटा को विज़ुअलाइज़ करने के लिए एक अच्छा एल्गोरिद्म बन जाता है।
निम्न तालिका आपको t-SNE और PCA की साइड-बाय-साइड तुलना करने में मदद कर सकती है:
| विशेषता | t-SNE | PCA |
|---|---|---|
| प्रकार | नॉन-लाइनर डायमेंशनलिटी रिडक्शन | लाइनर डायमेंशनलिटी रिडक्शन |
| उद्देश्य | स्थानीय पेयरवाइज़ समानताओं को संरक्षित रखना | वैश्विक वेरिएंस को संरक्षित रखना |
| श्रेष्ठ उपयोग | जटिल, हाई-डायमेंशनल डेटा का विज़ुअलाइज़ेशन | लाइनर संरचना वाला डेटा |
| आउटपुट | लोअर-डायमेंशनल प्रतिनिधित्व | प्रिंसिपल कंपोनेंट्स |
| उपयोग केस | क्लस्टरिंग, अनोमली डिटेक्शन, NLP | शोर में कमी, फीचर एक्सट्रैक्शन |
| कम्प्यूटेशनल तीव्रता | उच्च | निम्न |
| व्याख्या | समझना कठिन | समझना आसान |
t-SNE एल्गोरिद्म उच्च और निम्न आयामी स्पेस में इंस्टेंस के जोड़ों के बीच समानता मापता है। इसके बाद यह दो समानता मापों को ऑप्टिमाइज़ करने की कोशिश करता है। यह सब तीन चरणों में होता है।
ऑप्टिमाइज़ेशन प्रक्रिया लोअर-डायमेंशनल स्पेस में समान डेटा प्वाइंट्स के क्लस्टर और सब-क्लस्टर बनाती है, जिन्हें विज़ुअलाइज़ करके हाई-डायमेंशनल डेटा की संरचना और संबंधों को समझा जाता है।
Python उदाहरण में, हम क्लासिफिकेशन डेटा जनरेट करेंगे, PCA और t-SNE लागू करेंगे, और परिणामों को विज़ुअलाइज़ करेंगे। हम डायमेंशनलिटी रिडक्शन के लिए scikit-learn का उपयोग करेंगे, और विज़ुअलाइज़ेशन के लिए Plotly Express का उपयोग करेंगे।
हम scikit-learn के make_classification() फ़ंक्शन का उपयोग करके 6 फीचर्स, 1500 सैंपल्स और 3 क्लास वाले सिंथेटिक डेटा बनाएंगे।
इसके बाद, हम Plotly Express के scatter_3d() फ़ंक्शन से डेटा के पहले तीन फीचर्स का 3D प्लॉट बनाएंगे।
import plotly.express as px
from sklearn.datasets import make_classification

X, y = make_classification(
    n_features=6,
    n_classes=3,
    n_samples=1500,
    n_informative=2,
    random_state=5,
    n_clusters_per_class=1,
)


fig = px.scatter_3d(x=X[:, 0], y=X[:, 1], z=X[:, 2], color=y, opacity=0.8)
fig.show()
हमारे पास डेटा का 3D प्लॉट है; आप Plotly Express के scatter() फ़ंक्शन का उपयोग करके 2D चार्ट में भी डेटा को विज़ुअलाइज़ कर सकते हैं।

अब हम डेटासेट पर PCA एल्गोरिद्म लागू करेंगे ताकि दो PCA कंपोनेंट मिलें। fit_transform() एक ही समय में डेटासेट को सीखता और ट्रांसफॉर्म करता है।
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)अब हम स्कैटर प्लॉट पर दो PCA कंपोनेंट दिखाकर परिणामों का विज़ुअलाइज़ेशन कर सकते हैं।
हमने update_layout() फ़ंक्शन का उपयोग शीर्षक जोड़ने और x-अक्ष व y-अक्ष के नाम बदलने के लिए भी किया है।
fig = px.scatter(x=X_pca[:, 0], y=X_pca[:, 1], color=y)
fig.update_layout(
    title="PCA visualization of Custom Classification dataset",
    xaxis_title="First Principal Component",
    yaxis_title="Second Principal Component",
)
fig.show()
अब, हम डेटासेट पर t-SNE एल्गोरिद्म लागू करेंगे और परिणामों की तुलना करेंगे।
डेटा को फिट और ट्रांसफॉर्म करने के बाद, हम हाई और लोअर-डायमेंशनल प्रायिकता वितरणों के बीच Kullback-Leibler (KL) डाइवर्जेन्स दिखाएंगे। कम KL डाइवर्जेन्स आमतौर पर बेहतर परिणाम का संकेत है।
from sklearn.manifold import TSNE

tsne = TSNE(n_components=2, random_state=42)
X_tsne = tsne.fit_transform(X)
tsne.kl_divergence_1.1169137954711914PCA की तरह ही, हम स्कैटर प्लॉट पर दो t-SNE कंपोनेंट विज़ुअलाइज़ करेंगे।
fig = px.scatter(x=X_tsne[:, 0], y=X_tsne[:, 1], color=y)
fig.update_layout(
    title="t-SNE visualization of Custom Classification dataset",
    xaxis_title="First t-SNE",
    yaxis_title="Second t-SNE",
)
fig.show()
परिणाम PCA से काफ़ी बेहतर है। हमें स्पष्ट रूप से तीन बड़े क्लस्टर दिखाई दे रहे हैं।

इस खंड में, हम ईरान की एक टेलीकॉम कंपनी के कस्टमर चर्न डेटासेट का उपयोग करेंगे। इस डेटासेट में ग्राहकों की गतिविधियों—जैसे कॉल फेलियर और सब्सक्रिप्शन की अवधि—और चर्न लेबल की जानकारी शामिल है।
चर्न का अर्थ है, एक निर्धारित समयावधि में किसी सेवा का उपयोग बंद करने वाले ग्राहकों का प्रतिशत।
नोट: दोनों उदाहरणों का कोड स्रोत और डेटासेट इस DataLab वर्कबुक में उपलब्ध है; यदि आप कोड में बदलाव कर चलाना चाहते हैं, तो बस एक कॉपी बना लें, और आप तैयार हैं!
हम pandas का उपयोग करके डेटासेट लोड करेंगे और पहली तीन पंक्तियाँ प्रदर्शित करेंगे।
import pandas as pd

df = pd.read_csv("data/customer_churn.csv")
df.head(3)
इसके बाद, हम यह करेंगे:
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

X = df.drop('Churn', axis=1)
y = df['Churn']

scaler = StandardScaler()
X_norm = scaler.fit_transform(X)

X_train, X_test, y_train, y_test = train_test_split(
    X_norm, y, random_state=13, test_size=0.25, shuffle=True
)

pca = PCA(n_components=2)
X_train_pca = pca.fit_transform(X_train)

pca.score(X_test)-17.04482851288105अब हम Plotly Express स्कैटर प्लॉट का उपयोग करके PCA के परिणामों को विज़ुअलाइज़ करेंगे।
fig = px.scatter(x=X_train_pca[:, 0], y=X_train_pca[:, 1], color=y_train)
fig.update_layout(
    title="PCA visualization of Customer Churn dataset",
    xaxis_title="First Principal Component",
    yaxis_title="Second Principal Component",
)
fig.show()
PCA क्लस्टर बनाने में अच्छा नहीं रहा। लोअर डायमेंशन में डेटा यादृच्छिक जैसा दिखता है। इसका यह भी अर्थ हो सकता है कि डेटासेट में फीचर्स अत्यधिक स्क्यूड हैं, या उसमें मजबूत सहसंबंध संरचना नहीं है।

परप्लेक्सिटी t-SNE एल्गोरिद्म का एक महत्वपूर्ण हाइपरपैरामीटर है। यह डायमेंशनलिटी रिडक्शन के दौरान प्रत्येक प्वाइंट द्वारा माने जाने वाले प्रभावी पड़ोसियों की संख्या को नियंत्रित करता है।
हम 5 से 55 तक 5 के अंतराल वाली विभिन्न परप्लेक्सिटी के लिए KL डाइवर्जेन्स मीट्रिक निकालने के लिए एक लूप चलाएँगे। फिर हम Plotly Express लाइन प्लॉट से परिणाम दिखाएँगे।
import numpy as np

perplexity = np.arange(5, 55, 5)
divergence = []

for i in perplexity:
    model = TSNE(n_components=2, init="pca", perplexity=i)
    reduced = model.fit_transform(X_train)
    divergence.append(model.kl_divergence_)
fig = px.line(x=perplexity, y=divergence, markers=True)
fig.update_layout(xaxis_title="Perplexity Values", yaxis_title="Divergence")
fig.update_traces(line_color="red", line_width=1)
fig.show()
40 की परप्लेक्सिटी के बाद KL डाइवर्जेन्स स्थिर हो गया है। इसलिए, हम t-SNE एल्गोरिद्म में 40 परप्लेक्सिटी का उपयोग करेंगे।

अब हम 40 परप्लेक्सिटी के साथ t-SNE फिट करेंगे और लोअर डायमेंशंस में डेटा को ट्रांसफॉर्म करेंगे ताकि न्यूनतम KL डाइवर्जेन्स मिले।
from sklearn.manifold import TSNE

tsne = TSNE(n_components=2,perplexity=40, random_state=42)
X_train_tsne = tsne.fit_transform(X_train)

tsne.kl_divergence_0.258713960647583अब हम Plotly स्कैटर प्लॉट का उपयोग करके कंपोनेंट्स और टार्गेट क्लासेज़ को प्रदर्शित करेंगे।
fig = px.scatter(x=X_train_tsne[:, 0], y=X_train_tsne[:, 1], color=y_train)
fig.update_layout(
    title="t-SNE visualization of Customer Churn dataset",
    xaxis_title="First t-SNE",
    yaxis_title="Second t-SNE",
)
fig.show()
जैसा कि हम देख सकते हैं, हमारे पास कई क्लस्टर और सब-क्लस्टर हैं। हम इस जानकारी का उपयोग पैटर्न समझने और मौजूदा ग्राहकों को बनाए रखने की रणनीति विकसित करने के लिए कर सकते हैं।

हालाँकि t-SNE हाई-डायमेंशनल डेटा के लिए एक शक्तिशाली विज़ुअलाइज़ेशन टूल है, इसके साथ कुछ सीमाएँ भी आती हैं:
हाल के वर्षों में, UMAP (Uniform Manifold Approximation and Projection) t-SNE का एक लोकप्रिय विकल्प बनकर उभरा है। दोनों नॉन-लाइनर डायमेंशनलिटी रिडक्शन तकनीकें हैं जो विज़ुअलाइज़ेशन के लिए डिज़ाइन की गई हैं, लेकिन UMAP t-SNE की कुछ सीमाओं को संबोधित करता है:
निम्न तालिका में UMAP और PCA की तुलना में t-SNE की कम्प्यूटेशनल जटिलता का सार है:
| तकनीक | कम्प्यूटेशनल जटिलता | विशेषताएँ | बड़े डेटासेट के लिए उपयुक्तता |
|---|---|---|---|
| t-SNE | O(N2) | स्थानीय संरचना का संरक्षण, उच्च कस्टमाइज़ेबिलिटी | मध्यम (बड़े डेटासेट पर धीमा) |
| UMAP | O(N log N) | स्थानीय और वैश्विक संरचना का संतुलन, अधिक तेज़ | उच्च (बड़े डेटासेट को कुशलता से संभालता है) |
| PCA | O(Nd2) | लाइनर रिडक्शन, व्याख्येय कंपोनेंट्स | उच्च (बहुत कुशल) |
संक्षेप में, जहाँ t-SNE स्थानीय संबंधों पर विस्तृत अंतर्दृष्टि देता है, वहीं UMAP अक्सर आधुनिक डेटासेट के लिए अधिक कुशल और स्केलेबल विकल्प होता है। लाइनर डेटा के लिए PCA तेज़ और व्याख्येय विकल्प बना रहता है। डेटासेट और लक्ष्यों के आधार पर, सही तकनीक का चयन व्याख्येयता, कम्प्यूटेशनल लागत, और डेटा की प्रकृति के संतुलन पर निर्भर करता है।
जटिल बहु-आयामी डेटा का विज़ुअलाइज़ेशन करने के अलावा, t-SNE के अन्य उपयोग भी हैं:
t-SNE जटिल डेटासेट में छिपे पैटर्न और संरचनाओं को उजागर करने के लिए एक शक्तिशाली विज़ुअलाइज़ेशन टूल है। आप इसका उपयोग इमेज, ऑडियो, बायोलॉजिकल और सिंगल-टेबल डेटा में विसंगतियों और पैटर्न की पहचान के लिए कर सकते हैं।
इस ब्लॉग पोस्ट में, हमने t-SNE के बारे में सीखा—एक लोकप्रिय डायमेंशनलिटी रिडक्शन तकनीक जो हाई-डायमेंशनल नॉन-लाइनर डेटा को लोअर-डायमेंशनल स्पेस में विज़ुअलाइज़ कर सकती है। हमने t-SNE के पीछे का मुख्य विचार, यह कैसे काम करता है, और इसके अनुप्रयोग समझाए। साथ ही, हमने t-SNE को सिंथेटिक और वास्तविक डेटासेट पर लागू करने के उदाहरण और परिणामों की व्याख्या भी देखी।
t-SNE अनसुपरवाइज़्ड लर्निंग का हिस्सा है, और अगला स्वाभाविक कदम हायरार्किकल क्लस्टरिंग, PCA, डिकॉरिलेशन और व्याख्येय फीचर्स की खोज को समझना है। इन सभी विषयों को सीखने के लिए हमारा Unsupervised Learning in Python कोर्स करें।
Python के बारे में और जानें
कोर्स
कोर्स
कोर्स