
Free access is closing! 700+ free courses are waiting.
Ends in:
Start Now
SHAP değerleri, her bir özelliğin modelin tahminini nasıl etkilediğine dair tutarlı ve nesnel bir açıklama elde etmenin yaygın bir yoludur.
SHAP değerleri oyun kuramına dayanır ve bir modeldeki her özelliğe bir önem değeri atar. Pozitif SHAP değerlerine sahip özellikler tahmini olumlu yönde etkilerken, negatif değerlere sahip olanlar olumsuz etkiler. Büyüklük ise etkinin ne kadar güçlü olduğunun bir ölçüsüdür.
SHAP değerleri modelden bağımsızdır; yani aşağıdakiler de dahil olmak üzere herhangi bir makine öğrenimi modelini yorumlamak için kullanılabilir:
SHAP değerleri, modelleri yorumlamak için etkili kılan çeşitli yararlı özelliklere sahiptir:
SHAP değerleri toplanabilirdir; bu, her bir özelliğin nihai tahmine katkısının bağımsız olarak hesaplanabileceği ve ardından toplanabileceği anlamına gelir. Bu özellik, yüksek boyutlu veri kümeleri için bile SHAP değerlerinin verimli bir şekilde hesaplanmasını sağlar.
SHAP değerleri, beklenen model çıktısı ile verilen bir girdi için gerçek çıktı arasındaki farka denk gelir. Bu, SHAP değerlerinin modelin belirli bir girdi için yaptığı tahmini yerel ve doğru biçimde yorumladığı anlamına gelir.
SHAP değerleri, bir tahmin için eksik ya da ilgisiz özellikler için sıfırdır. Bu durum SHAP değerlerini eksik verilere karşı sağlam kılar ve ilgisiz özelliklerin yorumu bozmasını engeller.
Bir özelliğin katkısı değişmediği sürece model değiştiğinde SHAP değerleri değişmez. Bu da, model mimarisi veya parametreleri değişse bile SHAP değerlerinin modelin davranışına tutarlı bir yorum sunduğu anlamına gelir.
Özetle, SHAP değerleri bir makine öğrenimi modelinin nasıl tahmin yaptığını ve hangi özelliklerin en büyük etkiye sahip olduğunu anlamak için tutarlı ve nesnel bir yol sağlar.
Bu bölümde SHAP değerlerini hesaplayacak ve özellik önemini, bağımlılığını, kuvvet ve karar grafiğini görselleştireceğiz.
Bu eğitimdeki kodu çevrimiçi olarak çalıştırın ve düzenleyin
Kodu çalıştırSHAP'i PyPI veya conda-forge kullanarak yükleyin:
veya
Telecom Customer Churn verisini yükleyin. Veri kümesi temiz görünüyor ve hedef sütun “Churn”.
import shap
import pandas as pd
import numpy as np
shap.initjs()
customer = pd.read_csv("data/customer_churn.csv")
customer.head()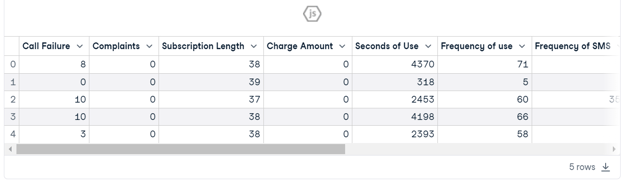
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split
X = customer.drop("Churn", axis=1) # Independent variables
y = customer.Churn # Dependent variable
# Split into train and test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=1)
# Train a machine learning model
from sklearn.ensemble import RandomForestClassifier
clf = RandomForestClassifier()
clf.fit(X_train, y_train)
# Make prediction on the testing data
y_pred = clf.predict(X_test)
# Classification Report
print(classification_report(y_pred, y_test))Model, dengesiz veri kümesi nedeniyle “0” etiketi için “1” etiketinden daha iyi performans gösterdi. Genel olarak, yüzde 94 doğrulukla kabul edilebilir bir sonuçtur.
precision recall f1-score support
0 0.97 0.96 0.97 815
1 0.79 0.82 0.80 130
accuracy 0.94 945
macro avg 0.88 0.89 0.88 945
weighted avg 0.94 0.94 0.94 945Python örnekleriyle makine öğreniminde sınıflandırmayı öğrenmek için Makine Öğreniminde Sınıflandırma rehberimize göz atın.
Şimdi model açıklayıcı kısmına geliyoruz.
Önce bir rastgele orman sınıflandırma modeli sağlayarak bir açıklayıcı nesnesi oluşturacağız, ardından test setini kullanarak SHAP değerini hesaplayacağız.
explainer = shap.Explainer(clf)
shap_values = explainer.shap_values(X_test)SHAP değerlerini ve test setini kullanarak summary_plot'u görüntüleyin.
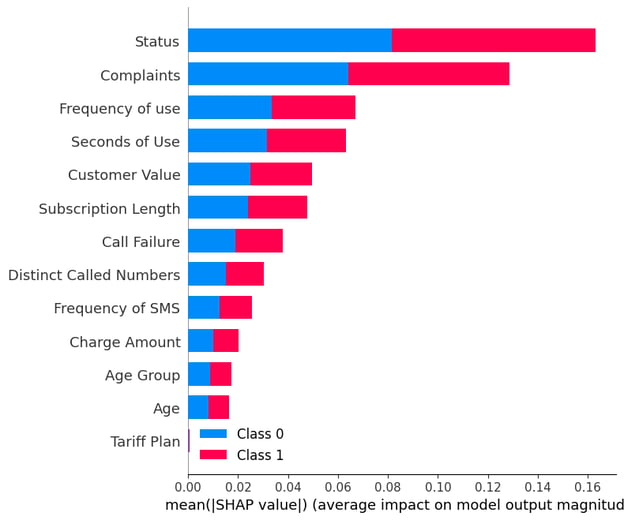
Özet grafiği, modeldeki her bir özelliğin önemini gösterir. Sonuçlar “Status”, “Complaints” ve “Frequency of use” özelliklerinin sonuçların belirlenmesinde başlıca rol oynadığını gösteriyor.
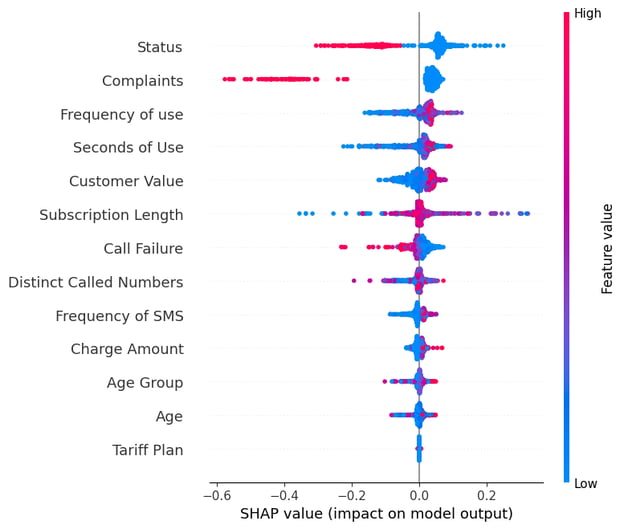
“0” etiketi için summary_plot'u görüntüleyin.
shap.summary_plot(shap_values[0], X_test)“Complaints” özelliğine bakarsanız, çoğunlukla negatif SHAP değeriyle yüksek olduğunu görürsünüz. Bu da daha yüksek şikayet sayılarının çıktıyı olumsuz etkileme eğiliminde olduğunu gösterir.
Not: “1” etiketi için görselleştirme tersine çevrilecektir.
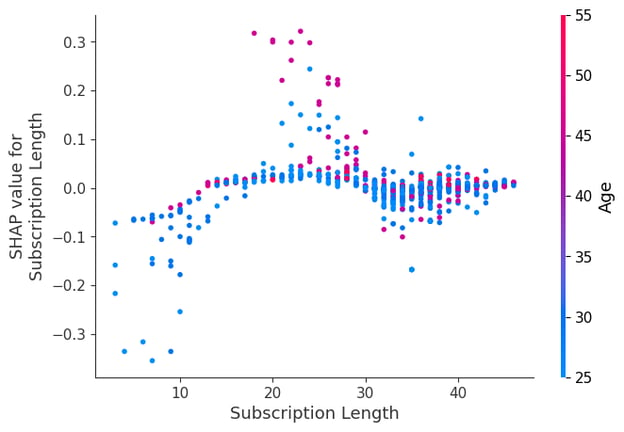
“Subscription Length” ve “Age” özellikleri arasındaki dependence_plot'u görselleştirin.
shap.dependence_plot("Subscription Length", shap_values[0], X_test,interaction_index="Age")Bağımlılık grafiği, modelin tahminlerinin belirli bir özelliğe (Subscription Length) göre nasıl etkilendiğini gösteren bir dağılım grafiği türüdür. Ortalama olarak, abonelik sürelerinin model üzerinde çoğunlukla olumlu bir etkisi vardır.
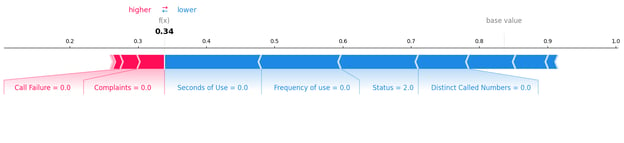
Test setindeki ilk örneği inceleyerek hangi özelliklerin "0" sonucuna katkıda bulunduğunu belirleyeceğiz. Bunu yapmak için bir kuvvet grafiği kullanacak ve beklenen değeri, SHAP değerini ve test örneğini sağlayacağız.
shap.plots.force(explainer.expected_value[0], shap_values[0][0,:], X_test.iloc[0, :], matplotlib = True)Sıfır şikayet ve sıfır çağrı hatasının müşteri kaybının olmamasına olumsuz yönde katkıda bulunduğunu açıkça görebiliyoruz.
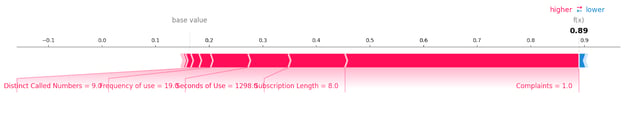
Şimdi “1” etiketli müşteri kaybı örneklerine bakalım.
shap.plots.force(explainer.expected_value[1], shap_values[1][6, :], X_test.iloc[6, :],matplotlib = True)Müşteri kaybına katkıda bulunan tüm özellikleri, değerleri ve büyüklükleriyle birlikte görebilirsiniz. Görünüşe göre tek bir çözülmemiş şikayet bile bir telekom şirketine müşteri kaybettirebilir.
Şimdi decision_plot'u görüntüleyeceğiz. Bu grafik, her tahmin için kümülatif SHAP değerlerini eşleyerek model kararlarını görsel olarak gösterir.
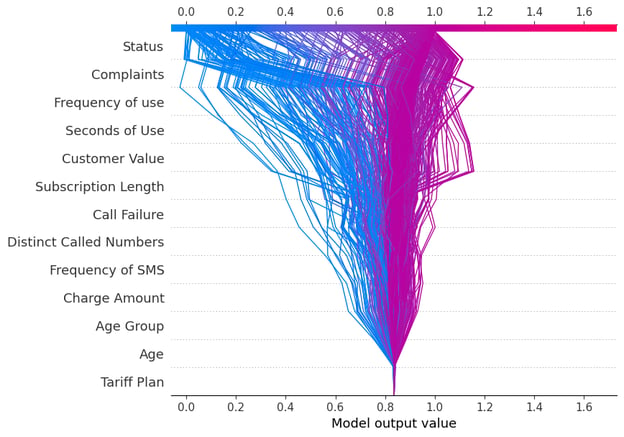
shap.decision_plot(explainer.expected_value[1], shap_values[1], X_test.columns)Karar grafiğindeki her çizgi, tek bir model tahminine bireysel özelliklerin ne kadar güçlü katkıda bulunduğunu gösterir; böylece hangi özellik değerlerinin tahmini ittiğini açıklar.
Not: Hedef etiket “1” için karar grafiği “1” yönüne eğimlidir.
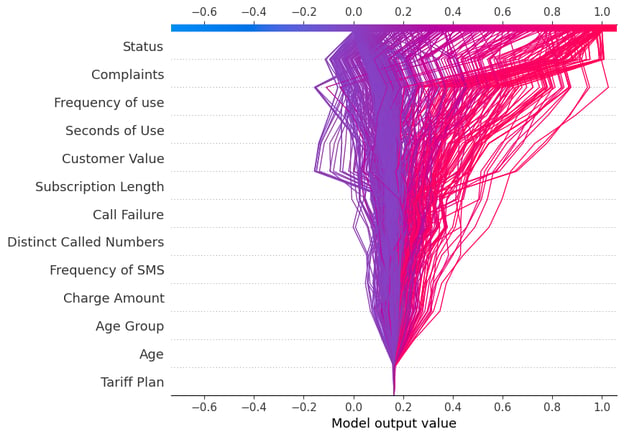
Hedef etiket “0” için karar grafiğini görüntüleyin
shap.decision_plot(explainer.expected_value[0], shap_values[0], X_test.columns)Bu karar grafiği ise “0” yönüne eğimlidir.
Makine öğreniminde yorumlanabilirlik ve açıklanabilirliğin yanı sıra, SHAP değeri şu amaçlarla da kullanılabilir:
SHAP değerlerini ve bunları makine öğrenimi modellerine yorumlanabilirlik kazandırmak için nasıl kullanabileceğimizi inceledik. Doğru bir modele sahip olmak önemli olmakla birlikte, şirketlerin kullanıcıların ve düzenleyicilerin güvenini kazanmak için doğruluğun ötesine geçip yorumlanabilirlik ve şeffaflığa odaklanması gerekir.
Bir modelin neden belirli bir tahmini yaptığını açıklayabilmek, olası önyargıların hata ayıklanmasına, veri sorunlarının belirlenmesine ve modelin kararlarının gerekçelendirilmesine yardımcı olur.
Makine öğrenimine yeni başlıyorsanız ve işe hazır hale gelmek istiyorsanız, Machine Learning Scientist with Python kariyer yolunu değerlendirin. Bu program, makine öğrenimi bilim insanı olmak ve iş bulmak için gerekli Python becerilerinde ustalaşmanıza yardımcı olacaktır.
Sertifikalı bir veri bilimcisi olarak, yenilikçi makine öğrenimi uygulamaları oluşturmak için en son teknolojileri kullanmaya büyük ilgi duyuyorum. Konuşma tanıma, veri analizi ve raporlama, MLOps, konuşma yapay zekası ve NLP alanlarında güçlü bir geçmişe sahip olarak, gerçek bir etki yaratabilecek akıllı sistemler geliştirme becerilerimi geliştirdim. Teknik uzmanlığımın yanı sıra, karmaşık kavramları açık ve özlü bir dille ifade etme yeteneğine sahip, becerikli bir iletişimciyim. Sonuç olarak, veri bilimi konusunda aranan bir blog yazarı oldum ve giderek büyüyen veri profesyonelleri topluluğuyla görüşlerimi ve deneyimlerimi paylaşıyorum. Şu anda, içerik oluşturma ve düzenlemeye odaklanıyorum. Büyük dil modelleriyle çalışarak, hem işletmelerin hem de bireylerin verilerinden en iyi şekilde yararlanmalarına yardımcı olabilecek güçlü ve ilgi çekici içerikler geliştiriyorum.

blog
 Abid Ali Awan• 14 dk.

blog
 Dario Radečić• 15 dk.

Eğitim
 Kurtis Pykes • 8 dk.



Makine öğrenimi modelleri giderek daha karmaşık, güçlü ve doğru tahminler yapabilir hale geliyor. Ancak bu modeller birer "kara kutu"ya dönüştükçe, o tahminlere nasıl ulaştıklarını anlamak daha da zorlaşıyor. Bu durum, makine öğreniminde yorumlanabilirlik ve açıklanabilirliğe artan bir odaklanmaya yol açtı.
Örneğin, bir bankadan kredi başvurusunda bulundunuz ancak reddedildiniz. Reddedilme nedenini öğrenmek istiyorsunuz; fakat müşteri temsilcisi başvurunun bir algoritma tarafından elendiğini ve nedenini belirleyemeyeceklerini söylüyor. Sinir bozucu, değil mi? Sizi etkileyen bir karar için açıklama alma hakkınız var. İşte bu yüzden şirketler makine öğrenimi modellerini daha şeffaf ve anlaşılır hale getirmeye çalışıyor.
Bu süreçte en umut verici araçlardan biri, her bir özelliğin (gelir, yaş, kredi puanı vb.) modelin tahminine ne kadar katkıda bulunduğunu ölçen SHAP değerleridir. SHAP değerleri, model için hangi özelliklerin en önemli olduğunu ve sonucu nasıl etkilediklerini görmenize yardımcı olabilir.
Bu eğitimde, SHAP değerlerini ve makine öğrenimi modeli yorumlamasındaki rollerini öğreneceğiz. Ayrıca, modelleri yorumlamak için farklı görselleştirmeler oluşturup analiz etmek üzere
ShapPython paketini kullanacağız.SHAP Değerleri Nedir?
SHAP (SHapley Additive exPlanations) değerleri, herhangi bir makine öğrenimi modelinin çıktısını açıklamanın bir yoludur. Nihai sonuca her bir oyuncunun katkısını ölçen oyun kuramı yaklaşımını kullanır. Makine öğreniminde, her bir özelliğe model çıktısına katkısını temsil eden bir önem değeri atanır.
SHAP değerleri, her bir özelliğin her bir nihai tahmini nasıl etkilediğini, her özelliğin diğerlerine kıyasla önemini ve modelin özellikler arası etkileşimlere ne ölçüde dayandığını gösterir.