इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएंसेटअप
SHAP को PyPI या conda-forge से इंस्टॉल करें:
pip install shapया
conda install -c conda-forge shapTelecom Customer Churn लोड करें। डेटासेट साफ दिखता है, और टार्गेट कॉलम “Churn” है।
import shap
import pandas as pd
import numpy as np
shap.initjs()

customer = pd.read_csv("data/customer_churn.csv")
customer.head()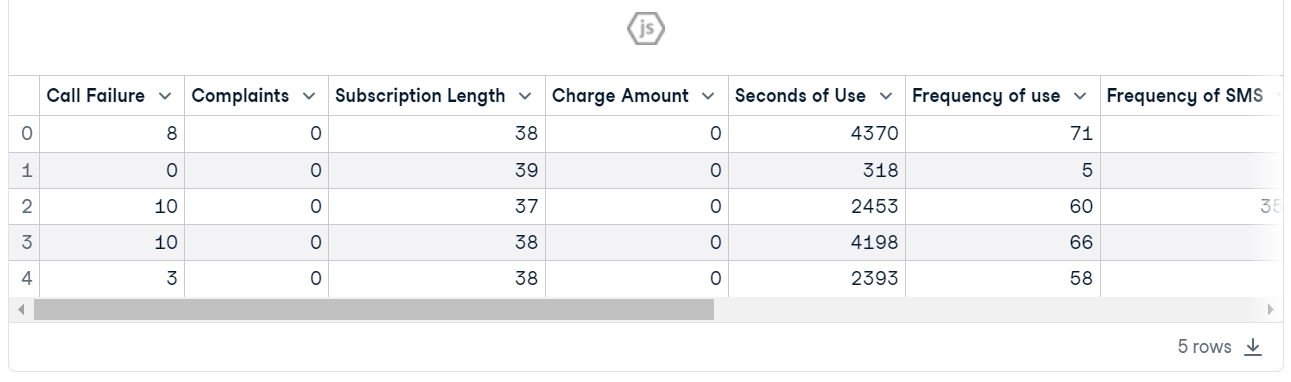
मॉडल प्रशिक्षण और मूल्यांकन
- टार्गेट कॉलम का उपयोग करके X और y बनाएँ और डेटासेट को ट्रेन और टेस्ट में बाँटें।
- ट्रेनिंग सेट पर Random Forest Classifier को प्रशिक्षित करें।
- टेस्टिंग सेट का उपयोग करके भविष्यवाणियाँ करें।
- क्लासिफिकेशन रिपोर्ट प्रदर्शित करें।
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split

X = customer.drop("Churn", axis=1) # Independent variables
y = customer.Churn # Dependent variable

# Split into train and test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=1)

# Train a machine learning model
from sklearn.ensemble import RandomForestClassifier
clf = RandomForestClassifier()
clf.fit(X_train, y_train)

# Make prediction on the testing data
y_pred = clf.predict(X_test)

# Classification Report
print(classification_report(y_pred, y_test))
मॉडल ने असंतुलित डेटासेट के कारण “0” लेबल के लिए “1” की तुलना में बेहतर प्रदर्शन दिखाया है। कुल मिलाकर, 94% सटीकता के साथ यह स्वीकार्य परिणाम है।
              precision    recall  f1-score   support

           0       0.97      0.96      0.97       815
           1       0.79      0.82      0.80       130

    accuracy                           0.94       945
   macro avg       0.88      0.89      0.88       945
weighted avg       0.94      0.94      0.94       945
क्लासिफिकेशन पर Python उदाहरणों के साथ सीखने के लिए हमारा Classification in Machine Learning गाइड देखें।
SHAP एक्सप्लेनर सेटअप
अब मॉडल एक्सप्लेनर वाले भाग पर आते हैं।
हम पहले एक एक्सप्लेनर ऑब्जेक्ट बनाएँगे जिसमें रैंडम फॉरेस्ट क्लासिफिकेशन मॉडल देंगे, फिर टेस्टिंग सेट का उपयोग करके SHAP वैल्यू की गणना करेंगे।
explainer = shap.Explainer(clf)
shap_values = explainer.shap_values(X_test)
समरी प्लॉट
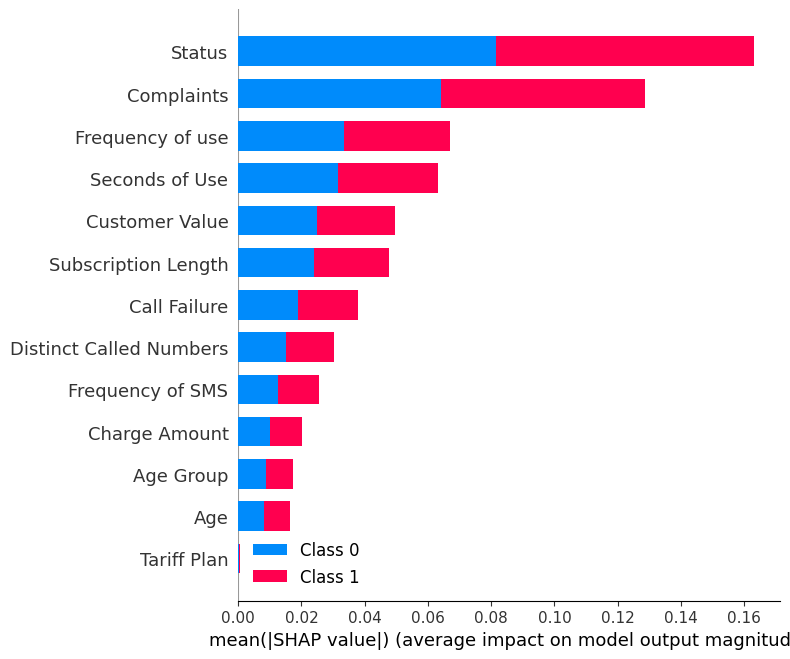
SHAP वैल्यूज़ और टेस्टिंग सेट का उपयोग करके summary_plot प्रदर्शित करें।
shap.summary_plot(shap_values, X_test)समरी प्लॉट मॉडल में प्रत्येक फीचर की फीचर इम्पॉर्टेंस दिखाता है। परिणाम बताते हैं कि “Status,” “Complaints,” और “Frequency of use” परिणाम निर्धारित करने में प्रमुख भूमिका निभाते हैं।
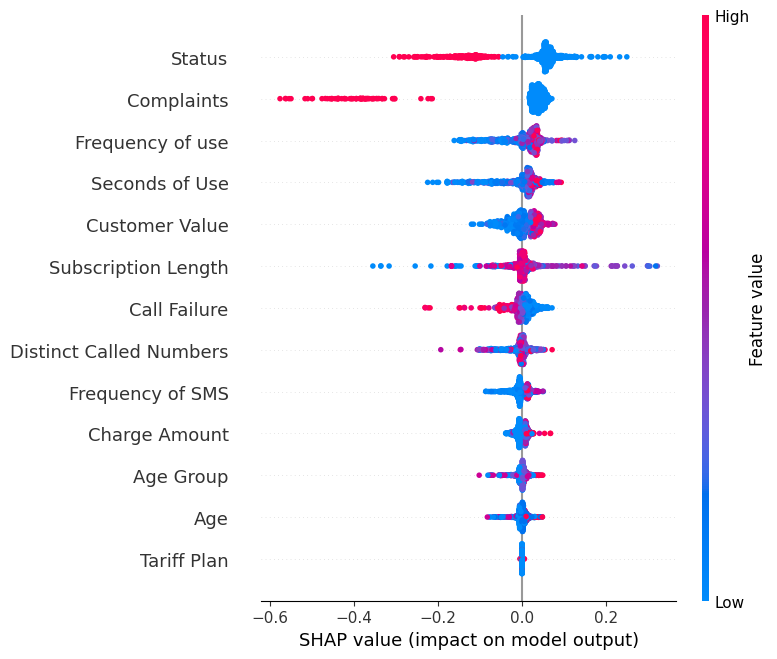
लेबल “0” का summary_plot प्रदर्शित करें।
shap.summary_plot(shap_values[0], X_test)- Y-अक्ष फीचर नामों को ऊपर से नीचे महत्व के क्रम में दर्शाता है।
- X-अक्ष SHAP वैल्यू का प्रतिनिधित्व करता है, जो लॉग ऑड्स में परिवर्तन की मात्रा दर्शाता है।
- ग्राफ़ पर प्रत्येक बिंदु का रंग संबंधित फीचर के मान का प्रतिनिधित्व करता है, जहाँ लाल उच्च मान और नीला निम्न मान इंगित करता है।
- प्रत्येक बिंदु मूल डेटासेट की एक डेटा पंक्ति का प्रतिनिधित्व करता है।
यदि आप फीचर “Complaints” देखें, तो पाएँगे कि यह अधिकांशतः उच्च है और इसकी SHAP वैल्यू नकारात्मक है। इसका मतलब है कि शिकायतों की अधिक संख्या आउटपुट को नकारात्मक रूप से प्रभावित करती है।
नोट: लेबल “1” के लिए विज़ुअलाइज़ेशन उल्टा होगा।
डिपेंडेंस प्लॉट
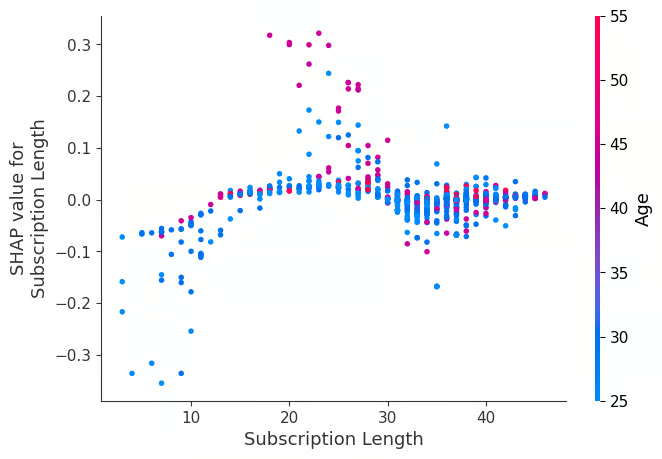
फीचर “Subscription Length” और “Age” के बीच dependence_plot को विज़ुअलाइज़ करें।
shap.dependence_plot("Subscription Length", shap_values[0], X_test,interaction_index="Age")डिपेंडेंस प्लॉट एक प्रकार का स्कैटर प्लॉट है जो दिखाता है कि किसी विशेष फीचर (Subscription Length) से मॉडल की भविष्यवाणियाँ कैसे प्रभावित होती हैं। औसतन, सब्सक्रिप्शन की अवधि का मॉडल पर ज्यादातर सकारात्मक प्रभाव पड़ता है।
फोर्स प्लॉट
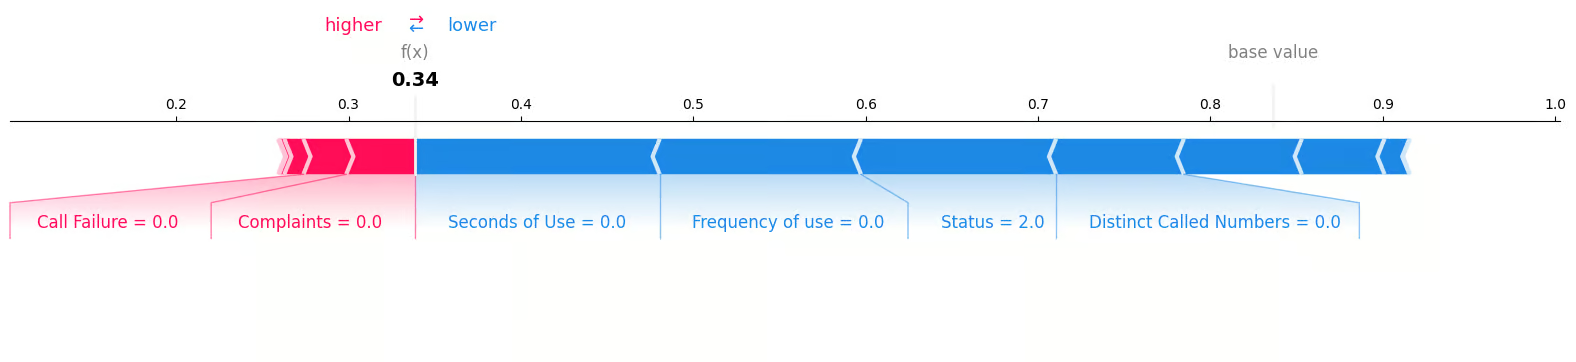
हम टेस्टिंग सेट के पहले सैंपल की जाँच करेंगे ताकि यह तय किया जा सके कि किन फीचर्स ने "0" परिणाम में योगदान दिया। ऐसा करने के लिए, हम फोर्स प्लॉट का उपयोग करेंगे और अपेक्षित मान, SHAP वैल्यू, और टेस्टिंग सैंपल प्रदान करेंगे।
shap.plots.force(explainer.expected_value[0], shap_values[0][0,:], X_test.iloc[0, :], matplotlib = True)हम स्पष्ट रूप से देख सकते हैं कि शून्य शिकायतें और शून्य कॉल विफलताएँ ग्राहकों के नुकसान में नकारात्मक योगदान दे रही हैं।
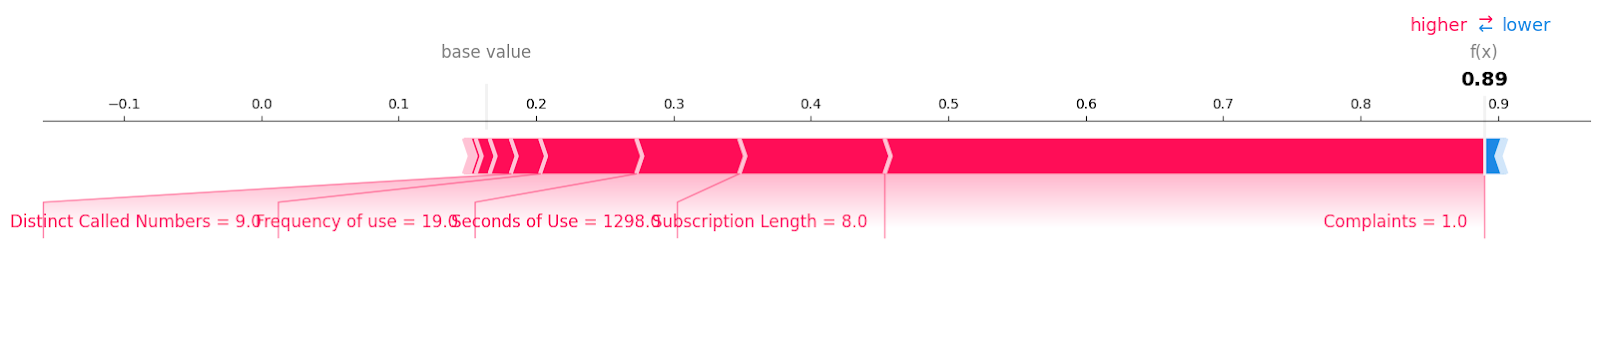
आइए लेबल “1” वाले कस्टमर चर्न सैंपल देखें।
shap.plots.force(explainer.expected_value[1], shap_values[1][6, :], X_test.iloc[6, :],matplotlib = True)आप उन सभी फीचर्स को उनके मान और परिमाण सहित देख सकते हैं, जिन्होंने ग्राहकों के नुकसान में योगदान दिया। ऐसा लगता है कि एक भी अनसुलझी शिकायत दूरसंचार कंपनी के लिए नुकसानदेह हो सकती है।
डिसीजन प्लॉट
अब हम decision_plot प्रदर्शित करेंगे। यह प्रत्येक भविष्यवाणी के लिए संचयी SHAP वैल्यूज़ को मैप करके मॉडल के निर्णयों को दृश्य रूप में दिखाता है।
shap.decision_plot(explainer.expected_value[1], shap_values[1], X_test.columns)डिसीजन प्लॉट पर प्रत्येक प्लॉट की गई रेखा दिखाती है कि किसी एकल मॉडल भविष्यवाणी में व्यक्तिगत फीचर्स ने कितना मजबूत योगदान दिया, जिससे यह स्पष्ट होता है कि किन फीचर मानों ने भविष्यवाणी को आगे बढ़ाया।
नोट: टार्गेट लेबल “1” का डिसीजन प्लॉट “1” की ओर झुका हुआ है।
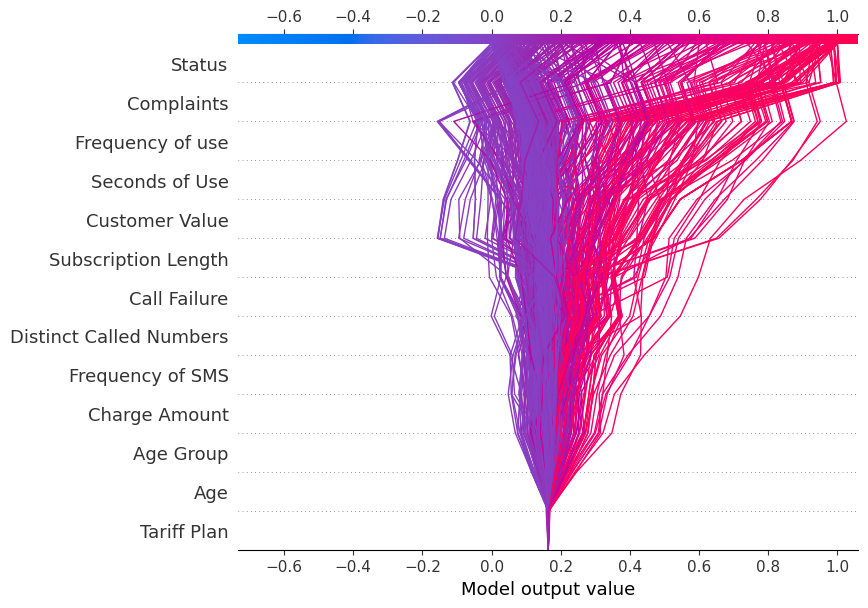
टार्गेट लेबल “0” के लिए डिसीजन प्लॉट प्रदर्शित करें
shap.decision_plot(explainer.expected_value[0], shap_values[0], X_test.columns)डिसीजन प्लॉट “0” की ओर झुका हुआ है।

SHAP वैल्यूज़ के उपयोग
मशीन लर्निंग की व्याख्यात्मकता और स्पष्टता के अलावा, SHAP वैल्यू का उपयोग इन कार्यों में किया जा सकता है:
- मॉडल डीबगिंग। SHAP वैल्यूज़ की जाँच करके, हम डेटा में ऐसे पूर्वाग्रहों या आउट्लायर्स की पहचान कर सकते हैं जो मॉडल से गलतियाँ करा रहे हों।
- फीचर इम्पॉर्टेंस। कम प्रभाव वाले फीचर्स की पहचान करके उन्हें हटाना एक अधिक अनुकूलित मॉडल बना सकता है।
- एंकरिंग एक्सप्लेनेशंस। हम SHAP वैल्यूज़ का उपयोग किसी व्यक्तिगत भविष्यवाणी को समझाने के लिए कर सकते हैं, उन आवश्यक फीचर्स को उजागर करके जिन्होंने उस भविष्यवाणी का कारण बना। यह उपयोगकर्ताओं को मॉडल के निर्णयों को समझने और उस पर भरोसा करने में मदद कर सकता है।
- मॉडल समरी। यह SHAP वैल्यू समरी प्लॉट के रूप में किसी मॉडल का एक वैश्विक सारांश प्रदान कर सकता है। यह पूरे डेटासेट में सबसे महत्वपूर्ण फीचर्स का अवलोकन देता है।
- पूर्वाग्रह का पता लगाना। SHAP वैल्यू विश्लेषण यह पहचानने में मदद करता है कि क्या कुछ फीचर्स विशेष समूहों को अनुपातहीन रूप से प्रभावित कर रहे हैं। यह मॉडल में भेदभाव का पता लगाने और उसे कम करने में सक्षम बनाता है।
- फेयरनेस ऑडिटिंग। किसी मॉडल की निष्पक्षता और नैतिक प्रभावों का आकलन करने के लिए इसका उपयोग किया जा सकता है।
- नियामकीय स्वीकृति। SHAP वैल्यूज़ मॉडल के निर्णयों को समझाकर नियामकीय स्वीकृति प्राप्त करने में मदद कर सकती हैं।
निष्कर्ष
हमने SHAP वैल्यूज़ की जाँच की और देखा कि उन्हें मशीन लर्निंग मॉडलों के लिए व्याख्यात्मकता प्रदान करने में कैसे उपयोग किया जा सकता है। यद्यपि सटीक मॉडल होना आवश्यक है, कंपनियों को सटीकता से आगे बढ़कर व्याख्यात्मकता और पारदर्शिता पर ध्यान केंद्रित करना चाहिए ताकि उपयोगकर्ताओं और नियामकों का विश्वास जीता जा सके।
यह समझा पाना कि किसी मॉडल ने कोई विशेष भविष्यवाणी क्यों की, संभावित पूर्वाग्रहों को डीबग करने, डेटा संबंधी समस्याओं की पहचान करने और मॉडल के निर्णयों को सही ठहराने में मदद करता है।
यदि आप मशीन लर्निंग में नए हैं और नौकरी के लिए तैयार होना चाहते हैं, तो Machine Learning Scientist with Python करियर ट्रैक पर विचार करें। यह प्रोग्राम आपको मशीन लर्निंग साइंटिस्ट बनने और नौकरी पाने के लिए आवश्यक Python कौशल में पारंगत करेगा।
