什么是向量数据库?
从本质上讲,向量数据库是一种专门为存储和检索向量数据而构建的系统。在这里,向量指的是一组有序的数值,它们可以表示从空间坐标到特征属性的任何内容。例如,在机器学习和数据科学的场景中,向量常用于表示对象的特征。向量数据库可以高效地存储并检索这些特征向量。
图片作者 Gary Alway
向量嵌入
向量嵌入是将对象(如词语、句子或实体)表示为连续向量空间中的向量的过程。这项技术常用于将高维、类别型数据转换为连续的低维向量,从而更有效地被机器学习算法利用。向量嵌入在自然语言处理(NLP)中尤为常见,用于表示词语或短语。
向量嵌入背后的核心思想是捕捉对象之间的语义关系。以词向量为例,含义相近的词会被表示为在向量空间中更接近的向量。这使得机器学习模型能够更好地理解词语之间的上下文与语义关系。
在向量嵌入这一概念之上,大语言模型(LLM)利用这些数值表示来处理复杂的语言理解和生成任务。
LLM 与向量嵌入
以一个具体示例来说,用于聊天的 GTP 模型的底层架构涉及向量。模型会将输入数据(如文本)转换为数值向量进行处理。
这些向量捕捉了输入的语义与上下文信息,使模型能够理解并生成连贯且与语境相关的响应。Transformer 架构(GPT-3.5 即基于此构建)利用自注意力机制来衡量序列中不同词语的重要性,从而进一步提升模型捕捉关系和上下文的能力。
“自注意力”指的是模型能够对输入序列中的不同词语分配不同程度的重要性。
因此,从本质上说,GPT-3.5 模型依托语言的向量化表示来执行各类自然语言理解与生成任务。这种基于向量的方法,是其在众多语言相关应用中取得成功的关键因素之一。
导航向量:使用 PG Vector 的上手之旅
PG Vector 是 Postgres 的开源向量相似度搜索扩展。我们直接上手,用 Docker 创建一个数据库。新建名为 docker-compose.yml 的文件,然后在命令行运行以下命令:docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust技术支持
下一步是创建一张表。在本例中,我们将编目 DataCamp 的学习资源,包括课程、博客、教程、播客、速查表、跟练代码以及认证。
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);技术支持
embedding 列将由一个字符串化的 JSON 对象生成,该对象表示资源属性 { name, content, slug, type }。要创建这个向量嵌入,我们将使用一个嵌入模型。
在 AWS Bedrock 上可用的一个此类模型是 amazon.titan-embed-text-v1。本文不涉及 Bedrock 的配置;它只是众多可实现类似效果的嵌入模型之一。主要目标是获取文本输入,使用嵌入模型生成向量嵌入,然后将其存储在 embedding 列中。
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
new InvokeModelCommand({
modelId: "amazon.titan-embed-text-v1",
contentType: "application/json",
accept: "application/json",
body: JSON.stringify({
inputText: JSON.stringify(resource),
}),
})
);
const { embedding } = JSON.parse(new TextDecoder().decode(response.body));技术支持
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]技术支持
向量操作与搜索
当我们能够将数据与其向量嵌入一并存储时,便能释放向量数据库的威力,使我们得以以类似自然语言的方式与数据库交互,轻松检索到有意义的结果。
您只需提出任何想要“询问数据”的问题,并对该文本应用相同的嵌入。SQL 查询如下所示:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;技术支持
该查询使用了余弦相似度搜索。参数 $1 表示您输入问题文本的嵌入结果;而参数 $2 作为相似度阈值,是一个值得试验的变量。其最佳取值取决于数据集规模以及您对结果相关性的期望,从而影响到检索信息的粒度。
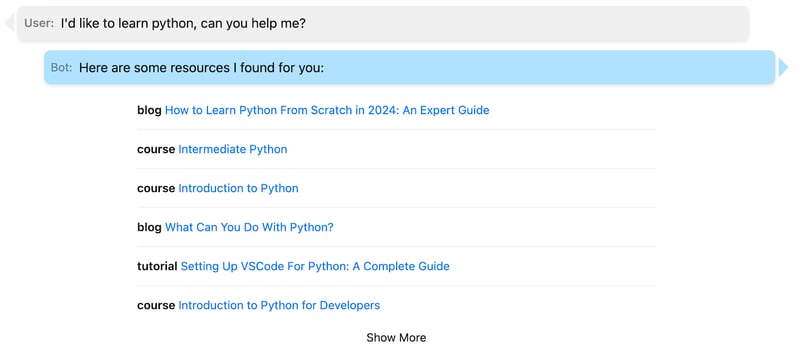
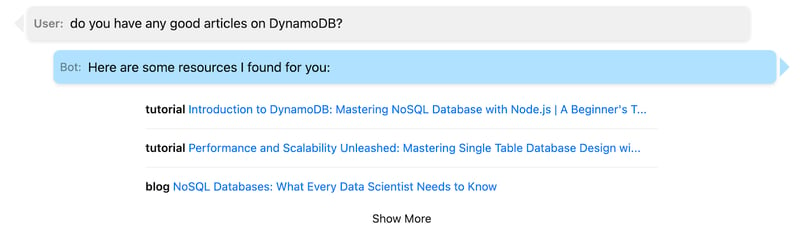
在以上组件就绪后,构建一个聊天式的 UI 便水到渠成。此类界面的具体实现超出了本文范围,但下面是一些示例,使用的是我的 DataCamp 数据集,包含 600 多条记录:
结语与延伸阅读
本文探讨了强大的向量数据库领域,并借助 PG Vector 提升了数据存储与检索能力。当您开始踏上向量嵌入之旅时,还有许多内容可供探索与学习。要深入了解 PG Vector,请参阅其readme,其中有更详细的信息,并包含面向您偏好编程语言的客户端链接。
在理解向量嵌入之后,一个自然而然的进阶主题是检索增强生成(RAG)。这是一种将上下文数据注入大语言模型(LLM)的过程。通过这样做,RAG 为模型提供了训练数据之外的知识,从而实现更有依据、更加贴合语境的回答。
您还可以在 DataCamp 找到涵盖向量数据库其他要素的一系列资源,包括:
祝您编码顺利,愿您的向量之旅有所洞见、满载收获!


什么是向量数据库?
从本质上讲,向量数据库是一种专门为存储和检索向量数据而构建的系统。在这里,向量指的是一组有序的数值,它们可以表示从空间坐标到特征属性的任何内容。例如,在机器学习和数据科学的场景中,向量常用于表示对象的特征。向量数据库可以高效地存储并检索这些特征向量。
图片作者 Gary Alway
向量嵌入
向量嵌入是将对象(如词语、句子或实体)表示为连续向量空间中的向量的过程。这项技术常用于将高维、类别型数据转换为连续的低维向量,从而更有效地被机器学习算法利用。向量嵌入在自然语言处理(NLP)中尤为常见,用于表示词语或短语。
向量嵌入背后的核心思想是捕捉对象之间的语义关系。以词向量为例,含义相近的词会被表示为在向量空间中更接近的向量。这使得机器学习模型能够更好地理解词语之间的上下文与语义关系。
在向量嵌入这一概念之上,大语言模型(LLM)利用这些数值表示来处理复杂的语言理解和生成任务。
LLM 与向量嵌入
以一个具体示例来说,用于聊天的 GTP 模型的底层架构涉及向量。模型会将输入数据(如文本)转换为数值向量进行处理。
这些向量捕捉了输入的语义与上下文信息,使模型能够理解并生成连贯且与语境相关的响应。Transformer 架构(GPT-3.5 即基于此构建)利用自注意力机制来衡量序列中不同词语的重要性,从而进一步提升模型捕捉关系和上下文的能力。
“自注意力”指的是模型能够对输入序列中的不同词语分配不同程度的重要性。
因此,从本质上说,GPT-3.5 模型依托语言的向量化表示来执行各类自然语言理解与生成任务。这种基于向量的方法,是其在众多语言相关应用中取得成功的关键因素之一。
导航向量:使用 PG Vector 的上手之旅
PG Vector 是 Postgres 的开源向量相似度搜索扩展。我们直接上手,用 Docker 创建一个数据库。新建名为
docker-compose.yml的文件,然后在命令行运行以下命令:docker-compose up -d下一步是创建一张表。在本例中,我们将编目 DataCamp 的学习资源,包括课程、博客、教程、播客、速查表、跟练代码以及认证。
embedding 列将由一个字符串化的 JSON 对象生成,该对象表示资源属性 { name, content, slug, type }。要创建这个向量嵌入,我们将使用一个嵌入模型。
在 AWS Bedrock 上可用的一个此类模型是
amazon.titan-embed-text-v1。本文不涉及 Bedrock 的配置;它只是众多可实现类似效果的嵌入模型之一。主要目标是获取文本输入,使用嵌入模型生成向量嵌入,然后将其存储在 embedding 列中。向量操作与搜索
当我们能够将数据与其向量嵌入一并存储时,便能释放向量数据库的威力,使我们得以以类似自然语言的方式与数据库交互,轻松检索到有意义的结果。
您只需提出任何想要“询问数据”的问题,并对该文本应用相同的嵌入。SQL 查询如下所示:
该查询使用了余弦相似度搜索。参数 $1 表示您输入问题文本的嵌入结果;而参数 $2 作为相似度阈值,是一个值得试验的变量。其最佳取值取决于数据集规模以及您对结果相关性的期望,从而影响到检索信息的粒度。
在以上组件就绪后,构建一个聊天式的 UI 便水到渠成。此类界面的具体实现超出了本文范围,但下面是一些示例,使用的是我的 DataCamp 数据集,包含 600 多条记录:
结语与延伸阅读
本文探讨了强大的向量数据库领域,并借助 PG Vector 提升了数据存储与检索能力。当您开始踏上向量嵌入之旅时,还有许多内容可供探索与学习。要深入了解 PG Vector,请参阅其readme,其中有更详细的信息,并包含面向您偏好编程语言的客户端链接。
在理解向量嵌入之后,一个自然而然的进阶主题是检索增强生成(RAG)。这是一种将上下文数据注入大语言模型(LLM)的过程。通过这样做,RAG 为模型提供了训练数据之外的知识,从而实现更有依据、更加贴合语境的回答。
您还可以在 DataCamp 找到涵盖向量数据库其他要素的一系列资源,包括:
祝您编码顺利,愿您的向量之旅有所洞见、满载收获!