Kurs
Pinecone ile AI Uygulamaları Geliştirme
3 sa
12.2K
Özünde, vektör veritabanı vektör verilerini saklamak ve geri çağırmak için tasarlanmış özel bir sistemdir. Bu bağlamda vektör, uzamsal koordinatlardan özellik özniteliklerine kadar her şeyi temsil edebilen sıralı sayısal değerler kümesini ifade eder; makine öğrenimi ve veri bilimi kullanım senaryolarında vektörler sıklıkla nesnelerin özelliklerini temsil etmek için kullanılır. Vektör veritabanı bu özellik vektörlerini verimli bir şekilde saklayıp geri çağırabilir.
Görsel: Gary Alway
Vektör gömme, kelimeler, cümleler veya varlıklar gibi nesneleri sürekli bir vektör uzayında vektörler olarak temsil etme sürecidir. Bu teknik, yüksek boyutlu ve kategorik verileri sürekli, daha düşük boyutlu vektörlere dönüştürmek için yaygın olarak kullanılır; bu da makine öğrenimi algoritmaları tarafından daha etkili şekilde kullanılabilir. Vektör gömmeleri özellikle doğal dil işleme (NLP) alanında, kelime veya ifadeleri temsil etmek için popülerdir.
Vektör gömmenin temel fikri, nesneler arasındaki anlamsal ilişkileri yakalamaktır. Örneğin, kelime gömmeleri bağlamında, benzer anlamlara sahip kelimeler vektör uzayında birbirine daha yakın vektörlerle temsil edilir. Bu, makine öğrenimi modellerinin kelimeler arasındaki bağlamsal ve anlamsal ilişkileri daha iyi anlamasına olanak tanır.
Vektör gömme kavramı üzerine inşa edilen Büyük Dil Modelleri (LLM'ler), bu sayısal temsilleri karmaşık dil anlama ve üretim görevlerini ele almak için kullanır.
Somut bir örnek olarak, chat GTP modelinin altında yatan mimari vektörlerin kullanımını içerir. Model, metin gibi girdi verilerini sayısal vektörlere dönüştürerek işler.
Bu vektörler girdinin anlamsal ve bağlamsal bilgisini yakalar; böylece modelin tutarlı ve bağlama uygun yanıtlar üretmesini sağlar. GPT-3.5'in üzerine inşa edildiği Transformer mimarisi, bir dizideki farklı kelimelerin önemini tartmak için öz-dikkat (self-attention) mekanizmalarını kullanır ve bu da modelin ilişkileri ve bağlamı yakalama yeteneğini daha da güçlendirir.
“Self-attention”, modelin girdi dizisi içindeki farklı kelimelere farklı derecelerde önem atayabilme yeteneğini ifade eder.
Kısacası, GPT-3.5 modeli çeşitli doğal dil anlama ve üretim görevlerini yerine getirmek için dilin vektörleştirilmiş temsilleri üzerinde çalışır. Bu vektör tabanlı yaklaşım, modelin çok çeşitli dil odaklı uygulamalardaki başarısının temel etkenlerinden biridir.
PG Vector, Postgres için açık kaynaklı bir vektör benzerlik aramasıdır. Hızlıca işe koyulalım ve Docker ile bir veritabanı oluşturalım. docker-compose.yml adlı bir dosya oluşturun ve ardından komut satırında şu komutu çalıştırın: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
Bir sonraki adım bir tablo oluşturmak; bu örnekte kurslar, bloglar, eğitimler, podcast'ler, cheat sheet'ler, birlikte kodlama oturumları ve sertifikalar dahil olmak üzere DataCamp öğrenme kaynaklarını kataloglayacağız.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
Embedding sütunu, kaynak özniteliklerini temsil eden stringleştirilmiş bir JSON nesnesinden oluşturulacaktır { name, content, slug, type }. Bu vektör gömmeyi oluşturmak için bir embedding modelinden yararlanacağız.
AWS Bedrock üzerinde bulunan modellerden biri amazon.titan-embed-text-v1'dir. Bedrock yapılandırması bu yazının kapsamına girmiyor; bu, benzer sonuçlar üretebilen birçok embedding modelinden yalnızca birine örnektir. Temel amaç, metinsel girdiyi almak, bir embedding modeliyle vektör gömmeleri üretmek ve bunları embedding sütununda saklamaktır.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Veriyi vektör gömmeleriyle birlikte saklama olanağı sayesinde, veritabanımızla doğal dil benzeri etkileşimler kurmamızı ve anlamlı sonuçları zahmetsizce geri çağırmamızı sağlayan vektör veritabanlarının gücünü açığa çıkarıyoruz.
“Verilerinize sormak” istediğiniz herhangi bir soruyu formüle edin ve aynı gömmeyi o metne de uygulayın. SQL sorgusu şu şekilde görünüyor:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Bu sorgu bir kosinüs benzerliği araması kullanır. $1 parametresi, girdi soru metninizin embedding sonucunu temsil ederken, benzerlik eşiği görevi gören $2 parametresi denemelerle ayarlanmasında fayda olan bir değişkendir. En uygun değeri, veri kümenizin boyutu ve istediğiniz sonuç alakalılığı gibi faktörlere bağlıdır; getirilen bilginin ayrıntı düzeyini şekillendirir.
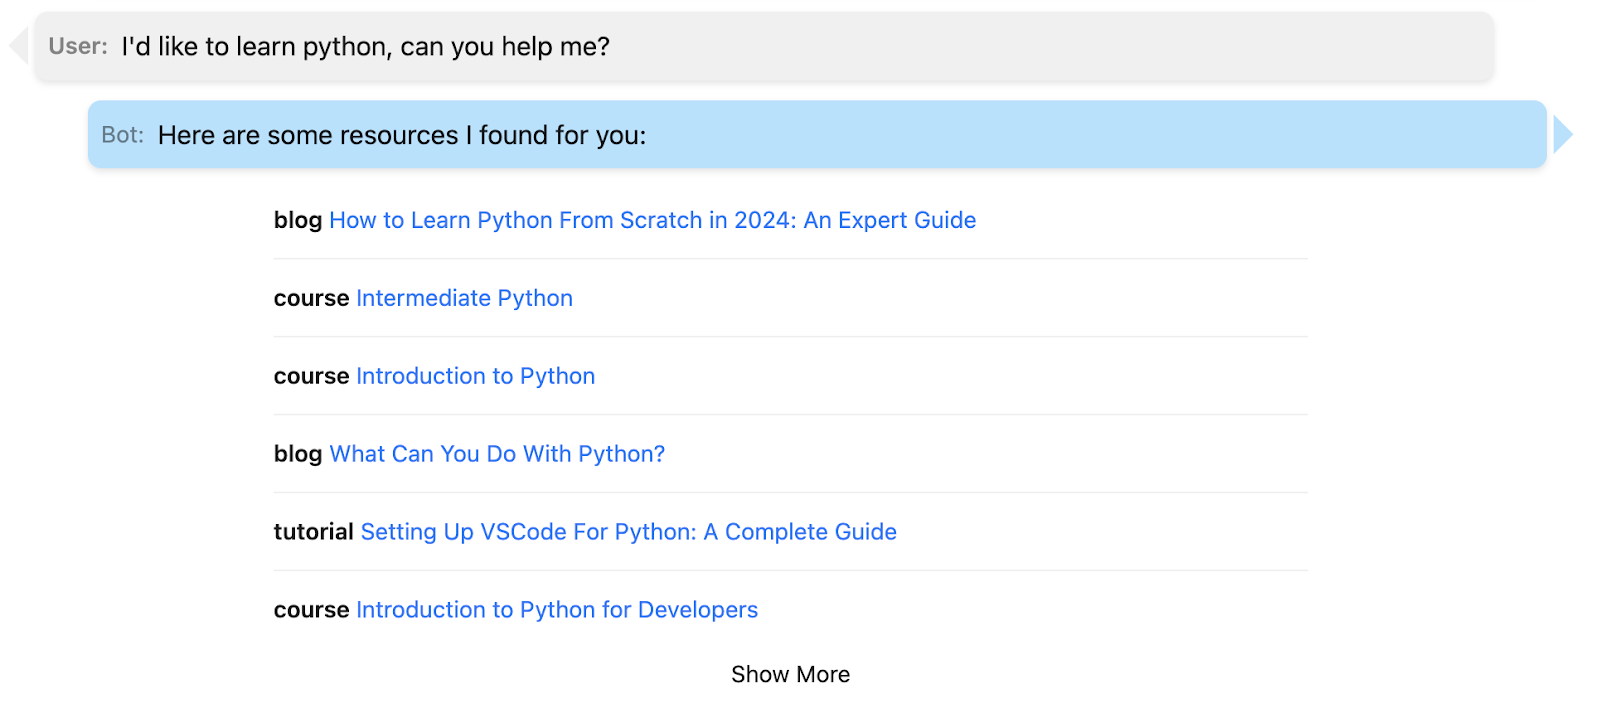
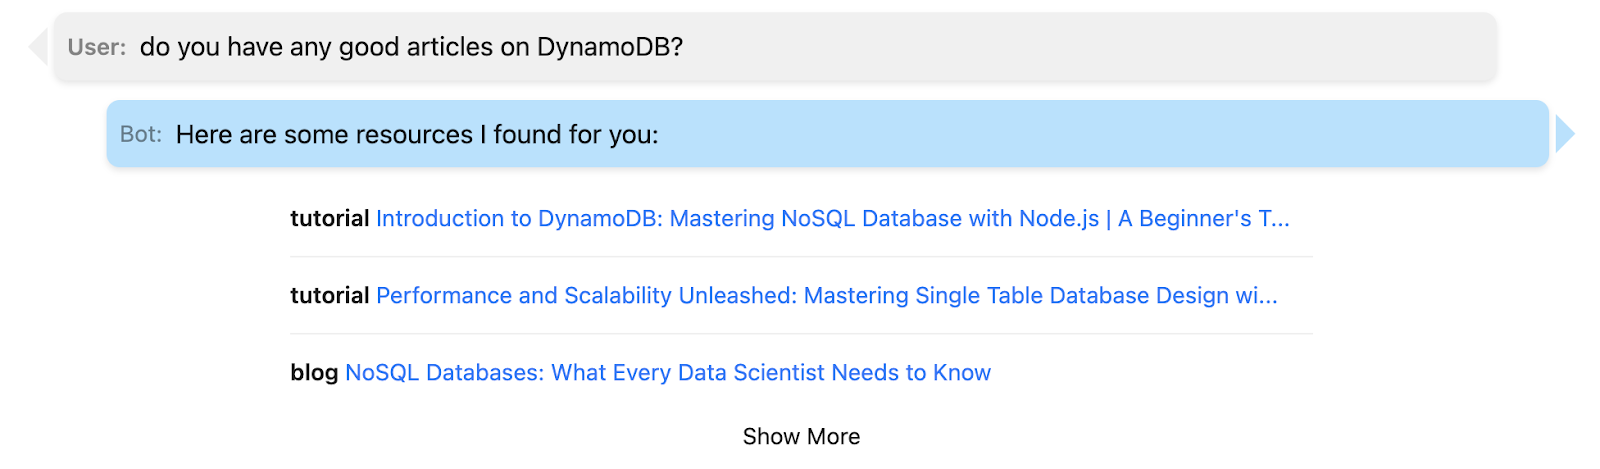
Tüm bu bileşenler yerli yerindeyken, sohbet tarzı bir arayüz oluşturmak oldukça kolaylaşır. Böyle bir arayüzün nasıl uygulanacağı bu yazının kapsamı dışında kalsa da, 600+ kayıttan oluşan DataCamp veri setimi kullanarak bazı örnekler aşağıdadır:
Bu yazıda, PG Vector'den yararlanarak veri depolama ve geri çağırma yeteneklerimizi güçlendiren vektör veritabanlarının güçlü dünyasını keşfettik. Vektör gömmeleriyle yolculuğunuza başlarken keşfedilecek ve öğrenilecek çok şey var. PG Vector'ü daha derinlemesine incelemek için, daha fazla ayrıntı içeren ve tercih ettiğiniz programlama dili için istemci bağlantılarına yer veren readme dosyalarına bakın.
Vektör gömmelerini anlamanın doğal bir devamı, Retrieval Augmented Generation (RAG) yaklaşımıdır. Bu, büyük dil modellerine (LLM) bağlamsal veri enjekte etme sürecidir. Böyle yaparak, RAG modele eğitim verilerinin ötesinde bilgi sağlar ve daha bilgili, bağlama daha uygun yanıtlar üretmesini mümkün kılar.
Ayrıca, vektör veritabanlarının diğer unsurlarını kapsayan çeşitli DataCamp kaynaklarını da bulabilirsiniz:
Mutlu kodlamalar; vektör tabanlı çalışmalarınız hem öğretici hem de verimli olsun!
Vektör Yolculuğunuza Bugün Devam Edin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



