कोर्स
Pinecone के साथ AI Applications बनाना
3 घंटा
11.8K
मूल रूप से, वेक्टर डेटाबेस वेक्टर डेटा के संग्रहीकरण और पुनर्प्राप्ति के लिए बनाया गया एक विशेष सिस्टम है। यहाँ वेक्टर से आशय क्रमबद्ध संख्यात्मक मानों के ऐसे सेट से है जो स्थानिक निर्देशांक से लेकर फीचर विशेषताओं तक कुछ भी दर्शा सकते हैं—जैसे मशीन लर्निंग और डेटा साइंस उपयोगों में, जहाँ वेक्टर अक्सर ऑब्जेक्ट्स के फीचर्स का प्रतिनिधित्व करते हैं। वेक्टर डेटाबेस इन फीचर वेक्टरों को कुशलतापूर्वक संग्रहीत और पुनर्प्राप्त कर सकता है।
छवि: Gary Alway
वेक्टर एम्बेडिंग वह प्रक्रिया है जिसमें शब्दों, वाक्यों, या एंटिटीज़ जैसे ऑब्जेक्ट्स को एक सतत वेक्टर स्पेस में वेक्टर के रूप में दर्शाया जाता है। यह तकनीक प्रायः उच्च-आयामी और श्रेणीबद्ध डेटा को सतत, निम्न-आयामी वेक्टरों में बदलने के लिए उपयोग की जाती है, जिन्हें मशीन लर्निंग एल्गोरिद्म अधिक प्रभावी ढंग से उपयोग कर पाते हैं। वेक्टर एम्बेडिंग विशेष रूप से नेचुरल लैंग्वेज प्रोसेसिंग (NLP) में लोकप्रिय हैं, जहाँ इनका उपयोग शब्दों या वाक्यांशों को दर्शाने के लिए होता है।
वेक्टर एम्बेडिंग के पीछे का प्रमुख विचार ऑब्जेक्ट्स के बीच सार्थक (सेमांटिक) संबंधों को पकड़ना है। उदाहरण के लिए, वर्ड एम्बेडिंग के संदर्भ में, समान अर्थ वाले शब्दों को वेक्टर स्पेस में एक-दूसरे के करीब स्थित वेक्टरों द्वारा दर्शाया जाता है। इससे मशीन लर्निंग मॉडल्स शब्दों के संदर्भात्मक और सार्थक संबंधों को बेहतर समझ पाते हैं।
वेक्टर एम्बेडिंग की अवधारणा पर आगे बढ़ते हुए, बड़े भाषा मॉडल (LLMs) इन संख्यात्मक प्रतिनिधित्वों का उपयोग जटिल भाषा-समझ और जनरेशन कार्यों से निपटने के लिए करते हैं।
एक ठोस उदाहरण के रूप में, चैट GTP के मॉडल की आधारभूत संरचना में वेक्टरों का उपयोग शामिल है। मॉडल इनपुट डेटा, जैसे पाठ, को संख्यात्मक वेक्टरों में बदलकर संसाधित करता है।
ये वेक्टर इनपुट की सार्थक और संदर्भात्मक जानकारी को पकड़ते हैं, जिससे मॉडल सुव्यवस्थित और संदर्भानुकूल प्रतिक्रियाएँ समझ और उत्पन्न कर सकता है। Transformer आर्किटेक्चर, जिस पर GPT-3.5 आधारित है, स्व-अटेंशन मैकेनिज्म का उपयोग करता है जो क्रम में विभिन्न शब्दों के महत्त्व को तौलता है, जिससे संबंधों और संदर्भ को पकड़ने की मॉडल की क्षमता और सुदृढ़ होती है।
“Self-attention” से आशय मॉडल की उस क्षमता से है जिसमें वह इनपुट अनुक्रम के भीतर अलग-अलग शब्दों को अलग-अलग स्तर का महत्त्व देता है।
तो, सार में, GPT-3.5 मॉडल विभिन्न प्राकृतिक भाषा समझ और जनरेशन कार्यों को करने के लिए भाषा के वेक्टराइज़्ड प्रतिनिधित्वों पर कार्य करता है। यह वेक्टर-आधारित दृष्टिकोण भाषा-संबंधी व्यापक अनुप्रयोगों में मॉडल की सफलता का एक प्रमुख कारक है।
PG Vector Postgres के लिए एक ओपन-सोर्स वेक्टर समानता खोज है। आइए सीधे कूदें और Docker के साथ एक डेटाबेस बनाएं। docker-compose.yml नाम की फ़ाइल बनाएं, फिर कमांड लाइन पर यह कमांड चलाएँ: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
अगला कदम है टेबल बनाना, और इस उदाहरण में, हम DataCamp लर्निंग संसाधनों—जैसे कोर्स, ब्लॉग, ट्यूटोरियल, पॉडकास्ट, चीट शीट्स, कोड-अलॉन्ग्स, और सर्टिफिकेशंस—की कैटलॉगिंग करने जा रहे हैं।
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
एम्बेडिंग कॉलम एक स्ट्रिंगिफाइड JSON ऑब्जेक्ट से जनरेट किया जाएगा, जो संसाधन के गुणों { name, content, slug, type } का प्रतिनिधित्व करता है। इस वेक्टर एम्बेडिंग को बनाने के लिए हम एक एम्बेडिंग मॉडल का उपयोग करेंगे।
AWS Bedrock पर उपलब्ध ऐसे ही एक मॉडल का नाम है amazon.titan-embed-text-v1। Bedrock का कॉन्फ़िगरेशन इस लेख के दायरे में नहीं है; यह केवल कई एम्बेडिंग मॉडलों में से एक उदाहरण है जो समान परिणाम देने में सक्षम हैं। मुख्य उद्देश्य है पाठ इनपुट लेना, एम्बेडिंग मॉडल का उपयोग करके वेक्टर एम्बेडिंग बनाना, और फिर उन्हें एम्बेडिंग कॉलम में संग्रहीत करना।
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]डेटा को उसके वेक्टर एम्बेडिंग के साथ संग्रहीत करने की क्षमता से सशक्त होकर, हम वेक्टर डेटाबेस की ताकत को अनलॉक करते हैं—जिससे हम अपने डेटाबेस से प्राकृतिक भाषा जैसी बातचीत कर सकते हैं और सार्थक परिणाम आसानी से प्राप्त कर सकते हैं।
जो भी प्रश्न आप “अपने डेटा से पूछना” चाहें, उसे गढ़ें और उसी एम्बेडिंग को उस पाठ पर लागू करें। SQL क्वेरी इस प्रकार दिखती है:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
यह क्वेरी कोसाइन समानता खोज का उपयोग करती है। पैरामीटर $1 आपके इनपुट प्रश्न-पाठ के एम्बेडिंग परिणाम का प्रतिनिधित्व करता है, जबकि पैरामीटर $2, जो समानता थ्रेशोल्ड का काम करता है, एक ऐसा वेरिएबल है जिस पर प्रयोग से लाभ होगा। इसका इष्टतम मान आपके डेटासेट के आकार और वांछित परिणाम-प्रासंगिकता जैसे कारकों पर निर्भर करता है, जो प्राप्त जानकारी की सूक्ष्मता को निर्धारित करता है।
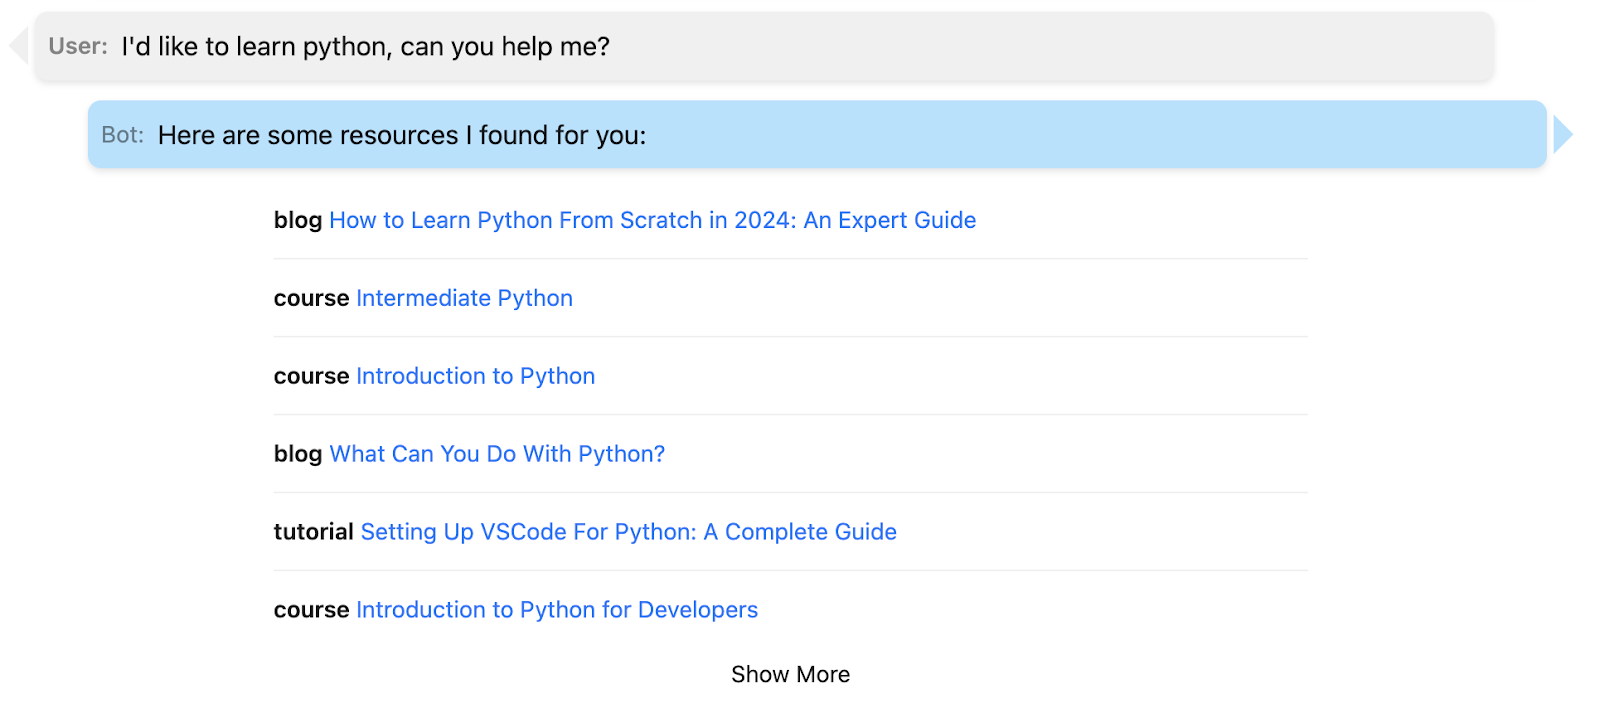
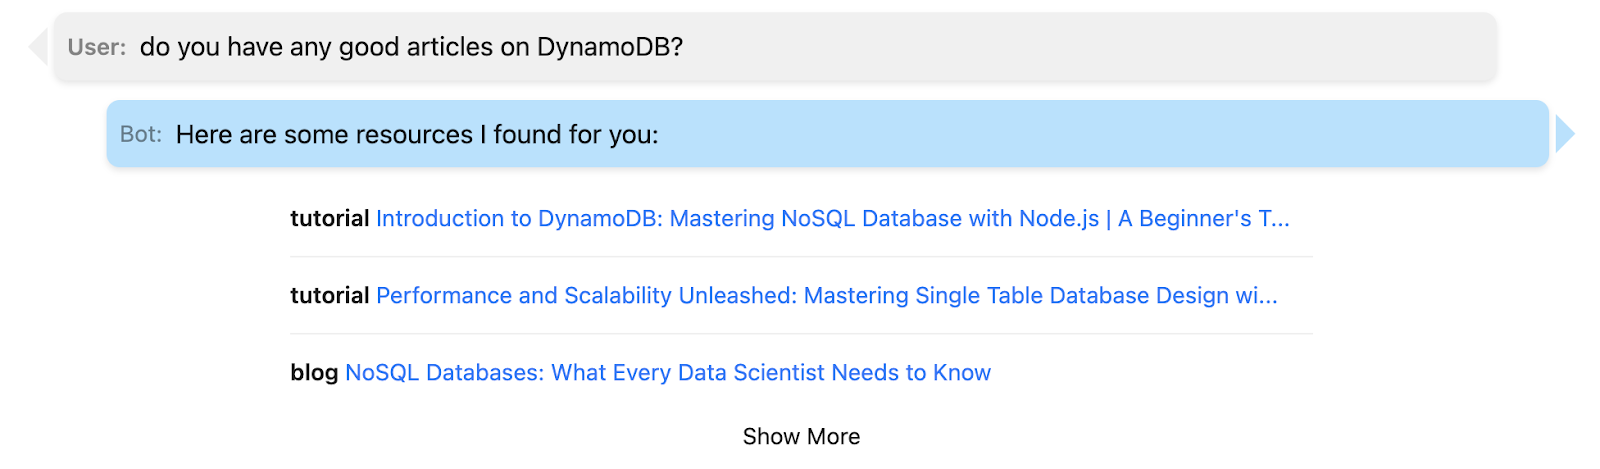
इन सभी घटकों के साथ, चैट-स्टाइल UI बनाना सरल हो जाता है। ऐसे इंटरफ़ेस को लागू करने के विवरण इस लेख के दायरे से बाहर हैं, पर यहाँ मेरे DataCamp डेटासेट (जिसमें 600+ से अधिक रिकॉर्ड हैं) के कुछ उदाहरण दिए गए हैं:
इस लेख में, हमने वेक्टर डेटाबेस की शक्तिशाली दुनिया का अन्वेषण किया, और PG Vector का उपयोग करके अपने डेटा के संग्रहीकरण और पुनर्प्राप्ति की क्षमताओं को बढ़ाया। जैसे ही आप वेक्टर एम्बेडिंग्स की यात्रा शुरू करते हैं, सीखने और खोजने के लिए बहुत कुछ है। PG Vector में गहराई से जाने के लिए उनका readme देखें, जो और अधिक विवरण में जाता है और आपकी पसंदीदा प्रोग्रामिंग भाषा के लिए क्लाइंट्स के लिंक शामिल करता है।
वेक्टर एम्बेडिंग्स को समझने से स्वाभाविक रूप से आगे बढ़ता है Retrieval Augmented Generation (RAG)। यह बड़े भाषा मॉडलों (LLMs) में संदर्भात्मक डेटा डालने की प्रक्रिया है। ऐसा करने से, RAG मॉडल को उसके प्रशिक्षण डेटा के बाहर का ज्ञान प्रदान करता है, जिससे अधिक सूचित और संदर्भानुकूल प्रतिक्रियाएँ संभव होती हैं।
आप DataCamp के ऐसे कई संसाधन भी पा सकते हैं जो वेक्टर डेटाबेस के अन्य पहलुओं को कवर करते हैं, जिनमें शामिल हैं:
हैप्पी कोडिंग, और आपकी वेक्टर-आधारित पहलों के परिणाम सूझ-बूझ भरे और फलदायी हों!
आज ही अपनी वेक्टर यात्रा जारी रखें!
कोर्स
कोर्स
कोर्स