Corso
Database vettoriali per Embeddings con Pinecone
3 ore
12.2K
Alla base, un database vettoriale è un sistema progettato appositamente per l'archiviazione e il recupero di dati vettoriali. In questo contesto, un vettore è un insieme ordinato di valori numerici che può rappresentare qualsiasi cosa, dalle coordinate spaziali agli attributi di feature, come nel caso del machine learning e della data science, dove i vettori vengono spesso usati per rappresentare le caratteristiche degli oggetti. Il database vettoriale può archiviare e recuperare in modo efficiente questi vettori di feature.
Immagine di Gary Alway
L’embedding vettoriale è il processo di rappresentazione di oggetti, come parole, frasi o entità, sotto forma di vettori in uno spazio vettoriale continuo. Questa tecnica è comunemente usata per convertire dati ad alta dimensionalità e categorici in vettori continui a dimensionalità inferiore, che possono essere utilizzati in modo più efficace dagli algoritmi di machine learning. Gli embedding vettoriali sono particolarmente popolari nell’elaborazione del linguaggio naturale (NLP), dove vengono usati per rappresentare parole o frasi.
L’idea principale dietro gli embedding vettoriali è catturare le relazioni semantiche tra gli oggetti. Nel contesto degli embedding di parole, ad esempio, parole con significati simili sono rappresentate da vettori più vicini nello spazio vettoriale. Questo permette ai modelli di machine learning di comprendere meglio le relazioni contestuali e semantiche tra le parole.
Partendo dal concetto di embedding vettoriali, i Large Language Model (LLM) sfruttano queste rappresentazioni numeriche per affrontare compiti complessi di comprensione e generazione del linguaggio.
Come esempio concreto, l’architettura alla base del modello per chat GTP coinvolge l’uso di vettori. Il modello elabora dati in input, come il testo, convertendoli in vettori numerici.
Questi vettori catturano le informazioni semantiche e contestuali dell’input, consentendo al modello di comprendere e generare risposte coerenti e rilevanti per il contesto. L’architettura Transformer, su cui si basa GPT-3.5, utilizza meccanismi di self-attention per pesare l’importanza delle diverse parole in una sequenza, migliorando ulteriormente la capacità del modello di cogliere relazioni e contesto.
“Self-attention” si riferisce alla capacità del modello di assegnare gradi di importanza variabili alle diverse parole all’interno della sequenza di input.
In sostanza, quindi, il modello GPT-3.5 opera su rappresentazioni vettoriali del linguaggio per svolgere vari compiti di comprensione e generazione del linguaggio naturale. Questo approccio basato su vettori è un fattore chiave del successo del modello in un’ampia gamma di applicazioni legate al linguaggio.
PG Vector è una ricerca di similarità vettoriale open source per Postgres. Tuffiamoci subito e creiamo un database con Docker. Crea un file chiamato docker-compose.yml quindi, a riga di comando, esegui il seguente comando: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
Il passo successivo è creare una tabella e, per questo esempio, andremo a catalogare le risorse di apprendimento di DataCamp, tra cui corsi, blog, tutorial, podcast, cheat sheet, code along e certificazioni.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
La colonna embedding verrà generata a partire da un oggetto JSON convertito in stringa che rappresenta gli attributi della risorsa { name, content, slug, type }. Per creare questo embedding vettoriale useremo un modello di embedding.
Uno di questi modelli disponibile su AWS Bedrock è amazon.titan-embed-text-v1. La configurazione di Bedrock non è trattata in questo articolo; è solo un esempio di uno dei tanti modelli di embedding in grado di ottenere risultati analoghi. L’obiettivo principale è prendere un input testuale, usare un modello di embedding per generare embedding vettoriali e poi archiviarli nella colonna embedding.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Grazie alla possibilità di archiviare i dati insieme ai loro embedding vettoriali, sblocchiamo la potenza dei database vettoriali, che ci permettono di interagire con il nostro database in modo simile al linguaggio naturale, recuperando facilmente risultati significativi.
Formula qualsiasi domanda che desideri “porre ai tuoi dati” e applica lo stesso embedding a quel testo. Ecco come appare la query SQL:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Questa query utilizza una ricerca per similarità coseno. Il parametro $1 rappresenta il risultato dell’embedding del testo della tua domanda in input, mentre il parametro $2, che funge da soglia di similarità, è una variabile su cui conviene fare esperimenti. Il suo valore ottimale dipende da fattori come la dimensione del dataset e la rilevanza dei risultati che desideri, influenzando la granularità delle informazioni recuperate.
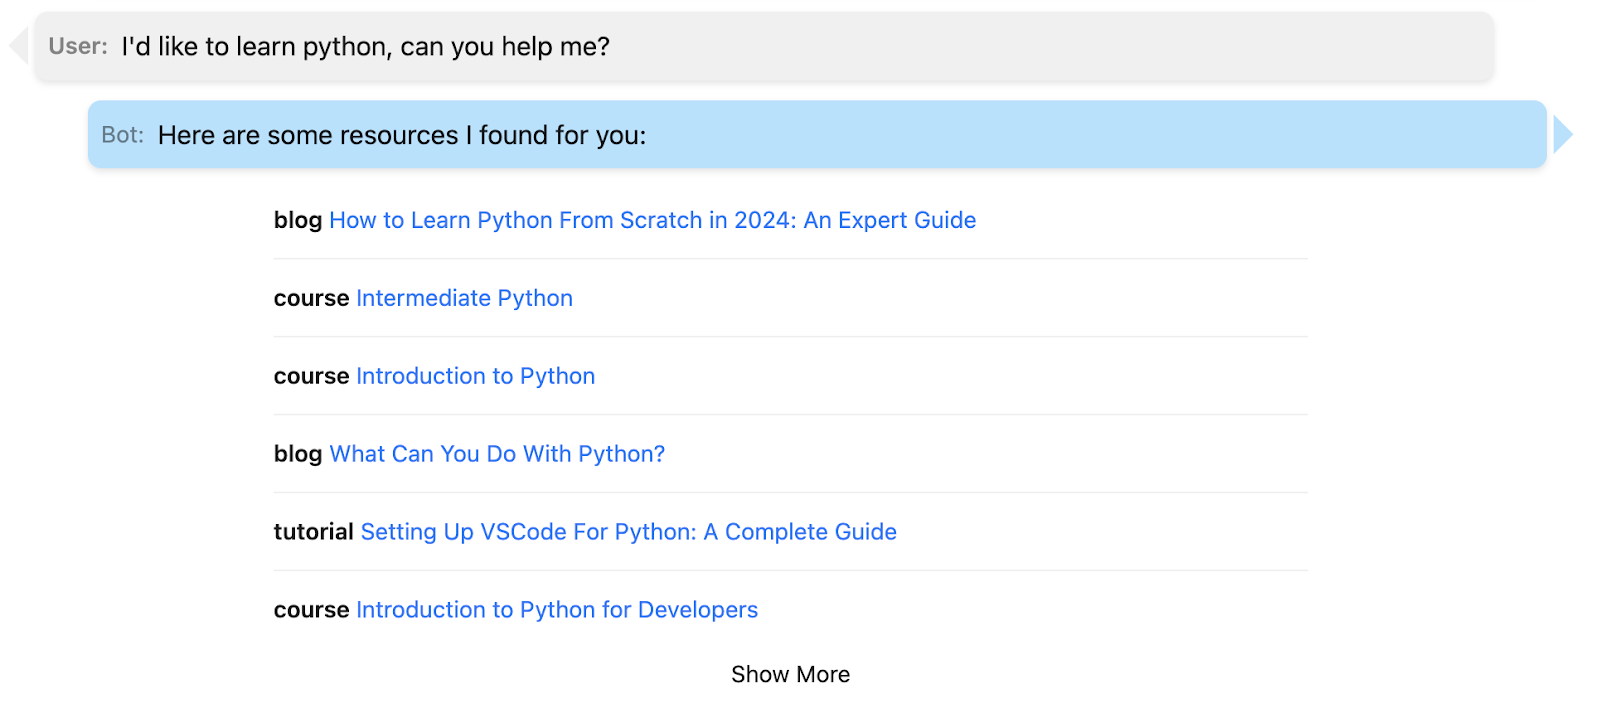
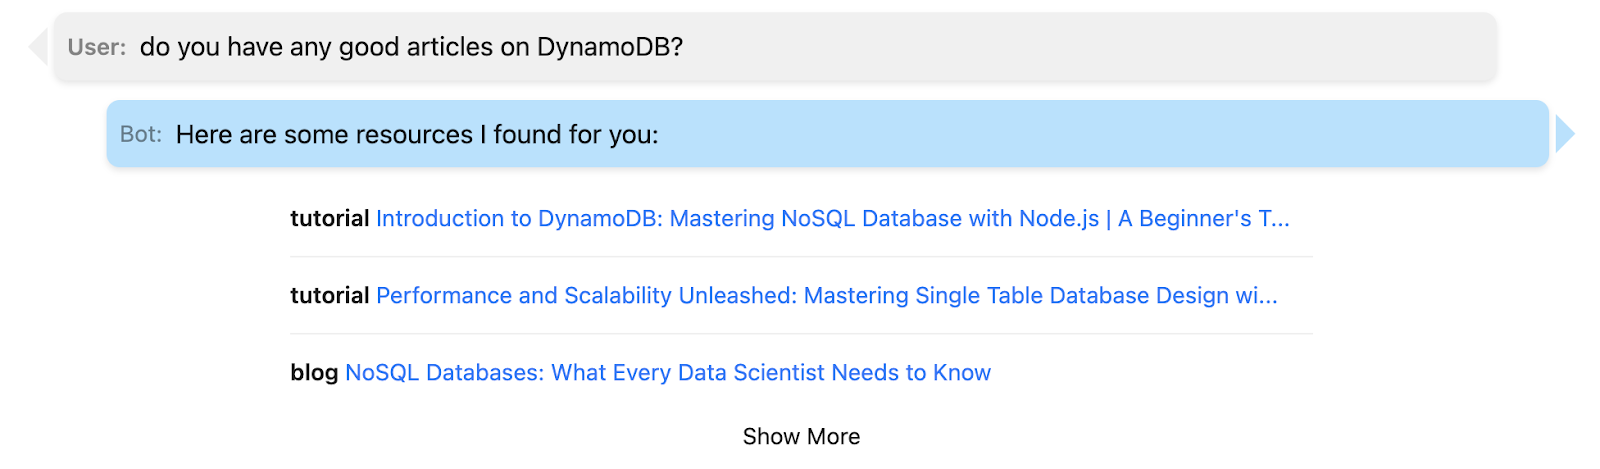
Con tutti questi componenti in posizione, creare un’interfaccia in stile chat diventa semplice. I dettagli di implementazione di un’interfaccia del genere esulano dallo scopo di questo articolo, ma ecco alcuni esempi basati sul mio dataset di DataCamp, che comprende oltre 600 record:
In questo articolo abbiamo esplorato il potente mondo dei database vettoriali, sfruttando PG Vector per migliorare le nostre capacità di archiviazione e recupero dei dati. Intraprendendo il tuo percorso con gli embedding vettoriali, c’è molto altro da scoprire e imparare. Per approfondire PG Vector, consulta il loro readme, che entra più nel dettaglio e include link ai client per il tuo linguaggio di programmazione preferito.
Una naturale evoluzione della comprensione degli embedding vettoriali è la Retrieval Augmented Generation (RAG). Si tratta del processo di iniezione di dati contestuali nei large language model (LLM). Così facendo, RAG fornisce al modello conoscenze al di fuori dei suoi dati di addestramento, consentendo risposte più informate e rilevanti per il contesto.
Puoi anche trovare una serie di risorse DataCamp che coprono altri aspetti dei database vettoriali, tra cui:
Buon coding, e che i tuoi progetti basati su vettori siano sia illuminanti sia gratificanti!
Continua oggi il tuo viaggio nel mondo dei vettori!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



